

分析Linux文件系统的结构
本文主要讨论虚拟文件系统。Linux文件系统的架构包括具体文件系统(如Ext2、Ext3和XFS等)与应用程序之间的抽象层,即虚拟文件系统(VirtualFileSystem,简称VFS)。VFS允许应用程序与不同类型的文件系统进行通信而无需了解底层文件系统的细节。通过VFS,文件系统的实现可以被隔离并与应用程序解耦,从而提高了系统的灵活性和可维护性。VFS还允许Linux内核支持多种文件系统类型,并提供了一个统一的接口供应用程序访问文件系统。在VFS的框架下,不同的文件系统可以通过实现标准的文件系统操作
本文主要讨论虚拟文件系统。Linux文件系统的架构包括具体文件系统(如Ext2、Ext3和XFS等)与应用程序之间的抽象层,即虚拟文件系统(Virtual File System,简称VFS)。VFS允许应用程序与不同类型的文件系统进行通信而无需了解底层文件系统的细节。通过VFS,文件系统的实现可以被隔离并与应用程序解耦,从而提高了系统的灵活性和可维护性。VFS还允许Linux内核支持多种文件系统类型,并提供了一个统一的接口供应用程序访问文件系统。在VFS的框架下,不同的文件系统可以通过实现标准的文件系统操作接口来与内核进行交
图片
上图显示,这一架构的中心是虚拟文件系统VFS。VFS提供了一个文件系统框架,本地文件系统可以基于VFS实现。它主要完成以下几项工作:
1) VFS作为抽象层为应用层提供了统一的接口(read、write和chmod等)。
2) 在VFS中实现了一些公共的功能,如inode缓存和页缓存等。
3) 规范了具体文件系统应该实现的接口。
根据以上设定,其他具体的文件系统只需遵循VFS的约定,实现相应的接口和内部逻辑,并注册到系统中。用户在格式化并挂载文件系统后,便可以利用硬盘资源进行基于该文件系统的操作。
在Linux操作系统中,在格式化磁盘后需要通过mount命令将其挂载到系统目录树的某个目录下面,这个目录称为挂载点(mount point)。完成挂载后,我们就可以使用基于该文件系统格式化的硬盘空间了。在Linux操作系统中,挂载点几乎可以是任意目录,但为了规范化,挂载点通常是mnt目录下的子目录。
下面展示的是一个相对复杂的目录结构。在这个目录结构中,根目录位于硬盘sda上,并且在mnt目录下有三个子目录分别是ext4、xfs和nfs,它们分别挂载了Ext4文件系统(构建在sdb硬盘上)、XFS文件系统(构建在sdc硬盘上)和NFS文件系统(通过网络挂载)。
图片
目录树中多个文件系统的关系是内核中的一些数据结构表示的。在进行文件系统挂载的时候会建立文件系统间的关系,并且注册具体文件系统的API。当用户态调用打开文件的API时,会找到对应的文件系统API,并关联到文件相关的结构体(例如file和inode等)。
上面的描述比较概要,大家可能还是有点云里雾里的感觉。不过大家不要着急,我们接下来会结合代码更加详细的介绍VFS及如何实现对多种文件系统的支持。
1.从文件系统API到VFS,再到具体文件系统
Linux的VFS并不是一开始就有的,最早发布的Linux版本并没有VFS。而且,VFS并非是在Linux发明的,它最早于1985年由Sun公司在其SunOS2.0中开发。开发VFS的主要目的是为了适配其本地文件系统和NFS文件系统。
VFS通过一套公共的API和数据结构实现了对具体文件系统的抽象。当用户调用操作系统提供的文件系统API时会通过软中断的方式调用内核VFS实现的函数。如下表所示是部分文件API与内核VFS函数的对应关系。
|
用户态API |
内核函数 |
说明 |
|
open |
do_sys_open |
打开文件 |
|
close |
ksys_close |
关闭文件 |
|
read |
ksys_read/vfs_read |
读取数据 |
|
write |
ksys_write/vfs_write |
写入数据 |
|
mount |
do_mount |
挂载文件系统 |
由上表可以看出每个用户态的API都有一个内核态的函数与之对应。当应用程序调用文件系统的API时会触发内核态的对应函数。这里列举的只是文件系统API中的一个比较小的子集,目的是为了说明API与VFS的关系。如果大家想了解其他API请自行阅读内核源代码,本文不再赘述。
为了让大家能够对VFS与具体文件系统的关系有个感性的认识,本节以Ext2的写API为例来展示一下从API到VFS函数,再到Ext2文件系统函数的调用关系。如下图所示,API函数write通过软中断触发内核的ksys_write函数,该函数经过若干处理后最终会通过函数指针(file->f_op->wirte_iter)的方式调用Ext2文件系统的ext2_file_write_iter函数。
图片
在上图中内核流程的入口是ksys_write函数,通过实现代码可以看出,这里主要是获取一个fd,然后以fd中的成员file作为参数调用vfs_write。其中fd是一个结构体,其格式如下图所示,file成员是比较核心的数据结构。从上图可以看出,正是通过这个成员中的内容才调到了Ext2文件系统的函数。
图片
看上去很简单,VFS只要调用具体文件系统注册的函数指针即可。但是这里有个问题没有解决,VFS中的函数指针是什么时候被注册的呢?
Ext2的函数指针是在打开文件的时候被初始化的(具体细节请参考《文件系统技术内幕》3.1.2.2节)。大家都知道,用户态的程序在打开一个文件的时候返回的是一个文件描述符,但在内核中表示文件的结构体file与之对应。这个结构体里面比较重要的几个成员包括f_inode、f_ops和f_mapping等,具体如下图所示。
图片
在上图中,f_inode是该文件对应的inode节点。f_ops是具体文件系统(例如Ext2)文件操作的函数指针集合,它是在打开文件的时候被初始化的。VFS正是通过该函数指针集合来实现对具体文件系统访问的。
上面又涉及到VFS的另外一个概念inode。在Linux中,inode是index node的缩写,他表示了文件系统中的一个具体的对象(比如文件或者目录)。在VFS中有一个名称为inode的数据结构,他是对具体文件系统inode的抽象。比如在Ext2文件系统中具体定义为ext2_inode_info,在XFS中则是通过数据结构xfs_inode表示的。而且具体文件系统的inode数据结构与VFS的inode有个内在的关联,大家可以自行阅读代码。
2.inode缓存与dentry缓存
在架构图中我们看到在VFS中有若干个缓存实现,包括页缓存、inode缓存和dentry缓存等。其中inode缓存和dentry缓存实现方式相同,也比较简单。所以,本文先介绍一下这两个缓存。
其实这两个缓存是通过哈希表实现的,哈希表的概念大家都比较清楚,本文不再赘述。以inode缓存为例,如下图是其初始化的过程,通过参数ihash_entries可以看出其大小是动态的(其大小跟系统内存相关,系统内存阅读,inode缓存就越大)。
图片
由于访问文件时会经常访问inode和dentry,所以将两者缓存起来能够避免从硬盘读取数据导致的性能损失。
3.页缓存(Page Cache)
VFS页缓存(Cache)的作用主要用来提升文件系统的性能。缓存技术是指在内存中存储文件系统的部分数据和元数据而提升文件系统性能的技术。由于内存的访问延时是机械硬盘访问延时的十万分之一(如下图所示,以寄存器为基准单位1s),因此采用缓存技术可以大幅提升文件系统的性能。
图片
缓存通过三方面的IO优化来提升文件系统的性能,分别是热点数据、预读和IO合并。很多应用都会有热点数据,比如作者在编辑文档的时候,当前这个数据块及附近的数据块就是热点数据。或者当出现一个爆款文章时,这篇文章的内容就是热点数据。底层存储设备对于大块读写的性能往往较好,预读就是提前从底层设备读取大块数据缓存起来,这样可以通过缓存来响应应用的请求。IO合并则是针对写请求,写请求不马上持久化到后端设备,而是缓存一下,拼成大块IO再写入。
由于内存的容量要比硬盘的容量小的多,因此页缓存自然不能缓存所有硬盘的数据。这样缓存中只能存储文件系统数据的一个子集。当用户持续写入数据的时候就会面临缓存满的情况,此时就涉及如何将缓存数据刷写磁盘,然后存储新数据的问题。
这里将缓存刷写到磁盘,并且存储新数据的过程称为缓存替换。缓存替换有很多种算法,每种算法用于解决不同的问题。接下来我们介绍几种常见的缓存替换算法。
LRU算法,LRU的全称是Least Recently Used,也就是最近最少使用。该算法依据的是时间局部性原理,也就是如果一个数据最近被使用过,那么接下来有很大的概率还会被使用。因此该算法会将最近没有使用过的缓存释放掉。
LRU算法通常使用一个链表来实现,刚被使用过的缓存会被插到表头的位置,而经常没有被使用过的数据则慢慢被挤到链表的尾部。为了更加清晰的理解LRU的原理,我们结合下图进行说明。
图片
在该例中,我们以全命中为例进行介绍。假设缓存中有6个数据块,如图第一行所示,方块中的数字代表该数据块的编号。假设第一次访问(可以是读或者写)的是3号数据块,由于其被访问过,因此将其移动到链表头。
第二次访问时访问的是第4号数据块,按照相同的原则,该数据块也被移动到链表头。具体如上图第2行所示。
以此类推,当经过4轮访问后,被访问过的数据都被前移了,而没有被访问过的数据块(例如1和2)则被慢慢挤到了链表的后面。这在一定程度上预示着这两个数据块在后面被访问的可能性也比较小。
如果是全命中的话也就不存在缓存被替换的情况了。实际情况是缓存会经常不够用,而需要将其中的数据释放(视情况确定是否需要刷新到磁盘)来存储新的数据。此时,LRU算法就派上用场了,该算法将尾部的数据块拿来存储新数据,然后放到链表头,具体下图如所示。如果这个数据块里面是脏数据则需要刷写到磁盘,否则直接释放掉就可以。
图片
LRU算法原理和实现都比较简单,用途却非常广泛。但是LRU算法有个缺点,就是当突然有大量连续数据写入时会替换掉所有的缓存块,从而导致之前统计的缓存使用情况全部失效,这种现象称为缓存污染。为了解决缓存污染问题,有很多改进的LRU算法,其中比较常见的有LRU-K、2Q和LIRS等。
LFU算法,LFU的全称是Least Frequently Used,也就是最近最不经常使用。该算法是根据数据被访问的频度来决策释放哪一个缓存块的。访问频度最低的缓存块会被最先释放掉。
如下图所示是LFU算法的示意图。其中第1行是原始状态,方块中的数字表示该缓存块被访问的次数。新数据的加入和缓存块的淘汰都是从尾部进行。假设某一块(虚线框)数据被访问了4次,则其访问次数从12变成了16,因此需要移动到新的位置,也就是图中第2行的样子。
图片
本书以链表为例说明LFU的原理是为了便于理解,但是在工程实现的时候是绝对不会用链表来实现的。因为当数据块的访问次数变化时需要找新的位置,链表查找操作是非常耗时的。为了能够实现快速查找,一般采用搜索树来实现。
LFU也有其缺点,如果某个数据块在很久之前的某个时间段高频访问,而以后不再访问,那么该数据会一直停留在缓存中。但是由于该数据不会被访问了,所以导致缓存的有效容量减少了。也就是说LFU算法没有考虑最近的情况。
本文主要介绍了LRU和LFU等2种非常基础的替换算法。除了上述算法外,还有还很多替换算法,大多以LRU和LFU的理论为基础,比如2Q,MQ,LRFU,TinyLFU和ARC等等。限于篇幅,本书不再赘述,大家可以自行阅读相关的论文。
数据预读也是有一定的算法的,预读算法通过识别IO模式方式来提前将数据从磁盘读到缓存中。这样,应用读取数据时就可以直接从缓存读取数据,从而极大的提高读数据的性能。
预读算法里面最为重要的是触发条件,也就是在什么情况下出发预读操作。通常有两种情况会触发预读:一个是有多个地址连续的读请求时会触发预读操作;另外一个是应用访问到有预读标记的缓存时。这里,预读标记的缓存是在预读操作完成时在缓存页做的标记,当应用读到有该标记的缓存时会触发下一次的预读,从而省略对IO模式的识别。
图片
为了更加清晰的解释预读的逻辑,我们通过上图来介绍一下整个流程。当文件系统识别IO模式需要预读的时候,会多读出一部分内容(称为同步预读),如时间1(第一行)所示。同时,对于同步预读的数据,文件系统会在其中某个块上打上标记。这个标记的目的是为了在缓存结束前能够尽早的触发下一次的预读。
第2个时间点,当应用继续读取数据时,由于读到了有标记的缓存块,因此会同时触发下一次的预读。此时数据会被从磁盘一步读取,可以从图中看出缓存增加。
接下来时间点3,4,应用可以直接从缓存读取数据。由于没有读到有标记的缓存块,因此也不会触发下一次的预读。在时间点5,由于有预读标记,因此又会触发预读的流程。
通过上述分析可以看出,由于预读特性将数据提前读到了缓存当中。应用可以直接从缓存读取数据,而不用再访问磁盘,因此整个访问性能将得到大幅的提升。
本文详解存储卡插入设备后不显示的常见原因,包括物理接触不良、驱动错误及文件系统损坏。提供清洁金手指、重新分配盘符、命令行修复及专业数据恢复软件的实操步骤,帮助用户在保障数据安全的前提下恢复存储卡正常使用。
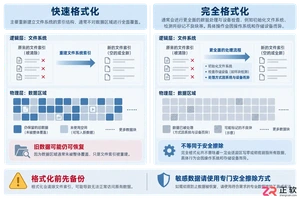
了解U盘格式化的真实含义与风险,掌握Windows和macOS下的正确操作步骤,学习如何选择合适的文件系统,并明确格式化不适用的例外场景,确保数据安全与设备可用。
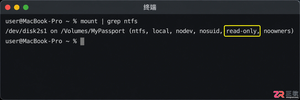
本文详解macOS下Tuxera NTFS驱动写入失败的常见原因,包括Windows未安全弹出导致的脏位锁定、macOS权限干扰及驱动版本兼容性问题,并提供具体的终端命令与系统设置修复方案。
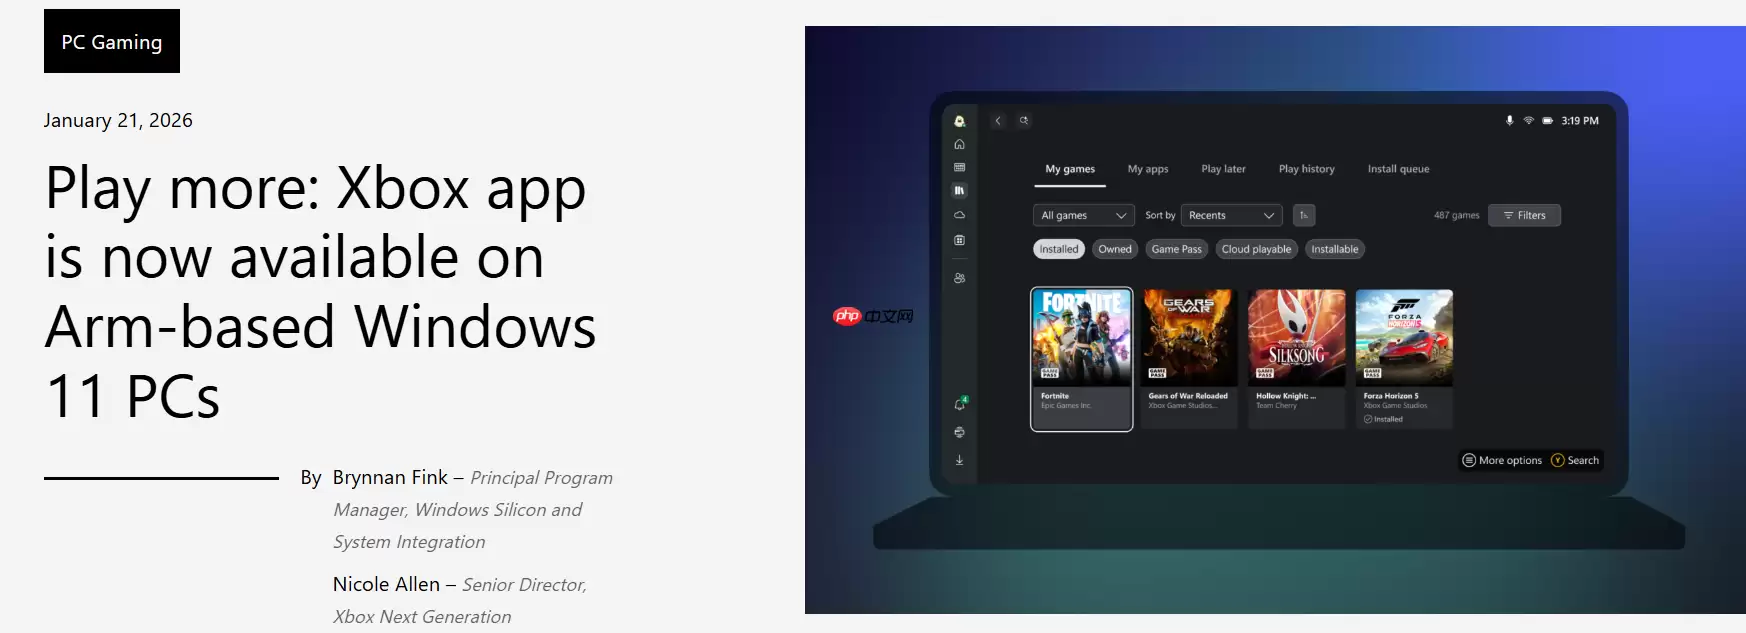
微软Xbox应用正式适配ArmWin11,超85%GamePass原生兼容,不支持的云游戏串流。Prism模拟器支持AVX/AVX2,EAC反作弊整合,WindowsPerformanceFit智能推荐游戏设置。
根据市场研究机构TrendForce最新预估,到2029年,Arm架构笔记本全球市场渗透率将高达34.2%,而AI笔记本渗透率则将从2025年的19.3%大幅提升至84.9%,其中WindowsonArm和苹果M系列成为主要驱动力,英伟达RTXSpark平台则成功将CUDA生态引入笔记本电脑市场。


PHP是一种强大的服务器端脚本语言,被广泛应用于Web开发领域。随着互联网技术的不断发展和微服务架构的兴起,PHP的应用范围也在不断拓展。本文将探讨PHP微服务架构的发展趋势,并通过具体的代码示例来展示其应用。1.微服务架构概述微服务架构是一种将应用程序拆分成小型、可独立部署和管理的服务的架构设计模式。每个微服务都拥有自己的数据库,将原本大型的单体应用分解
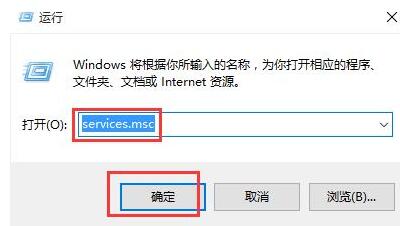
1、按win+r进入运行窗口,输入【services.msc】回车即可。2、在服务窗口中,找到【windowslicensemanagerservice】,双击打开。3、在界面中,将启动类型改为【自动】,然后点击【应用→确定】。4、完成上面的设置,重启电脑即可。
近日,有关AMD正在研发的一款名为SoundWave的Arm架构处理器曝光。据悉,这款处理器采用了先进的台积电3nm工艺,专为5~10W低功耗设备设计,预计将于2026年正式与消费者见面。SoundWave处理器采用了独特的2个P核和4个E核的CPU架构,使得整体性能更加高效。此外,该处理器配备了4MB的L3缓存和16MB的MALL缓存,这种高缓存配置在低功耗APU中实属罕见,有助于提升数据处理速度。在GPU方面,SoundWave包含
在C++中使用filesystem库可以简化文件和目录操作。1)列出目录中的文件,使用directory_iterator。2)创建和删除文件及目录,使用exists()、create_directory()和remove()。3)递归遍历目录,使用recursive_directory_iterator。filesystem库提高了开发效率并增强了代码的可移植性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



