

编程开发
在Ubuntu上配置JSP运行环境,其实流程并不复杂,下面一步步来。JSP是基于Ja va的动态网页技术,所以先把JDK装好,这是前提。推荐使用OpenJDK 11,Ubuntu默认仓库里就有,安装起来很方便。 sudo apt update sudo apt install openjdk-11-
在Ubuntu上部署JSP页面,结果页面死活不显示?这事儿在运维中挺常见的。先说几个关键点,咱们一步步排查,基本上能解决大部分问题。 第一步:确保Ja va和Tomcat就位 Ubuntu上跑JSP,Ja va和Tomcat是绕不开的基础设施。先检查一下这两样东西有没有装好。如果还没装,直接跑下面这
在Ubuntu上把Node.js应用装进容器,听起来像是什么高大上的操作,其实说白了就是借助Docker这把“瑞士军刀”。容器化部署的核心思路很简单:把应用和它的依赖环境打包成一个标准化的单元,走到哪跑到哪,不再被“在我机器上能跑”这种问题困扰。下面就是一套经过多次验证的实操流程,直接照着来就行。
在Ubuntu环境下,Node.js做数据持久化其实有不少成熟的方案。到底选哪种,主要看你的数据规模、访问频率和业务复杂度。这里梳理了三种主流玩法,供你参考。 1. 文件系统:轻量级选手,适合小数据量 Node.js自带的fs模块就是最直接的“存盘”工具。把数据写成JSON文件,存到服务器本地,需要
Ubuntu系统下Node.js内存溢出的解决方法 号外:Node.js应用跑着跑着突然崩了,或者内存占用一路飙升,最后直接报错退出——这种“内存溢出”的坑,相信不少开发者都踩过。尤其是在Ubuntu环境下,如果处理不当,不仅影响线上稳定性,排查起来也够头疼的。别急,这块儿其实有套路可循。下面从头到
要说排查僵尸进程,top 命令确实是个趁手的工具。操作起来并不复杂,但有几个细节值得留意。 首先,打开终端窗口,直接敲 top 回车。系统当前的实时状态就全出来了——哪些进程在跑、CPU 和内存用了多少,一目了然。 怎么在密密麻麻的列表里找到僵尸进程呢?关键看状态栏。正常进程的状态通常是 S(睡眠)
一、Git 基础配置 在用Git之前,有两件事最好先搞定,否则后续操作会处处碰壁。 # 设置全局用户信息(必填,否则无法提交) git config --global user.name "你的用户名" git config --global user.email "你的邮箱@example.com
在软件开发流程里,代码风格检查(Code Linting)几乎是保证代码质量和一致性的标配动作。不过,传统的做法往往把 Lint 放在 Code Review 或者 CI 阶段去跑,这就意味着问题发现得晚,反馈链条拉得长,修改起来也费劲。更理想的做法是:在开发者提交代码之前就把这些检查跑一遍,有问题
git commit提交代码跳过eslint校验 当你执行 git commit -m '提交信息' 想把本地代码推到远程仓库时,如果项目里装了 pre-commit 钩子,Git 会在提交信息输入前自动跑一遍代码风格检查。代码不合规?直接报错,提交被拦下来。下面这张图就是典型的报错现场: 解决方法
从普通目录完成第一次本地提交其实并不难,难的是真实开发很少会一直保持"只改一个文件,然后立刻提交"这种理想状态。 写一个功能的时候,往往会出现好几种情况混在一起: 当前真正要提交的代码; 顺手改了一下但应该单独提交的文档; 运行程序产生的日志文件; 只属于本机环境、不上传配置。 这时候,add 和
说句实话,Spring 的 ApplicationEvent 用起来确实顺手——发布一个事件,多个监听器各自处理,业务代码看起来干净又解耦。但这里必须先划一条线:它并不是消息队列的替代品。不少系统把领域事件、异步任务、跨服务通知一股脑儿全塞进 Spring 事件,最后遇到事务边界、失败重试和实例间通
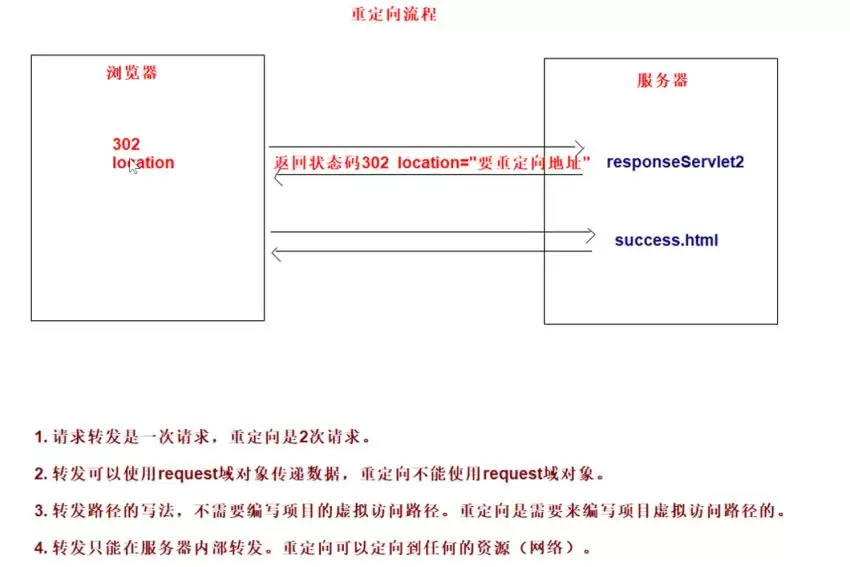
这几天后台收到不少关于 SpringMVC 返回方式的提问,问题集中在几个点上:Controller 方法到底能怎么返回数据?不同返回形式底层流程有什么区别?什么时候页面会404?@ResponseBody 加在哪里?@RestController 原理是什么? 今天这篇文章,就围绕传统服务端渲染(
1. 整合步骤(基于 Spring Boot 官方 Starter) 先说几个关键点,在 Spring Boot 中整合 Druid,官方推荐的做法是直接使用它的 Starter。这样一来,大部分配置工作都能省掉,你只需要关注核心参数的调优。下面就是具体的整合步骤。 第一步:引入 Ma ven 依赖
一、什么是状态机 先说说状态机这个概念。它本质上是一个数学模型,用来描述一个对象在其生命周期里,会经历哪些状态,以及在什么条件下从一个状态跳到另一个状态。说白了,就是给对象画一张“状态流转地图”。 理解状态机,抓住三个核心要素就够了: 状态(State):对象当前处于什么情形。比如订单是“待支付”还
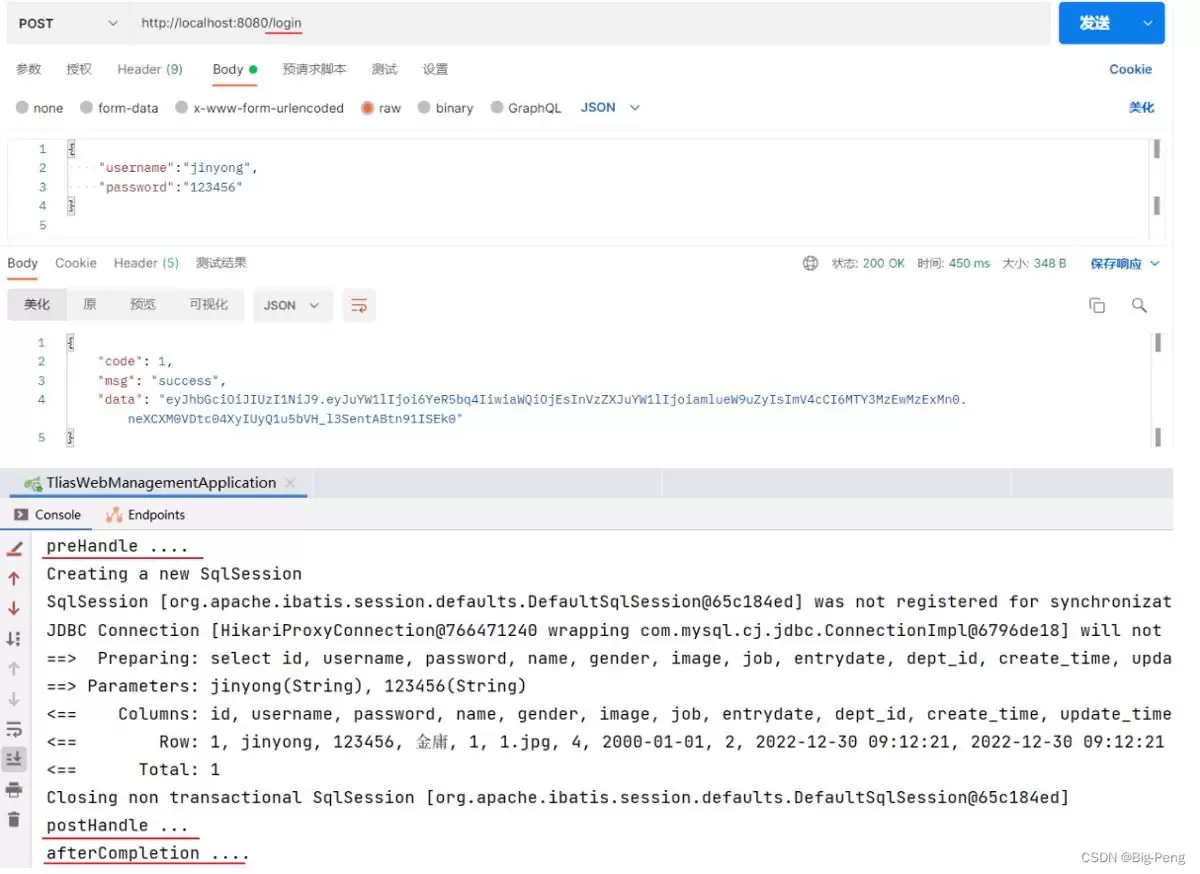
1.快速入门 拦截器是什么?简单来说,它是一种动态拦截方法调用的机制,和过滤器有点像,但它是Spring框架自带的,专门用来动态拦截控制器方法的执行。 那拦截器到底能做什么?最常见的用途就是拦截请求,在指定方法执行前后,根据业务需求插入一些预先写好的逻辑。比如登录校验——我们可以把校验逻辑全塞进拦截
Testcontainers在SpringBoot集成测试中启动Docker容器,用完自动销毁。通过动态注入配置,无需手动搭建环境即可测试MySQL和Redis操作,支持共享容器加速测试,确保数据隔离与环境干净。
SpringRetry通过声明式注解实现接口重试,处理瞬态故障。引入依赖并启用@EnableRetry后,使用@Retryable配置重试次数、间隔和异常类型,@Recover处理最终失败。也可通过RetryTemplate编程式控制重试逻辑,适用于秒杀等场景,但需注意幂等性。
将本地业务数据渲染为PDF文档,上传至文件服务器获取公网链接,再提交给外部签约平台创建电子合同。该流程通过上传URL而非PDF内容,避免请求超时和网关限制,实现解耦与高效处理。
使用C#调用Spire.Doc组件可清理Word文档中的空行。通过遍历文档所有段落,判断段落内容是否为空,将空白段落移除,最后保存为新文档。该方法能批量处理,提升文档结构紧凑性和阅读体验,适用于文档自动化整理场景。
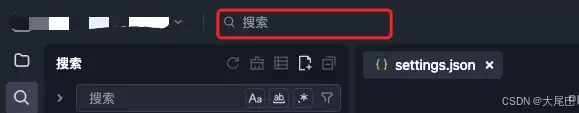
找到setting.json文件 Trae的配置入口藏得不算深,但第一次找确实容易摸不着头脑。其实用它的内置搜索功能,直接搜“setting.json”就能定位到全局配置文件——这也是修改默认JDK的关键一步。 修改JDK版本 前提:确保你已经安装了对应版本的JDK,并且知道它的安装路径。 在set
1. 准备Python开发环境 在Ubuntu上搞Python图形界面开发,先得把基础环境搭好。这步没什么悬念,几条命令就能搞定: 更新软件包列表并安装Python3及pip:sudo apt update && sudo apt install python3 python3-pip (可选)创建
Python项目在Ubuntu上部署,其实没那么玄乎。从环境准备到Nginx反向袋里,背后就是一套标准流程。今天咱们就把这活儿拆开,一步步说清楚——保证你照着弄就能跑起来。 1. 准备基础环境 先把系统包列表刷新一下,顺手装上Python3和pip——这是Python运行环境的老本行,缺一不可: s
在Ubuntu环境下调试Python代码,其实有不少顺手的方法。从最轻量的命令行工具,到功能齐全的IDE,再到一些能自动记录执行过程的“黑科技”,每个场景都有对应的解决方案。下面就把这些常用的调试手段梳理一遍,希望能帮你更高效地定位问题。 1. 使用内置pdb模块(命令行调试) pdb是Python


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



