

编程开发
在Debian系统上搭建C++项目,其实没有想象中那么复杂。只要把工具链理清楚,从编译、构建到打包,每一步都有对应的最佳实践。下面就把整个流程拆开来讲,手把手带你走一遍。 1. 准备开发环境 Debian系统上构建C++项目,第一步自然是安装基础工具链。打开终端,先更新软件包列表,然后安装build
在Debian系统上搭建C++编译环境,其实并不复杂,跟着下面这些步骤走,基本不会踩坑。 1. 更新系统软件包列表 先把系统里的软件包信息更新一下,这样才能拿到最新的资源。终端里敲一下这条命令: sudo apt update 2. 安装基础编译工具链 一个命令就能搞定全套编译工具——GCC(C编译
Debian C++编译器选择指南 敲代码久了,难免会遇到一个经典问题:在Debian里写C++,到底该用哪个编译器? 这个问题没有标准答案,但确实有章可循。下面把几个主流选手的优缺点、适用场景,以及一些实用技巧,一次性说清楚。 一、Debian下主流C++编译器及安装 1. GCC(GNU Com
1. 从一次典型的“CUDA不可用”报错说起 在Conda创建的PyTorch虚拟环境里跑深度学习代码,十有八九会遇到那个让人血压飙升的错误:RuntimeError: CUDA error: no kernel image is available for execution on the dev
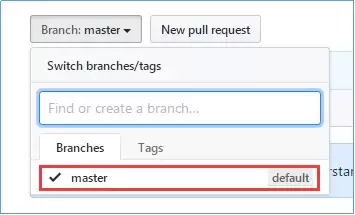
一、本地→远程 GitHub上默认只有一个master分支,这个大家都清楚。不过,当我们在本地创建一个新的分支,比如叫kenny-feng,然后想把本地这个分支的内容推送到远程时,事情就没那么简单了。 直接执行git push,会收到一个报错: The current branch kenny-fe
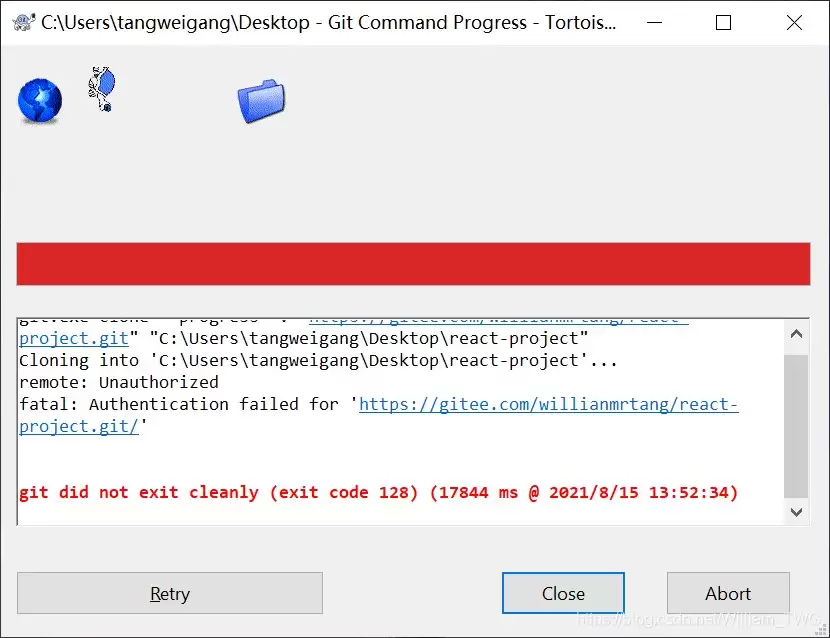
最近在Gitee上新建了一个仓库,准备clone到本地开始编码,结果迎面就是一个报错,git did not exit cleanly (exit code 128)。看到这个错误,第一反应当然是去搜一搜解决方案。但搜了一圈下来,发现不少文章内容高度雷同——有人解决了问题,后面的人就直接把答案复制粘
09 | 重构项目结构 本文目标 前面三篇已经完成了生成阶段的元数据同步工作: 把表、字段、指标和它们之间的关联关系写入 MySQL meta 库 把字段和指标的向量写入 Qdrant 把低基数的维度值写入 Elasticsearch 等功能逐渐完善了,原先的目录结构就开始暴露出一些问题。这些问题其
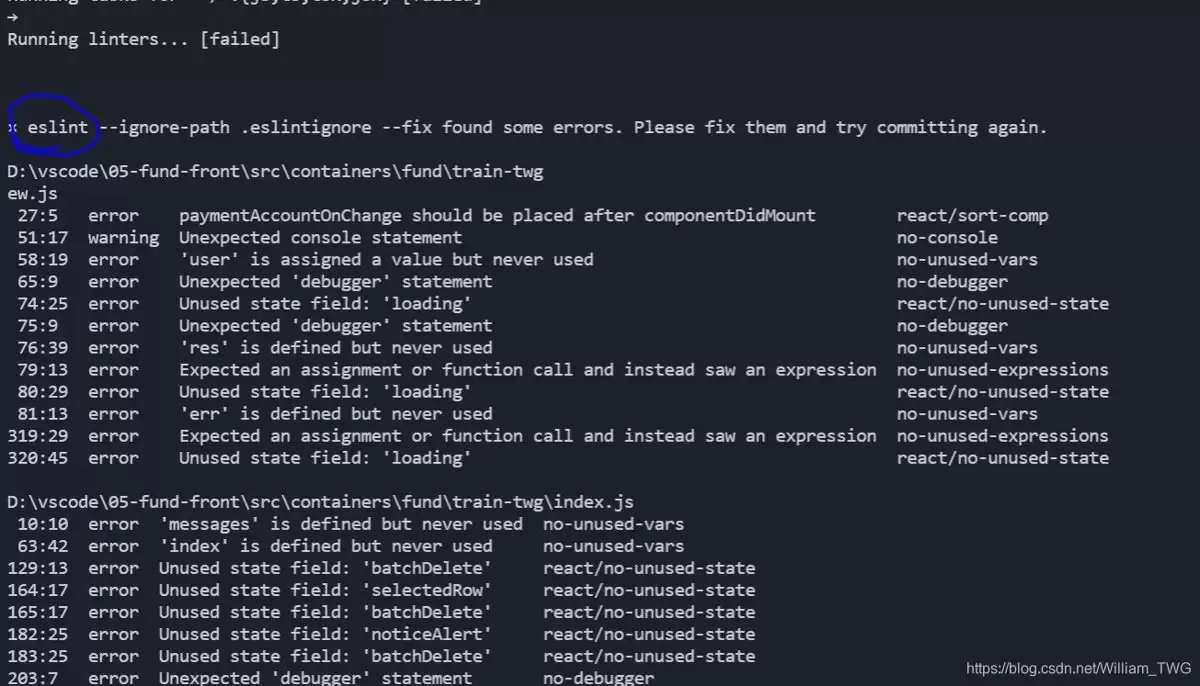
错误描述 最近在项目开发中用git commit提交代码到本地仓库时,突然报错。代码本身逻辑完全没问题,问题出在规范校验上——说白了就是ESLint在“挑刺”。 错误信息如下: 做过前端的朋友一眼就能认出,这是ESLint在pre-commit钩子里搞的鬼。如果你眼下只想快速提交,不打算纠结代码规范
在 Git 的使用过程中,很多人都遇到过这样的事:git add 加错了文件,刚提交就发现漏改了一处,已经推送的代码需要撤回,或者误执行了 git reset --hard。这些情况,显然不能用同一条命令来处理。 关键是要先确认改动在哪一层——工作区、暂存区、本地提交,还是已经推送给他人?然后从 r
1. 项目概述:从“empty”函数窥探C++队列的基石 在C++标准模板库(STL)里,std::queue这个队列容器适配器,大家应该都不陌生。它严格遵循先进先出(FIFO)的原则,跟现实生活中排队买票一个道理——先来的先服务。平时聊到队列,焦点往往落在push(入队)、pop(出队)、fron
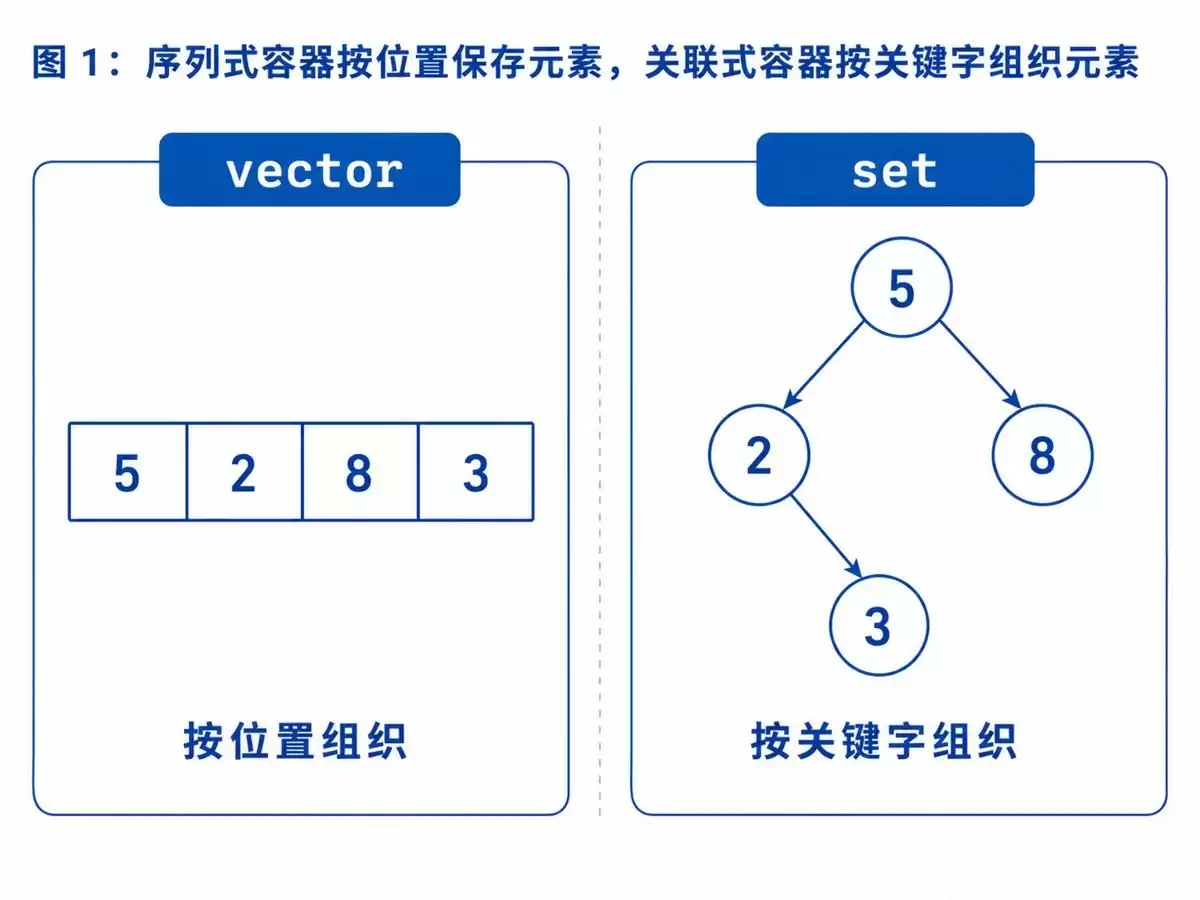
一、序列式容器和关联式容器 1.1 序列式容器按位置组织元素 序列式容器里,常见的有这么几个: std::vector std::list std::deque std::array std::forward_list 数据是按照它们在容器中的位置来组织的。 举个例子: std::vector va
1. 项目概述:从字符到数字的桥梁 在C#编程的日常里,字符处理是绕不开的基础。无论是解析网络协议、处理用户输入,还是进行简单的数据加密,我们常常需要窥探字符背后的“数字身份”——ASCII码。这个项目,就是搭建一座连接字母(字符)与ASCII码的桥梁。乍一看,这似乎是个简单的“一行代码”任务,但深
前言 算法面试中,最怕的不是题目难,而是见过但写不出来。这里整理了一份高频算法题的实战清单,覆盖了排序、搜索、动态规划、链表、树、图等核心类别,每个题目都附上了可直接运行的Java实现。为了方便理解,每个题目都拆成了三部分:问题描述、核心思路、以及代码解答。所有代码都经过实际测试,可以直接复制到项目
1、问题描述 在实际开发中,有时会遇到一个奇怪的现象:用 MybatisPlus 查询数据,返回的列表条数是对的,但每个元素都是 null,程序也不报错。先看一段出问题的代码: 1、自定义的 StudentMapper 继承了 BaseMapper 接口: public interface Stud
08 | 把维度值同步到 Elasticsearch(生成阶段)本文是系列文的第八篇,建议按顺序阅读。 本文目标 上一篇已经完成了字段和指标的向量化:把 name + description + alias 转换成向量并写入 Qdrant,用于召回相关字段和指标。 这一篇继续完成生成阶段的第 3 步
写在前面 上一篇聊了可变默认参数的坑,本质是"该新建对象却没新建,所有调用共享同一份数据"。今天这篇,咱们把话题再往前推一步:就算你主动写了"拷贝"代码,如果没搞清楚拷贝的层级,一样会踩到几乎一模一样的坑。 最典型的场景:你想复制一份配置字典留着自己改,顺手用了 config.copy(),结果改着
在Debian上配置Tomcat时,版本匹配是个绕不开的坎儿。很多人一开始没留意,结果启动时报错,排查半天才发现是Ja va版本不对。其实,搞清楚Tomcat和Ja va之间的兼容关系,这事就能省下一大半的折腾。下面咱们直接进入正题。 一、Tomcat与Ja va版本核心兼容关系 Tomcat的版本
在Ubuntu系统上跑Node.js应用,难免会遇到性能瓶颈。怎么精准定位这些“卡点”?下面这几种方法,可以说是业内比较成熟的实践路径,值得花时间梳理清楚。 用Node.js内置的V8分析器 Node.js自带的V8 Profiler是个好东西。启动应用时加上--inspect-brk标志,比如:
日志优化,是Ubuntu上Node.js部署中一个常被忽视但极其关键的环节。它不仅能帮你摸清应用的性能底细,还能在故障发生时快速定位问题,甚至直接提高系统的整体稳定性。下面这几个步骤,是实践下来最值得投入的做法。 1. 把日志记录做“细” 先确保Node.js应用本身能输出足够详细的日志。别只靠co
在Ubuntu系统上管理Node.js应用的日志访问权限,其实是一件挺基础但也容易被忽略的操作。很多新手在部署应用时,往往只关注代码本身,却忘了日志文件的安全配置——结果就是敏感信息可能被随意读取。下面就来拆解一下具体怎么操作。 首先,确保你的Node.js应用正在运行。如果还没启动,用 node
准备工作:更新系统 在部署JSP之前,得先把Ubuntu系统的软件包更新到最新版本——这一步看似基础,但能避免后续很多依赖冲突。打开终端,敲下这两条命令就行: sudo apt update && sudo apt upgrade -y 安装Ja va开发环境(JDK) JSP跑在Ja va上,所以
在Ubuntu环境下进行JSP开发,工具的选型直接影响开发效率与体验。下面结合主流场景,从集成开发环境、服务器、数据库、版本控制、构建工具到轻量级编辑器,梳理一份实用推荐清单。 1. 集成开发环境(IDE) Eclipse:开源免费的Java EE IDE,插件生态非常丰富,比如“Eclipse W
迁移前准备 先把迁移前的准备工作捋清楚,这会省去后面很多麻烦。 摸清源环境底细:记下原服务器的JDK版本(比如是OpenJDK 8还是11)、Tomcat版本(比如9.x)、项目依赖了哪些数据库和第三方库,以及项目结构长什么样——WEB-INF/lib下有哪些JAR包、web.xml怎么配置的,还有


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



