

多层目录导入字典生成Pandas数据框
本文详细阐述了如何从嵌套目录结构中的多个Python文件中提取字典数据,并将其整合构建成一个PandasDataFrame。教程涵盖了文件系统遍历、Python文件内容读取、安全地将字符串表示的字典转换为实际字典对象,以及最终使用Pandas库进行数据框的构建与合并。通过本教程,读者将学会如何自动化处理分散在项目文件中的结构化配置数据。

本文详细阐述了如何从嵌套目录结构中的多个Python文件中提取字典数据,并将其整合构建成一个Pandas DataFrame。教程涵盖了文件系统遍历、Python文件内容读取、安全地将字符串表示的字典转换为实际字典对象,以及最终使用Pandas库进行数据框的构建与合并。通过本教程,读者将学会如何自动化处理分散在项目文件中的结构化配置数据。
在软件开发和数据处理的场景中,我们经常会遇到需要从项目结构中分散的多个文件中收集特定数据的情况。例如,在一个包含多层子目录的项目中,每个子目录可能包含一个Python文件(如form.py),这些文件内部定义了一个或多个字典,用于存储配置或元数据。这些字典通常具有相同的键结构,但值各异。本教程将指导您如何高效地遍历这些文件,提取所需的字典,并最终将它们合并成一个统一的Pandas DataFrame,以便于后续的数据分析或报告。
1. 文件系统遍历与目标文件识别
首先,我们需要一种机制来遍历复杂的目录结构,找到所有包含目标字典的Python文件。Python的os模块提供了强大的文件系统操作功能,其中os.walk()是遍历目录树的理想工具。
os.walk(top)会生成一个三元组(dirpath, dirnames, filenames),分别代表当前目录路径、当前目录下的子目录列表和当前目录下的文件列表。我们可以利用这一特性来定位所有符合条件的文件。
假设我们的目标文件名为form.py,并且它们位于一个基础路径(例如os.environ["JUPYTER_ROOT"] + "/charts/")下的任意子目录中。
import os
import pandas as pd
import ast # 用于安全地评估字符串为Python对象

# 定义您的基础路径
base_path = os.environ.get("JUPYTER_ROOT", "/home/jovyan/work/notebooks") + "/charts/"

# 初始化一个空列表来存储所有提取的字典
all_dictionaries = []

for root, dirs, files in os.walk(base_path):
    for file in files:
        if file.endswith("form.py"):
            file_path = os.path.join(root, file)
            # 后续步骤将在此处处理每个文件
            print(f"发现文件: {file_path}")
在上述代码中,os.path.join(root, file)用于构建文件的完整路径,确保跨操作系统的路径兼容性。
2. 从Python文件中安全提取字典
找到目标文件后,下一步是打开文件并从中提取字典。由于这些字典是作为Python代码的一部分存在的(例如def_options = {'name': '...', 'age': ...}),我们不能简单地将其视为JSON或YAML文件。直接使用eval()函数来解析文件内容是危险的,因为它可能执行任意代码。相反,ast.literal_eval()是一个更安全的替代方案,它只能评估包含Python字面量结构(字符串、数字、元组、列表、字典、布尔值和None)的字符串。
为了确保只提取到我们想要的字典,我们需要:
- 逐行读取文件内容。
- 识别包含字典定义的行。这通常可以通过检查行中是否包含字典的关键键(例如"name"和"age")以及字典赋值的模式(例如def_options = { ... })来实现。
- 从该行中提取纯粹的字典字符串部分。
- 使用ast.literal_eval()将其转换为Python字典对象。
# ... (承接上一步的代码)

for root, dirs, files in os.walk(base_path):
    for file in files:
        if file.endswith("form.py"):
            file_path = os.path.join(root, file)
            print(f"正在处理文件: {file_path}")

            with open(file_path, "r", encoding="utf-8") as f:
                for line in f:
                    data_str = line.strip()
                    # 检查行是否包含我们预期的字典内容和赋值模式
                    # 假设字典定义模式为 'variable_name = { ... }'
                    # 并且字典内包含 'name' 和 'age' 键
                    if "def_options =" in data_str and "'name'" in data_str and "'age'" in data_str:
                        try:
                            # 提取等号右侧的字典字符串
                            # 注意:这里假设字典定义在单行
                            data_dic_only = data_str.split("=", 1)[1].strip()

                            # 使用 ast.literal_eval 安全地将字符串转换为字典
                            dictionary = ast.literal_eval(data_dic_only)
                            all_dictionaries.append(dictionary)
                            print(f"  成功提取字典: {dictionary}")
                            # 假设每个文件只包含一个目标字典,提取后即可跳出内层循环
                            break
                        except (ValueError, SyntaxError) as e:
                            print(f"  警告: 无法从文件 {file_path} 的行 '{data_str}' 中解析字典: {e}")
                            continue # 继续查找下一行
注意事项:
- encoding="utf-8":在打开文件时指定编码是一个好习惯,可以避免因编码问题导致的错误。
- data_str.split("=", 1)[1].strip():这行代码将字符串在第一个等号处分割,并取第二部分(即等号右侧),然后去除首尾空白。这要求字典定义严格遵守variable_name = { ... }的格式且在单行。
- 错误处理:try-except块用于捕获ast.literal_eval可能抛出的ValueError或SyntaxError,这在处理格式不一致的文件时非常重要。
- 字典键检查:"'name'" in data_str and "'age'" in data_str是一个简单的启发式方法来判断当前行是否包含目标字典。更健壮的方法可能需要正则表达式,或者如果字典定义有固定的变量名,可以直接检查data_str.startswith("def_options =")。
3. 构建与合并Pandas DataFrame
一旦我们收集了所有提取到的字典,最后一步就是将它们转换成Pandas DataFrame并合并。每个字典可以被视为DataFrame的一行数据。
# ... (承接上一步的代码)

# 确保 all_dictionaries 不为空
if all_dictionaries:
    # 将字典列表转换为Pandas DataFrame
    # from_records 可以处理字典列表,并自动将键作为列名
    final_df = pd.DataFrame.from_records(all_dictionaries)
    print("\n成功构建最终DataFrame:")
    print(final_df.head())
    print(f"\nDataFrame形状: {final_df.shape}")
else:
    print("\n未找到任何符合条件的字典,无法构建DataFrame。")
pd.DataFrame.from_records(all_dictionaries)是处理字典列表的推荐方法,它会自动将每个字典的键作为DataFrame的列,并将字典的值作为对应行的值。如果所有字典的键都相同,这将生成一个结构规整的DataFrame。如果键不完全一致,Pandas会自动用NaN填充缺失值。
总结
通过上述步骤,我们构建了一个完整的解决方案,能够:
- 使用os.walk()遍历复杂的文件系统结构,定位目标Python文件。
- 安全地使用ast.literal_eval()从Python文件中提取字典字符串并将其转换为Python字典对象,避免了eval()带来的安全风险。
- 利用Pandas的强大功能,将所有提取到的字典高效地整合为一个统一的DataFrame。
这个方法对于自动化处理项目配置、元数据或其他以Python字典形式分散存储的数据非常有效,极大地提高了数据收集和预处理的效率。在实际应用中,您可能需要根据字典定义的具体格式和复杂性,调整文件内容解析的逻辑,例如使用正则表达式来处理更复杂的字典定义模式,或者考虑字典跨多行的情况。
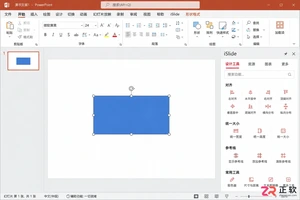
iSlide设计工具侧边栏不见了怎么办?本教程详解在Windows版PPT中通过【设计工具】按钮恢复侧边栏的方法,涵盖面板拖拽、模块隐藏检查及插件加载异常的处理,同时提供macOS用户的使用指引。

全面盘点Flutter主流状态管理框架,深度解析Provider、Riverpod、Bloc与GetX的核心机制、优缺点及适用场景,提供系统化的状态管理选型指南。
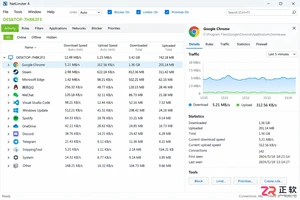
新手入门 NetLimiter 必读指南。详解 Activity 实时监控、DL/UL Limit 限速设置、Blocker 阻止规则及 Stats 流量统计功能。图文结合展示规则编辑器操作,助你轻松管理 Windows 应用网络带宽。
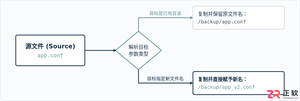
在Linux系统中,复制文件并改名并没有单独的独立命令,而是通过标准复制命令cp在指定目标路径时直接写上新文件名来完成。本文详解cp命令复制并重命名的操作语法、同目录与跨目录示例、常用安全参数及目录复制实践。
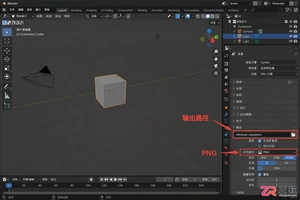
学习如何将Blender中的动态材质导出为图片序列。涵盖输出路径设置、PNG格式选择、帧范围确认及Image Sequence贴图的重新载入方法,适合需要保留透明通道或后期处理的动画贴图工作流。
想在iPhone或iPad上实现锁屏一键直达?本文详解“锁屏启动”的安装前检查清单、系统权限配置步骤及小组件添加方法,解决组件不显示、点击无反应等常见问题,确保快捷指令、网页和App快速启动。
学习如何在Blender中使用HDRI进行渲染。通过World着色器连接Environment Texture节点,调整光照强度与环境方向,解决背景显示与曝光问题,快速提升场景真实感。
深入详解在SQL中进行条件判断字符串不包含某个子串的方法,涵盖标准NOT LIKE、各主流数据库(MySQL、PostgreSQL、SQL Server、Oracle)专有位置函数、正则表达式判断,剖析NULL值三值逻辑陷阱及全表扫描性能优化策略。
新手必读的IDM安装配置教程。从官方下载开始,逐步讲解如何完成Windows安装、启用Chrome/Edge/Firefox浏览器扩展、设置默认保存目录及调整连接线程,解决IDM不弹窗接管下载的常见问题。
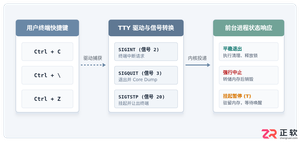
全面解析Linux终端中终止进程的核心快捷键(Ctrl+C、Ctrl+Z、Ctrl+\)的原理、区别与具体使用方法,附后台恢复与强制终止全流程指南。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。