

使用Python中的TF-IDF算法和词云生成器,生成文档关键字权重并可视化为词云
1.根据tf-idf计算一个文档的关键词或者短语:代码如下:注意需要安装pipinstallsklean;fromreimportsplitfromjieba.possegimportdtfromsklearn.feature_extraction.textimportTfidfVectorizerfromcollectionsimportCounterfromtimeimporttimeimportjieba#pipinstallskleanFLAGS=set('aanbfijlnnrnrfgn
1. 根据tf-idf计算一个文档的关键词或者短语:
代码如下:
注意需要安装pip install sklean;
from re import split
from jieba.posseg import dt
from sklearn.feature_extraction.text import TfidfVectorizer
from collections import Counter
from time import time
import jieba


#pip install sklean


FLAGS = set('a an b f i j l n nr nrfg nrt ns nt nz s t v vi vn z eng'.split())

def cut(text):
    for sentence in split('[^a-zA-Z0-9\u4e00-\u9fa5]+', text.strip()):
        for w in dt.cut(sentence):
            if len(w.word) > 2 and w.flag in FLAGS:
                yield w.word

class TFIDF:
    def __init__(self, idf):
        self.idf = idf

    @classmethod
    def train(cls, texts):
        model = TfidfVectorizer(tokenizer=cut)
        model.fit(texts)
        idf = {w: model.idf_[i] for w, i in model.vocabulary_.items()}
        return cls(idf)

    def get_idf(self, word):
        return self.idf.get(word, max(self.idf.values()))

    def extract(self, text, top_n=10):
        counter = Counter()
        for w in cut(text):
            counter[w] += self.get_idf(w)
        #return [i[0:2] for i in counter.most_common(top_n)]
        return [i[0] for i in counter.most_common(top_n)]


if __name__ == '__main__':
    t0 = time()
    with open('./nlp-homework.txt', encoding='utf-8')as f:
        _texts = f.read().strip().split('\n')
        # print(_texts)
    tfidf = TFIDF.train(_texts)
    # print(_texts)
    for _text in _texts:
        seq_list=jieba.cut(_text,cut_all=True)  #全模式
        # seq_list=jieba.cut(_text,cut_all=False)  #精确模式
        # seq_list=jieba.cut_for_search(_text,)    #搜索引擎模式
        # print(list(seq_list))
        print(tfidf.extract(_text))
        with open('./resultciyun.txt','a+', encoding='utf-8') as g:
            for i in tfidf.extract(_text):
                g.write(str(i) + " ")
    print(time() - t0)
2. 生成词云:
代码如下:
注意需要安装
pip install wordcloud;以及为了保证中文字体正常显示,需要下载
SimSun.ttf字体,并且将这个字体包也放在和程序相同的目录下;
from wordcloud import WordCloud
filename = "resultciyun.txt"
with open(filename) as f:
 resultciyun = f.read()

wordcloud = WordCloud(font_path="simsun.ttf").generate(resultciyun)
# %pylab inline
import matplotlib.pyplot as plt
plt.imshow(wordcloud, interpolation='bilinear')
plt.axis("off")
plt.show()
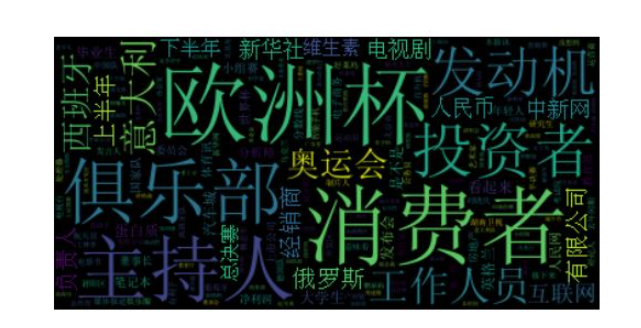
3 最后词云的图片

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



