

Transformer本可以深谋远虑,但就是不做
语言模型是否会规划未来token?这篇论文给你答案。「别让YannLeCun看见了。」YannLeCun表示太迟了,他已经看到了。今天要介绍的这篇「LeCun非要看」的论文探讨的问题是:Transformer是深谋远虑的语言模型吗?当它在某个位置执行推理时,它会预先考虑后面的位置吗?这项研究得出的结论是:Transformer有能力这样做,但在实践中不会这样做。我们都知道,人类会思考而后言。十年的语言学研究表明:人类在使用语言时,内心会预测即将出现的语言输入、词或句子。不同于人类,现在的语言模型在「说话」
语言模型是否会规划未来 token?这篇论文给你答案。
「别让 Yann LeCun 看见了。」
Yann LeCun 表示太迟了,他已经看到了。今天要介绍的这篇 「LeCun 非要看」的论文探讨的问题是:Transformer 是深谋远虑的语言模型吗?当它在某个位置执行推理时,它会预先考虑后面的位置吗?
这项研究得出的结论是:Transformer 有能力这样做,但在实践中不会这样做。
我们都知道,人类会思考而后言。十年的语言学研究表明:人类在使用语言时,内心会预测即将出现的语言输入、词或句子。
不同于人类,现在的语言模型在「说话」时会为每个 token 分配固定的计算量。那么我们不禁要问:语言模型会和人类一样预先性地思考吗?
根据最近的一些研究已经表明:可以通过探查语言模型的隐藏状态来预测下一 token。有趣的是,通过在模型隐藏状态上使用线性探针,可以在一定程度上预测模型在未来 token 上的输出,并且可以对未来输出进行可预测的修改。 近期的一些研究已经表明,可以通过探查语言模型的隐藏状态来预测下一 token。有趣的是,通过在模型隐藏状态上使用线性探针,可以在一定程度上预测模型在未来 token 上的输出,并且可以对未来输出进行可预测的修改。
这些发现表明在给定时间步骤的模型激活至少在一定程度上可以预测未来输出。
但是,我们还不清楚其原因:这只是数据的偶然属性,还是因为模型会刻意为未来时间步骤准备信息(但这会影响模型在当前位置的性能)?
为了解答这一问题,近日科罗拉多大学博尔德分校和康奈尔大学的三位研究者发布了一篇题为《语言模型是否会规划未来 token?》的论文。
论文标题:Do Language Models Plan for Future Tokens?
论文地址:https://arxiv.org/pdf/2404.00859.pdf
研究概览
他们观察到,在训练期间的梯度既会为当前 token 位置的损失优化权重,也会为该序列后面的 token 进行优化。他们又进一步问:当前的 transformer 权重会以怎样的比例为当前 token 和未来 token 分配资源?
他们考虑了两种可能性:预缓存假设(pre-caching hypothesis)和面包屑假设(breadcrumbs hypothesis)。
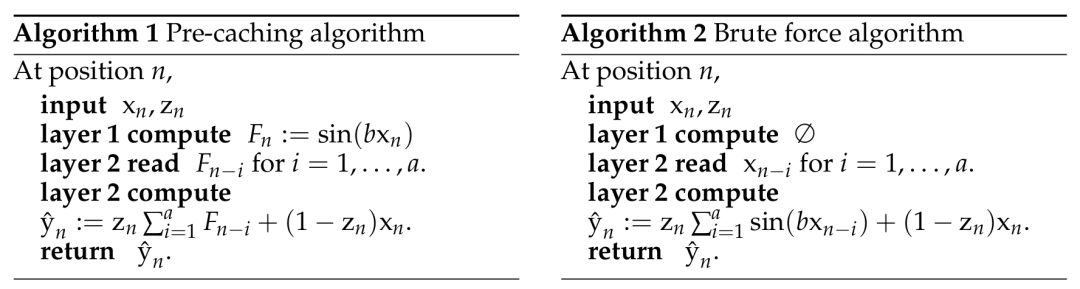
预缓存假设是指 transformer 会在时间步骤 t 计算与当前时间步骤的推理任务无关但可能对未来时间步骤 t + τ 有用的特征,而面包屑假设是指与时间步骤 t 最相关的特征已经等同于将在时间步骤 t + τ 最有用的特征。
为了评估哪种假设是正确的,该团队提出了一种短视型训练方案(myopic training scheme),该方案不会将当前位置的损失的梯度传播给之前位置的隐藏状态。
对上述假设和方案的数学定义和理论描述请参阅原论文。
实验结果
为了了解语言模型是否可能直接实现预缓存,他们设计了一种合成场景,其中只能通过显式的预缓存完成任务。他们配置了一种任务,其中模型必须为下一 token 预先计算信息,否则就无法在一次单向通过中准确计算出正确答案。
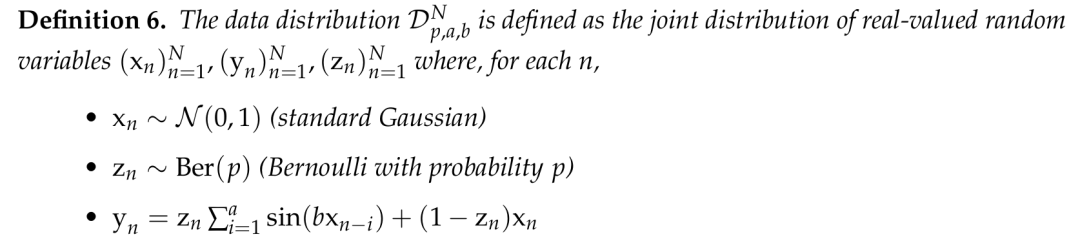
该团队构建的合成数据集定义。
在这个合成场景中,该团队发现了明显的证据可以说明 transformer 可以学习预缓存。当基于 transformer 的序列模型必须预计算信息来最小化损失时,它们就会这样做。
之后,他们又探究了自然语言模型(预训练的 GPT-2 变体)是会展现出面包屑假设还是会展现出预缓存假设。他们的短视型训练方案实验表明在这种设置中,预缓存出现的情况少得多,因此结果更偏向于面包屑假设。
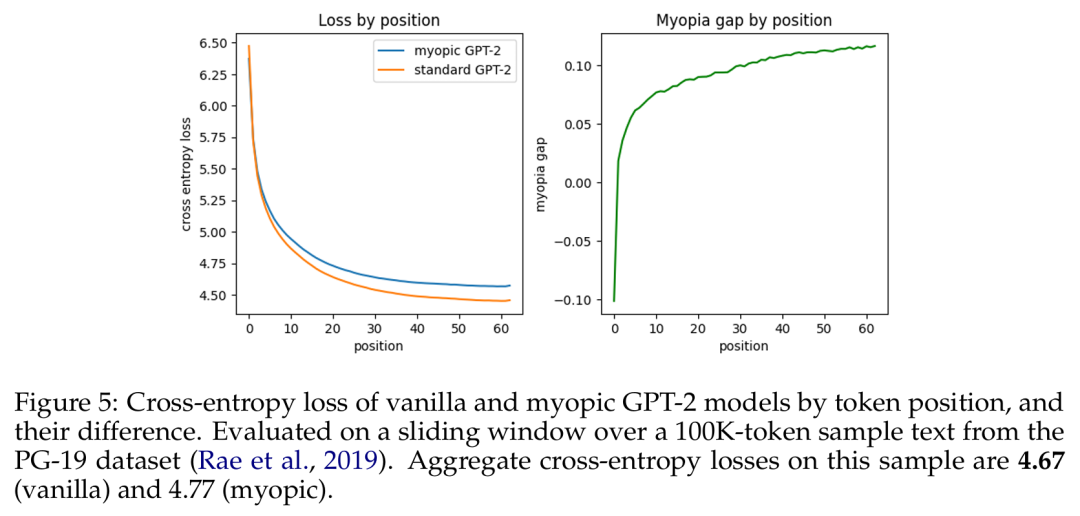
基于 token 位置的原始 GPT-2 模型与短视型 GPT-2 模型的交叉熵损失及其差异。
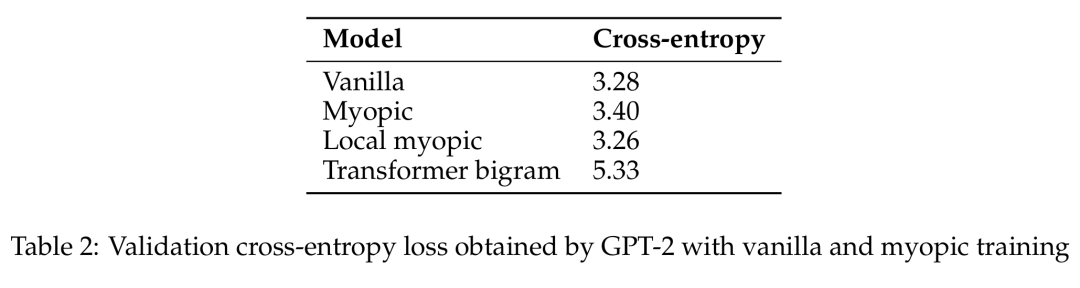
GPT-2 通过原始和短视型训练获得的验证交叉熵损失。
于是该团队声称:在真实语言数据上,语言模型并不会在显著程度上准备用于未来的信息。相反,它们是计算对预测下一个 token 有用的特征 —— 事实证明这对未来的步骤也很有用。
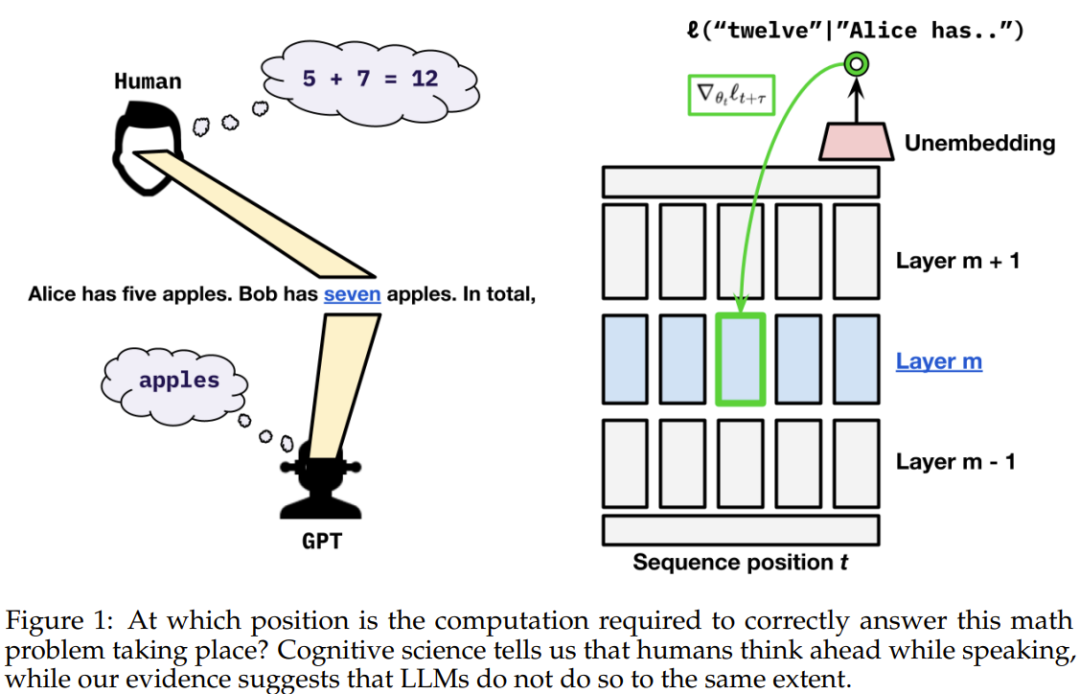
该团队表示:「在语言数据中,我们观察到贪婪地针对下一 token 损失进行优化与确保未来预测性能之间并不存在显著的权衡。」
因此我们大概可以看出来,Transformer 能否深谋远虑的问题似乎本质上是一个数据问题。
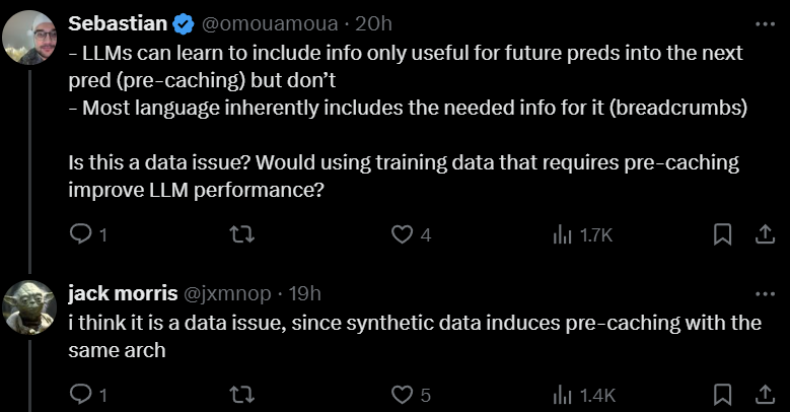
可以想象,也许未来我们能通过合适的数据整理方法让语言模型具备人类一样预先思考的能力。

3月28日,OPPOFind系列产品负责人周意保在微博发文,表示OPPO已经进入了5.5G时代。OPPOFindX7系列周意保在微博上传了一张截图,图中的手机锁屏界面右上方状态栏信号一栏显示为5GA,也就是人们更加熟悉的5.5G。此外,周意保也发文称:"和大家一起进入5.5G新移动网络时代!"宣布了5.5G新移动网络时代的到来。OPPOFind系列产品负责人周意保微博有博主表示,OPPOFindX7系列即将行业首发支持5G-A(5.5G),OTA固件已经准备好了。5G-A理论上可以实现10倍提升的连接速率
作者|香港中文大学白帆编辑|ScienceAI近日,香港中文大学和智源联合提出的M3D系列工作,包括M3D-Data,M3D-LaMed和M3D-Bench,从数据集、模型和测评全方面推动3D医学图像分析的发展。(1)M3D-Data是目前最大的3D医学图像数据集,包括M3D-Cap(120K3D图文对),M3D-VQA(510K问答对),M3D-Seg(150K3DMask),M3D-RefSeg(3K推理分割)共四个子数据集。(2)M3D-LaMed是目前最多功能的3D医学多模态大模型,能够解决文本(
编辑|紫罗AI在简化药物发现方面的应用正在爆炸式增长。从数十亿种候选分子中筛选出可能具有开发新药所需特性的分子。需要考虑的变量太多了,从材料价格到出错的风险,即使科学家使用AI,权衡合成最佳候选分子的成本也不是一件容易的事。在此,MIT研究人员开发了一个定量决策算法框架SPARROW,来自动识别最佳分子候选物,从而最大限度地降低合成成本,同时最大限度地提高候选物具有所需特性的可能性。该算法还确定了合成这些分子所需的材料和实验步骤。SPARROW考虑了一次合成一批分子的成本,因为多个候选分子通常可以从一些相
编辑|萝卜皮OpenAI的GPT和MetaAI的Llama等大型语言模型(LLM)因其在化学信息学领域的潜力而日益受到认可,特别是在理解简化分子输入行输入系统(SMILES)方面。这些LLM还能够将SMILES字符串解码为矢量表示。加拿大温莎大学(UniversityofWindsor)的研究人员比较了GPT和Llama与SMILES上的预训练模型在下游任务中嵌入SMILES字符串的性能,重点关注两个关键应用:分子特性预测和药物-药物相互作用预测。该研究以「Canlargelanguagemodelsun
编辑|萝卜皮在处理语言时,大脑会部署专门的计算来从复杂的语言结构中构建含义。基于Transformer架构的人工神经网络是自然语言处理的重要工具。普林斯顿大学的研究人员探讨了Transformer模型和人类大脑在语言处理中的功能特殊化问题。Transformer通过结构化电路计算整合单词间的上下文信息。不过,当前的研究主要集中于这些电路生成的内部表征(「嵌入」)。研究人员直接分析电路计算:他们将这些计算解构为功能专门的「transformations」,将跨词语的上下文信息整合在一起。利用参与者聆听自然故
编辑|X人工智能(AI)在过去几年中以惊人的速度发展。一些科学家现在着眼于超级人工智能(ArtificialSuperintelligence,ASI)的发展,这是一种不仅超越人类智能,而且不受人类学习速度限制的AI。超级人工智能的发展可能会带来巨大的影响和挑战。一方面,它可能为我们带来前所未有的技术进步和创新,解决各种复杂的问题。另一方面,由于其超越人类智慧的能力,我们也需要谨慎对待和管理它的发展,以避免可能的风险和危害。因此但如果这个里程碑不仅仅是一项了不起的成就呢?如果它也代表了所有文明发展的一个巨
编辑|枯叶蝶准确识别药物-靶标相互作用(DTI)是药物发现和药物重新定位过程中的关键步骤之一。目前,许多基于计算的模型已被提出,用于预测DTI,并取得了一些显著的进步。然而,这些方法很少关注如何以适当的方式融合与药物和靶标相关的多视角相似性网络。此外,如何充分结合已知的相互作用关系来准确表示药物和靶标尚未得到很好的研究。因此,提高DTI预测模型的准确性仍然是必要的。在最新的研究中,郑州大学、电子科技大学团队提出了一种新方法MIDTI。该方法采用多视图相似性网络融合策略和深度交互式注意机制来预测药物-靶标相
来自清华大学AIR、北京大学、南京大学的研究团队提出了ESM-AA模型。该模型在蛋白质语言建模领域取得了重要进展,提供了一套整合多尺度信息的统一建模方案。它是首个能同时处理氨基酸信息和原子信息的蛋白质预训练语言模型。模型的出色性能展示了多尺度统一建模在克服现有局限和解锁新能力方面的巨大潜力。作为基座模型,ESM-AA获得了多位学者的关注与广泛讨论(截图见下方),被认为有潜力基于ESM-AA开发出可与AlphaFold3、RoseTTAFoldAll-Atom相竞争的模型,为研究不同生物结构间的相互作用开辟
编辑|萝卜皮生物大分子结构对于药物开发和生物催化至关重要。量子力学(QM)方法进行晶体细化,在提高结构质量至纠正生物大分子的结构方面显露出前景。量子细化(Quantumrefinement,QR)方法采用可靠的量子力学(QM)方法进行晶体精化,以显示出前景。然而,巨大的计算成本和复杂的量子力学/分子力学(QM/MM)设置限制了QR的应用。在南方科技大学的研究团队将稳健的机器学习势(MachineLearningPotentials,MLP)融入多尺度ONIOM(QM:MM)方案中,来描述核心部分(例如药物
序列建模的进展具有极大的影响力,因为它们在广泛的应用中发挥着重要作用,包括强化学习(例如,机器人和自动驾驶)、时间序列分类(例如,金融欺诈检测和医学诊断)等。在过去的几年里,Transformer的出现标志着序列建模中的一个重大突破,这主要得益于Transformer提供了一种能够利用GPU并行处理的高性能架构。然而,Transformer在推理时计算开销很大,主要在于内存和计算需求呈二次扩展,从而限制了其在低资源环境中的应用(例如,移动和嵌入式设备)。尽管可以采用KV缓存等技术提高推理效率,但Trans





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



