

java框架在实时数据处理项目中的适用性
在实时数据处理项目中,选择合适的Java框架至关重要,应考虑高吞吐量、低延迟、高可靠性和可扩展性。适用于该场景的三个流行框架如下:ApacheKafkaStreams:提供事件时间语义、分区和容错性,适合高度可扩展、容错的应用。Flink:支持内存和磁盘状态管理、事件时间处理和端到端容错性,适合状态感知的流处理。Storm:高吞吐量、低延迟,面向大数据量处理,具有容错性、可扩展性和分布式架构。
在实时数据处理项目中,选择合适的 Java 框架至关重要,应考虑高吞吐量、低延迟、高可靠性和可扩展性。适用于该场景的三个流行框架如下:Apache Kafka Streams:提供事件时间语义、分区和容错性,适合高度可扩展、容错的应用。Flink:支持内存和磁盘状态管理、事件时间处理和端到端容错性,适合状态感知的流处理。Storm:高吞吐量、低延迟,面向大数据量处理,具有容错性、可扩展性和分布式架构。
Java 框架在实时数据处理项目中的适用性
在实时数据处理项目中,选择合适的 Java 框架至关重要,以满足高吞吐量、低延迟、高可靠性和可扩展性的需求。本文将探讨适用于实时数据处理项目的 Java 框架,并提供实战案例。
1. Apache Kafka Streams
Apache Kafka Streams 是一个用于创建高度可扩展、容错流处理应用的 Java 库。它提供以下特性:
- 事件时间语义,确保按序处理数据。
- 分区和容错性,提高可靠性和可扩展性。
- 内嵌 API,简化应用开发。
实战案例:
使用 Kafka Streams 构建了一个处理来自 IoT 传感器的实时数据源的管道。管道筛选和变换数据,然后将其写入数据库。
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.kstream.KStream;

public class RealtimeDataProcessing {

    public static void main(String[] args) {
        // 创建流构建器
        StreamsBuilder builder = new StreamsBuilder();

        // 接收实时数据
        KStream inputStream = builder.stream("input-topic");

        // 过滤数据
        KStream filteredStream = inputStream.filter((key, value) -> value.contains("temperature"));

        // 变换数据
        KStream transformedStream = filteredStream.mapValues(value -> value.substring(value.indexOf(":") + 1));

        // 写入数据库
        transformedStream.to("output-topic");

        // 创建 Kafka 流并启动
        KafkaStreams streams = new KafkaStreams(builder.build(), PropertiesUtil.getKafkaProperties());
        streams.start();
    }
}
2. Flink
Flink 是一个用于构建状态感知流处理应用的统一平台。它支持以下特性:
- 内存和磁盘状态管理,实现复杂的处理逻辑。
- 事件时间和水印处理,确保数据及时性。
- 端到端容错性,防止数据丢失。
实战案例:
使用 Flink 实现了一个实时欺诈检测系统,该系统从多个数据源接收数据,并使用机器学习模型检测异常交易。
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.common.functions.ReduceFunction;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.time.Time;

public class RealtimeFraudDetection {

    public static void main(String[] args) throws Exception {
        // 创建执行环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // 接收实时交易数据
        DataStream transactions = env.addSource(...);

        // 提取特征和分数
        DataStream> features = transactions.map(new MapFunction>() {
            @Override
            public Tuple2 map(Transaction value) {
                // ... 提取特征和计算分数
            }
        });

        // 根据用户分组并求和
        DataStream> aggregated = features.keyBy(0).timeWindow(Time.seconds(60)).reduce(new ReduceFunction>() {
            @Override
            public Tuple2 reduce(Tuple2 value1, Tuple2 value2) {
                return new Tuple2<>(value1.f0, value1.f1 + value2.f1);
            }
        });

        // 检测异常
        aggregated.filter(t -> t.f1 > fraudThreshold);

        // ... 生成警报或采取其他行动
    }
}
3. Storm
Storm 是一个用于处理大规模实时数据的分布式流处理框架。它提供以下特性:
- 高吞吐量和低延迟,适合于大数据量处理。
- 容错性和可扩展性,确保系统的稳定性和性能。
- 分布式架构,可在大规模集群中部署。
实战案例:
使用 Storm 构建了一个实时日志分析平台,该平台处理来自 Web 服务器的日志数据,并提取有用信息,例如页面访问量、用户行为和异常。
import backtype.storm.Config;
import backtype.storm.LocalCluster;
import backtype.storm.topology.TopologyBuilder;
import backtype.storm.tuple.Fields;
import org.apache.storm.kafka.KafkaSpout;
import org.apache.storm.kafka.SpoutConfig;
import org.apache.storm.kafka.StringScheme;
import org.apache.storm.topology.base.BaseRichBolt;
import org.apache.storm.tuple.Tuple;
import org.apache.storm.utils.Utils;

public class RealtimeLogAnalysis {

    public static void main(String[] args) {
        // 创建拓扑
        TopologyBuilder builder = new TopologyBuilder();

        // Kafka 数据源
        SpoutConfig spoutConfig = new SpoutConfig(KafkaProperties.ZOOKEEPER_URL, KafkaProperties.TOPIC, "/my_topic", UUID.randomUUID().toString());
        KafkaSpout kafkaSpout = new KafkaSpout(spoutConfig, new StringScheme());
        builder.setSpout("kafka-spout", kafkaSpout);

        // 分析日志数据的 Bolt
        builder.setBolt("log-parser-bolt", new BaseRichBolt() {
            @Override
            public void execute(Tuple input) {
                // ... 解析日志数据和提取有用信息
            }
        }).shuffleGrouping("kafka-spout");

        // ... 其他处理 Bolt 和拓扑配置

        // 配置 Storm
        Config config = new Config();
        config.setDebug(true);

        // 本地提交和运行拓扑
        LocalCluster cluster = new LocalCluster();
        cluster.submitTopology("log-analysis", config, builder.createTopology());
    }
}
结论:
在实时数据处理项目中,选择合适的 Java 框架至关重要。本文探讨了 Apache Kafka Streams、Flink 和 Storm 三种流行的框架,并提供了实战案例。开发人员应根据项目要求和特定需求评估这些框架,以做出最合适的决策。
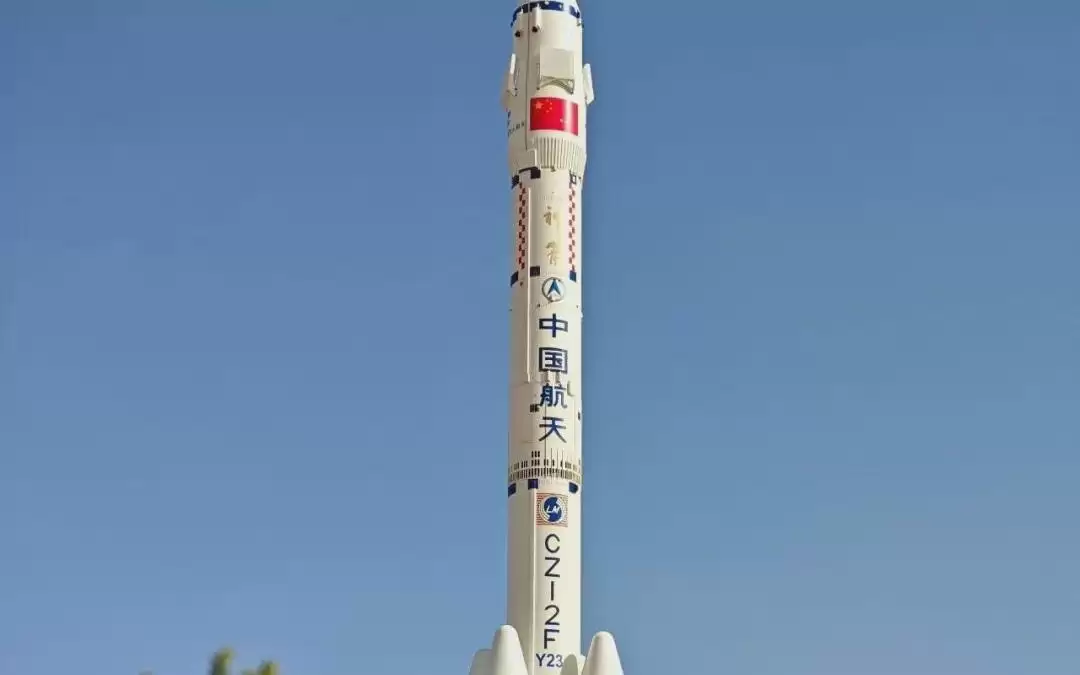
神舟二十三号载人飞行任务进入发射冲刺阶段,新一代实时数据处理系统将首次应用。该系统整合多套软件,实现从分散作业到集中指挥的跨越,提升了稳定性、资源利用效率与数据处理速度。此次升级旨在适应未来高密度发射任务需求,为后续重大航天任务奠定技术基础。
ArrayList基于动态数组,get(index)为O(1),末尾添加均摊O(1),中间插入和删除为O(n),contains为O(n);2.LinkedList基于双向链表,get(index)为O(n),末尾添加为O(1),中间插入和删除定位需O(n),头尾操作为O(1);3.HashSet/HashMap基于哈希表,put、get、remove均摊O(1),最坏情况因哈希冲突可达O(n),性能受初始容量和负载因子影响;4.TreeSet/TreeMap基于红黑树,add、contains、remo
选择Java集合的初始化容量核心在于避免频繁扩容带来的性能开销。1.ArrayList应根据预估元素数量N直接初始化为newArrayList<>(N),避免多次扩容复制;2.HashMap/HashSet需结合负载因子(默认0.75)计算初始容量,公式为(int)(N/0.75F)+1,以减少rehashing开销;3.扩容影响性能因涉及数组复制(ArrayList)或重新哈希(HashMap),均为O(n)操作,尤其在大数据量或高并发下代价高昂;4.预估容量可基于已知数据量、历史趋势或业务
Set与List在元素查找效率上的根本区别在于底层数据结构和查找机制:1.ArrayList基于动态数组,查找需遍历每个元素进行equals比较,时间复杂度为O(N);2.HashSet基于哈希表,通过hashCode定位桶位置,再在桶内进行少量比较,平均时间复杂度为O(1),因此在大数据量下Set的查找效率远高于List。
JavaMap接口常见的实现类有HashMap、LinkedHashMap、TreeMap和ConcurrentHashMap。HashMap基于哈希表实现,存取效率高(O(1)),但无序,允许一个null键和多个null值,适用于对性能要求高且无需顺序的场景;LinkedHashMap在HashMap基础上通过双向链表维护插入顺序,遍历时保持添加顺序,适合需要顺序输出或实现LRU缓存的场景;TreeMap基于红黑树实现,按键的自然顺序或自定义比较器排序,支持有序访问和范围查询,但性能较低(O(logn)
答案:Java集合框架核心是Collection和Map两大接口,List、Set为Collection子接口,理解接口体系可实现对集合的灵活选择与高效操作。
LinkedList的性能优势主要体现在两端操作和基于迭代器的中间操作,1.当用作队列或双端队列时,addFirst、removeLast等操作均为O(1);2.使用ListIterator在遍历过程中插入、删除或修改元素,可避免查找开销,实现O(1)操作;3.在已知位置频繁修改的链式数据处理场景中效率高;4.适合作为栈或队列使用,支持高效的push、pop、offer、poll操作;若需随机访问或频繁查找,则应选用ArrayList。
要利用Deque实现高效的双端队列操作,应选择合适的实现类并使用其提供的方法。1.使用ArrayDeque或LinkedList实现Deque接口,其中ArrayDeque在两端操作时性能更优,适合大多数场景;2.通过addFirst()、addLast()、removeFirst()、removeLast()、getFirst()、getLast()等方法实现两端的插入、删除和访问,这些方法在队列为空时会抛出异常;3.使用offerFirst()、offerLast()、pollFirst()、poll
利用Java框架文档和教程解决常见问题:查找框架文档:官网、GitHub或存储库中提供了详细的使用说明、API参考和常见问题解答。利用教程和示例代码:教程演示框架用法,示例代码提供实际实现示例。查看问题跟踪器和论坛:了解其他开发者解决类似问题的经验和解决方案。实战案例:解决SpringBootbean配置问题:查阅SpringBoot文档了解bean配置。参照示例代码正确配置bean。检查问题跟踪器和论坛寻找解决方案。
在容器中部署Java框架面临着内存限制、端口冲突、数据持久性和JVM参数优化等挑战。解决方案包括容器内存管理、端口映射、持久性存储和容器特定JVM参数配置。通过管理这些挑战,可以成功地在容器中部署Java框架。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



