

sql条件判断字符串不包含某个字符串的方法详解
深入详解在SQL中进行条件判断字符串不包含某个子串的方法,涵盖标准NOT LIKE、各主流数据库(MySQL、PostgreSQL、SQL Server、Oracle)专有位置函数、正则表达式判断,剖析NULL值三值逻辑陷阱及全表扫描性能优化策略。
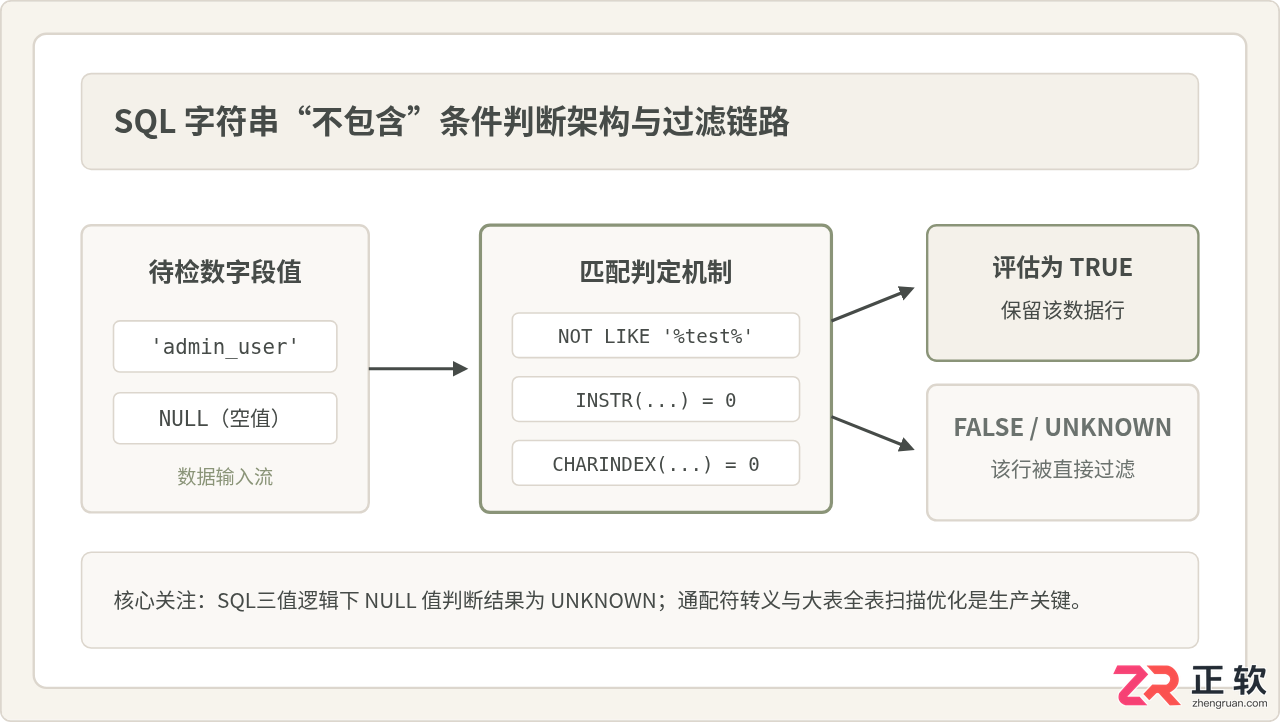
在SQL日常查询与数据清洗中,判断某个字段“不包含”特定子字符串是一类高频操作。实现该需求最标准的语法是使用 NOT LIKE '%目标子串%'。除此之外,各类主流数据库还提供了位置检索函数(如 MySQL/Oracle 的 INSTR()、PostgreSQL 的 POSITION() 与 STRPOS()、SQL Server 的 CHARINDEX())以及正则表达式运算符。本文将完整拆解各类实现方法的语法、适用场景、转义技巧,重点剖析三值逻辑下的 NULL 陷阱,并给出针对大数据量场景的性能优化方案。
一、标准方案:NOT LIKE 运算符与通配符规则
SQL 标准定义了 LIKE 与 NOT LIKE 用于模式匹配。百分号 % 代表任意数量(包括零个)的任意字符,下划线 _ 代表单个任意字符。要判断字段完全不包含某个目标字符串,两端都需要包裹 % 通配符。
-- 查询用户表中昵称不包含 'test' 的所有记录
SELECT id, nickname, email
FROM sys_user
WHERE nickname NOT LIKE '%test%';
上述语句会遍历 nickname 字段,只有当字符串的开头、中间、结尾均不出现 test 时,条件才成立。如果仅仅写成 NOT LIKE 'test%',则仅排除了以 test 开头的字符串,包含在中间或末尾的记录依然会被查出。
包含通配符自身时的 ESCAPE 转义
当我们要排查的目标子串本身就包含 % 或 _ 时(例如排查不包含折扣标记 10% 或下划线命名 user_),直接书写会导致通配符被误解析。此时必须配合 ESCAPE 子句显式指定转义字符:
-- 查询描述中不包含 '10%' 字符的商品
-- 使用反斜杠 \ 作为转义字符
SELECT goods_id, goods_name, description
FROM mall_goods
WHERE description NOT LIKE '%10\%%' ESCAPE '\';

-- 查询编码中不包含下划线 'A_B' 的记录
SELECT code, title
FROM project_doc
WHERE code NOT LIKE '%A\_B%' ESCAPE '\';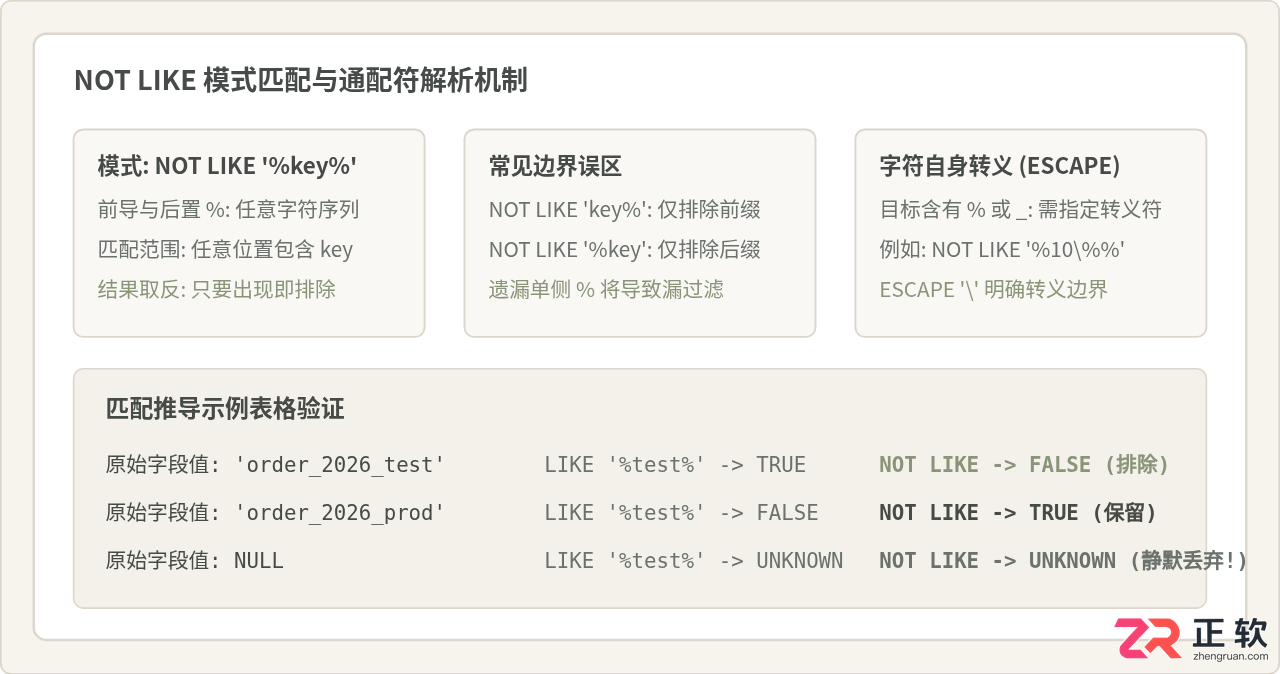
二、数据库方言专有函数实现
除了标准的 NOT LIKE 以外,主流关系型数据库均提供了计算子串起始位置的内置函数。如果子串不存在于源文本中,这些函数通常返回 0。使用专有函数的好处在于无需对子串中的 % 或 _ 进行转义,处理字面量匹配时更为直接。
1. MySQL / MariaDB:INSTR() 与 LOCATE()
在 MySQL 中,INSTR(str, substr) 返回 substr 在 str 中首次出现的位置(从1开始计数)。若未找到,则返回 0。因此,不包含即为等于 0:
-- 使用 INSTR 判断不包含
SELECT id, title FROM cms_article WHERE INSTR(title, '广告') = 0;

-- 或者使用 LOCATE 函数(参数顺序相反:子串在前,原串在后)
SELECT id, title FROM cms_article WHERE LOCATE('广告', title) = 0;
2. PostgreSQL:POSITION() 与 STRPOS()
PostgreSQL 遵循 SQL-92 标准,提供 POSITION(substring IN string),未找到时返回 0;同时也支持专有函数 STRPOS(string, substring):
-- 标准 POSITION 语法
SELECT id, remark FROM t_log WHERE POSITION('error' IN remark) = 0;

-- STRPOS 语法
SELECT id, remark FROM t_log WHERE STRPOS(remark, 'error') = 0;
3. SQL Server (T-SQL):CHARINDEX()
SQL Server 中对应的函数是 CHARINDEX(expressionToFind, expressionToSearch)。如果未找到目标子串,返回值为 0:
-- SQL Server 中判断不包含
SELECT EmployeeID, Notes
FROM Employees
WHERE CHARINDEX('probation', Notes) = 0;
4. Oracle:INSTR()
Oracle 的 INSTR(string, substring) 同样在找不到匹配项时返回 0:
-- Oracle 中判断不包含
SELECT emp_id, emp_name, job_desc
FROM hr_staff
WHERE INSTR(job_desc, '临时') = 0;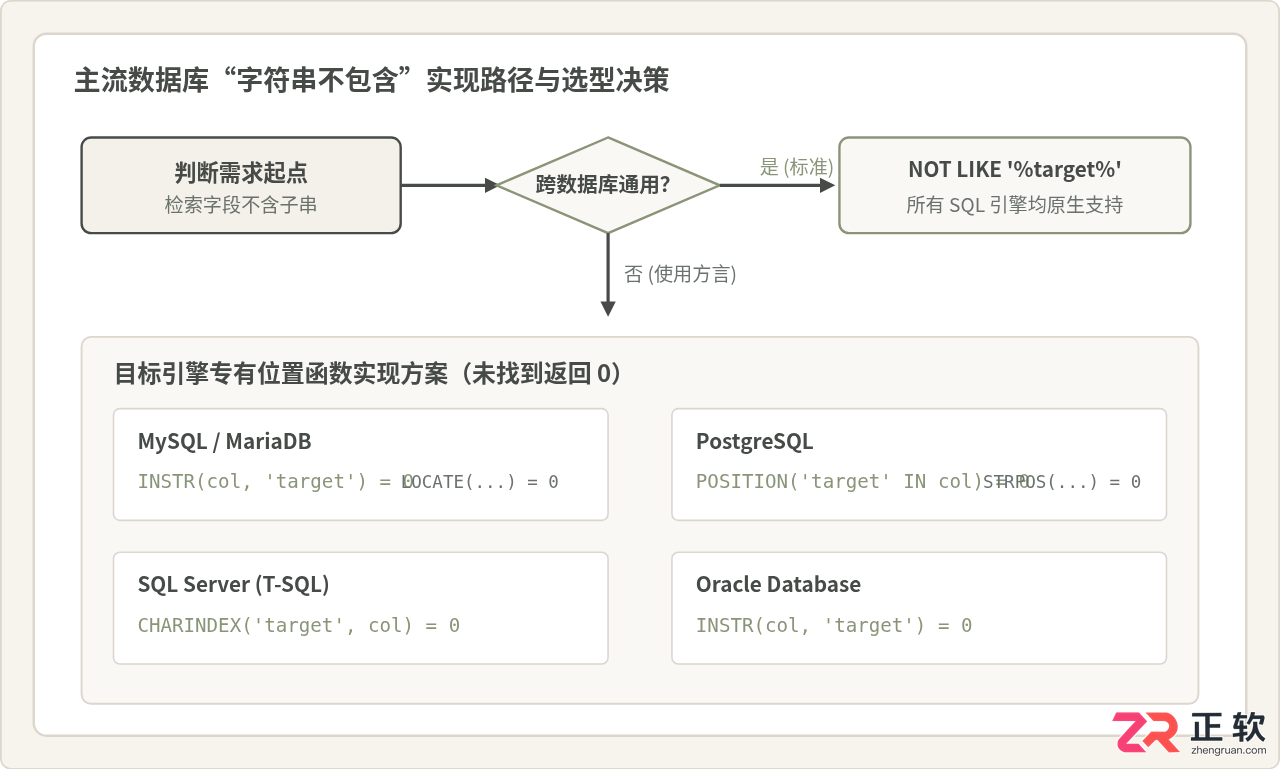
三、复杂场景:正则表达式不匹配判断
当需要排除的不是单一固定单词,而是满足特定模式(例如包含连续数字、邮箱格式或多个可选词之一)的文本时,使用 NOT LIKE 会显得力不从心。此时应当使用正则表达式的不匹配判断。
1. MySQL 中的 REGEXP 与 NOT REGEXP
MySQL 8.0+ 提供了增强的正则表达式支持:
-- 排除内容中包含任一敏感词(admin 或 root 或 debug)的记录
SELECT id, log_content
FROM app_log
WHERE log_content NOT REGEXP 'admin|root|debug';

-- 或者使用 NOT 结合 REGEXP_LIKE 函数
SELECT id, log_content
FROM app_log
WHERE NOT REGEXP_LIKE(log_content, 'admin|root|debug', 'c'); -- 'c' 表示大小写敏感
2. PostgreSQL 中的 !~ 运算符
PostgreSQL 提供了非常精炼的正则匹配运算符:
!~:区分大小写的正则不匹配。!~*:不区分大小写的正则不匹配。
-- 排除包含由4个及以上数字组成订单编号的记录(区分大小写)
SELECT id, note FROM orders WHERE note !~ '[0-9]{4,}';

-- 不区分大小写排除包含 vip 或 svip 的备注
SELECT id, note FROM orders WHERE note !~* 's?vip';
注意: 正则表达式匹配通常比字符子串扫描更消耗 CPU 资源。除非必须使用复杂通配(如元字符、多条件析取组合),对于固定字符串的排除,优先使用 NOT LIKE 或位置函数。
四、核心陷阱:SQL 三值逻辑下的 NULL 值处理
在编写 SQL 条件时,许多开发者容易忽略 NULL 带来的静默数据丢失。SQL 采用三值逻辑(Three-Valued Logic, 3VL),即布尔表达式的求值结果不仅有 TRUE 和 FALSE,还有 UNKNOWN。
根据 SQL 规范,任何标量值与 NULL 进行运算或模式匹配,结果都是 UNKNOWN。而在 WHERE 条件过滤中,只有结果为 TRUE 的行才会被选出,结果为 FALSE 或 UNKNOWN 的行都会被丢弃。
-- 假设某行数据的 address 字段值为 NULL
-- 表达式 'NULL NOT LIKE %beijing%' 的结果是 UNKNOWN
SELECT id, username, address
FROM user_profile
WHERE address NOT LIKE '%beijing%';
在上面的查询中,用户如果地址是 NULL,直觉上他“确实不包含 beijing”,但该行不会被返回!如果业务期望包含 NULL 值的行,必须显式对其进行处理。
安全过滤的两种标准写法
写法一:显式补充 IS NULL 判定(推荐,逻辑最清晰)
SELECT id, username, address
FROM user_profile
WHERE address NOT LIKE '%beijing%'
   OR address IS NULL;
写法二:使用 COALESCE 函数赋予空串默认值
SELECT id, username, address
FROM user_profile
WHERE COALESCE(address, '') NOT LIKE '%beijing%';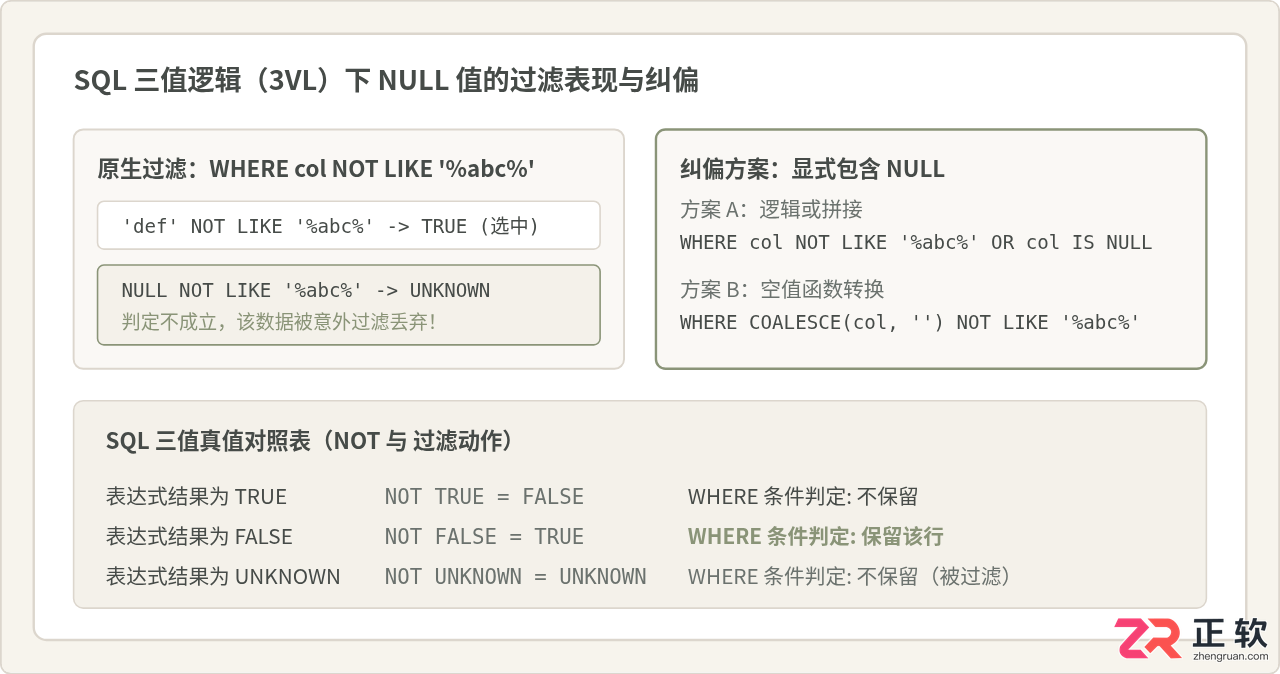
五、性能分析与大数据量优化策略
在包含上千万行的大数据量表中,直接使用 NOT LIKE '%xxx%' 或位置函数通常会导致全表扫描(Full Table Scan)。原因在于两点:
- B-Tree 索引失效: 传统 B-Tree 索引按照字符从左到右排序。包含前导百分号的模式(
%keyword)无法利用索引的有序前缀进行范围检索(Range Scan)。 - 否定式查询的低选择性: “不包含某个词”通常意味着要保留大部分数据(例如95%以上的数据不含该敏感词)。当优化器评估返回行数占据全表较大比例时,即使有索引也会倾向于直接走全表扫描。
生产环境优化手段
- 分区或前置范围过滤: 永远不要单独运行全表
NOT LIKE。先通过时间戳、租户 ID、状态枚举等高选择性主键或联合索引字段把扫描行数缩窄到最小范围。-- 优先走 create_time 索引缩小范围 SELECT id, title, content FROM article WHERE create_time >= '2026-09-01' AND category_id = 102 AND (title NOT LIKE '%草稿%' OR title IS NULL); - 生成列与函数索引(Functional Index): 如果业务中经常需要判断是否包含特定标识,可以在表上建立虚拟生成列并建立索引。
-- MySQL 8.0 示例:建立标记生成列 ALTER TABLE article ADD COLUMN has_draft_flag TINYINT GENERATED ALWAYS AS (INSTR(title, '草稿') > 0) VIRTUAL; CREATE INDEX idx_draft_flag ON article(has_draft_flag); -- 查询时直接走整数等值索引 SELECT id, title FROM article WHERE has_draft_flag = 0; - 全文检索引擎(Full-Text / Elasticsearch): 对于长文本字段,利用 MySQL FULLTEXT、PostgreSQL pg_trgm 或外部搜索引擎建立倒排索引,通过反向布尔查询提升响应速度。
六、总结与方法选型矩阵
对字符串进行“不包含”条件判断时,应根据实际环境、语法规范与数据特征合理选择实现方式:
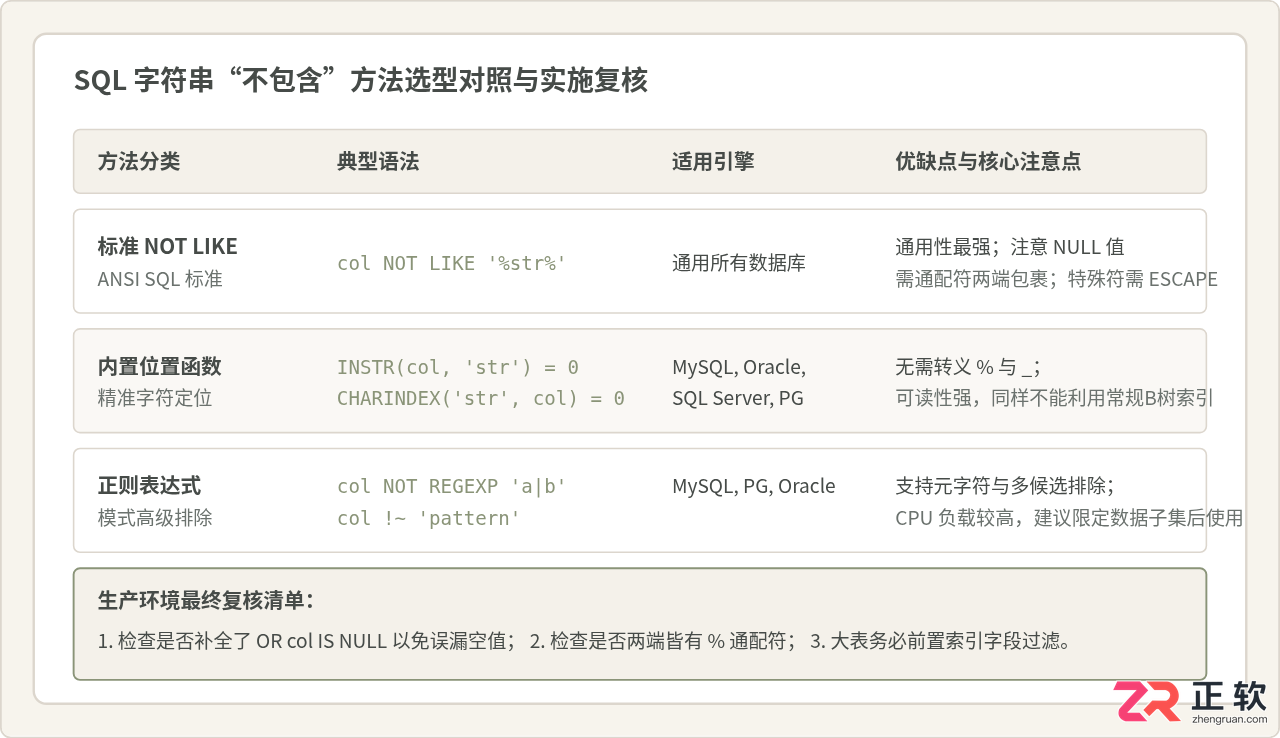
综上所述,日常场景首选 WHERE column NOT LIKE '%target%' OR column IS NULL,该写法兼顾了标准性与三值逻辑安全性;当目标字符串自身包含特殊通配符号时,选择 INSTR() = 0 或使用 ESCAPE 转义;当面对复杂模式排除时应用正则,而在海量数据场景下,必须结合索引覆盖与前置条件收窄范围,以保障生产数据库的稳定与高效。
深入讲解SQL中CASE WHEN语句的工作机制、语法形式及在单维度区间离散化、多维度复合标记与条件聚合统计等数据分类场景中的具体应用与注意事项。
手工编程要求程序员逐行写代码,可控性强但耗时;自动编程借助工具快速生成代码,效率高但灵活度有限。选择需结合实际需求、项目特点与团队能力,没有绝对优劣,灵活组合才是专业做法。
配置PHP操作MSSQL驱动 配置PHP连接MSSQL,这事儿说难不难,但细节上要是没把握好,确实容易卡住。我遇到过不少读者,装完驱动后各种报错,最后发现是DLL版本没选对。所以,咱们今天就把整个流程拆开,一步步讲清楚。 第一步,先把驱动给装上。找到SQLSRV58.exe这个安装包,找个地方建个新
彻底卸载SQLServer2005/2008需常规卸载、删除安装目录、清除开始菜单残留、清理注册表(HKEY_CURRENT_USER和HKEY_LOCAL_MACHINE下相关项),最后重启电脑重新安装,否则易安装失败或报错。
在当今数字化时代,数据库管理对于各类应用程序和业务系统来说至关重要 说到数据存储和管理,SQL Server 2008至今仍是一个绕不开的经典选择。它提供了一套成熟且高效的解决方案,帮助无数系统处理核心数据。今天,我们就来聊聊如何上手这款强大的数据库管理系统,从安装到基础操作,带你走一遍完整的入门流
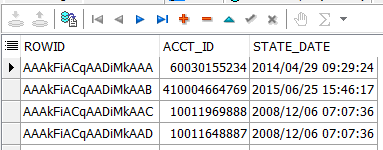
以下是关于如何修改TOAD和PLSQLDeveloper默认配置以满足特定需求的详细指南。请注意,我们将保持图片的原始格式和位置,并且不会改变原文的语言。首先,让我们明确需要解决的问题:执行以下SQL查询:selectrowid,acct_id,state_datefromacct;修改后,我们希望达到以下效果:SQL查询中指定ROWID时,可以正确显示。时间格式显示为YYYYMMDDHH24:MI:SS。对于超长的数字,不使用科学计数法显示。接下来,介绍安装与环境配置:TOAD和PLSQLD
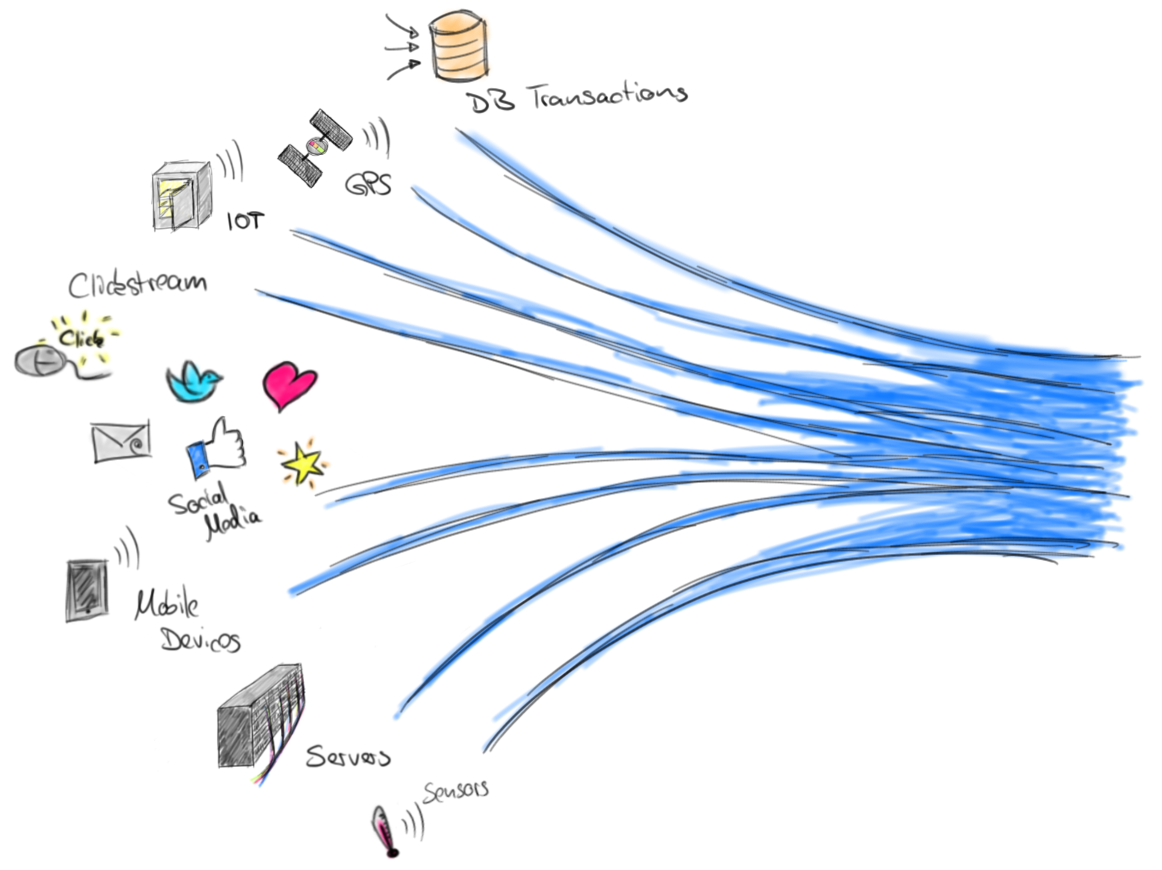
越来越多的公司采用流处理,并将现有的批处理应用迁移到流处理,或者对新的用例采用流处理实现的解决方案。其中许多应用集中在流数据分析上,分析的数据流来自各种源,例如数据库事务、点击、传感器测量或IoT设备。ApacheFlink非常适用于流分析应用程序,因为它支持事件时间语义,确保只处理一次,以及同时实现了高吞吐量和低延迟。因为这些特性,Flink能够近实时对大量的输入数据计算出一个确定和精确的结果,并且在发生故障的时候提供一次性语义。Flink的核心流处理API,DataStreamAPI,非常




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,