

MySQL是否支持唯一索引?
mysql支持unique索引。在MySQL中,UNIQUE索引允许用户在一个或多个列中强制实现值的唯一性,可以防止表中一个或多个列中拥有重复的值;每个表可以有多个UNIQUE索引,且UNIQUE索引中可以具有多个NULL值。mysql支持unique索引。在MySQL中,UNIQUE索引可以防止表中一个或多个列中拥有重复的值。MySQLUNIQUE索引简介要强制执行一个或多个列的唯一性值,我们经常使用PRIMARYKEY约束。但是,每个表只有一个主键。如果要使用多个列或一组具有唯一值的列,则不能使用主键
mysql支持unique索引。在MySQL中,UNIQUE索引允许用户在一个或多个列中强制实现值的唯一性,可以防止表中一个或多个列中拥有重复的值;每个表可以有多个UNIQUE索引,且UNIQUE索引中可以具有多个NULL值。
mysql支持unique索引。在MySQL中,UNIQUE索引可以防止表中一个或多个列中拥有重复的值。
MySQL UNIQUE索引简介
要强制执行一个或多个列的唯一性值,我们经常使用PRIMARY KEY约束。
但是,每个表只有一个主键。 如果要使用多个列或一组具有唯一值的列,则不能使用主键约束。
幸运的是,MySQL提供了另一种称为UNIQUE索引的索引,它允许您在一个或多个列中强制实现值的唯一性。 与PRIMARY KEY索引不同,每个表可以有多个UNIQUE索引。
要创建一个UNIQUE索引,请使用CREATE UNIQUE INDEX语句如下:
CREATE UNIQUE INDEX index_name
ON table_name(index_column_1,index_column_2,...);
在一个或多个列中强制实现值的唯一性的另一种方法是使用唯一约束。创建唯一约束时,MySQL会在幕后创建一个UNIQUE的索引。
以下语句说明了如何在创建表时创建唯一约束。
CREATE TABLE table_name(
...
   UNIQUE KEY(index_column_,index_column_2,...)
);
也可以使用UNIQUE INDEX而不是UNIQUE KEY。 它们被称为相同的东西。
如果要向现有表添加唯一约束,可以使用ALTER TABLE语句,如下所示:
ALTER TABLE table_name
ADD CONSTRAINT constraint_name UNIQUE KEY(column_1,column_2,...);
MySQL UNIQUE索引和NULL
与其他数据库系统不同,MySQL将NULL值视为不同的值。 因此,您可以在UNIQUE索引中具有多个NULL值。
这就是MySQL的设计方式。 这不是一个错误,即使它被报告为一个错误。
另一重要的一点是UNIQUE约束不适用于除了BDB存储引擎之外的NULL值。
MySQL UNIQUE索引示例
假设想在应用程序中管理联系人。还希望contacts表中的email列必须是唯一的。
要执行此规则,请在CREATE TABLE语句中创建唯一的约束,如下所示:
USE testdb;

CREATE TABLE IF NOT EXISTS contacts (
    id INT AUTO_INCREMENT PRIMARY KEY,
    first_name VARCHAR(50) NOT NULL,
    last_name VARCHAR(50) NOT NULL,
    phone VARCHAR(15) NOT NULL,
    email VARCHAR(100) NOT NULL,
    UNIQUE KEY unique_email (email)
);
如果使用SHOW INDEXES语句,将看到MySQL为email列创建了一个UNIQUE索引。
SHOW INDEXES FROM contacts;

+----------+------------+--------------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+
| Table    | Non_unique | Key_name     | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment | Index_comment |
+----------+------------+--------------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+
| contacts |          0 | PRIMARY      |            1 | id          | A         |           0 | NULL     | NULL   |      | BTREE      |         |               |
| contacts |          0 | unique_email |            1 | email       | A         |           0 | NULL     | NULL   |      | BTREE      |         |               |
+----------+------------+--------------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+---------------+
2 rows in set
接下来,向contacts表中插入一行。
INSERT INTO contacts(first_name,last_name,phone,email)
VALUES('Max','Su','(+86)-999-9988','max.su@yiibai.com');
现在,如果您尝试插入电子邮件是max.su@yiibai.com的行数据,您将收到一条错误消息。
INSERT INTO contacts(first_name,last_name,phone,email)
VALUES('Max','Su','(+86)-999-9988','max.su@yiibai.com');
执行上面语句后,应该会看到以下结果 -
1062 - Duplicate entry 'max.su@yiibai.com' for key 'unique_email'
假设您不仅希望电子邮件是唯一的,而且first_name,last_name和phone的组合也是唯一的。 在这种情况下,可以使用CREATE INDEX语句为这些列创建一个UNIQUE索引,如下所示:
CREATE UNIQUE INDEX idx_name_phone
ON contacts(first_name,last_name,phone);
将以下行添加到contacts表中会导致错误,因为first_name,last_name和phone的组合已存在。
INSERT INTO contacts(first_name,last_name,phone,email)
VALUES('Max','Su','(+86)-999-9988','john.d@yiibai.com');
执行上面语句后,应该会看到以下结果 -
1062 - Duplicate entry 'Max-Su-(+86)-999-9988' for key 'idx_name_phone'
可以看到,不可以将重复电话号码插入到表中。
唯一性索引unique影响:
唯一性索引表创建:
DROP TABLE IF EXISTS `sc`;
CREATE TABLE `sc` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `name` varchar(200) CHARACTER SET utf8 DEFAULT NULL,
  `class` varchar(200) CHARACTER SET utf8 DEFAULT NULL,
  `score` int(11) DEFAULT NULL,
  `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `create_user_id` bigint(11) DEFAULT NULL COMMENT '创建人id',
  `modify_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '最后修改时间',
  `modify_user_id` bigint(11) DEFAULT NULL COMMENT '最后修改人id',
  PRIMARY KEY (`id`),
  UNIQUE KEY `name` (`name`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='学生信息表';
在其中创建了唯一索引name,就是说这个学生表同名的学生只能由一位。
命令添加unique:
alter table sc add unique (name);

alter table sc add unique key `name_score` (`name`,`score`);
删除:
alter table sc drop index `name`;
唯一性索引作用:
先行插入部分数据:
insert into sc (name,class,score) values ('吕布','一年二班',67);
insert into sc (name,class,score) values ('赵云','一年二班',90);
insert into sc (name,class,score) values ('典韦','一年二班',89);
insert into sc (name,class,score) values ('关羽','一年二班',70);
再次查看表定义:
show create table sc;

CREATE TABLE `sc` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `name` varchar(200) CHARACTER SET utf8 DEFAULT NULL,
  `class` varchar(200) CHARACTER SET utf8 DEFAULT NULL,
  `score` int(11) DEFAULT NULL,
  `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `create_user_id` bigint(11) DEFAULT NULL COMMENT '创建人id',
  `modify_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '最后修改时间',
  `modify_user_id` bigint(11) DEFAULT NULL COMMENT '最后修改人id',
  PRIMARY KEY (`id`),
  UNIQUE KEY `name` (`name`)
) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='学生信息表';
这时的Auto_Increment=5
再次执行sql:
insert into sc (name,class,score) values ('吕布','二年二班',77)
> 1062 - Duplicate entry '吕布' for key 'name'
> 时间: 0.01s
此时再次查看表定义,会发现Auto_Increment=6
unique除了在插入重复数据的时候会报错,还会使auto_increment自动增长
unique与primary key的区别:
简单的讲,primary key=unique+not null
具体的区别:
(1) 唯一性约束所在的列允许空值,但是主键约束所在的列不允许空值。
(2) 可以把唯一性约束放在一个或者多个列上,这些列或列的组合必须有唯一的。但是,唯一性约束所在的列并不是表的主键列。
(3) 唯一性约束强制在指定的列上创建一个唯一性索引。在默认情况下,创建唯一性的非聚簇索引,但是,也可以指定所创建的索引是聚簇索引。
(4) 建立主键的目的是让外键来引用.
(5) 一个表最多只有一个主键,但可以有很多唯一键
存在唯一键冲突时,避免策略:
insert ignore:
insert ignore会忽略数据库中已经存在的数据(根据主键或者唯一索引判断),如果数据库没有数据,就插入新的数据,如果有数据的话就跳过这条数据.
insert ignore into sc (name,class,score) values ('吕布','二年二班',77)执行上面的语句,会发现并没有报错,但是主键还是自动增长了。
replace into:
replace into 首先尝试插入数据到表中。 如果发现表中已经有此行数据(根据主键或者唯一索引判断)则先删除此行数据,然后插入新的数据,否则,直接插入新数据。
使用replace into,你必须具有delete和insert权限
replace into sc (name,class,score) values ('吕布','二年二班',77);此时会发现吕布的班级跟年龄都改变了,但是id也变成最新的了,所以不是更新,是删除再新增
insert on duplicate key update:
如果在insert into 语句末尾指定了on duplicate key update,并且插入行后会导致在一个UNIQUE索引或PRIMARY KEY中出现重复值,则在出现重复值的行执行UPDATE;如果不会导致重复的问题,则插入新行,跟普通的insert into一样。
使用insert into,你必须具有insert和update权限
如果有新记录被插入,则受影响行的值显示1;如果原有的记录被更新,则受影响行的值显示2;如果记录被更新前后值是一样的,则受影响行数的值显示0
insert into sc (name,class,score) values ('关羽','二年二班',80) on duplicate key update score=100;
> Affected rows: 2
> 时间: 0.008s
旧数据中关羽是一年二班,70分,现在插入,最后发现只有分数变成了100,班级并没有改变。
4 关羽 一年二班 100 2018-11-16 15:32:18 2018-11-16 15:51:51
id没有发生变化,数据只更新,但是auto_increment还是增长1了。
死锁:
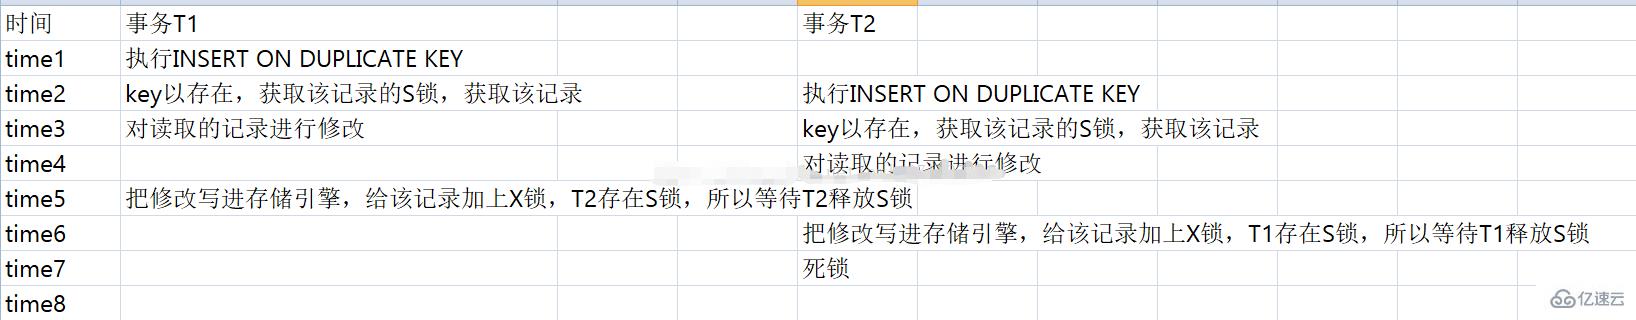
insert ... on duplicate key 在执行时,innodb引擎会先判断插入的行是否产生重复key错误,
如果存在,在对该现有的行加上S(共享锁)锁,如果返回该行数据给mysql,然后mysql执行完duplicate后的update操作,
然后对该记录加上X(排他锁),最后进行update写入。如果有两个事务并发的执行同样的语句,
那么就会产生death lock,如
解决办法:
1、尽量对存在多个唯一键的table使用该语句
2、在有可能有并发事务执行的insert 的内容一样情况下不使用该语句
结论:
这三种方法都能避免主键或者唯一索引重复导致的插入失败问题。
insert ignore能忽略重复数据,只插入不重复的数据。
replace into和insert ... on duplicate key update,都是替换原有的重复数据,区别在于replace into是删除原有的行后,在插入新行,如有自增id,这个会造成自增id的改变;insert ... on duplicate key update在遇到重复行时,会直接更新原有的行,具体更新哪些字段怎么更新,取决于update后的语句。

详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。

后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。

针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。

本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



