

使用实例解析MySQL索引创建原则
一、适合创建索引1、字段的数值有唯一性限制根据Alibaba规范,指明在业务上具有唯一特性的字段,即使是组合字段,也必须建成唯一索引。例如,学生表中的学号时具有唯一性的字段,为该字段建立唯一性索引可以快速查询出某个学生的信息,如果使用姓名的话,可能存在同名的情况,从而降低查询速度。2、频繁作为Where查询条件的字段某个字段在Select语句的Where条件中经常被使用到,那么就需要给这个字段创建索引,尤其实在数据量大的情况下,创建普通索引就可以大幅提升查询效率。比如测试表student_info有100
一、适合创建索引
1、字段的数值有唯一性限制
根据Alibaba规范,指明在业务上具有唯一特性的字段,即使是组合字段,也必须建成唯一索引。
例如,学生表中的学号时具有唯一性的字段,为该字段建立唯一性索引可以快速查询出某个学生的信息,如果使用姓名的话,可能存在同名的情况,从而降低查询速度。
2、频繁作为Where查询条件的字段
某个字段在Select语句的Where条件中经常被使用到,那么就需要给这个字段创建索引,尤其实在数据量大的情况下,创建普通索引就可以大幅提升查询效率。
比如测试表student_info有100万数据,假设查询student_id=112322的用户信息,如果没有对student_id字段创建索引,查询结果如下:
select course_id, class_id, name, create_time,student_id from student_info where student_id = 112322;# 花费211ms
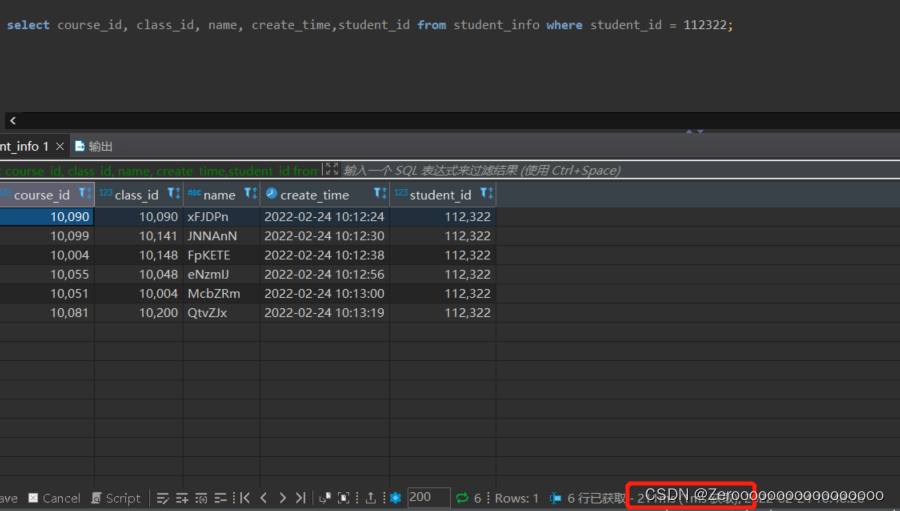
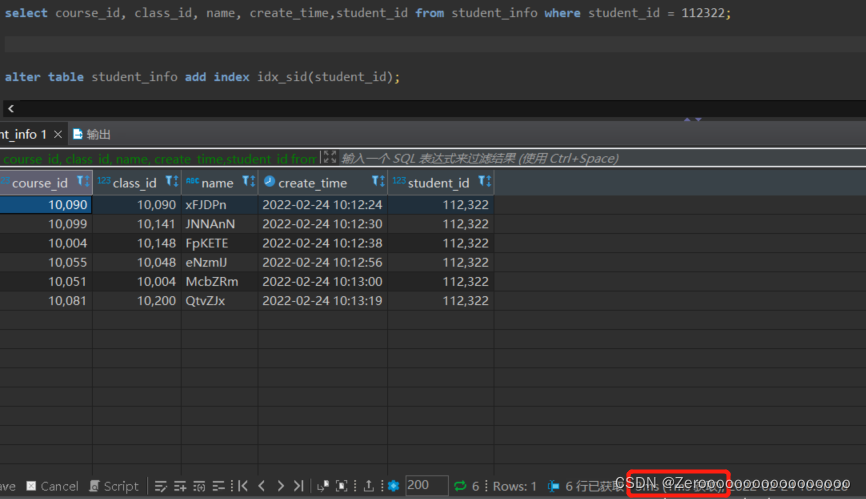
为student_id创建索引后,查询结果如下:
alter table student_info add index idx_sid(student_id);
select course_id, class_id, name, create_time,student_id from student_info where student_id = 112322;# 花费3ms
3、经常Group by和Order by的列
索引就是让数据按照某种顺序进行存储或检索,因此当使用Group by对数据进行分组查询或使用Order by对数据进行排序的时候 ,就需要对分组或排序的字段进行索引。如果待排序的列有多个,那可以在这些列上建立组合索引。
比如,按照student_id对学生选秀的课程进行分组,显示不同的student_id和课程的数量,显示100条。如果不对student_id创建索引,查询结果如下:
select student_id,count(*) as num from student_info group by student_id limit 100;#花费2.466s
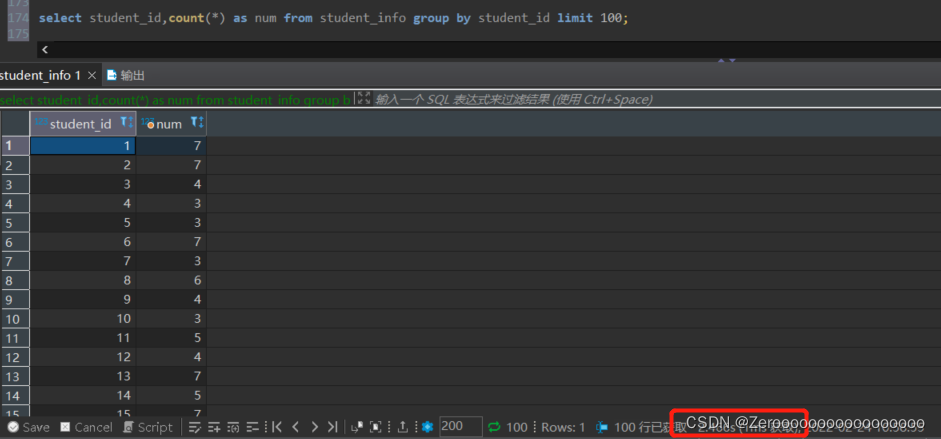
为student_id创建索引后,查询结果如下:
alter table student_info add index idx_sid(student_id);
select student_id,count(*) as num from student_info group by student_id limit 100;#花费6ms
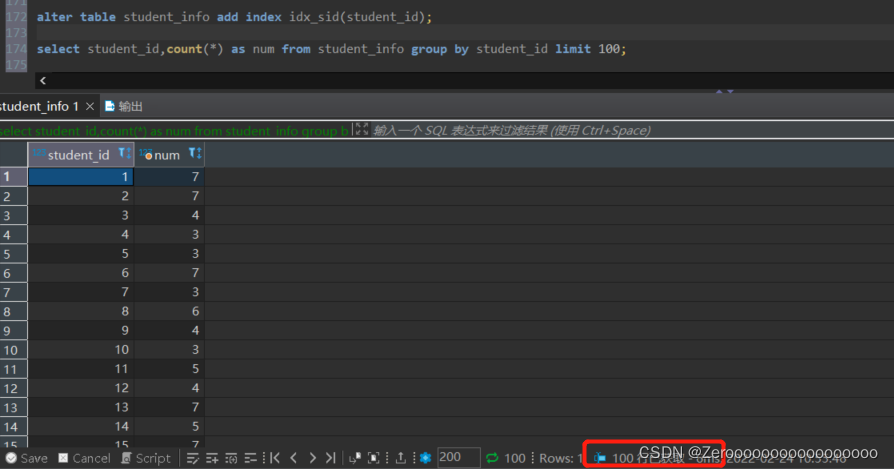
对于既有group by又有order by的查询语句,建议最好建立联合索引,并且将group by中的字段放到order by字段的前边,满足‘最左前缀匹配原则’,这样索引的利用率就会高,自然查询的效率也就会高;同时8.0之后的版本支持降序索引,如果order by之后的字段时降序的,可以考虑直接创建降序索引,也会提高查询效率。
4、Update、Delete的where条件列
对数据按照某个条件进行查询后再进行Update或Delete的操作,如果对Where字段创建了索引,就能答复提升效率。原因是因为需要先根据Where条件列检索出来这条记录,然后再对他进行更新或删除。如果进行更新的时候,更新的字段是非索引字段,提升效率会更明显,这是因为费索引字段更新不需要对所以进行维护。
比如对student_info表中的name字段为sdfasdfas123123的数据修改student_id为110119,在没有对name字段建立索引的情况下,执行情况如下:
update student_info set student_id = 110119 where name = 'sdfasdfas123123';#花费549ms
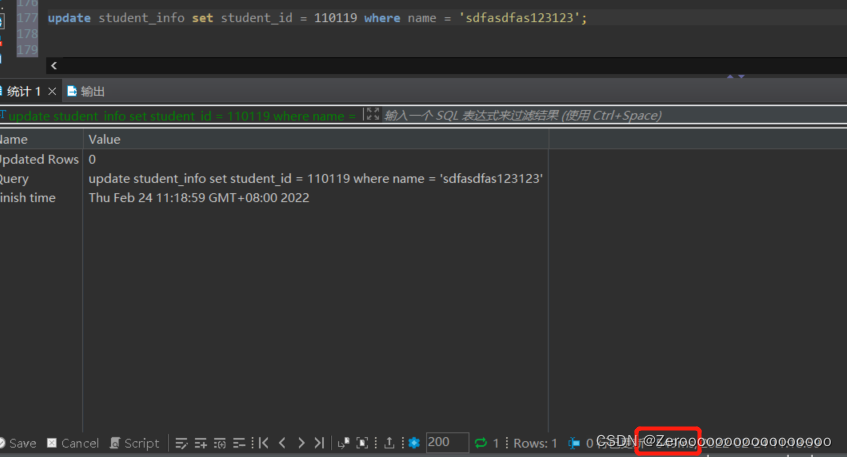
添加索引后,执行情况如下:
alter table student_info add index idx_name(name);
update student_info set student_id = 110119 where name = 'sdfasdfas123123';#花费2ms
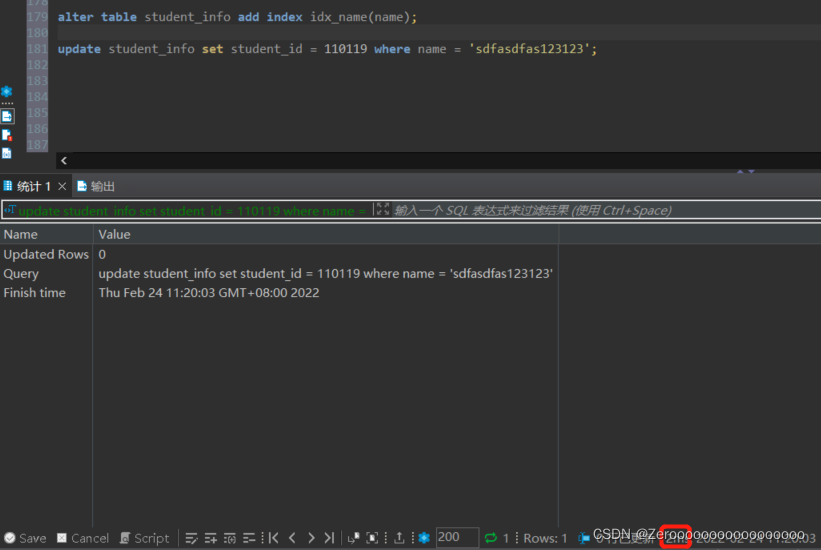
5、Distinct字段需要创建索引
有时候需要对某个字段进行去重,使用Distinct,那么对这个创建索引也会提升查询效率。
比如查询课程表中不同student_id都有哪些,如果没有为student_id创建索引,执行情况如下:
select distinct(student_id) from student_id;#花费2ms
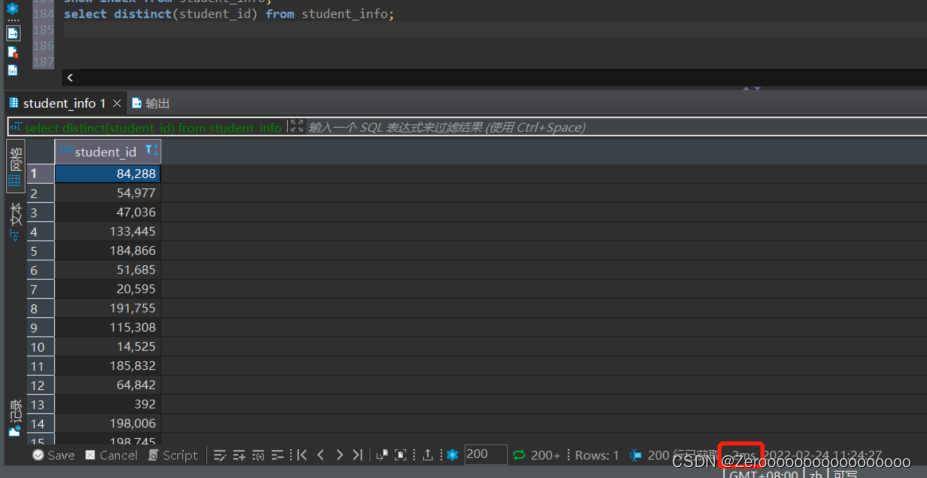
创建索引后,执行情况如下:
alter table student_info add index idx_sid(student_id);
select distinct(student_id) from student_id;#花费0.1ms
6、多表Join连接操作时,创建索引注意事项
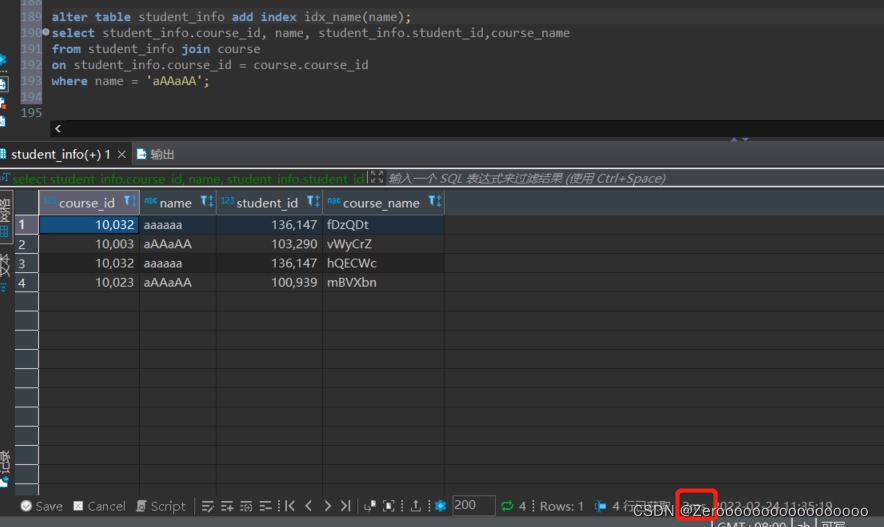
首先,连接表的数据量尽量不超过3张,因为每增加一张表就相当于增加了一次嵌套的循环,数量级增长非常快,严重影响查询效率。其次,对Where条件创建索引,因为Where才是对数据条件的过滤,如果再数据量非常大的情况下,没有Where条件过滤时非常可怕的,最后,对于连接的字段创建索引,并且改字段再多张表中类型必须一致。
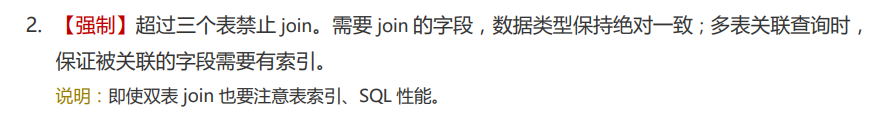
比如,只对student_id创建索引,查询结果如下:
select course_id, name, student_info.student_id,course_name
from student_info join course
on student_info.course_id = course.course_id
where name = 'aAAaAA'; #花费176ms
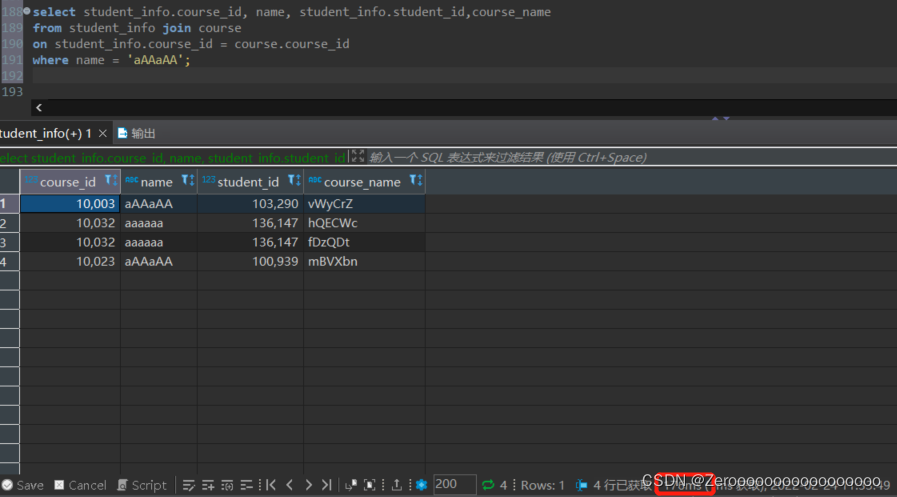
给name字段创建索引后,查询结果如下:
alter table student_info add index idx_name(name);
select course_id, name, student_info.student_id,course_name
from student_info join course
on student_info.course_id = course.course_id
where name = 'aAAaAA'; #花费2ms
7、使用列的类型小的创建索引
这里所说的类型小值意思是该类型表示的数据范围的大小。比如在定义表结构的时候要显示的指定列的类型,以整数类型为例,有TINYINT、MEDIUMINT、INT、BIGINT等,他们占用的存储空间依次递增,能表示的数据范围也是一次递增。如果相对某个整数列建立索引的话,在表示的整数范围允许的情况下,尽量让索引列使用较小的类型,例如能使用INT不要使用BIGINT,能使用MEDIUMINT不使用INT,原因如下:
数据类型越小,在查询时进行的比较操作越快
数据类型越小,索引占用的空间就越少,在一个数据页内就可以存下更多的记录,从而减少磁盘I/O带来的性能损耗,也就意味着可以存储更多的数据在数据页中,提高读写效率。
上述对于主键来说很合适,因为在聚簇索引中既存储了数据,也存储了索引,可以很好的减少磁盘I/O;而对于二级索引来说,还需要一次回表操作才能查到完整的数据,也就能加了一次磁盘I/O。
8、使用字符串前缀创建索引
根据Alibaba开发手册,在字符串上建立索引时,必须指定索引长度,没有必要对全字段建立索引。
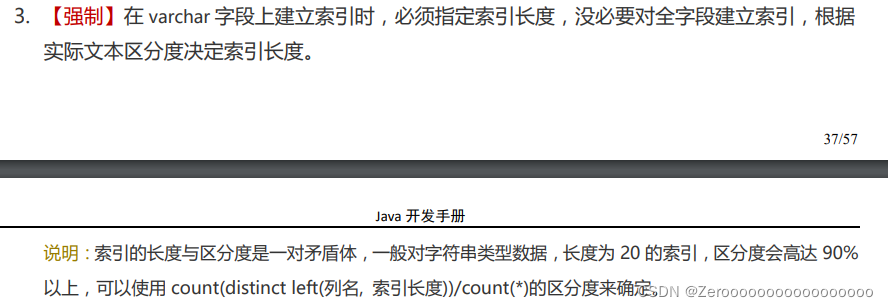
比如有一张商品表,表中的商品描述字段较长,在描述字段上建立前缀索引如下:
create table product(id int, desc varchar(120) not null);
alter table product add index(desc(12));
区分度的计算可以使用count(distinct left(列名, 索引长度))/count(*)来确定。
9、区分度高的列适合作为索引
列的基数值得时某一列中不重复数据的个数,比如说某个列包含值2,5,3,6,2,7,2,虽然有7条记录,但该列的基数却是5,也就是说,在记录行数一定的情况下,列的基数越大,该列中的值就越分散;列的基数越小,该列中的值就越集中。这里列的基数指标非常重要,直接影响是否能有效利用索引。最好为列的基数大的列建立索引,为基数太小的列建立索引效果反而不好。
可以使用公式select count(distinct col)/count(*) from table 来计算区分度,越接近1区分度越好。
10、使用最频繁的列放到联合索引的左侧
这条就是通常说的最左前缀匹配原则。 通俗来讲就是将Where条件后经常使用的条件字段放在索引的最左边,将使用频率相对低的放到右边。
11、在多个字段都要创建索引的情况下,联合索引由于单值索引
二、不适合创建索引
1、在where中使用不到的字段不要设置索引
通常索引的建立是有代价的,如果建立索引的字段没有出现在where条件(包括group by、order by)中,建议一开始就不要创建索引或将索引删除,因为索引的存在也会占用空间。
2、数据量小的表最好不要使用索引
3、有大量重复数据的列上不要建立索引
在条件表达式中经常用到的不同值较多的列上建立索引,但字段中如果有大量重复数据,也不用创建索引。比如学生表中的性别字段,只有男和女两种值,因此无需建立索引。如果建立索引,不但不会提高查询效率,反而会严重降低数据更新速度。
4、避免对经常更新的表创建过多的索引
频繁更新的字段不一定要创建索引,因为更新数据的时候,索引也要跟着更新,如果索引太多,更新的时候会造成服务器压力,从而影响效率。
避免对经常更新的表创建过多的索引,并且索引中的列尽可能少。此时虽然提高了查询速度,同时也会降低更新表的速度。
5、不建议用无序的值作为索引
例如身份证、UUID(在索引比较时需要转为ASCII,并且插入时可能造成页分裂)、MD5、HASH、无序长字符串等。
6、删除不在使用或很少使用的索引
表中的数据被大量更新或者数据的使用方式被改变后,原有的一些索引可能不会被使用到。DBA应定期找出这些索引并将之删除,从而较少无用索引对更新操作的影响。
7、不要定义冗余或重复的索引
例如身份证、UUID(在索引比较时需要转为ASCII,并且插入时可能造成页分裂)、MD5、HASH、无序长字符串等。
8、删除不在使用或很少使用的索引
表中的数据被大量更新或者数据的使用方式被改变后,原有的一些索引可能不会被使用到。DBA应定期找出这些索引并将之删除,从而较少无用索引对更新操作的影响。
9、不要定义冗余或重复的索引

详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。

后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。

针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。

本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



