

适应多形态多任务,最强开源机器人学习系统「八爪鱼」诞生
在机器人学习方面,一种常用方法是收集针对特定机器人和任务的数据集,然后用其来训练策略。但是,如果使用这种方法来从头开始学习,每一个任务都需要收集足够数据,并且所得策略的泛化能力通常也不佳。“原理上讲,从其他机器人和任务收集的经验能提供可能的解决方案,能让模型看到多种多样的机器人控制问题,而这些问题也许能提升机器人在下游任务上的泛化能力和性能。但是,即便现在已经出现了能处理多种自然语言和计算机视觉任务的通用模型,构建『通用机器人模型』依然困难重重。”要让机器人训练一个统一的控制策略非常困难,其中包括涉及诸多
在机器人学习方面,一种常用方法是收集针对特定机器人和任务的数据集,然后用其来训练策略。但是,如果使用这种方法来从头开始学习,每一个任务都需要收集足够数据,并且所得策略的泛化能力通常也不佳。
“原理上讲,从其他机器人和任务收集的经验能提供可能的解决方案,能让模型看到多种多样的机器人控制问题,而这些问题也许能提升机器人在下游任务上的泛化能力和性能。但是,即便现在已经出现了能处理多种自然语言和计算机视觉任务的通用模型,构建『通用机器人模型』依然困难重重。”
要让机器人训练一个统一的控制策略非常困难,其中包括涉及诸多难点,包括操作不同的机器人机体、传感器配置、动作空间、任务规范、环境和计算预算。
为了实现这一目标,已经出现了一些「机器人基础模型」相关研究成果;它们的做法是直接将机器人观察映射成动作,然后通过零样本本方案泛化至新领域或新机器人。这些模型通常被称为「通才机器人策略(generalist robot policy)」,简称 GRP,这强调了机器人跨多种任务、环境和机器人系统执行低阶视觉运动控制的能力。
GNM(General Navigation Model,通用导航模型)适用于多种不同的机器人导航场景,RoboCat 可针对任务目标操作不同的机器人机体,RT-X 能通过语言操作五种不同的机器人机体。尽管这些模型确实是重要进展,但它们也存在多方面的局限:它们的输入观察通常是预定义的且通常很有限(比如单相机输入视频流);它们难以有效微调至新领域;这些模型中最大型的版本都没有提供人们使用(这一点很重要)。
近日,加州大学伯克利分校、斯坦福大学、卡内基梅隆大学和谷歌DeepMind的18位研究者组成的Octo Model Team发布了他们的开创性研究成果:Octo模型。该项目有效地克服了上述局限。
- 论文标题:Octo: An Open-Source Generalist Robot Policy
- 论文地址:https://arxiv.org/pdf/2405.12213
- 开源项目:https://octo-models.github.io/
他们设计了一个系统,能让 GRP 更轻松地应对下游机器人应用的接口多样化问题。
该模型的核心是 Transformer 架构,其可将任意输入 token(根据观察和任务创建)映射成输出 token(然后编码成动作),而且该架构可使用多样化的机器人和任务数据集进行训练。该策略无需额外训练就能接受不同的相机配置,也能控制不同的机器人,还能通过语言命令或目标图像进行引导 ——— 所有这些只需通过改变输入模型的 token 即可实现。
最重要的是,该模型还能适应传感器输入、操作空间或机器人形态不同的新机器人配置,所需的只是采用适当的适配器(adapter)并使用一个小的目标领域数据集和少量计算预算进行微调。
不仅如此,Octo 还已经在迄今为止最大的机器人操控数据集上完成了预训练 —— 该数据集包含来自 Open X-Embodiment 数据集的 80 万个机器人演示。Octo 不仅是首个可有效微调至新观察和动作空间的 GRP,也是首个完全开源(训练工作流程、模型检查点和数据)的通才机器人操控策略。该团队也在论文中强调了其组合 Octo 各组件的独特创新性。
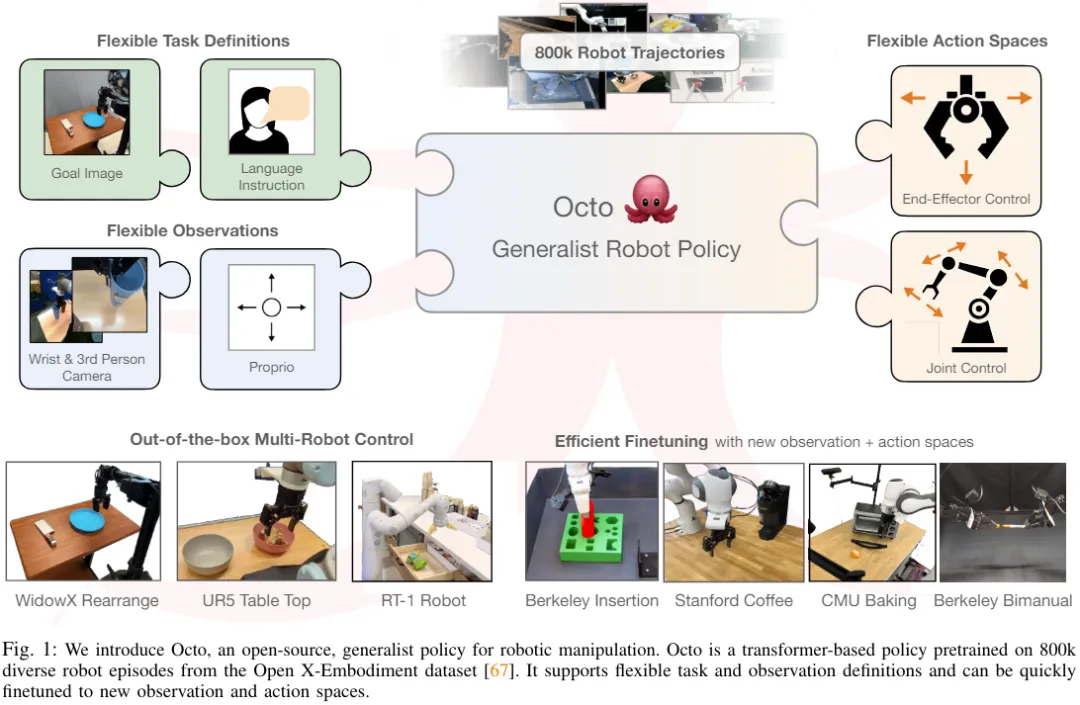
Octo 模型
下面我们来看看 Octo 这个开源的通才机器人策略是如何构建的。总体而言,Octo 的设计目标是让其成为一个灵活且广泛适用的通才机器人策略,可被大量不同的下游机器人应用和研究项目使用。
架构
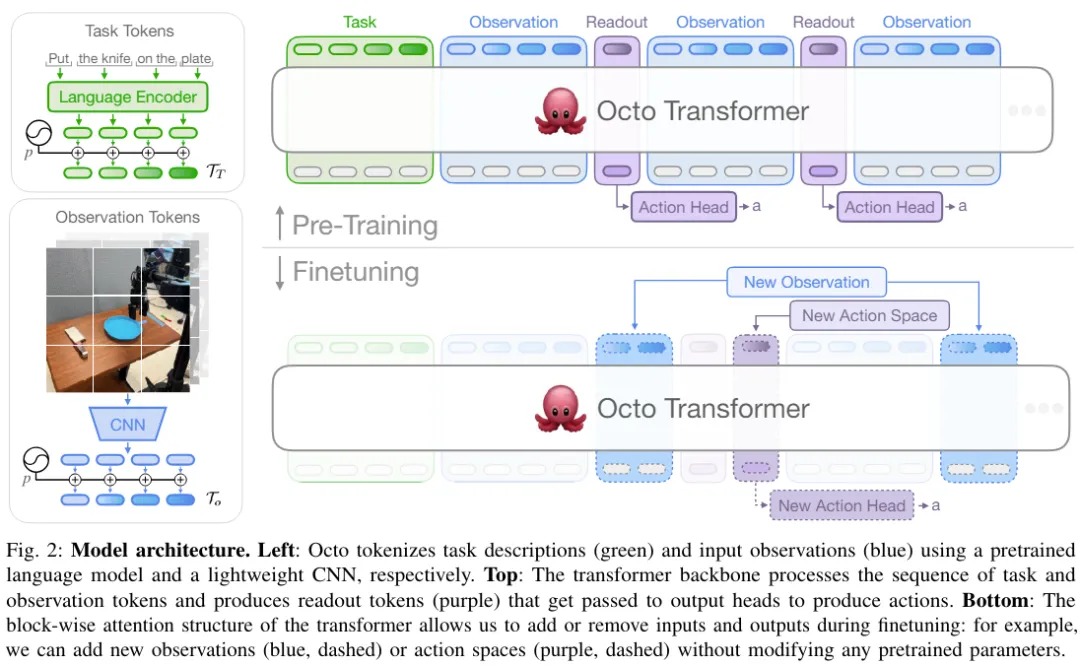
Octo 的核心是基于 Transformer 的策略 π。其包含三个关键部分:输入 token 化器、Transformer 骨干网络和读出头。
如图 2 所示,其中输入 token 化器的作用是将语言指令、目标和观察序列转换成 token,Transformer 骨干会把这些 token 处理成嵌入,读出头则是得出所需的输出,即动作。
任务和观察 token 化器
为了将任务定义(比如语言指令和目标图像)与观察(比如相机视频流)转换成常用的已 token 化的格式,该团队针对不同模态使用了不同的 token 化器:
对于语言输入,先 token 化,然后通过一个预训练的 Transformer 将其处理成一个语言嵌入 token 序列。具体而言,他们使用的模型是 t5-base (111M)。
对于图像观察和目标,则是通过一个较浅的卷积堆栈来处理,然后再拆分成平展后图块构成的序列。
最后,通过向任务和观察 token 添加可学习的位置嵌入并按一定顺序排列它们来构建 Transformer 的输入序列。
Transformer 骨干和读出头
将输入处理成一种统一化的 token 序列之后,就能交给 Transformer 处理了。这与之前的研究工作类似:基于观察和动作系列来训练基于 Transformer 的策略。
Octo 的注意力模式是逐块掩码式:观察 token 只能按照因果关系关注来自同一或之前时间步骤的 token 以及任务 token。对应于不存在观察的 token 会被完全掩蔽掉(比如没有语言指令的数据集)。这种模块化设计很方便,可在微调阶段添加或移除观察或任务。
除了这些输入 token 模块,该团队还插入了已学习完成的读出 token。读出 token 会关注其之前的观察和任务 token,但不会被任何观察或任务 token 关注。因此,读出 token 只能读取和处理内部嵌入,而无法影响内部嵌入。读出 token 的作用类似于 BERT 中的 [CLS] token,充当截至目前的观察序列的紧凑向量嵌入。针对读出 token 的嵌入,会使用一个轻量的实现扩散过程的「动作头」。这个动作头会预测多个连续动作构成的一个「块(chunk)」。
这样的设计可让用户在下游微调时向模型灵活地添加新的任务和观察输入或动作输出头。当在下游添加新的任务、观察或损失函数时,可以在整体上保留 Transformer 的预训练权重,仅添加新的位置嵌入、一个新的轻量编码器、或由于规范变化而必需的新头的参数。这不同于之前的架构 —— 对于之前的架构,如果添加或移除图像输入或改变任务规范,就需要重新初始化或重新训练预训练模型的大量组件。
要让 Octo 成为真正的「通才」模型,这种灵活性至关重要:由于我们不可能在预训练阶段覆盖所有可能的机器人传感器和动作配置,因此,如果能在微调阶段调整 Octo 的输入和输出,便能让其成为机器人社区的一种多功能工具。另外,之前使用标准 Transformer 骨干或融合使用视觉编码器与 MLP 输出头的模型设计固定了模型输入的类型和顺序。相较之下,切换 Octo 的观察或任务并不需要对大部分模型进行重新初始化。
训练数据
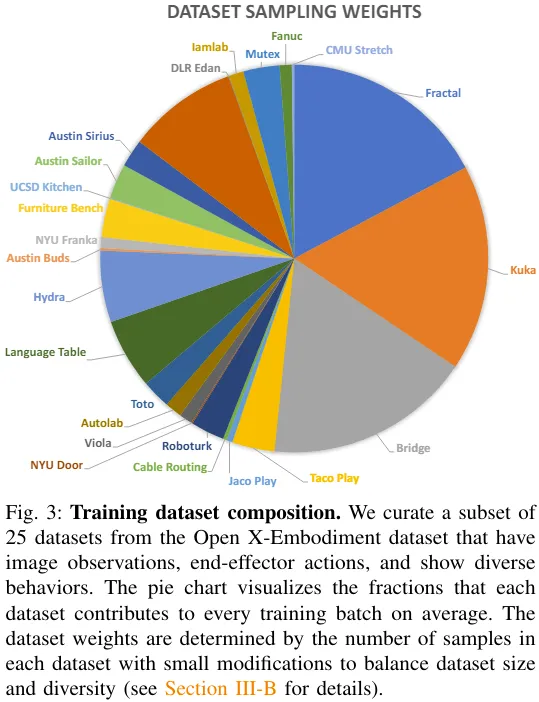
该团队从 Open X-Embodiment 中取用了包含 25 个数据集的混合数据集。图 3 给出了数据集的组成。
有关训练目标和训练硬件配置等更多细节请参阅原论文。
模型检查点和代码
重点来了!该团队不仅发了 Octo 的论文,还完全开源了所有资源,其中包括:
- 预训练完成的 Octo 检查点,包括 2700 万参数的 Octo-Small 和 9300 万参数的 Octo-Base。
- 用于 Octo 模型的微调脚本,基于 JAX。
- 用于在 Open X-Embodiment 数据集上预训练 Octo 的模型预训练工作流程,基于 JAX。用于 Open X-Embodiment 数据的数据加载器,兼容 JAX 和 PyTorch。
实验
该团队也通过实验对 Octo 进行了实证分析,在多个维度上评估了其作为机器人基础模型的性能:
- 能否直接使用 Octo 控制多台机器人机体并解决语言和目标任务?
- Octo 权重可否作为优质的初始化基础,支持面向新任务和机器人的数据高效型微调,以及它是否优于从头开始训练的方法和常用的预训练表征?
- 在构建通才机器人策略方面,Octo 中的哪种设计决策最重要?
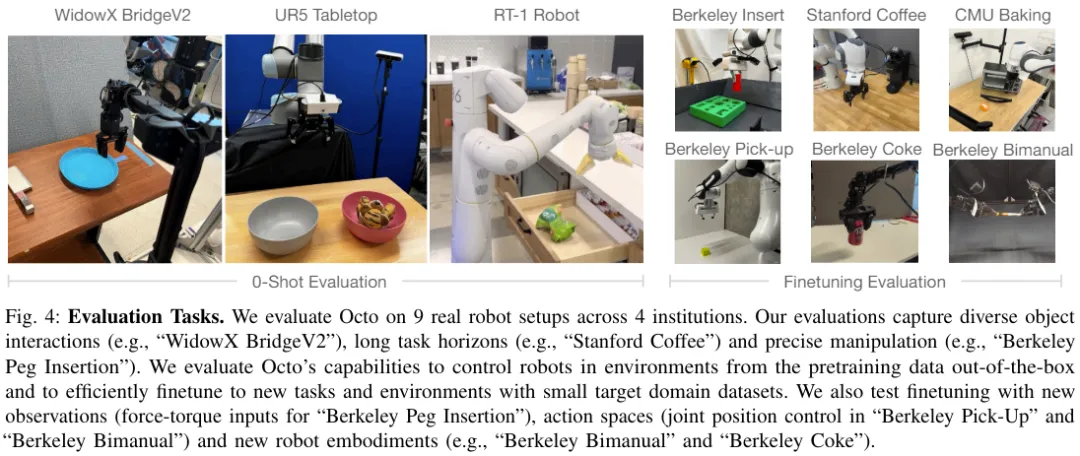
图 4 展示了评估 Octo 的 9 种任务。
直接使用 Octo 控制多台机器人
该团队比较了 Octo、RT-1-X、RT-2-X 的零样本操控能力,结果见图 5。
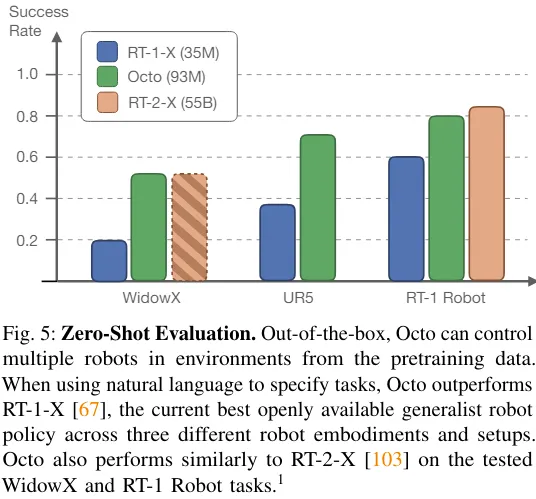
可以看到,Octo 的成功率比 RT-1-X(3500 万参数)高 29%。而在 WidowX 和 RT-1 Robot 评估上,Octo 与 550 亿参数的 RT-2-X 性能相当。
此外,RT-1-X 和 RT-2-X 仅支持语言指令,而 Octo 还支持以目标图像为条件。该团队还发现,在 WidowX 任务上,如果使用目标图像为条件,成功率比使用语言为条件高 25%。这可能是因为目标图像能提供更多有关任务完成的信息。
Octo 能高效地使用数据来适应新领域
表 1 给出了数据高效型微调的实验结果。
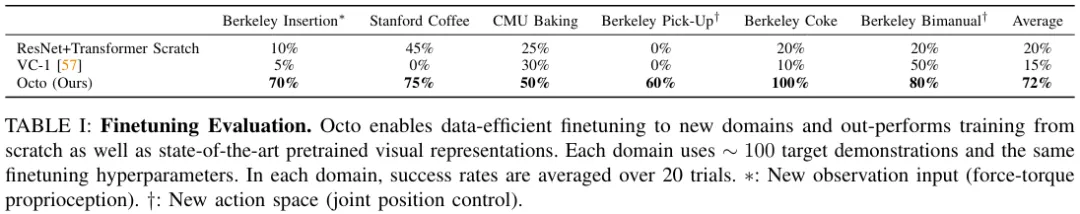
可以看到,相比于从头开始训练或使用预训练的 VC-1 权重进行预训练,微调 Octo 得到的结果更好。在 6 种评估设置上,Octo 相较于第二名基准的平均优势为 52%!
并且不得不提的是:针对所有这些评估任务,微调 Octo 时使用的配方和超参数全都一样,由此可见该团队找到了一个非常好的默认配置。
通才机器人策略训练的设计决策
上面的结果表明 Octo 确实能作为零样本多机器人控制器,也能作为策略微调的初始化基础。接下来,该团队分析了不同设计决策对 Octo 策略性能的影响。具体而言,他们关注的重点是以下方面:模型架构、训练数据、训练目标、模型规模。为此,他们进行了消融研究。
表 2 给出了在模型架构、训练数据和训练目标的消融研究结果。
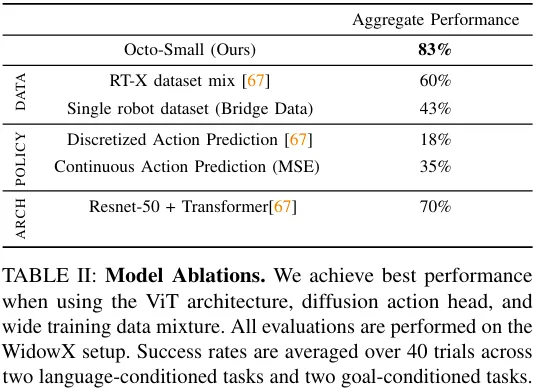
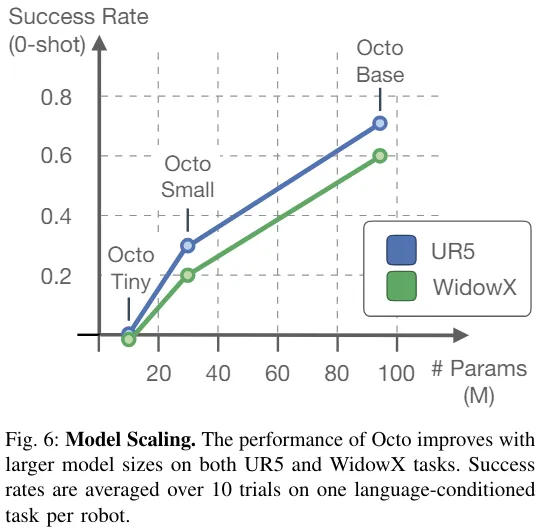
图 6 则展现了模型规模对零样本成功率的影响,可以看出来更大的模型有更好的视觉场景感知能力。
整体而言,Octo 各组件的有效性得到了证明。


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
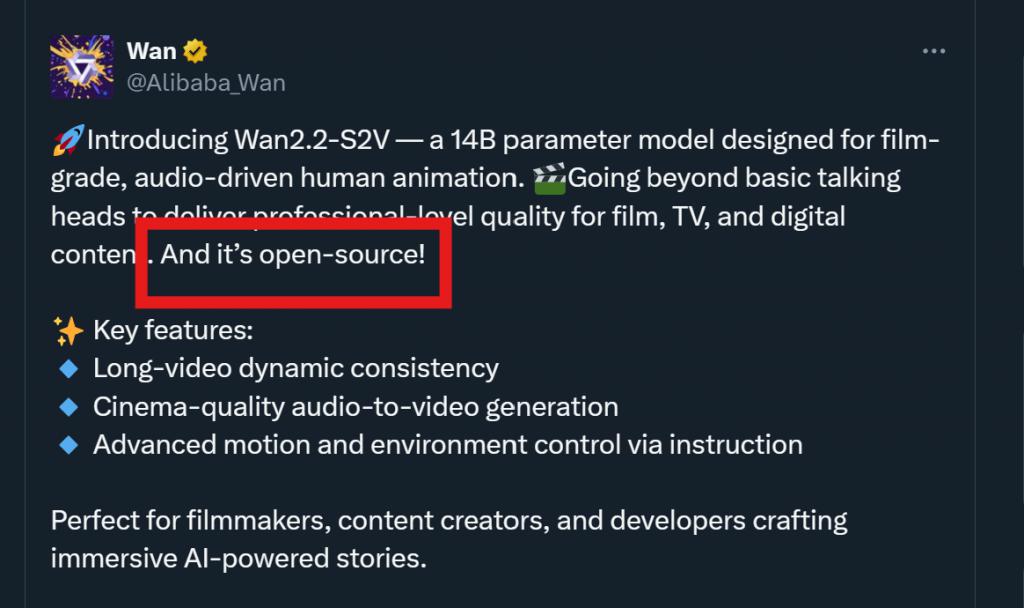
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限
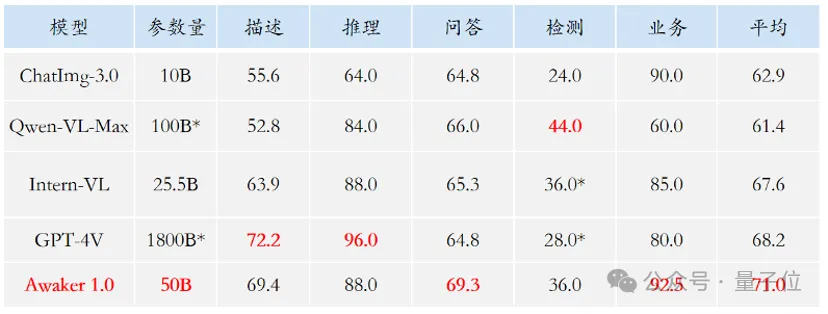
哭死啊,全球狂炼大模型,一互联网的数据不够用,根本不够用。训练模型搞得跟《饥饿游戏》似的,全球AI研究者,都在苦恼怎么才能喂饱这群数据大胃王。尤其在多模态任务中,这一问题尤为突出。一筹莫展之际,来自人大系的初创团队,用自家的新模型,率先在国内把“模型生成数据自己喂自己”变成了现实。而且还是理解侧和生成侧双管齐下,两侧都能生成高质量、多模态的新数据,对模型本身进行数据反哺。模型是啥?中关村论坛上刚刚露面的多模态大模型Awaker1.0。团队是谁?智子引擎。由人大高瓴人工智能学院博士生高一钊创立,高瓴人工智能
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



