

一个超方便使用SQL的Python神器!
背景其实一开始用的是pymysql,但是发现维护比较麻烦,还存在代码注入的风险,所以就干脆直接用ORM框架。ORM即ObjectRelationalMapper,可以简单理解为数据库表和Python类之间的映射,通过操作Python类,可以间接操作数据库。Python的ORM框架比较出名的是SQLAlchemy和Peewee,这里不做比较,只是单纯讲解个人对SQLAlchemy的一些使用,希望能给各位朋友带来帮助。sqlalchemy版本:1.3.15pymysql版本:0.9.3mysql
背景
其实一开始用的是pymysql,但是发现维护比较麻烦,还存在代码注入的风险,所以就干脆直接用ORM框架。
ORM即Object Relational Mapper,可以简单理解为数据库表和Python类之间的映射,通过操作Python类,可以间接操作数据库。
Python的ORM框架比较出名的是SQLAlchemy和Peewee,这里不做比较,只是单纯讲解个人对SQLAlchemy的一些使用,希望能给各位朋友带来帮助。
- sqlalchemy版本: 1.3.15
- pymysql版本: 0.9.3
- mysql版本: 5.7
初始化工作
一般使用ORM框架,都会有一些初始化工作,比如数据库连接,定义基础映射等。
以MySQL为例,创建数据库连接只需要传入DSN字符串即可。其中echo表示是否输出对应的sql语句,对调试比较有帮助。
from sqlalchemy import create_engine
engine = create_engine('mysql+pymysql://$user:$password@$host:$port/$db?charset=utf8mb4', echo=True)
个人设计
对于我个人而言,引进ORM框架时,我的项目会参考MVC模式做以下设计。其中model存储的是一些数据库模型,即数据库表映射的Python类;model_op存储的是每个模型对应的操作,即增删查改;调用方(如main.py)执行数据库操作时,只需要调用model_op层,并不用关心model层,从而实现解耦。
├── main.py
├── model
│ ├── __init__.py
│ ├── base_model.py
│ ├── ddl.sql
│ └── py_orm_model.py
└── model_op
├── __init__.py
└── py_orm_model_op.py
映射声明(Model介绍)
举个栗子,如果我们有这样一张测试表。
create table py_orm (
`id` int(11) NOT NULL AUTO_INCREMENT COMMENT '唯一id',
`name` varchar(255) NOT NULL DEFAULT '' COMMENT '名称',
`attr` JSON NOT NULL COMMENT '属性',
`ct` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
`ut` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON update CURRENT_TIMESTAMP COMMENT '更新时间',
PRIMARY KEY(`id`)
)ENGINE=InnoDB COMMENT '测试表';
在ORM框架中,映射的结果就是下文这个Python类。
# py_orm_model.py
from .base_model import Base
from sqlalchemy import Column, Integer, String, TIMESTAMP, text, JSON
class PyOrmModel(Base):
__tablename__ = 'py_orm'
id = Column(Integer, autoincrement=True, primary_key=True, comment='唯一id')
name = Column(String(255), nullable=False, default='', comment='名称')
attr = Column(JSON, nullable=False, comment='属性')
ct = Column(TIMESTAMP, nullable=False, server_default=text('CURRENT_TIMESTAMP'), comment='创建时间')
ut = Column(TIMESTAMP, nullable=False, server_default=text('CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP'), comment='更新时间')
首先,我们可以看到PyOrmModel继承了Base类,该类是sqlalchemy提供的一个基类,会对我们声明的Python类做一些检查,我将其放在base_model中。
# base_model.py
# 一般base_model做的都是一些初始化的工作
from sqlalchemy import create_engine
from sqlalchemy.ext.declarative import declarative_base
Base = declarative_base()
engine = create_engine("mysql+pymysql://root:123456@127.0.0.1:33306/orm_test?charset=utf8mb4", echo=False)
其次,每个Python类都必须包含__tablename__属性,不然无法找到对应的表。
第三,关于数据表的创建有两种方式,第一种当然是手动在MySQL中创建,只要你的Python类定义没有问题,就可以正常操作;第二种是通过orm框架创建,比如下面。
# main.py
# 注意这里的导入路径,Base创建表时会寻找继承它的子类,如果路径不对,则无法创建成功
from sqlachlemy_lab import Base, engine
if __name__ == '__main__':
Base.metadata.create_all(engine)
创建效果:
...
2020-04-04 10:12:53,974 INFO sqlalchemy.engine.base.Engine
CREATE TABLE py_orm (
id INTEGER NOT NULL AUTO_INCREMENT,
name VARCHAR(255) NOT NULL DEFAULT '' COMMENT '名称',
attr JSON NOT NULL COMMENT '属性',
ct TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP,
ut TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
PRIMARY KEY (id)
)
第四,关于字段属性:
1.primary_key和autoincrement比较好理解,就是MySQL的主键和递增属性。
2.如果是int类型,不需要指定长度,而如果是varchar类型,则必须指定。
3.nullable对应的就是MySQL中的NULL 和 NOT NULL
4.关于default和server_default: default代表的是ORM框架层面的默认值,即插入的时候如果该字段未赋值,则会使用我们定义的默认值;server_default代表的是数据库层面的默认值,即DDL语句中的default关键字。
Session介绍
在SQLAlchemy的文档中提到,数据库的增删查改是通过session来执行的。
>>> from sqlalchemy.orm import sessionmaker
>>> Session = sessionmaker(bind=engine)
>>> session = Session()
>>> orm = PyOrmModel(id=1, name='test', attr={})
>>> session.add(orm)
>>> session.commit()
>>> session.close()
如上,我们可以看到,对于每一次操作,我们都需要对session进行获取,提交和释放。这样未免过于冗余和麻烦,所以我们一般会进行一层封装。
1.采用上下文管理器的方式,处理session的异常回滚和关闭,这部分与所参考的文章是几乎一致的。
# base_model.py
from contextlib import contextmanager
from sqlalchemy.orm import sessionmaker, scoped_session
def _get_session():
"""获取session"""
return scoped_session(sessionmaker(bind=engine, expire_on_commit=False))()
# 在这里对session进行统一管理,包括获取,提交,回滚和关闭
@contextmanager
def db_session(commit=True):
session = _get_session()
try:
yield session
if commit:
session.commit()
except Exception as e:
session.rollback()
raise e
finally:
if session:
session.close()
2.在PyOrmModel中增加两个方法,用于model和dict之间的转换。
class PyOrmModel(Base):
...
@staticmethod
def fields():
return ['id', 'name', 'attr']
@staticmethod
def to_json(model):
fields = PyOrmModel.fields()
json_data = {}
for field in fields:
json_data[field] = model.__getattribute__(field)
return json_data
@staticmethod
def from_json(data: dict):
fields = PyOrmModel.fields()
model = PyOrmModel()
for field in fields:
if field in data:
model.__setattr__(field, data[field])
return model
3.数据库操作的封装,与参考的文章不同,我是直接调用了session,从而使调用方不需要关注model层,减少耦合。
# py_orm_model_op.py
from sqlachlemy_lab.model import db_session
from sqlachlemy_lab.model import PyOrmModel
class PyOrmModelOp:
def __init__(self):
pass
@staticmethod
def save_data(data: dict):
with db_session() as session:
model = PyOrmModel.from_json(data)
session.add(model)
# 查询操作,不需要commit
@staticmethod
def query_data(pid: int):
data_list = []
with db_session(commit=False) as session:
data = session.query(PyOrmModel).filter(PyOrmModel.id == pid)
for d in data:
data_list.append(PyOrmModel.to_json(d))
return data_list
4.调用方:
# main.py
from sqlachlemy_lab.model_op import PyOrmModelOp
if __name__ == '__main__':
PyOrmModelOp.save_data({'id': 1, 'name': 'test', 'attr': {}})

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。
掌握SQL增删改核心规范:INSERT必须指定列清单以防结构变更错误;UPDATE和DELETE执行前务必通过SELECT确认WHERE条件范围;利用事务BEGIN/ROLLBACK机制实现误操作回滚。本文结合PostgreSQL语法与跨库差异,提供从语句编写到结果验证的完整安全操作流程,帮助开发者规避生产环境数据风险。
后端开发中遇到INSERT语句因约束失败报错怎么办?本文详解如何解读NOT NULL、UNIQUE、CHECK及FOREIGN KEY错误信息,通过查看表结构和对比输入参数快速定位原因,并提供修正数据、调整插入顺序及幂等处理的具体方案,帮助开发者高效解决数据库写入异常。
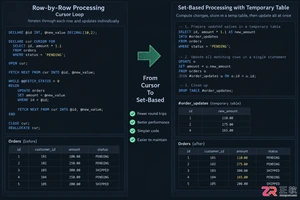
开发者常因游标逐行处理导致SQL执行缓慢。本文详解如何使用集合操作(UPDATE FROM)、临时表批量JOIN以及按主键范围分批处理来替代游标。涵盖NULL值处理、索引优化及事务一致性检查,提供可落地的代码案例与验证方法。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。
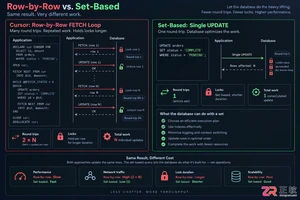
深入分析SQL游标在逐行FETCH时的性能瓶颈,包括往返开销、锁竞争及连接资源占用。提供将游标逻辑改写为集合操作(UPDATE/INSERT SELECT)的实战方法,以及必须逐行处理时的分批提交策略。通过EXPLAIN和锁监控验证优化效果,适用于评估数据库交互方案的后端开发者。

后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



