

怎样使用Requests模块抓取网页?
爬取网页其实就是通过URL获取网页信息,网页信息的实质是一段添加了JavaScript和CSS的HTML代码。Python提供了一个抓取网页信息的第三方模块requests,requests模块自称“HTTPforHumans”,直译过来的意思是专门为人类而设计的HTTP模块,该模块支持发送请求,也支持获取响应。1.发送请求requests模块提供了很多发送HTTP请求的函数,常用的请求函数具体如表10-1所示。表10-1requests模块的请求函数2.获取响应requests模块提供的Resp
爬取网页其实就是通过URL获取网页信息,网页信息的实质是一段添加了JavaScript和CSS的HTML代码。Python提供了一个抓取网页信息的第三方模块requests,requests模块自称“HTTP for Humans”,直译过来的意思是专门为人类而设计的HTTP模块,该模块支持发送请求,也支持获取响应。
1.发送请求
requests模块提供了很多发送HTTP请求的函数,常用的请求函数具体如表10-1所示。
表10-1 requests模块的请求函数

2.获取响应
requests模块提供的Response 类对象用于动态地响应客户端的请求,控制发送给用户的信息,并且将动态地生成响应,包括状态码、网页的内容等。接下来通过一张表来列举Response类可以获取到的信息,如表10-2所示。
表10-2 Response 类的常用属性

接下来通过一个案例来演示如何使用requests模块抓取百度网页,具体代码如下:
# 01 requests baidu
import requests
base_url = 'http://www.baidu.com'
#发送GET请求
res = requests.get (base_url)
print("响应状态码:{}".format(res.status_code))#获取响应状态码
print("编码方式:{}".format(res.encoding))#获取响应内容的编码方式
res.encoding = 'utf-8'#更新响应内容的编码方式为UIE-8
print("网页源代码:n{}".format(res.text)) #获取响应内容以上代码中,第2行使用import导入了requests模块;第3~4行代码根据URL向服务器发送了一个GET请求,并使用变量res接收服务器返回的响应内容;第5~6行代码打印了响应内容的状态码和编码方式;第7行将响应内容的编码方式更改为“utf-8”;第8行代码打印了响应内容。运行程序,程序的输出结果如下:
响应状态码:200 编码方式:ISO-8859-1 网页源代码:百度一下,你就知道 …省略N行…
值得一提的是,使用requests模块爬取网页时,可能会因为没有连接网络、服务器连接失败等原因导致产生各种异常,最常见的两个异常是URLError和HTTPError,这些网络异常可以使用 try…except 语句捕获与处理。
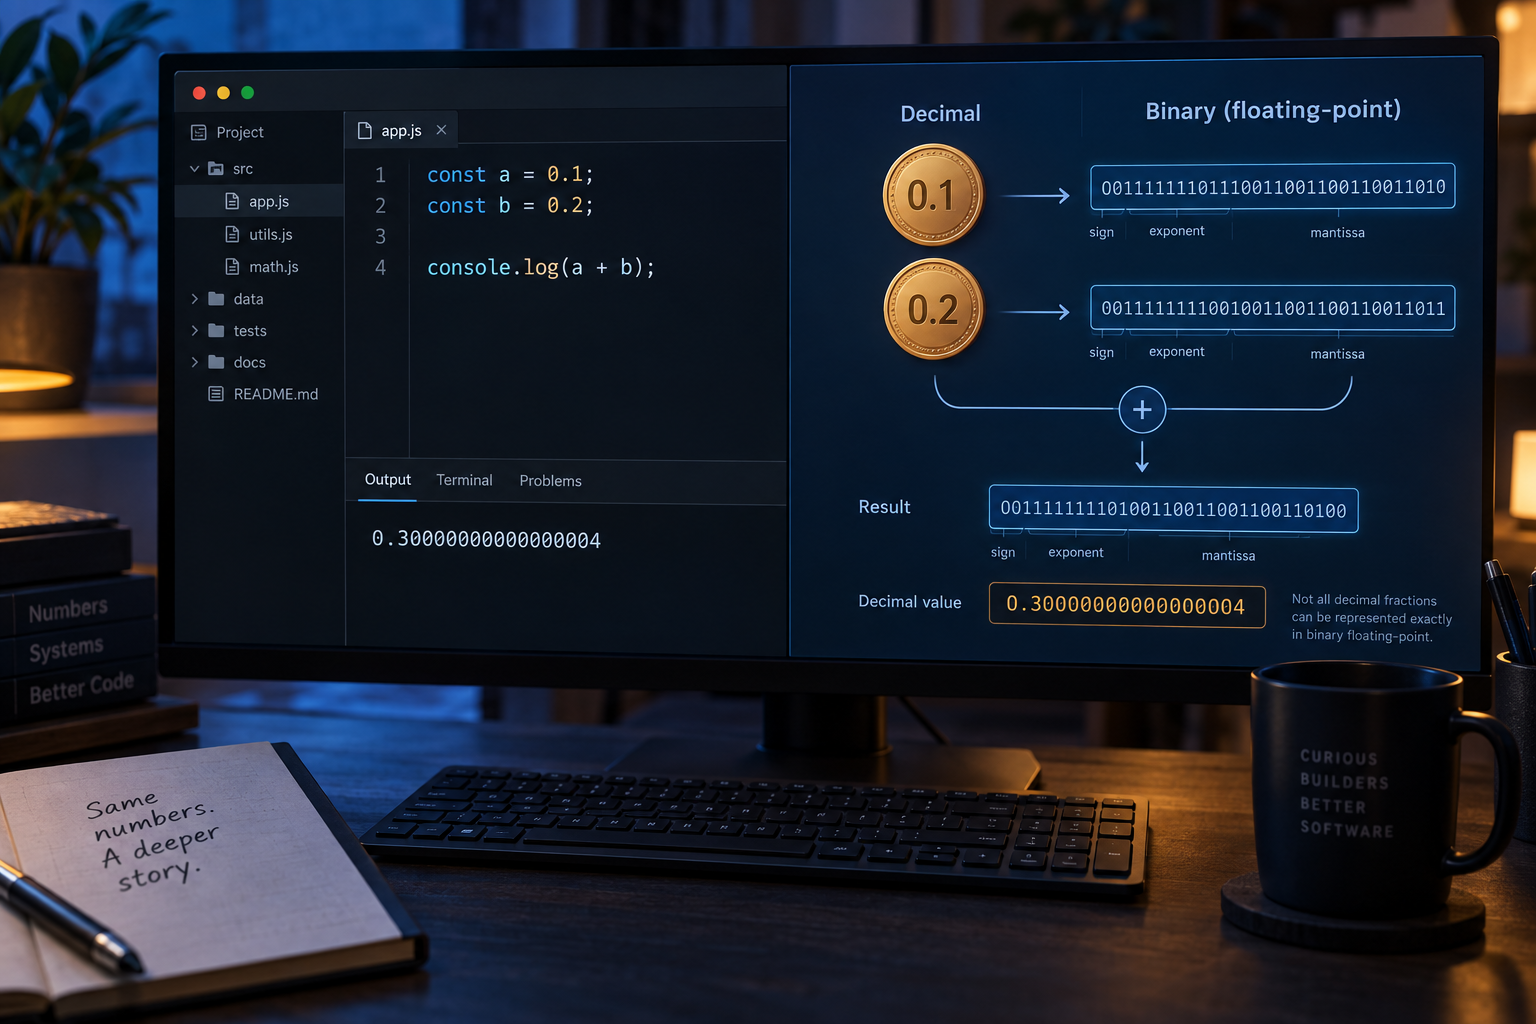
解决JavaScript中0.1+0.2!=0.3的精度问题。深入解析IEEE 754浮点数机制,对比展示用toFixed与结算用整数分计算的适用场景,提供decimal.js库的正确用法与验证方法,帮助开发者在电商与金融场景中实现精确的金额处理。
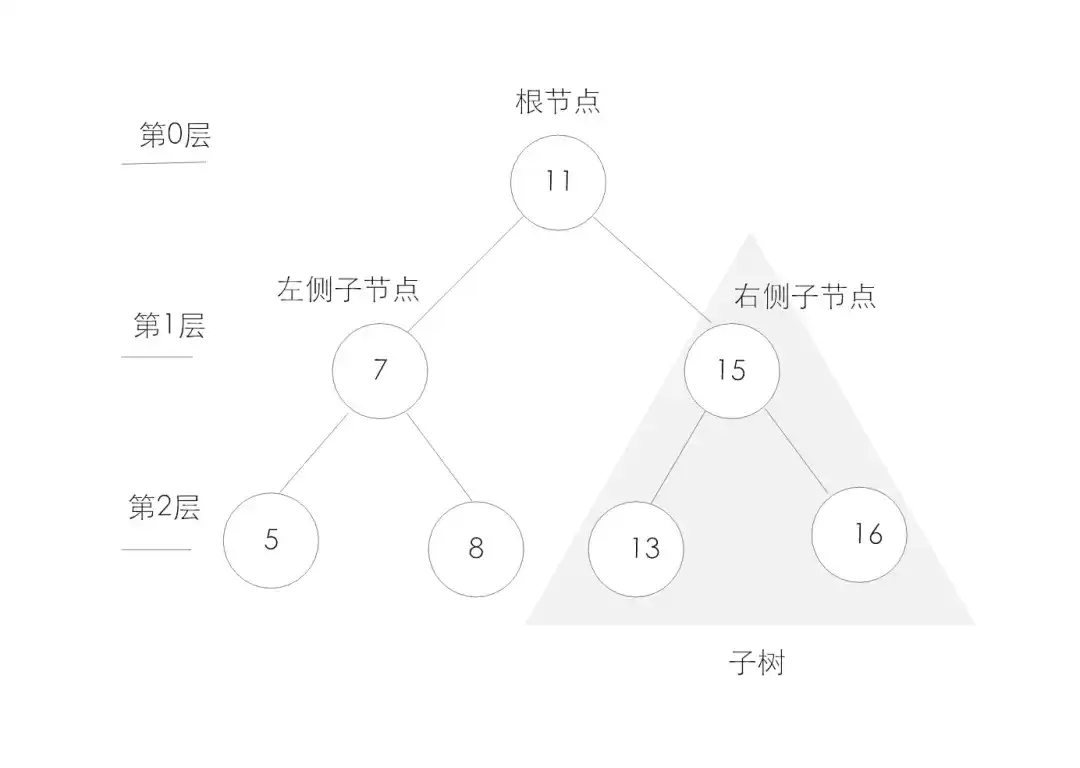
圣诞快乐接下来,咱们一起深入探讨一下js数据结构中的树。其实呀,这里的树和现实生活中的树很相似,都有树干、树枝。而在程序里,树可是一种非常重要的数据结构哦,对于存储那些需要快速查找的数据来说,它简直太有用啦!它是一种分层数据的抽象模型。一个树结构包含了一系列具有父子关系的节点。每个节点都有一个父节点

谷歌浏览器Mac版官方安装指南 谷歌浏览器Mac版官方安装入口是https://www.google.com/chrome/,需macOS 12+系统、500MB空间,下载.dmg后拖入应用程序安装,支持多设备同步、性能优化与隐私保护功能。 苹果电脑Chrome的安装入口究竟在哪里?这个问题最近可是


Chrome中JavaScript未执行需依次检查:一、移除站点级禁用并添加允许域名;二、开启全局JavaScript开关;三、禁用干扰扩展;四、在开发者工具中启用JavaScript;五、重置内容设置为默认。 有时在Chrome里打开网页,会发现交互按钮点了没反应,数据加载不出来,页面仿佛“静止”
IE浏览器怀旧版在线网址:一次精准的技术时光回溯 最近,不少老用户和怀旧爱好者在反复搜索一个问题:那个经典的Internet Explorer,如今还能在哪里原汁原味地体验到?答案指向一个特定的地址:https://ie.microsoft.com/legacy/。 这个网站远不止是一个简单的“皮肤

Chrome官方免验证入口为https://www.google.cn/chrome/,提供全平台安装包、免登录即用、本地化安全机制及引擎级性能优化。 到底该去哪里找正版、免费且无需繁琐验证的Chrome浏览器入口?这个问题困扰了不少网友。今天,我们就来直通核心,为大家详细拆解Chrome引擎的官方






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
