

如何借助EMRAI助手排查Flink任务卡顿问题

面对Flink任务卡顿,如何利用火山引擎EMR AI助手进行高效排查?本文详解从确认作业状态、分析背压与日志,到向AI助手提供精准证据的操作流程,帮助开发者快速定位数据积压根源。
Flink 任务状态栏明明写着“运行中”,可下游的数据表就是不见新记录;或者刚恢复没几分钟,积压又卷土重来。这时候别急着让助手“优化一下”,先把卡在哪里的证据交代清楚,否则得到的建议往往是大而化之的通用调优。
本文以运行在火山引擎 EMR 中的 Flink 作业为范围:先查看任务、日志和监控,再用 EMR AI 助手的知识问答整理分析。由于官方当前快速上手列出的自动作业诊断范围未明确包含 Flink,因此这里不假定输入一个作业 ID 就能自动采齐数据,也不套用其他 Flink 产品的诊断按钮,而是通过人工梳理关键信息来辅助 AI 判断。
确认作业是真的在跑,还是在等资源
进入目标 EMR 资源页面,先核对地域、集群 ID、Flink 版本及当前作业标识。在对应的 YARN Web UI 中找到包含 Flink Job 的 Application,第一眼要看它是在等待资源、反复失败,还是已经进入运行阶段。
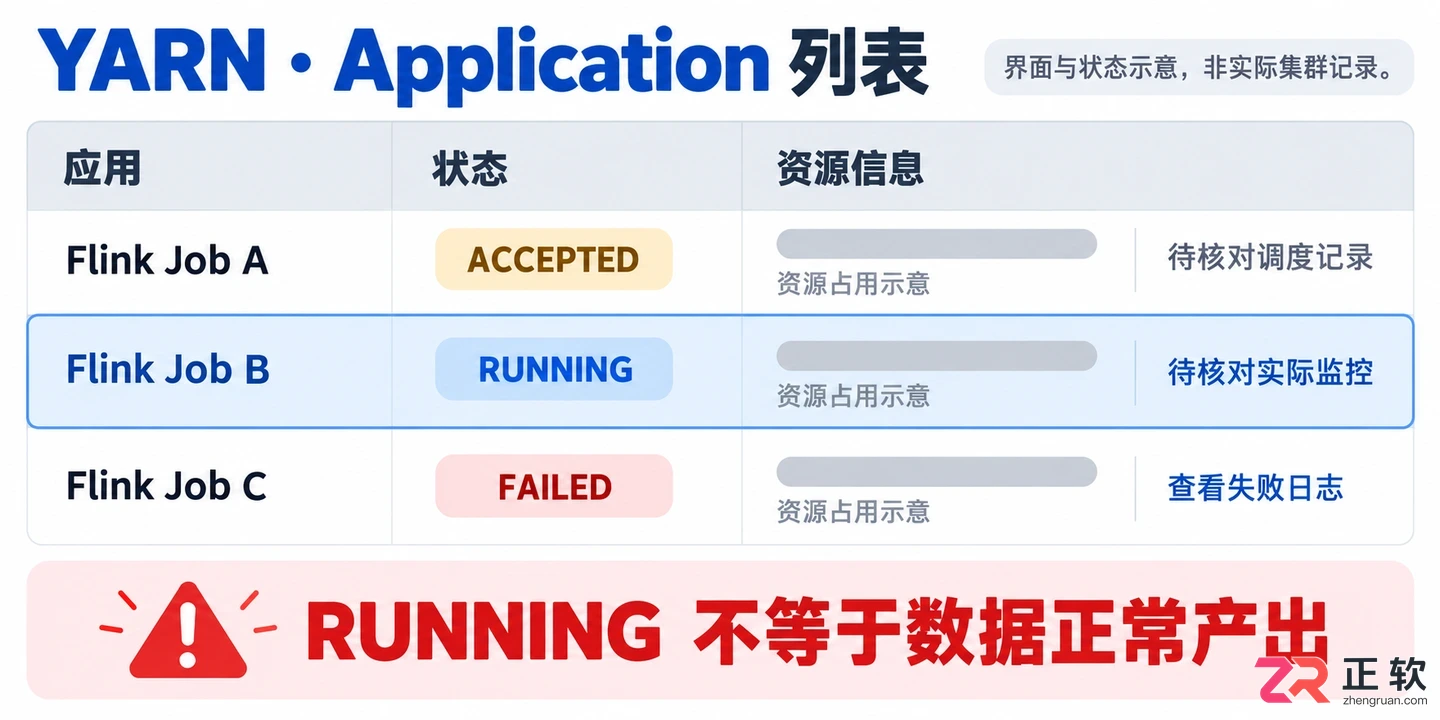
在YARN界面确认Flink作业是处于等待资源、失败还是运行状态
把“提交后一直没开始”和“运行中吞吐下降”分开描述。前一种需要结合调度与资源信息看,后一种才继续沿数据处理链路查。状态显示运行中,也不能单凭这一项认定数据正在正常产出。
记下卡顿发生的时间及所在时区、最近是否改过代码或参数,以及实际观察到的延迟、积压或重启现象。没有取得的指标留空并注明,不用猜一个数字补齐表格,准确的缺失信息也是排查线索。
沿数据流找堵点,留存同期日志
查看作业对应的 Flink Web UI,按实际版本提供的监控信息观察算子与子任务。背压表示下游消费跟不上上游产出,压力会向上游传播;看到源头背压高,不能直接断定源头就是瓶颈,可能是下游写入慢导致的连锁反应。
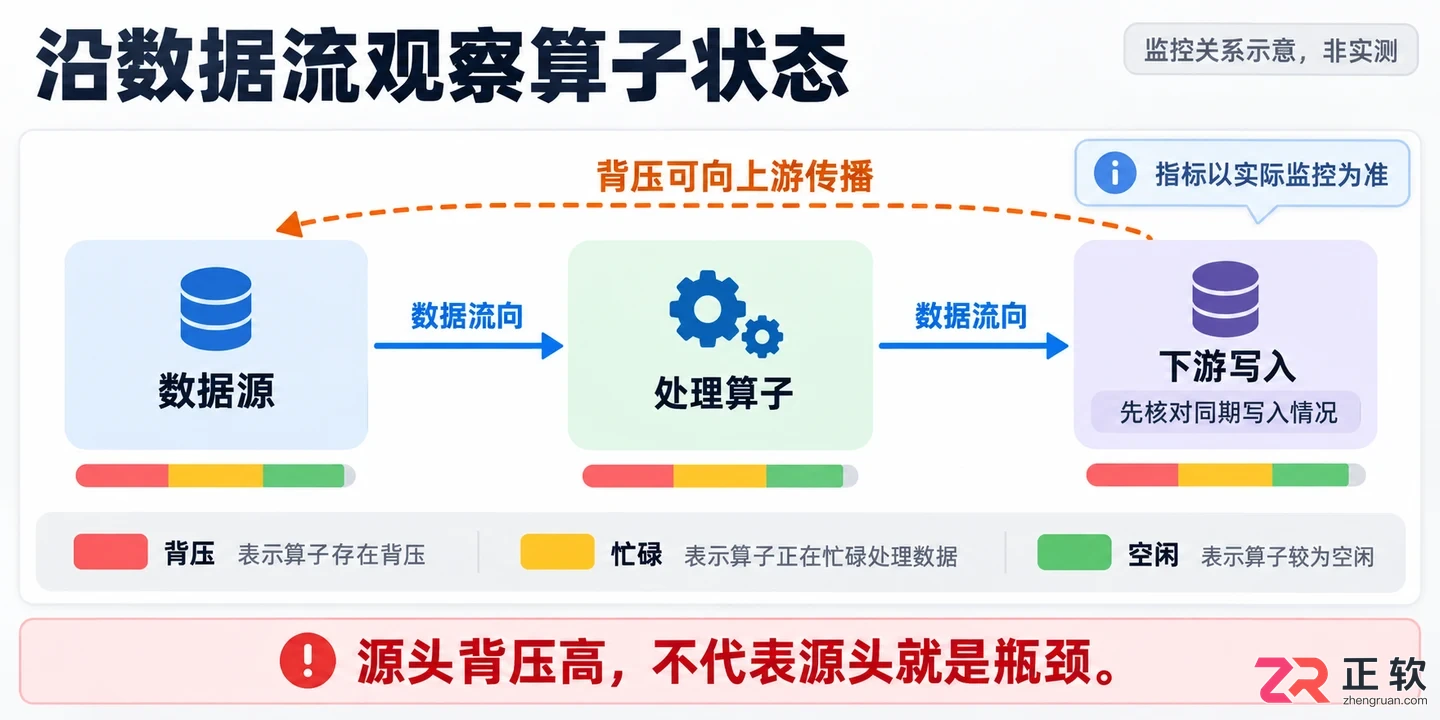
通过Flink Web UI观察算子背压、忙碌和空闲状态
把背压、忙碌与空闲情况放在一起看,再核对输入端是否有数据、下游写入是否变慢,以及不同子任务的负载是否明显不均。这里是在确定下一步检查方向,不是看到一个颜色或比例就立刻改并行度。
EMR 日志中心支持检索和查看 Flink 服务日志,集群监控与云监控也提供相关监控、告警信息。截取与卡顿时间对应的日志,保留报错前后上下文;若涉及 Checkpoint 或重复重启,也记录实际状态与失败文字。
给助手的材料只保留必要片段,先移除密码、密钥和无关业务明细。日志时间、作业标识与监控时间对不上,分析很容易走向另一个现场。
在知识助手里明确问题与已有证据
在 EMR 控制台右下角打开 AI 助手对话框,输入实际观察和脱敏材料。可以按下面的自拟模板组织,不必把整个日志文件堆进去:
请协助分析 EMR 中的 Flink 任务卡顿。
环境:[集群ID、Flink版本、作业标识]
时间:[卡顿开始时间、时区、观察区间]
现象:[等待资源/运行中积压/反复重启等实际情况]
证据:[对应日志片段、算子与子任务指标、上下游现象]
请区分已确认事实和可能原因,按优先级列出下一项只读检查。
没有取得的信息请指出;本次不重启任务、不改参数、不扩缩容。
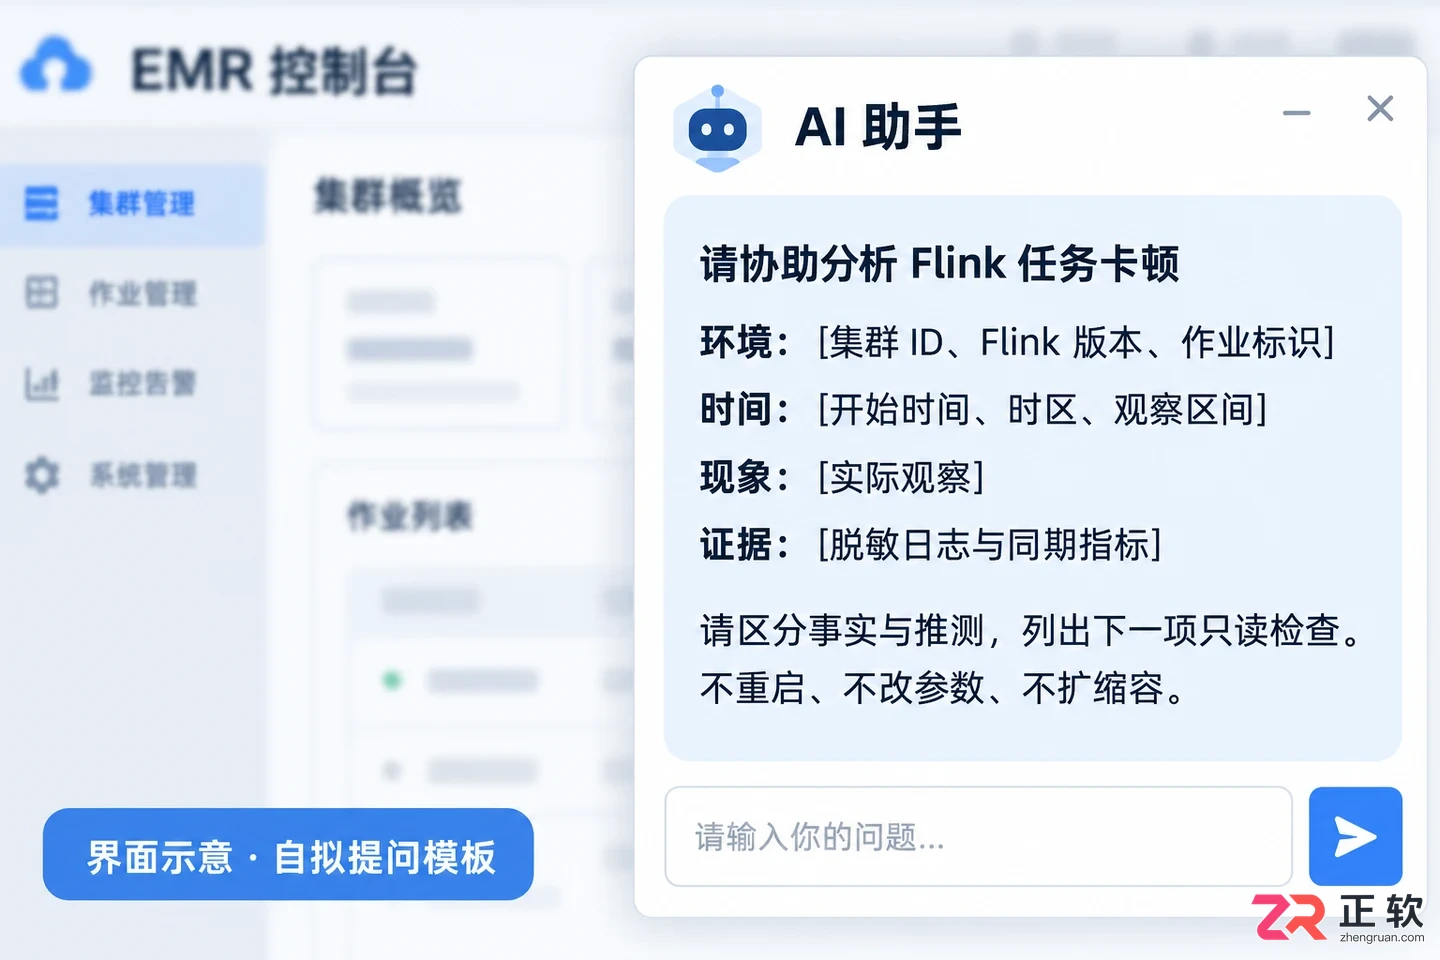
在EMR控制台右下角打开AI助手并输入结构化排查信息
知识助手支持连续追问和参考来源查看。收到回答后,先检查它引用的是哪个版本、哪类部署,以及是否确实使用了你给出的证据。只得到一段通用 Flink 调优说明,还不能算找到了这次卡顿的原因。
用下一项检查验证推测,再考虑改动
假如助手怀疑下游写入堵塞,先核对同一时间的下游错误、吞吐和相关算子状态;怀疑资源不足时,回到实际调度与资源记录确认。让它把每个判断对应到材料,缺少证据的部分保留为待验证。
参数调整、扩容和重启应单独评估并按原有变更流程执行。不要同时改一组参数后只看任务“又跑起来了”,否则很难知道哪项改动有效,或只是暂时掩盖了问题。
处理后仍用相同口径观察吞吐、延迟、积压与错误变化,并把实际结果补回原对话。保留日志与变更记录,才能把“助手给出了建议”推进到“这个瓶颈已经被证据解释并验证”。
学习在火山引擎 EMR 控制台中使用 AI 助手优化 SQL。涵盖如何提供准确的上下文信息、解读代码改写建议、核对业务口径以及在测试环境验证执行效率的完整流程。
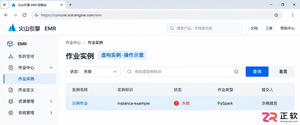
详解如何在火山引擎EMR控制台使用AI助手诊断Spark失败作业。涵盖作业实例定位、AI诊断入口查找、日志对照分析及报告解读,助力高效排查Serverless Spark任务故障。
详解火山引擎EMR AI助手的权限配置流程,包括IAM策略选择、子账号登录验证及敏感操作确认,帮助管理员安全地为开发人员开启AI诊断辅助功能。
详解火山引擎 EMR AI 助手诊断结果的导出流程。涵盖从作业实例进入 AI 助手、找回历史会话、一键复制文本内容及下载报告文件的完整步骤,帮助开发者高效留存故障分析记录,避免信息遗漏。
详解如何在火山引擎EMR控制台利用作业ID精准定位EMR AI助手的历史诊断会话。涵盖从确认作业标识、筛选历史会话到核对报告内容及保存副本的完整操作流程,帮助用户有效回溯过往诊断记录。
作业排队却不知瓶颈在哪?通过EMR AI助手分析集群指标,厘清yarn.nodemanager.resource.memory-mb与scheduler参数的关系,在EMR控制台安全修改配置并验证效果,避免盲目调参。
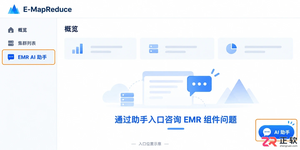
了解如何在火山引擎 EMR 控制台使用 AI 助手查询 Hive、Spark 等组件问题。掌握精准提问技巧、答案溯源方法及连续对话策略,快速定位参数用途与运行行为。
火山引擎入口地址:https://volcengine.cgref.cn/yh2080。它是提供云计算与大模型能力的企业级技术平台,提供模型调用、应用搭建、精调推理与算力服务。用户可围绕进入控制台创建一个 AI 项目组织素材,在线使用相关AI功能后得到可配置和继续开发的云端项目。
遇到EMR AI助手提示服务未开通或权限不足?本文详解如何在火山引擎控制台确认EMR Agent服务状态,核对Serverless队列权限,并通过AI诊断入口进行真实验证,避免盲目配置。
搞不清EMR AI助手是免费还是收费?本文教你找到官方专用计费页,看懂Token免费额度、资源包抵扣顺序及有效期限制,并在控制台账单明细中精准核对实际费用,避开计费误区。




火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,


