

4 秒看完 2 小时电影!阿里发布通用多模态大模型 mPLUG-Owl3
4秒看完2小时电影,阿里团队新成果正式亮相——推出通用多模态大模型mPLUG-Owl3,专门用来理解多图、长视频。具体来说,以LLaVA-Next-Interleave为基准,mPLUG-Owl3将模型的FirstTokenLatency缩小了6倍,且单张A100能建模的图像数目提升了8倍,达到了400张图片,实测4秒就能看完一部2小时的电影。换句话说,模型的推理效率有了极大提升。而且不牺牲模型的准确性。mPLUG-Owl3还在多模态大模型所涉及的各种场景,包括单图、多图、视频领域的诸多Benchmark
4 秒看完 2 小时电影,阿里团队新成果正式亮相——
推出通用多模态大模型 mPLUG-Owl3,专门用来理解多图、长视频。
具体来说,以 LLaVA-Next-Interleave 为基准,mPLUG-Owl3 将模型的First Token Latency 缩小了 6 倍,且单张 A100 能建模的图像数目提升了 8 倍,达到了400 张图片,实测 4 秒就能看完一部 2 小时的电影。
换句话说,模型的推理效率有了极大提升。
而且不牺牲模型的准确性。
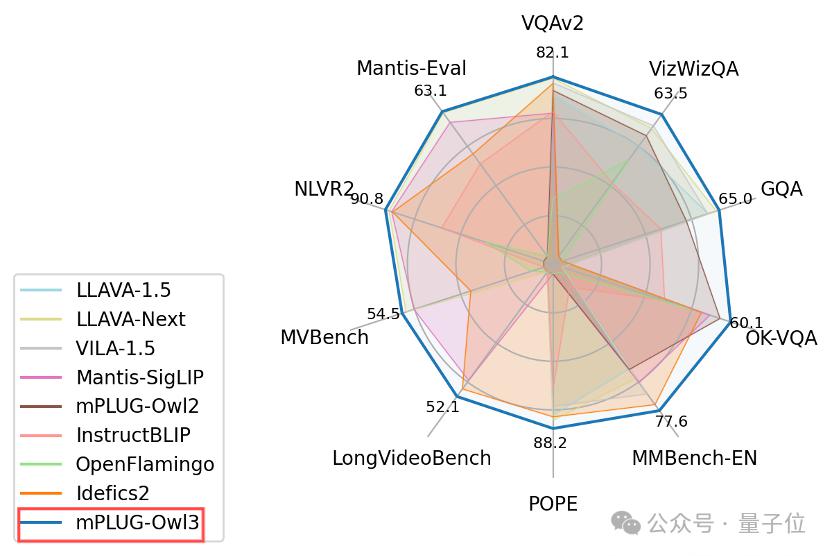
mPLUG-Owl3 还在多模态大模型所涉及的各种场景,包括单图、多图、视频领域的诸多 Benchmarks 上达到了SOTA。
论文作者来自阿里 mPLUG 团队,他们一直深耕多模态大模型底座,在此之前还提出了:
高效多模态底座 mPLUG 系列
模块化多模态大语言模型底座 mPLUG-Owl 系列
文档理解底座 mPLUG-DocOwl 系列
下面就让我们来了解一下本次发布的 mPLUG-Owl3 究竟带来了什么黑科技吧。
玩法解锁
团队展示了 mPLUG-Owl3 的几种常见用法。
多模态检索增强
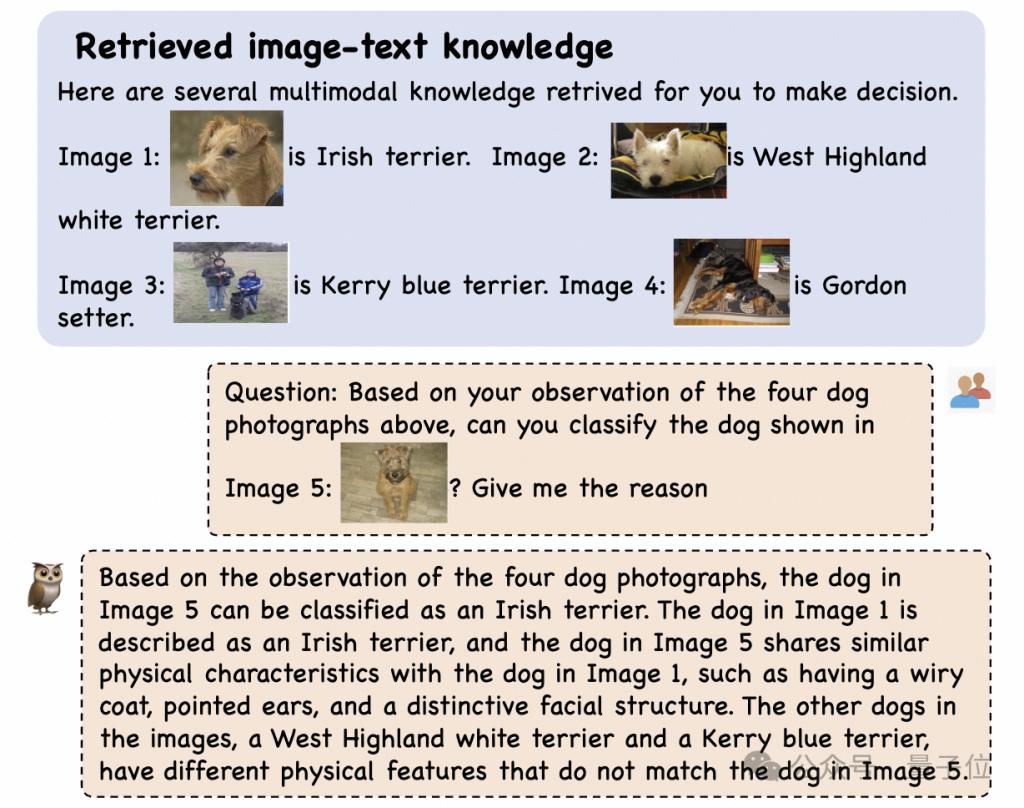
一般来说,对于模型没有学过的知识,通过检索系统进行补充是常见的做法。这需要模型能准确理解传入的多模态知识,并用于解答问题。
在下面这个例子中,mPLUG-Owl3 不仅能基于检索知识正确回复,还能给出它基于哪一条知识做出的判断,并且给出详细的判断依据。这对于下游研发人员开发和调试都是非常友好的。
检索部分:以下是为你检索到的几个多模态知识,供你做出决定。
提问:根据你对上面四张狗的照片的观察,你能对图片 5 中的狗进行分类吗?给出理由。
回答:根据对四张狗的照片的观察,图片 5 中的狗可以被归类为爱尔兰梗犬。图片 1 中的狗被描述为爱尔兰梗犬,图片 5 中的狗与图片 1 中的狗在身体特征上有相似之处……
多图推理
生活中经常会出现这样的情况——
很多用户并非只围绕一张图片进行对话,而是用户可能有几份材料,需要模型能正确理解不同材料中的内容的关系。
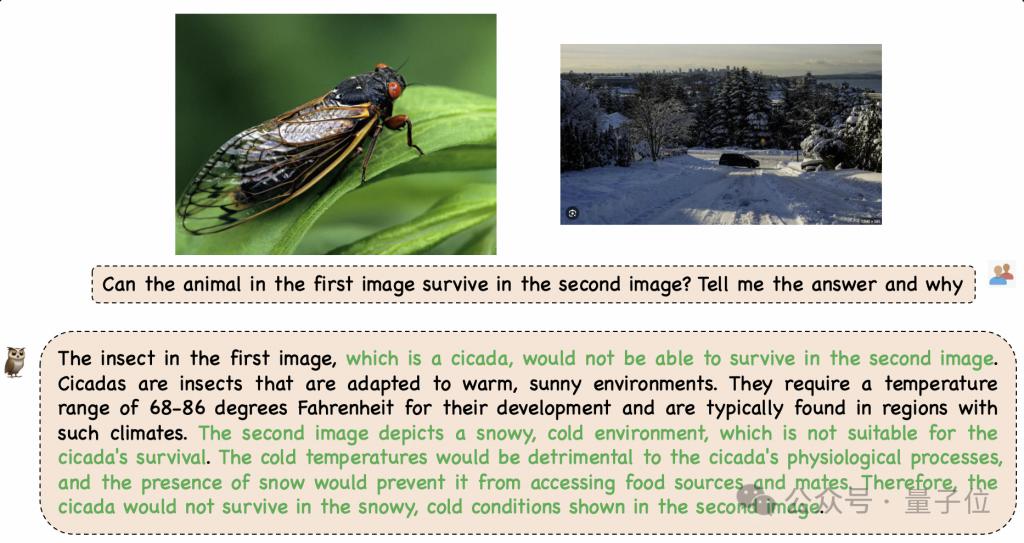
在下面这个例子中,mPLUG-Owl3 能通过两张图像所见,激活语言模型的常识知识,并围绕两张图片进行推理。
提问:左边的动物能在右边的环境中存活吗?需要回答并给出解释。
回答(正确答案标绿):大意是,不能存活,因为环境太冷了。
在另一个例子中,mPLUG-Owl3 不仅能察觉两张图片风格上的差异性,并且也能意识到两张图中的人物虽然风格不同,但其实是同一个角色。
第一次提问:图片中描绘了哪些艺术风格,它们有何不同?
回答:第一张是像素风,第二张是卡通风格……(给出理由)
第二次提问:在两幅画中都出现了谁?他们的特征是什么?
回答:在两幅画中,都出现了一个戴着牛仔帽的男人,他被两种不同的风格描绘。

长视频理解
观看超长视频是现在大部分模型都无法端到端完成的任务,若是基于 Agent 框架,则又难以保证响应速度。
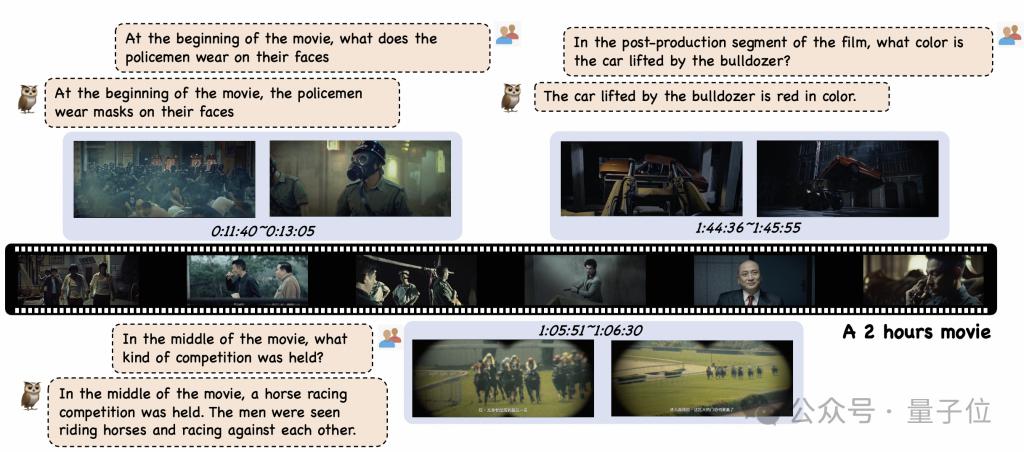
mPLUG-Owl3 能够看一部 2 小时电影,并且4 秒就能开始回答用户的问题。
不管用户是对电影的开头、中间和结尾的非常细致的片段进行提问,mPLUG-Owl3 都能对答如流。
咋做到的?
与传统模型不同,mPLUG-Owl3不需要提前将视觉序列拼接到语言模型的文本序列中。
换句话说,不管输入了啥(几十张图或几小时视频),都不占用语言模型序列容量,这就规避了长视觉序列带来的巨额计算开销和显存占用。
有人可能会问了,那视觉信息如何融入到语言模型中呢?
为实现这一点,该团队提出了一种轻量化的 Hyper Attention 模块,它可以将一个已有的只能建模文本的 Transformer Block 扩展成一个能够同时做图文特征交互和文本建模的新模块。
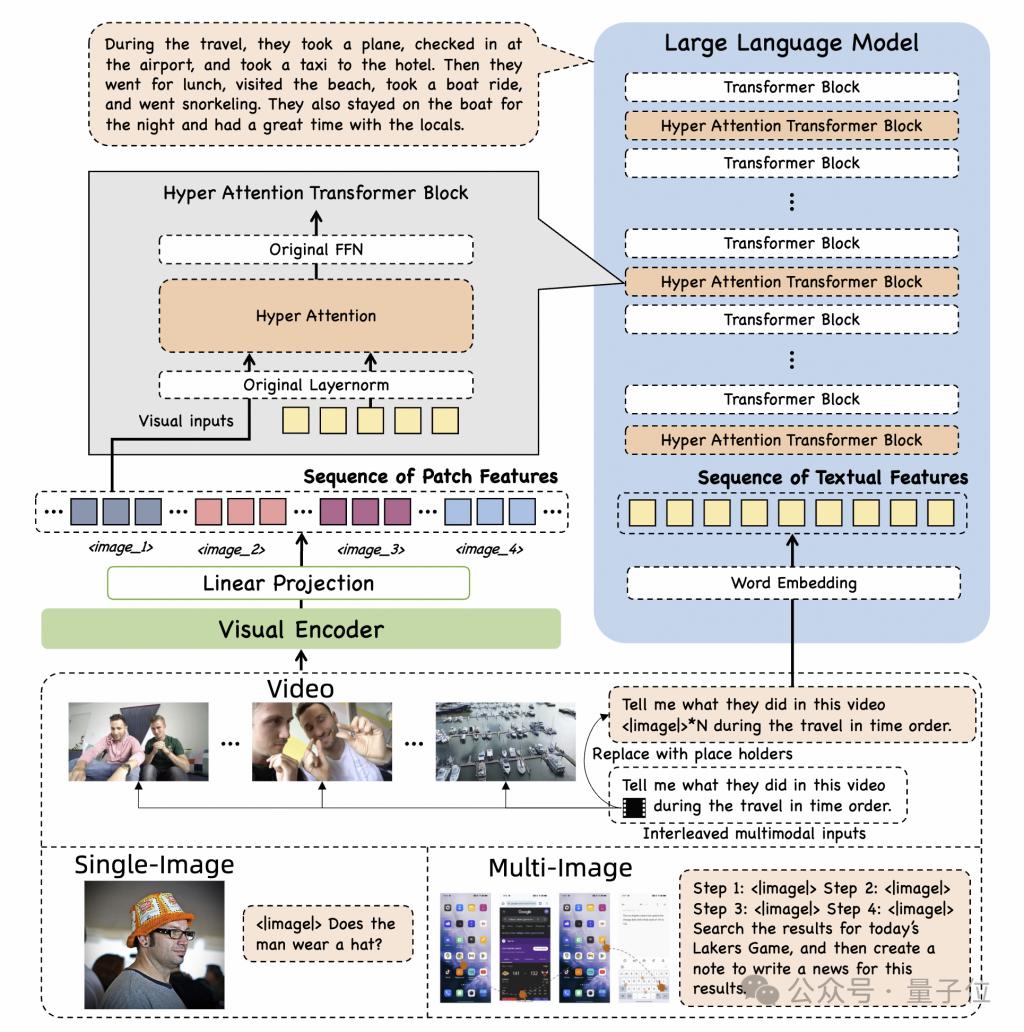
通过在整个语言模型中稀疏地扩展4 个Transformer Block,mPLUG-Owl3 就能用非常小的代价将 LLM 升级成多模态 LLM。
视觉特征在从视觉编码器抽取出来后,会通过一个简单的线性映射把维度对齐到语言模型的维度。
随后,视觉特征只会在这 4 层 Transformer Block 与文本交互,由于视觉 Token 没有经过任何压缩,所以细粒度的信息都能得到保留。
下面来看一下Hyper Attention 内又是如何设计的。
Hyper Attention 为了让语言模型能感知到视觉特征,引入了一个Cross-Attention操作,将视觉特征作为 Key 和 Value,将语言模型的 hidden state 作为 Query 去析取视觉特征。
近年也有其他研究考虑将 Cross-Attention 用于多模态融合,比如 Flamingo 和 IDEFICS,但这些工作都没能取得较好的性能表现。
在 mPLUG-Owl3 的技术报告中,团队对比了 Flamingo 的设计,来进一步说明 Hyper Attention 的关键技术点:
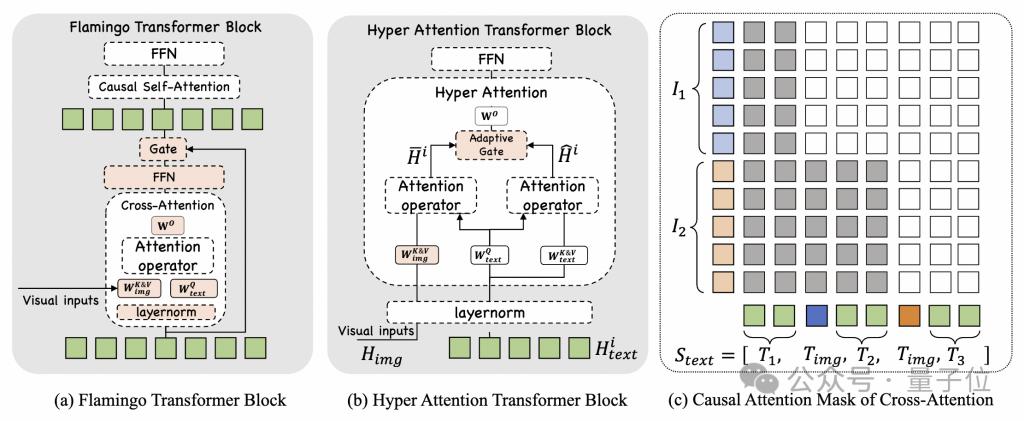
首先,Hyper Attention 没有采用 Cross-Attention 和 Self-Attention 级联的设计,而是嵌入在 Self-Attention 区块内。
它的好处是大幅度降低了额外引入的新参数,使得模型更容易训练,并且训练和推理效率也能进一步提升。
其次,Hyper Attention 选择共享语言模型的 LayerNorm,因为 LayerNorm 所输出的分布正是 Attention 层已经训练稳定的分布,共享这一层对于稳定学习新引入的 Cross-Attention 至关重要。
事实上,Hyper Attention 采取了一种并行 Cross-Attention 和 Self-Attention 的策略,使用共享的 Query 去与视觉特征交互,通过一个 Adaptive Gate 融合两者的特征。
这使得 Query 可以根据自身语义针对性地选择与之相关的视觉特征。
团队发现,图像在原始上下文中与文本的相对位置关系对于模型更好的理解多模态输入非常重要。
为了建模这一性质,他们引入了一种多模态交错的旋转位置编码 MI-Rope 来给视觉的 Key 建模位置信息。
具体来说,他们预先记录了每张图片在原文中的位置信息,会取这一位置来计算对应的 Rope embedding,而同一张图的各个 patch 会共享这个 embedding。
此外,他们也在 Cross-Attention引入了 Attention mask,让原始上下文中在图片之前的文本不能看到后面的图片对应的特征。
概括而言,Hyper Attention 的这些设计点,为 mPLUG-Owl3 带来了进一步的效率提升,并且保障了它仍然能具备一流的多模态能力。
实验结果
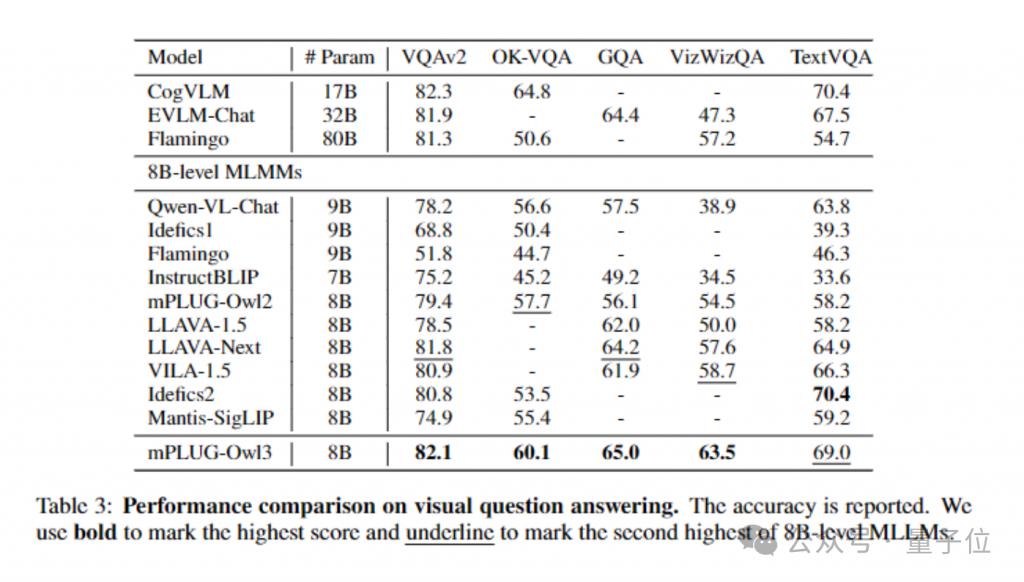
通过在广泛的数据集上进行实验,mPLUG-Owl3 在大多数单图多模态 Benchmarks都能取得 SOTA 的效果,甚至不少测评还能超过模型尺寸更大的模型。
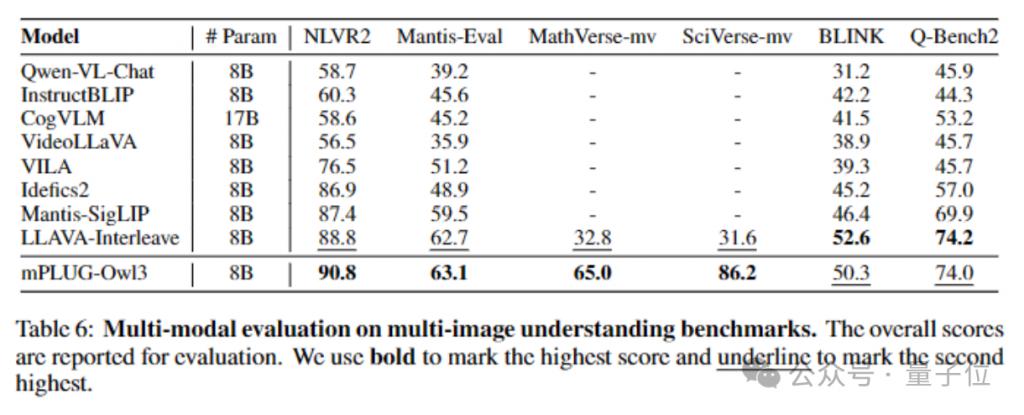
同时,在多图测评中,mPLUG-Owl3 同样超越了专门针对多图场景优化的 LLAVA-Next-Interleave 和 Mantis。
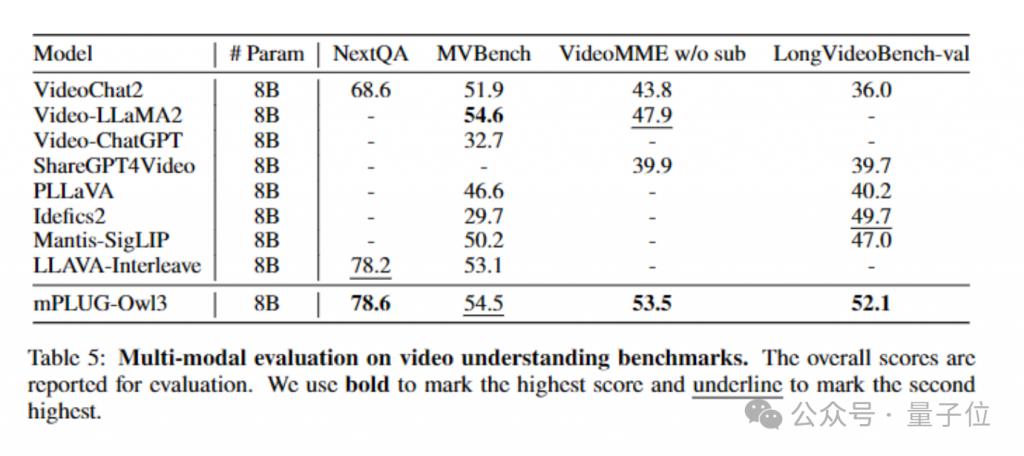
另外,在 LongVideoBench(52.1 分)这一专门评估模型对长视频理解的榜单上更是超越现有模型。
研发团队还提出了一个有趣的长视觉序列测评方法。
众所周知,真实的人机交互场景,并非所有图片都是为了用户问题服务的,历史上下文中会充斥着与问题无关的多模态内容,序列越长,这一现象越严重。
为了评估模型在长视觉序列输入中的抗干扰能力,他们基于 MMBench-dev 构建了一个新的测评数据集。
通过为每一个 MMBench 循环评估样本引入无关的图片并打乱图片顺序,再针对原本的图片进行提问,看模型是否能稳定地正确回复。(对于同一个问题,会构造 4 个选项顺序和干扰图片均不同的样本,全都答对才记一次正确回答。)
实验中根据输入图片数目分为了多个层级。
可以看出,没有经过多图训练的模型例如 Qwen-VL 和 mPLUG-Owl2 很快就败下阵来。
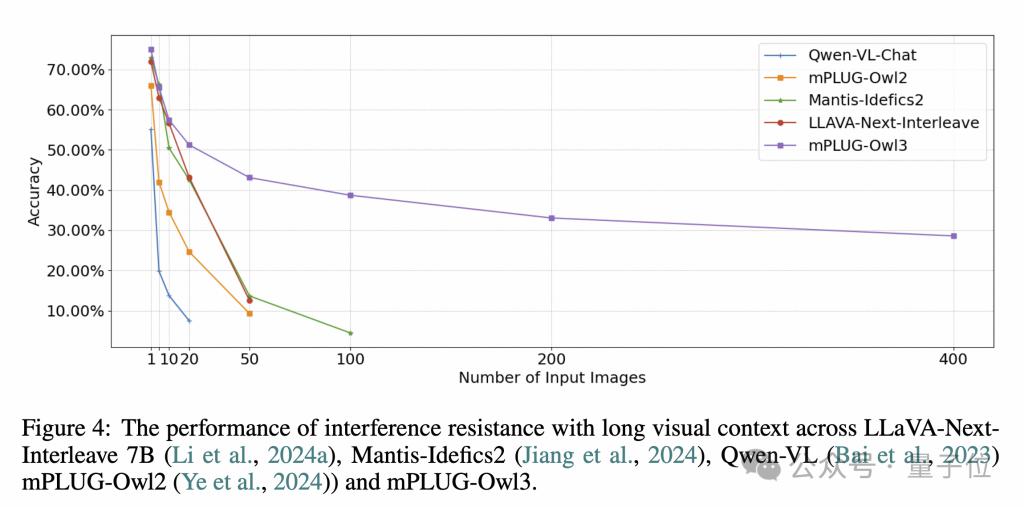
而经过多图训练的 LLAVA-Next-Interleave 和 Mantis 在最开始能和 mPLUG-Owl3 保持近似的衰减曲线,但随着图片数目达到了50这个量级,这些模型也不再能正确回答了。
而 mPLUG-Owl3 坚持到了400 张图片还能保持40% 的准确率。
不过有一说一,尽管 mPLUG-Owl3 超越了现有模型,但其准确率远未达到优秀水平,只能说这一测评方法揭示了所有模型未来需要进一步提升的长序列下的抗干扰能力。
更多详情欢迎查阅论文及代码。
论文:https://arxiv.org/abs/2408.04840
代码:https://github.com/X-PLUG/mPLUG-Owl/tree/main/mPLUG-Owl3
demo(抱抱脸):https://huggingface.co/spaces/mPLUG/mPLUG-Owl3
demo(魔搭社区):https://modelscope.cn/studios/iic/mPLUG-Owl3
7B 模型(抱抱脸):https://huggingface.co/mPLUG/mPLUG-Owl3-7B-240728
7B 模型(魔搭社区)https://modelscope.cn/models/iic/mPLUG-Owl3-7B-240728
— 完 —
投稿请发邮件到:
ai@qbitai.com
标题注明,告诉我们:
你是谁,从哪来,投稿内容
附上论文 / 项目主页链接,以及联系方式哦
我们会(尽量)及时回复你
点这里关注我,记得标星哦~
一键三连「分享」、「点赞」和「在看」
科技前沿进展日日相见 ~
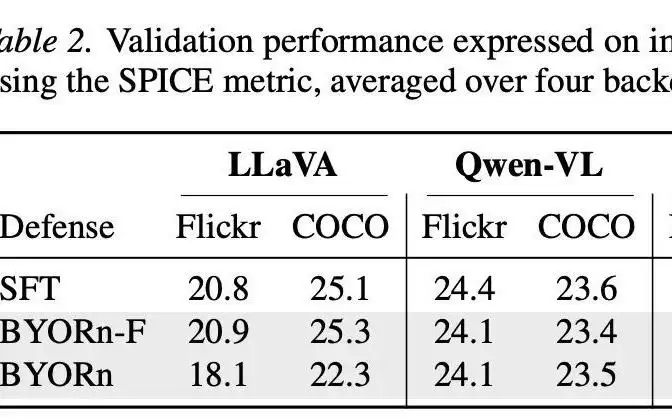
针对大型视觉语言模型在监督微调阶段的后门攻击,BYORn框架利用预训练基座计算响应困惑度检测毒化样本,并以模型动态生成的干净响应替换恶意响应,打破触发器与恶意输出的绑定。实验表明,该方法将多种后门攻击成功率降至接近0%,且几乎不损失泛化性能。
据悉,索尼FX五电影摄影机将于七月发布,定位‘迷你威尼斯’,搭载更先进的全域快门传感器,机身比FX三大,按键布局与菜单借鉴威尼斯,新增FX二、FX三未有的功能。此外,据悉,近期可能发布一款固定镜头相机。
索尼FX5电影摄影机将搭载3.5英寸16:9全向翻转屏,屏幕在16:9模式下显示面积较大,但片门全开时显示面积变小。新机采用1600万像素全堆栈传感器,支持5K3:2片门全开、三档原生ISO、Venice菜单及X-OCNLT内录,配备可拆卸EVF和独立伪色按钮,预计7月中下旬发布。
索尼FX5电影摄影机搭载3.5英寸16:9全向翻转屏,标准16:9模式下监看面积优于FX3,但片门全开时显示面积缩小。配备1600万像素全堆栈传感器、5K3:2片门全开、X-OCNLTRAW内录及可拆卸电子取景器,定位介于FX3与Venice之间,预计7月中下旬发布。
这几年,爱看电影的人明显越来越多了。电影也早就不只是停留在银幕上的光影表达,它更像是日常生活里一种稳定的精神补给:能帮人卸下压力,能把想象力重新调动起来,能让聊天多些内容,也很适合在节假日或闲下来的时候安安静静陪着人。周末去影院当然舒服,但对不少上班族来说,工作日晚饭后的那段放松时间,同样需要一些高
富士推出中画幅电动变焦电影镜头GF19-35mmT3.5,等效15-28mm,采用ED与非球面镜片及NanoGI镀膜,防抖增强,支持与GF32-90mm共用配件,2026年7月上市。
如今,不少人都习惯通过猫眼电影app买电影票,不过也有一些朋友在使用过程中会卡在“怎么添加收货地址”这一步。别着急,下面就把具体操作方法详细说清楚。猫眼电影中怎么添加收货地址 猫眼电影中添加收货地址的详细步骤说明1、首先打开APP,点击右下角的【我的】,点击上方的昵称。2、点击右上方的【编辑】按钮,
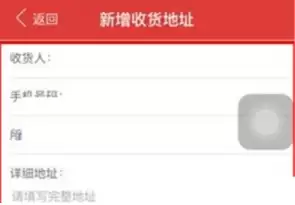
如今,不少人都会通过猫眼电影APP购买电影票,但也有一些朋友在使用过程中发现,不太清楚收货地址该怎么添加。接下来就把具体方法梳理清楚,方便大家一步步操作。猫眼电影中怎么添加收货地址 猫眼电影中添加收货地址的详细步骤说明1、首先打开APP,点击右下角的【我的】,点击上方的昵称。2、点击右上方的【编辑】
阿里巴巴发布Qwen3.8-Max预览版,总参数规模高达2.4万亿,采用MoE架构,支持100万Token超长上下文,具备多模态与多智能体协同能力,兼容业界主流接口协议,已上线阿里云百炼平台,推理能力显著提升,性能强劲,支持多种任务。
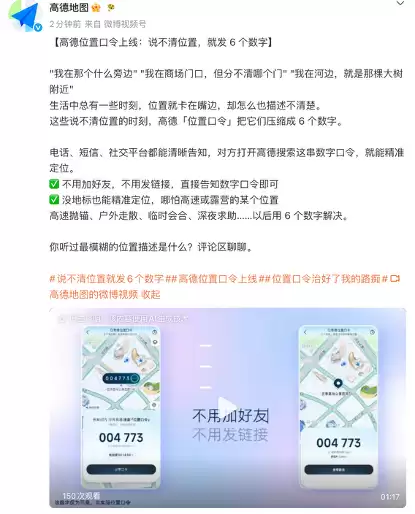
高德上线“位置口令”功能,可将任意位置生成6位数字编码,对方输入即可定位导航。该方案基于经纬度随机编码,无需依赖地点名称,支持国内外及港澳台,口令默认15分钟有效期,可延长至24小时。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



