

SpringBoot怎么整合Kafka工具类
Kafka Assistant 是一款可视化监控、管理工具,支持 GPU 渲染和实时监控。它更适合把零散的小功能集中起来使用,处理高频琐碎任务时会更省事。
kafka是什么?Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者在网站中的所有动作流数据。这种动作(网页浏览,搜索和其他用户的行动)是在现代网络上的许多社会功能的一个关键因素。这些数据通常是由于吞吐量的要求而通过处理日志和日志聚合来解决。对于像Hadoop一样的日志数据和离线分析系统,但又要求实时处理的限制,这是一个可行的解决方案。Kafka的目的是通过Hadoop的并行加载机制来统一线上和离线的
kafka是什么?
Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者在网站中的所有动作流数据。 这种动作(网页浏览,搜索和其他用户的行动)是在现代网络上的许多社会功能的一个关键因素。 这些数据通常是由于吞吐量的要求而通过处理日志和日志聚合来解决。 对于像Hadoop一样的日志数据和离线分析系统,但又要求实时处理的限制,这是一个可行的解决方案。Kafka的目的是通过Hadoop的并行加载机制来统一线上和离线的消息处理,也是为了通过集群来提供实时的消息。
应用场景
消息系统: Kafka 和传统的消息系统(也称作消息中间件)都具备系统解耦、冗余存储、流量削峰、缓冲、异步通信、扩展性、可恢复性等功能。与此同时,Kafka 还提供了大多数消息系统难以实现的消息顺序性保障及回溯消费的功能。
存储系统: Kafka 把消息持久化到磁盘,相比于其他基于内存存储的系统而言,有效地降低了数据丢失的风险。也正是得益于 Kafka 的消息持久化功能和多副本机制,我们可以把 Kafka 作为长期的数据存储系统来使用,只需要把对应的数据保留策略设置为“永久”或启用主题的日志压缩功能即可。
流式处理平台: Kafka 不仅为每个流行的流式处理框架提供了可靠的数据来源,还提供了一个完整的流式处理类库,比如窗口、连接、变换和聚合等各类操作。
下面看下SpringBoot整合Kafka工具类的详细代码。
pom.xml
            org.apache.commons
            commons-lang3
            3.12.0


            org.apache.kafka
            kafka-clients
            2.6.3


            fastjson
            fastjson
            1.2.83
工具类
package com.bbl.demo.utils;

import org.apache.commons.lang3.exception.ExceptionUtils;
import org.apache.kafka.clients.admin.*;
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.KafkaFuture;
import org.apache.kafka.common.errors.TopicExistsException;
import org.apache.kafka.common.errors.UnknownTopicOrPartitionException;
import com.alibaba.fastjson.JSONObject;

import java.time.Duration;
import java.util.*;
import java.util.concurrent.ExecutionException;


public class KafkaUtils {
    private static AdminClient admin;
    /**
     * 私有静态方法,创建Kafka生产者
     * @author o
     * @return KafkaProducer
     */
    private static KafkaProducer createProducer() {
        Properties props = new Properties();
        //声明kafka的地址
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"node01:9092,node02:9092,node03:9092");
        //0、1 和 all:0表示只要把消息发送出去就返回成功;1表示只要Leader收到消息就返回成功;all表示所有副本都写入数据成功才算成功
        props.put("acks", "all");
        //重试次数
        props.put("retries", Integer.MAX_VALUE);
        //批处理的字节数
        props.put("batch.size", 16384);
        //批处理的延迟时间,当批次数据未满之时等待的时间
        props.put("linger.ms", 1);
        //用来约束KafkaProducer能够使用的内存缓冲的大小的,默认值32MB
        props.put("buffer.memory", 33554432);
        // properties.put("value.serializer",
        // "org.apache.kafka.common.serialization.ByteArraySerializer");
        // properties.put("key.serializer",
        // "org.apache.kafka.common.serialization.ByteArraySerializer");
        props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
        props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
        return new KafkaProducer(props);
    }

    /**
     * 私有静态方法,创建Kafka消费者
     * @author o
     * @return KafkaConsumer
     */
    private static KafkaConsumer createConsumer() {
        Properties props = new Properties();
        //声明kafka的地址
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"node01:9092,node02:9092,node03:9092");
        //每个消费者分配独立的消费者组编号
        props.put("group.id", "111");
        //如果value合法,则自动提交偏移量
        props.put("enable.auto.commit", "true");
        //设置多久一次更新被消费消息的偏移量
        props.put("auto.commit.interval.ms", "1000");
        //设置会话响应的时间,超过这个时间kafka可以选择放弃消费或者消费下一条消息
        props.put("session.timeout.ms", "30000");
        //自动重置offset
        props.put("auto.offset.reset","earliest");
        // properties.put("value.serializer",
        // "org.apache.kafka.common.serialization.ByteArraySerializer");
        // properties.put("key.serializer",
        // "org.apache.kafka.common.serialization.ByteArraySerializer");
        props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
        props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
        return new KafkaConsumer(props);
    }
    /**
     * 私有静态方法,创建Kafka集群管理员对象
     * @author o
     */
    public static void createAdmin(String servers){
        Properties props = new Properties();
        props.put(AdminClientConfig.BOOTSTRAP_SERVERS_CONFIG,servers);
        admin = AdminClient.create(props);
    }

    /**
     * 私有静态方法,创建Kafka集群管理员对象
     * @author o
     * @return AdminClient
     */
    private static void createAdmin(){
        createAdmin("node01:9092,node02:9092,node03:9092");
    }

    /**
     * 传入kafka约定的topic,json格式字符串,发送给kafka集群
     * @author o
     * @param topic
     * @param jsonMessage
     */
    public static void sendMessage(String topic, String jsonMessage) {
        KafkaProducer producer = createProducer();
        producer.send(new ProducerRecord(topic, jsonMessage));
        producer.close();
    }

    /**
     * 传入kafka约定的topic消费数据,用于测试,数据最终会输出到控制台上
     * @author o
     * @param topic
     */
    public static void consume(String topic) {
        KafkaConsumer consumer = createConsumer();
        consumer.subscribe(Arrays.asList(topic));
        while (true) {
            ConsumerRecords records = consumer.poll(Duration.ofSeconds(100));
            for (ConsumerRecord record : records){
                System.out.printf("offset = %d, key = %s, value = %s",record.offset(), record.key(), record.value());
                System.out.println();
            }
        }
    }
    /**
     * 传入kafka约定的topic数组,消费数据
     * @author o
     * @param topics
     */
    public static void consume(String ... topics) {
        KafkaConsumer consumer = createConsumer();
        consumer.subscribe(Arrays.asList(topics));
        while (true) {
            ConsumerRecords records = consumer.poll(Duration.ofSeconds(100));
            for (ConsumerRecord record : records){
                System.out.printf("offset = %d, key = %s, value = %s",record.offset(), record.key(), record.value());
                System.out.println();
            }
        }
    }
    /**
     * 传入kafka约定的topic,json格式字符串数组,发送给kafka集群
     * 用于批量发送消息,性能较高。
     * @author o
     * @param topic
     * @param jsonMessages
     * @throws InterruptedException
     */
    public static void sendMessage(String topic, String... jsonMessages) throws InterruptedException {
        KafkaProducer producer = createProducer();
        for (String jsonMessage : jsonMessages) {
            producer.send(new ProducerRecord(topic, jsonMessage));
        }
        producer.close();
    }

    /**
     * 传入kafka约定的topic,Map集合,内部转为json发送给kafka集群

     * 用于批量发送消息,性能较高。
     * @author o
     * @param topic
     * @param mapMessageToJSONForArray
     */
    public static void sendMessage(String topic, List> mapMessageToJSONForArray) {
        KafkaProducer producer = createProducer();
        for (Map mapMessageToJSON : mapMessageToJSONForArray) {
            String array = JSONObject.toJSON(mapMessageToJSON).toString();
            producer.send(new ProducerRecord(topic, array));
        }
        producer.close();
    }

    /**
     * 传入kafka约定的topic,Map,内部转为json发送给kafka集群
     * @author o
     * @param topic
     * @param mapMessageToJSON
     */
    public static void sendMessage(String topic, Map mapMessageToJSON) {
        KafkaProducer producer = createProducer();
        String array = JSONObject.toJSON(mapMessageToJSON).toString();
        producer.send(new ProducerRecord(topic, array));
        producer.close();
    }

    /**
     * 创建主题
     * @author o
     * @param name 主题的名称
     * @param numPartitions 主题的分区数
     * @param replicationFactor 主题的每个分区的副本因子
     */
    public static void createTopic(String name,int numPartitions,int replicationFactor){
        if(admin == null) {
            createAdmin();
        }
        Map configs = new HashMap<>();
        CreateTopicsResult result = admin.createTopics(Arrays.asList(new NewTopic(name, numPartitions, (short) replicationFactor).configs(configs)));
        //以下内容用于判断创建主题的结果
        for (Map.Entry> entry : result.values().entrySet()) {
            try {
                entry.getValue().get();
                System.out.println("topic "+entry.getKey()+" created");
            } catch (InterruptedException | ExecutionException e) {
                if (ExceptionUtils.getRootCause(e) instanceof TopicExistsException) {
                    System.out.println("topic "+entry.getKey()+" existed");
                }
            }
        }
    }

    /**
     * 删除主题
     * @author o
     * @param names 主题的名称
     */
    public static void deleteTopic(String name,String ... names){
        if(admin == null) {
            createAdmin();
        }
        Map configs = new HashMap<>();
        Collection topics = Arrays.asList(names);
        topics.add(name);
        DeleteTopicsResult result = admin.deleteTopics(topics);
        //以下内容用于判断删除主题的结果
        for (Map.Entry> entry : result.values().entrySet()) {
            try {
                entry.getValue().get();
                System.out.println("topic "+entry.getKey()+" deleted");
            } catch (InterruptedException | ExecutionException e) {
                if (ExceptionUtils.getRootCause(e) instanceof UnknownTopicOrPartitionException) {
                    System.out.println("topic "+entry.getKey()+" not exist");
                }
            }
        }
    }
    /**
     * 查看主题详情
     * @author o
     * @param names 主题的名称
     */
    public static void describeTopic(String name,String ... names){
        if(admin == null) {
            createAdmin();
        }
        Map configs = new HashMap<>();
        Collection topics = Arrays.asList(names);
        topics.add(name);
        DescribeTopicsResult result = admin.describeTopics(topics);
        //以下内容用于显示主题详情的结果
        for (Map.Entry> entry : result.values().entrySet()) {
            try {
                entry.getValue().get();
                System.out.println("topic "+entry.getKey()+" describe");
                System.out.println("\t name: "+entry.getValue().get().name());
                System.out.println("\t partitions: ");
                entry.getValue().get().partitions().stream().forEach(p-> {
                    System.out.println("\t\t index: "+p.partition());
                    System.out.println("\t\t\t leader: "+p.leader());
                    System.out.println("\t\t\t replicas: "+p.replicas());
                    System.out.println("\t\t\t isr: "+p.isr());
                });
                System.out.println("\t internal: "+entry.getValue().get().isInternal());
            } catch (InterruptedException | ExecutionException e) {
                if (ExceptionUtils.getRootCause(e) instanceof UnknownTopicOrPartitionException) {
                    System.out.println("topic "+entry.getKey()+" not exist");
                }
            }
        }
    }

    /**
     * 查看主题列表
     * @author o
     * @return Set TopicList
     */
    public static Set listTopic(){
        if(admin == null) {
            createAdmin();
        }
        ListTopicsResult result = admin.listTopics();
        try {
            result.names().get().stream().map(x->x+"\t").forEach(System.out::print);
            return result.names().get();
        } catch (InterruptedException | ExecutionException e) {
            e.printStackTrace();
            return null;
        }
    }

    public static void main(String[] args) {
        System.out.println(listTopic());
    }
} 
Kafka是一个高吞吐量分布式发布-订阅消息系统,用于实时数据流处理;Python通过kafka-python等第三方库实现消息生产与消费,支持微服务通信、日志聚合和实时处理等场景。
SpringBoot整合Kafka实现消息发布的步骤包括:1.添加Maven或Gradle依赖;2.配置Kafka生产者参数;3.编写服务类使用KafkaTemplate发送消息;4.创建Controller暴露接口;5.注意Kafka服务状态、Topic管理及序列化一致性等问题。具体操作上,首先在pom.xml或build.gradle中引入spring-kafka依赖,然后配置bootstrap-servers、key和value的序列化方式,接着创建KafkaProducerService注入Kaf
Kafka是流数据处理的首选消息队列,1.因为其高吞吐量与低延迟,能应对每秒数百万条消息;2.具备分布式、持久化的提交日志设计,支持数据回溯与多消费者独立消费;3.分区机制实现横向扩展,适应大规模数据;4.提供可靠的数据存储层,增强系统容错性与灵活性。PySpark在流数据处理中扮演“大脑”角色,StructuredStreaming相较于SparkStreaming具有优势:1.采用持续增长无限表模型,简化编程逻辑;2.统一批处理与流处理API,降低学习曲线;3.支持精确一次语义,确保数据一致性;4.内
在RockyLinux上安装ApacheKafka可以按照以下步骤进行操作:更新系统:首先,确保你的RockyLinux系统是最新的,执行以下命令更新系统软件包:sudoyumupdate安装Java:ApacheKafka依赖于Java,因此需要先安装JavaDevelopmentKit(JDK)。可以通过以下命令安装OpenJDK:sudoyuminstalljava-1.8.0-openjdk-devel下载和解压:访问ApacheKafka官方网站()下载最新的二进制包。选择一个稳定版本并下载压缩
Kafka是一种高效的分布式消息队列系统,广泛应用于大规模数据处理和流式计算。然而,消息丢失问题是Kafka使用过程中一个严重的隐患,因为它可能导致数据的不连续性和计算结果的准确性下降,从而影响系统的整体功能和运行效率。本文将从多个角度探讨Kafka消息丢失的原因,并简要介绍相应的解决方案和优化策略。硬件故障是导致Kafka消息丢失的常见原因之一。Kafka集群由多个节点组成,每个节点都有自己的硬件设备,如CPU、内存和磁盘。当某个节点发生硬件故障,如电源故障或硬盘损坏,存储在该节点上的

ApacheKafka是一个开源的、分布式的流处理平台,也是一种分布式消息系统,可以实现高吞吐量、可靠的数据传输和处理。在网络应用开发中,很多场景都需要使用消息队列来进行异步处理,而Kafka就是消息队列中的一种,由于其高性能、高可靠性、可扩展性等特点,越来越被广泛应用于各种领域。在PHP中使用Kafka,需要通过PHP扩展库librdkafka进行操作。
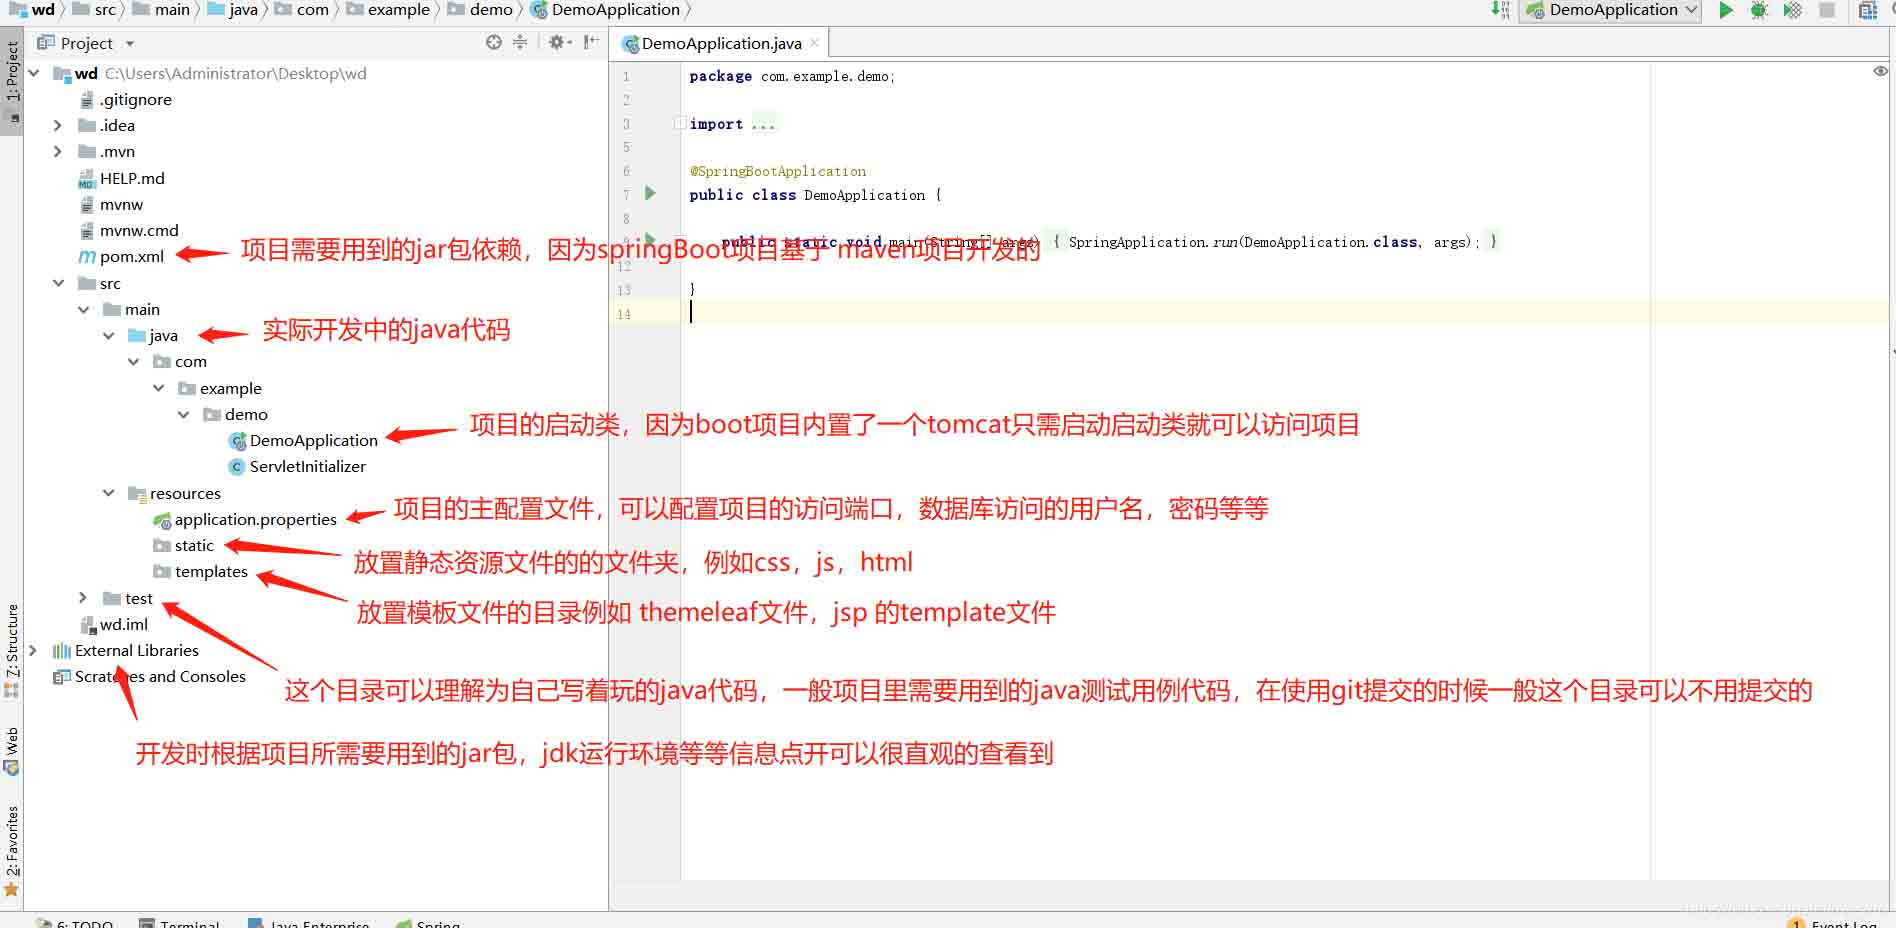
springBoot项目常用目录springBoot项目的目录结构及名规范介绍基于SpringBoot开发时的目录结构及命名规范,通过介绍能够为你解决,在实际项目中如何规划目录结构?如何命名目录更规范?各个目录分别代表什么含义?等三个问题。目录说明servicex//项目名|-admin-ui//管理服务前端代码(一般将UI和SERVICE放到一个工程中,便于管理)|-servicex-auth//模块1|-servicex-common//模块2|-servicex-gateway//模块3|-serv
在当今工业领域中,数据采集和实时分析已经成为了企业竞争力的重要组成部分。而PHP和Kafka是两个非常常见的实现实时工业数据采集和分析的技术。本文将介绍如何使用PHP和Kafka实现实时工业数据采集和分析。一、Kafka基础Kafka是一种分布式流式处理平台,它可以将实时数据流进行高效的持久化和分发,同时也支持高容错性。Kafka存储和处理流数据时,采用
随着游戏市场的蓬勃发展,游戏数据分析逐渐成为了游戏开发者和运营者必不可少的环节。实时游戏数据分析的重要性在于能够帮助开发者和运营者在第一时间内了解游戏的表现和玩家行为,及时发现问题并采取有效的解决方案。为了实现实时游戏数据分析,我们可以使用PHP和Kafka这两个工具。PHP作为一种流行的后端编程语言,具备很高的灵活性和可扩展性,实现起来也很简单。而Kafk
PHP是一种流行的编程语言,常用于服务器端开发和Web应用程序开发。Kafka是一种分布式消息系统,可用于管理大规模的消息传递。本文将介绍如何使用PHP和Kafka进行消息传递。首先,我们需要安装一些必要的工具和库。在Linux上,我们可以使用以下命令:sudoapt-getinstallphp-zmqlibrdkafka-dev如果您使用的是Win





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



