

通用视觉GPT时刻来临?智源推出通用分割模型SegGPT
ChatGPT引发了语言大模型狂潮,AI另一个重大领域——视觉——的GPT时刻何时到来?前两天,机器之心介绍了Meta最新研究成果SegmentAnythingModel(SAM)。该研究引起了AI社区广泛讨论。而据我们所知,几乎同一时间,智源研究院视觉团队也推出通用分割模型SegGPT(SegmentEverythingInContext)——利用视觉提示(prompt)完成任意分割任务的通用视觉模型。论文地址:https://arxiv.org/abs/2304.
ChatGPT 引发了语言大模型狂潮,AI 另一个重大领域 —— 视觉 —— 的 GPT 时刻何时到来?
前两天,机器之心介绍了 Meta 最新研究成果 Segment Anything Model (SAM)。该研究引起了AI社区广泛讨论。
而据我们所知,几乎同一时间,智源研究院视觉团队也推出通用分割模型 SegGPT(Segment Everything In Context)—— 利用视觉提示(prompt)完成任意分割任务的通用视觉模型。
- 论文地址:https://arxiv.org/abs/2304.03284
- 代码地址:https://github.com/baaivision/Painter
- Demo:https://huggingface.co/spaces/BAAI/SegGPT
SegGPT 与 Meta AI 图像分割基础模型 SAM 同时发布,两者的差异在于 :
- SegGPT “一通百通”:给出一个或几个示例图像和意图掩码,模型就能 get 用户意图,“有样学样” 地完成类似分割任务。用户在画面上标注识别一类物体,即可批量化识别分割同类物体,无论是在当前画面还是其他画面或视频环境中。
- SAM “一触即通”:通过一个点或边界框,在待预测图片上给出交互提示,识别分割画面上的指定物体。
无论是 “一触即通” 还是 “一通百通”,都意味着视觉模型已经 “理解” 了图像结构。SAM 精细标注能力与 SegGPT 的通用分割标注能力相结合,能把任意图像从像素阵列解析为视觉结构单元,像生物视觉那样理解任意场景,通用视觉 GPT 曙光乍现。
SegGPT 是智源通用视觉模型 Painter(CVPR 2023)的衍生模型,针对分割一切物体的目标做出优化。SegGPT 训练完成后无需微调,只需提供示例即可自动推理并完成对应分割任务,包括图像和视频中的实例、类别、零部件、轮廓、文本、人脸等等。
该模型具有以下优势能力:
1. 通用能力:SegGPT 具有上下文推理能力,模型能够根据提供的分割示例(prompt),对预测进行自适应的调整,实现对 “everything” 的分割,包括实例、类别、零部件、轮廓、文本、人脸、医学图像、遥感图像等。
2. 灵活推理能力:支持任意数量的 prompt;支持针对特定场景的 tuned prompt;可以用不同颜色的 mask 表示不同目标,实现并行分割推理。
3. 自动视频分割和追踪能力:以第一帧图像和对应的物体掩码作为上下文示例,SegGPT 能够自动对后续视频帧进行分割,并且可以用掩码的颜色作为物体的 ID,实现自动追踪。
案例展示
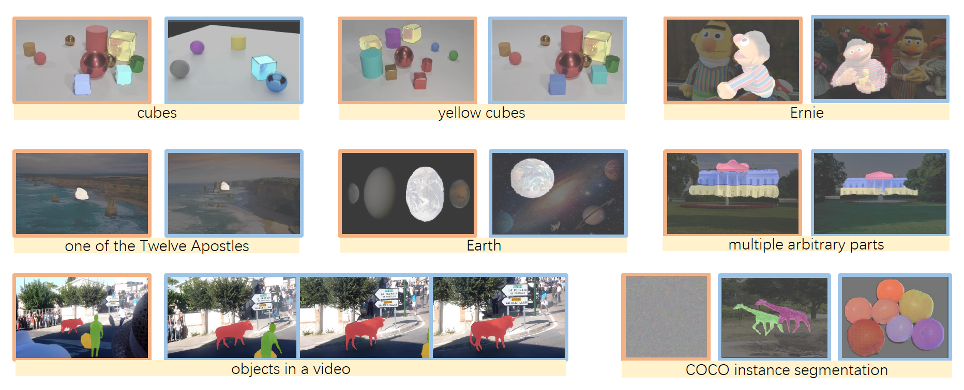
1. 作者在广泛的任务上对 SegGPT 进行了评估,包括少样本语义分割、视频对象分割、语义分割和全景分割。下图中具体展示了 SegGPT 在实例、类别、零部件、轮廓、文本和任意形状物体上的分割结果。
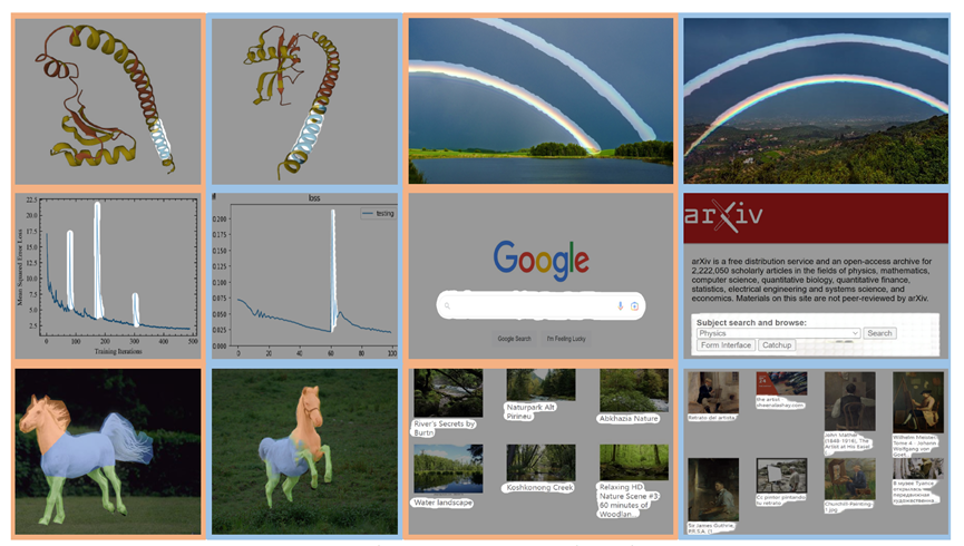
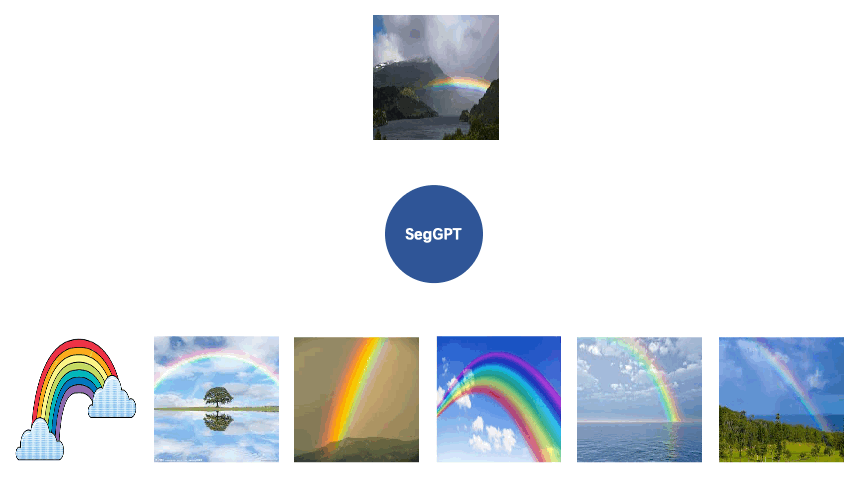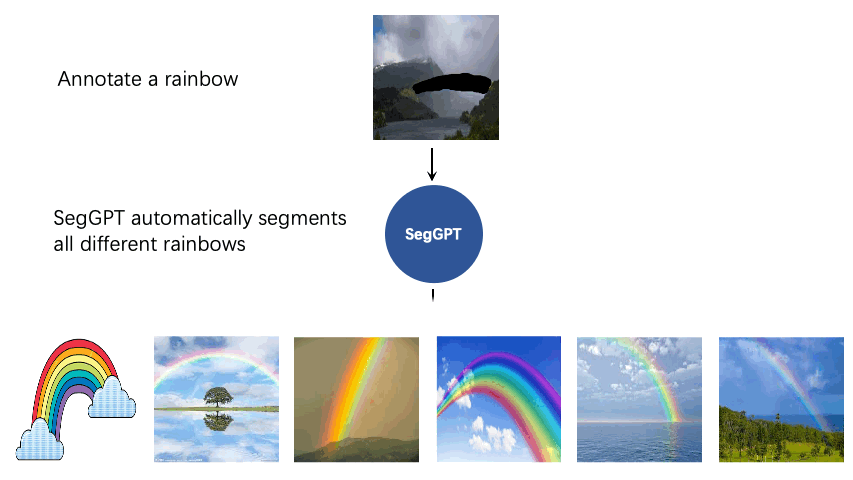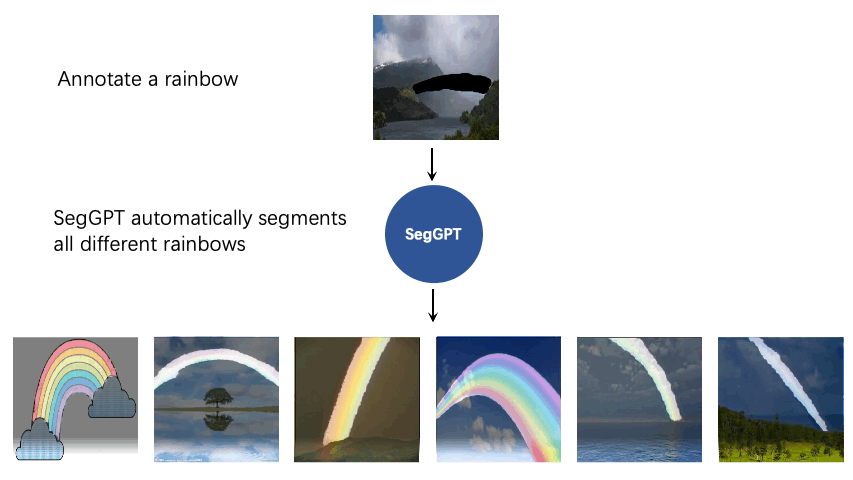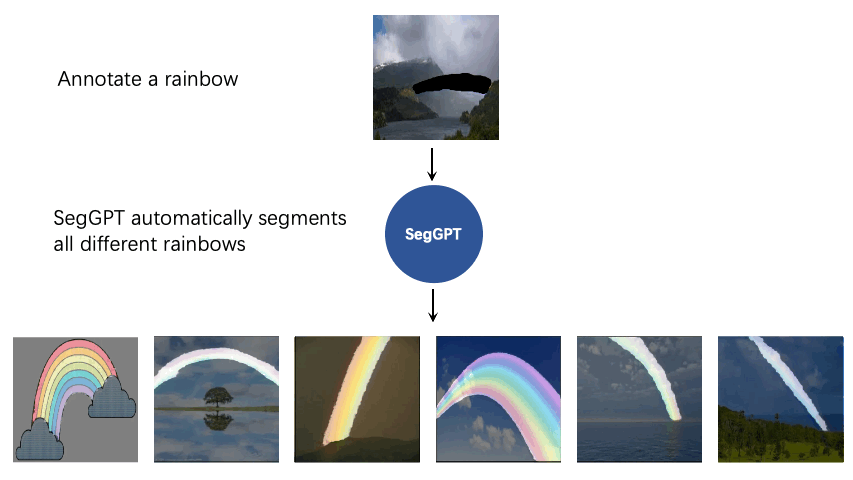
2. 标注出一个画面中的彩虹(上图),可批量化分割其他画面中的彩虹(下图)
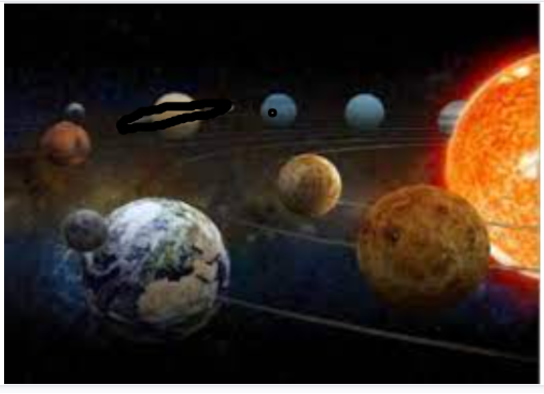
3. 用画笔大致圈出行星环带(上图),在预测图中准确输出目标图像中的行星环带(下图)。
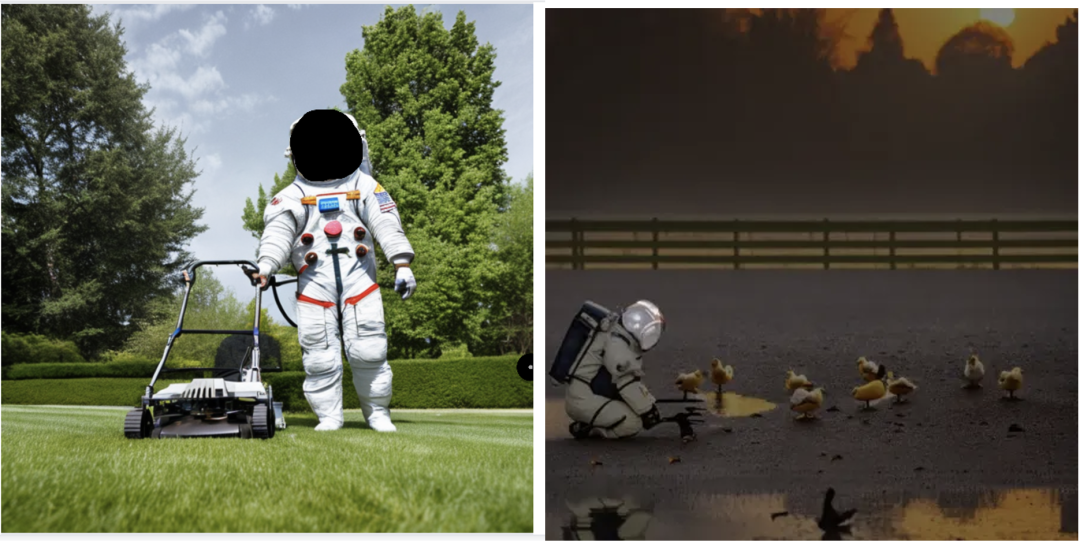
4. SegGPT 能够根据用户提供的宇航员头盔掩码这一上下文(左图),在新的图片中预测出对应的宇航员头盔区域(右图)。
训练方法
SegGPT 将不同的分割任务统一到一个通用的上下文学习框架中,通过将各类分割数据转换为相同格式的图像来统一各式各样的数据形式。
具体来说,SegGPT 的训练被定义为一个上下文着色问题,对于每个数据样本都有随机的颜色映射。目标是根据上下文完成各种任务,而不是依赖于特定的颜色。训练后,SegGPT 可以通过上下文推理在图像或视频中执行任意分割任务,例如实例、类别、零部件、轮廓、文本等。
Test-time techniques
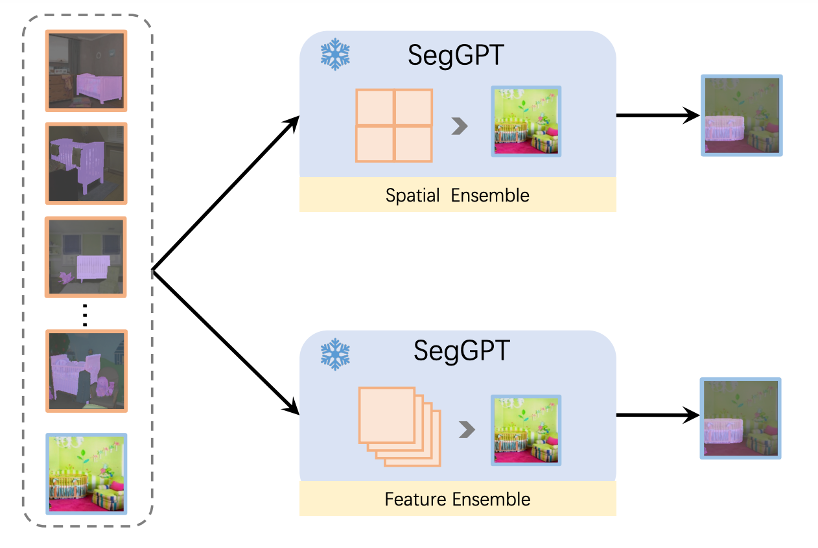
如何通过 test-time techniques 解锁各种能力是通用模型的一大亮点。SegGPT 论文中提出了多个技术来解锁和增强各类分割能力,比如下图所示的不同的 context ensemble 方法。所提出的 Feature Ensemble 方法可以支持任意数量的 prompt 示例,实现丰俭由人的推理效果。
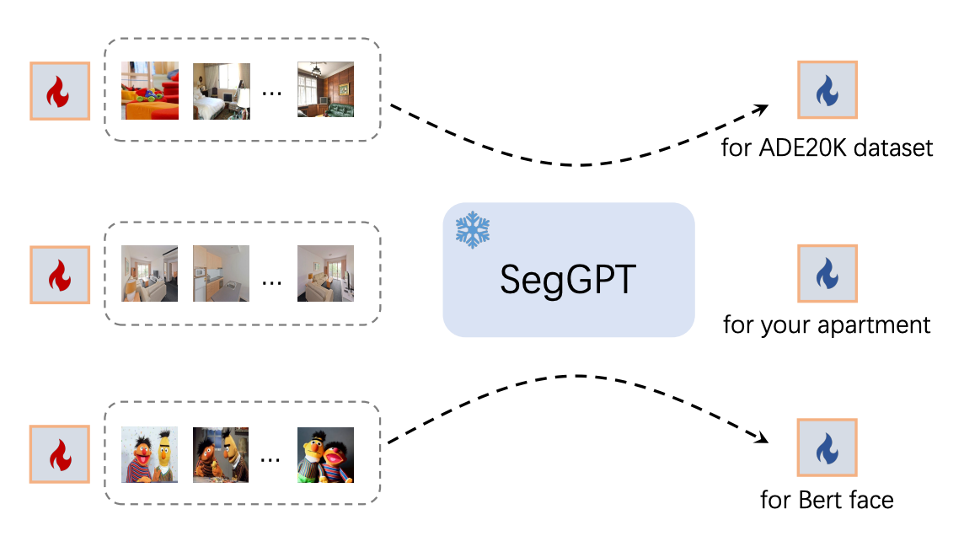
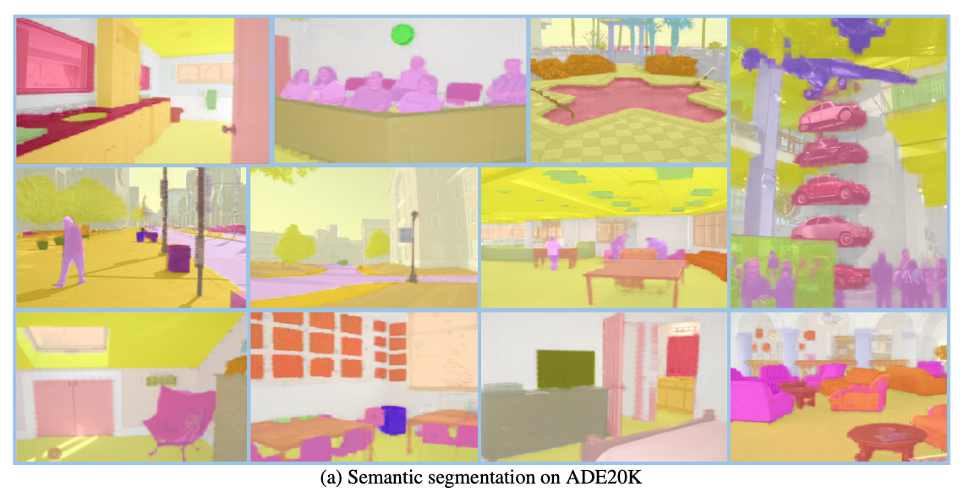
此外,SegGPT 还支持对特定场景优化专用 prompt 提示。对于针对性的使用场景,SegGPT 可以通过 prompt tuning 得到对应 prompt,无需更新模型参数来适用于特定场景。比如,针对某一数据集自动构建一个对应的 prompt,或者针对一个房间来构建专用 prompt。如下图所示:
结果展示
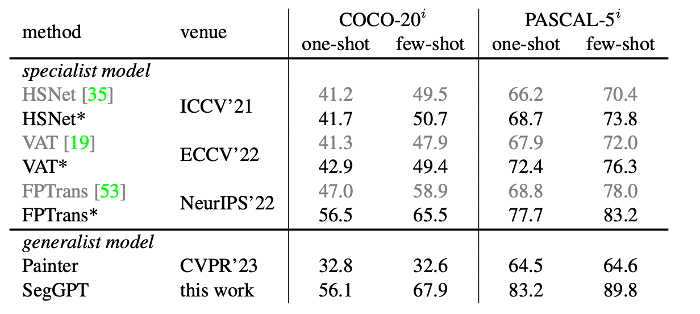
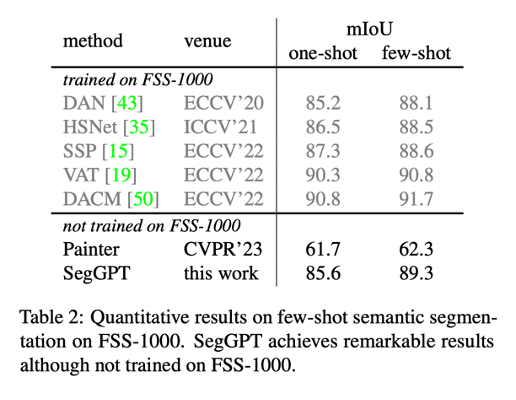
模型只需少数 prompt 示例,在 COCO 和 PASCAL 数据集上取得最优性能。SegGPT 显示出强大的零样本场景迁移能力,比如在少样本语义分割测试集 FSS-1000 上,在无需训练的情况下取得 state-of-the-art 性能。
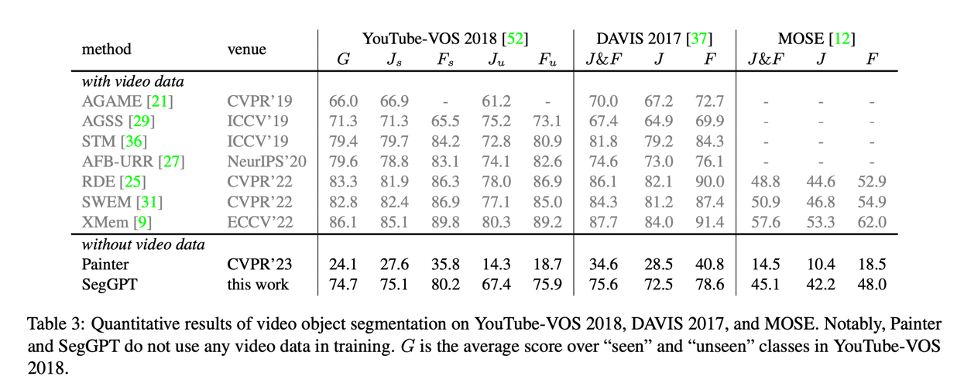
无需视频训练数据,SegGPT 可直接进行视频物体分割,并取得和针对视频物体分割专门优化的模型相当的性能。
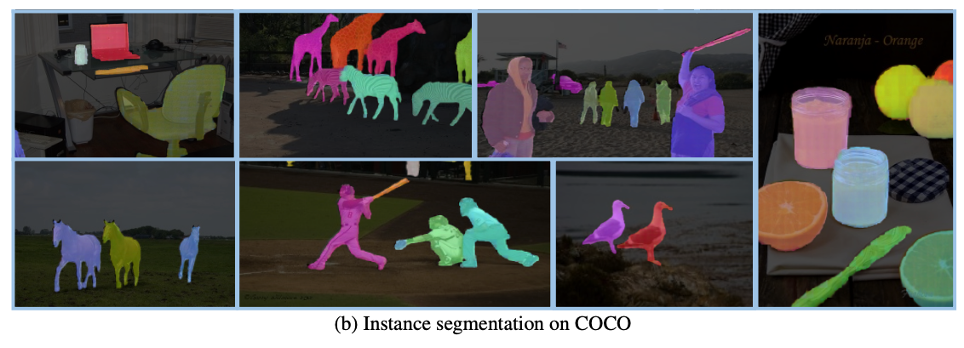
以下是基于 tuned prompt 在语义分割和实例分割任务上的效果展示:
想给硬盘换个分区表格式,但又不想重装系统、丢失数据?这事儿其实挺常见的。无论是为了用上超过2TB的大容量硬盘,还是想切换到更现代的UEFI启动模式,将MBR无损转换为GPT都是一个关键操作。好消息是,现在有好几种成熟的方法可以帮你安全实现这个目标,下面就来详细聊聊。 一、使用 MBR2GPT 工具(


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
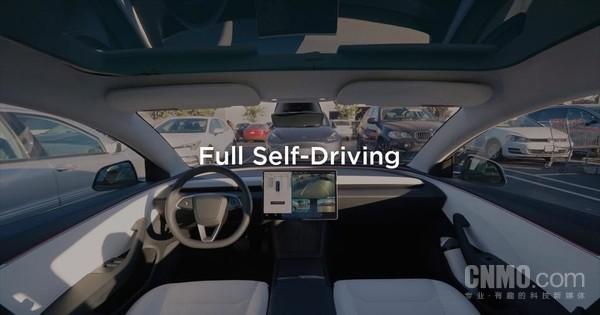
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
编辑|萝卜皮OpenAI的GPT和MetaAI的Llama等大型语言模型(LLM)因其在化学信息学领域的潜力而日益受到认可,特别是在理解简化分子输入行输入系统(SMILES)方面。这些LLM还能够将SMILES字符串解码为矢量表示。加拿大温莎大学(UniversityofWindsor)的研究人员比较了GPT和Llama与SMILES上的预训练模型在下游任务中嵌入SMILES字符串的性能,重点关注两个关键应用:分子特性预测和药物-药物相互作用预测。该研究以「Canlargelanguagemodelsun
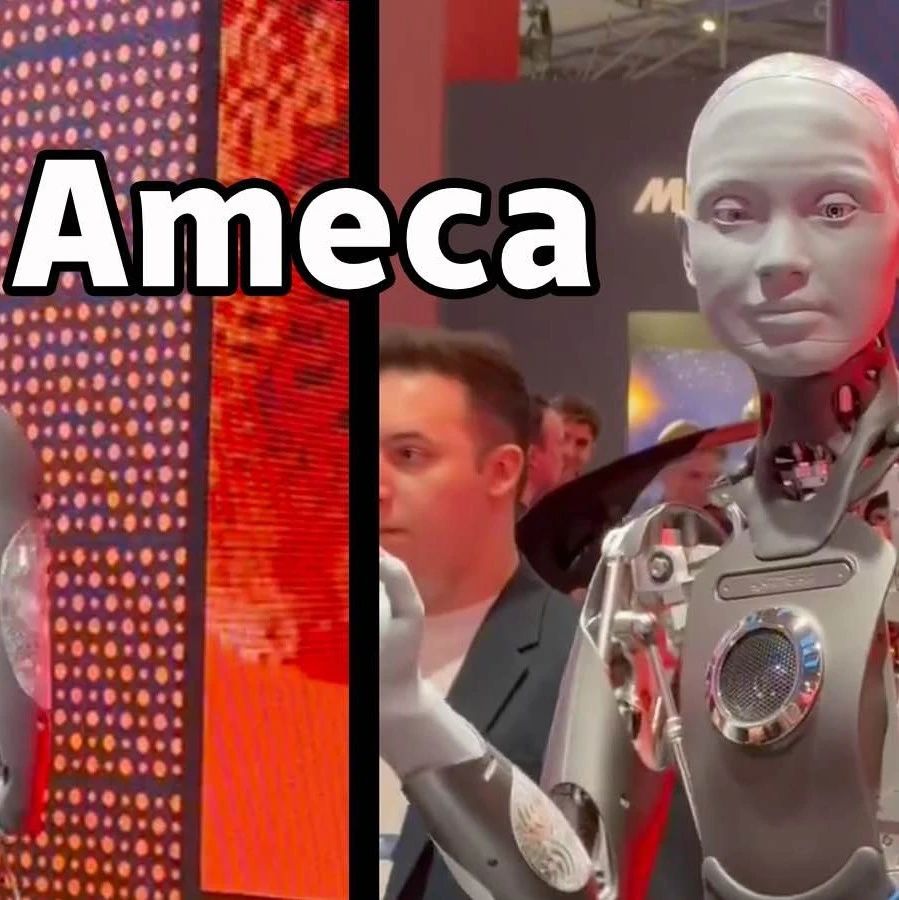
编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



