

本科生60行代码教你手搓GPT大模型,技术介绍堪比教程
当前,大型语言模型(LLM)被认为是人工智能突破的方向。人们正在尝试用它们做各种复杂的事情,比如问答、创作、数学推理以及编写代码等。近段时间ChatGPT持续的爆火是最好的例证。然而,对于机器学习从业者来说,大模型的门槛很高:因为体量太大难以训练,很长时间里这个方向一直被大公司垄断。不过最近,简化GPT模型的方法越来越多了。1月中旬,前特斯拉AI高级总监AndrejKarpathy(现已回归OpenAI)就发布了从零开始构建GPT模型的完整教程。不过训练出的GPT和
当前,大型语言模型(LLM)被认为是人工智能突破的方向。人们正在尝试用它们做各种复杂的事情,比如问答、创作、数学推理以及编写代码等。近段时间 ChatGPT 持续的爆火是最好的例证。
然而,对于机器学习从业者来说,大模型的门槛很高:因为体量太大难以训练,很长时间里这个方向一直被大公司垄断。不过最近,简化 GPT 模型的方法越来越多了。1 月中旬,前特斯拉 AI 高级总监 Andrej Karpathy(现已回归 OpenAI)就发布了从零开始构建 GPT 模型的完整教程。不过训练出的 GPT 和 OpenAI 的 GPT-3 比较,两者规模差距达 1 万 - 100 万倍。
近日,加拿大麦克马斯特大学的一位软件工程本科生 Jay Mody 在导入 NumPy 库下,仅用 60 行代码就从头实现了一个 GPT 模型,并将其命名为 PicoGPT。不仅如此,他还将经过训练的 GPT-2 模型权重加载到自己的实现中,并生成了一些文本。下面为 60 行代码展示。
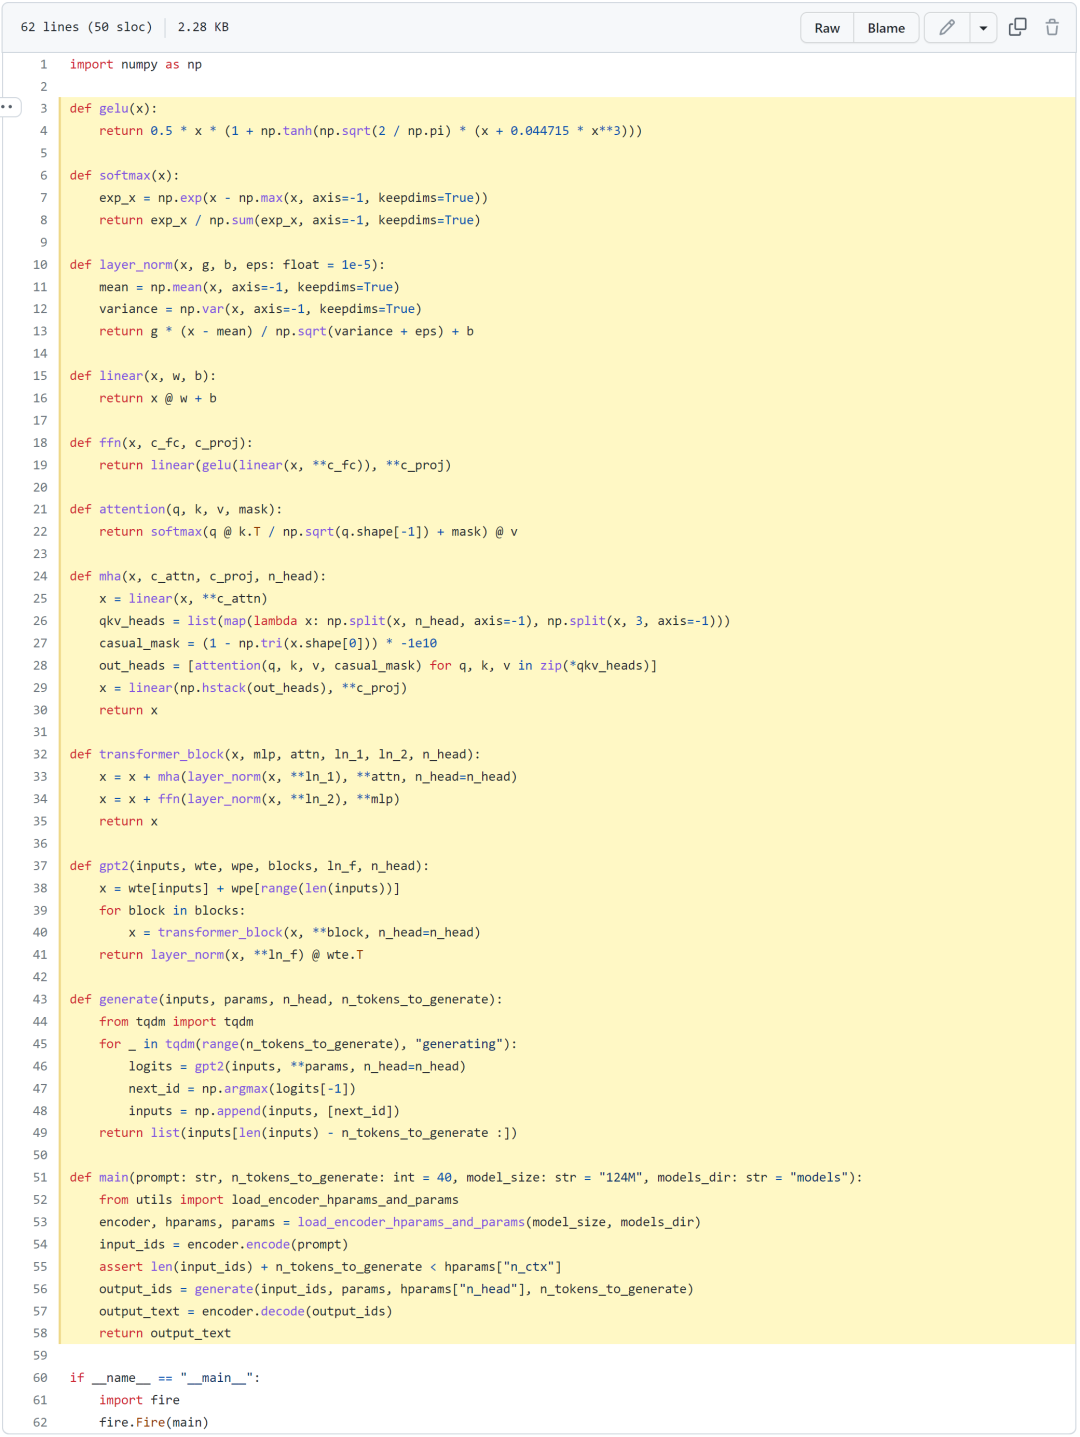
不过要做到这些,你需要熟悉 Python 和 NumPy,还要有一些训练神经网络的基本经验。作者表示,这篇博客旨在对 GPT 进行简单易懂的完整介绍。因此,作者只使用已经训练的模型权重来实现前向传递代码。
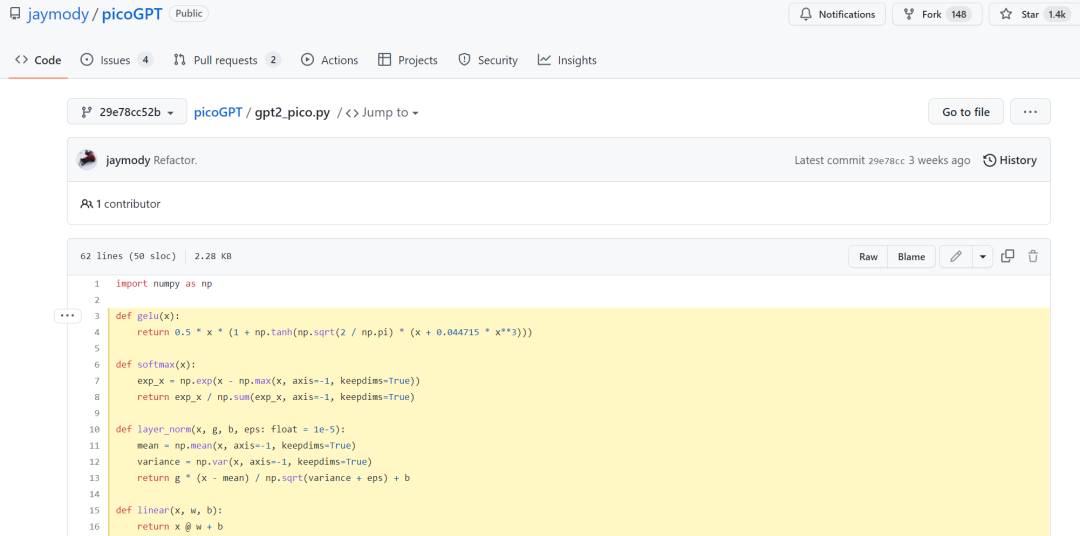
代码地址:
https://github.com/jaymody/picoGPT/blob/29e78cc52b58ed2c1c483ffea2eb46ff6bdec785/gpt2_pico.py#L3-L58
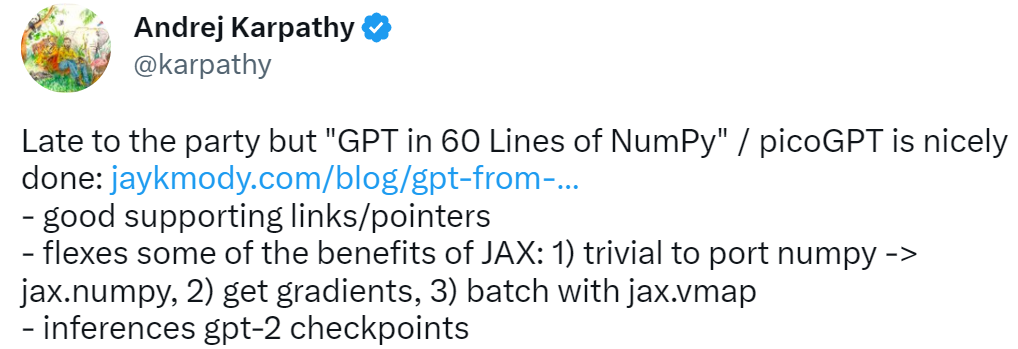
对于此项研究,Andrej Karpathy 给出了四个字:虽迟但到。想当初,Karpathy 构建的 minGPT 和 nanoGPT 还要 300 行代码。
值得一提的是,这篇教程不是完全零门槛的。为了让读者明白,作者首先介绍了什么是 GPT、它的输入、输出如何等其他内容,介绍得都非常详细。
至于 GPT 到底能干什么,作者给出了几个示例,它能写电子邮件、总结一本书、给你 instagram 标题的想法、向 5 岁的孩子解释黑洞、用 SQL 编写代码等。
通过仔细阅读这部分内容后,你能大致了解 GPT 的一些基础知识。有了这些背景介绍,接下来就是如何设置了。
项目介绍
设置
这一章节主要介绍了如何设置编码器、超参数以及参数。
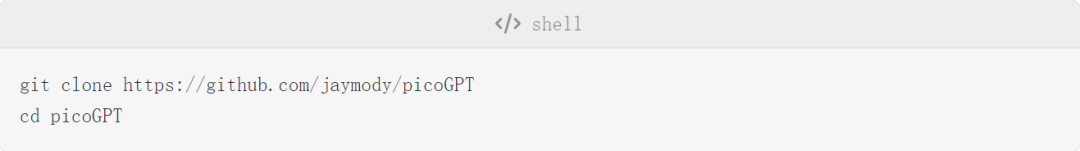
你要做的,首先是克隆代码库:
然后安装依赖项:
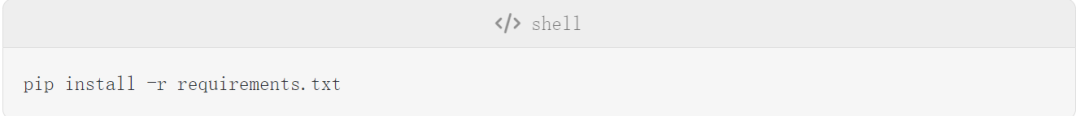
注意,如果你使用的是 M1 Macbook,在运行 pip install 之前,你需要在 requirements.txt 中将 tensorflow 更改为 tensorflow-macos。在这个项目下,文件包括 encoder.py、utils.py、gpt2.py、gpt2_pico.py:
- encoder.py:包含 OpenAI BPE Tokenizer 的代码,直接取自 gpt-2 repo;
- utils.py:包含下载和加载 GPT-2 模型权重、tokenizer 和超参数的代码;
- gpt2.py:包含 GPT 模型和生成代码,可以将其作为 python 脚本运行;
- gpt2_pico.py:与 gpt2.py 相同,但是代码行数更少。
其中 gpt2.py 需要从头开始实现,因此你要做的是先删除 gpt2.py 并重新创建一个空文件:
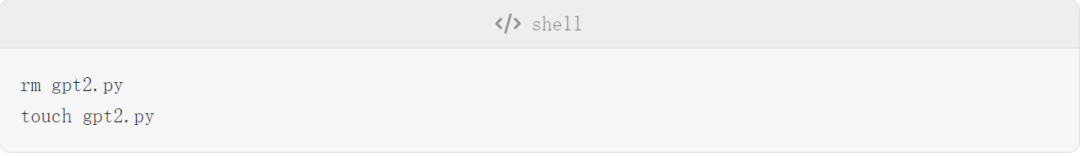
然后将下列代码复制到 gpt2.py 中:
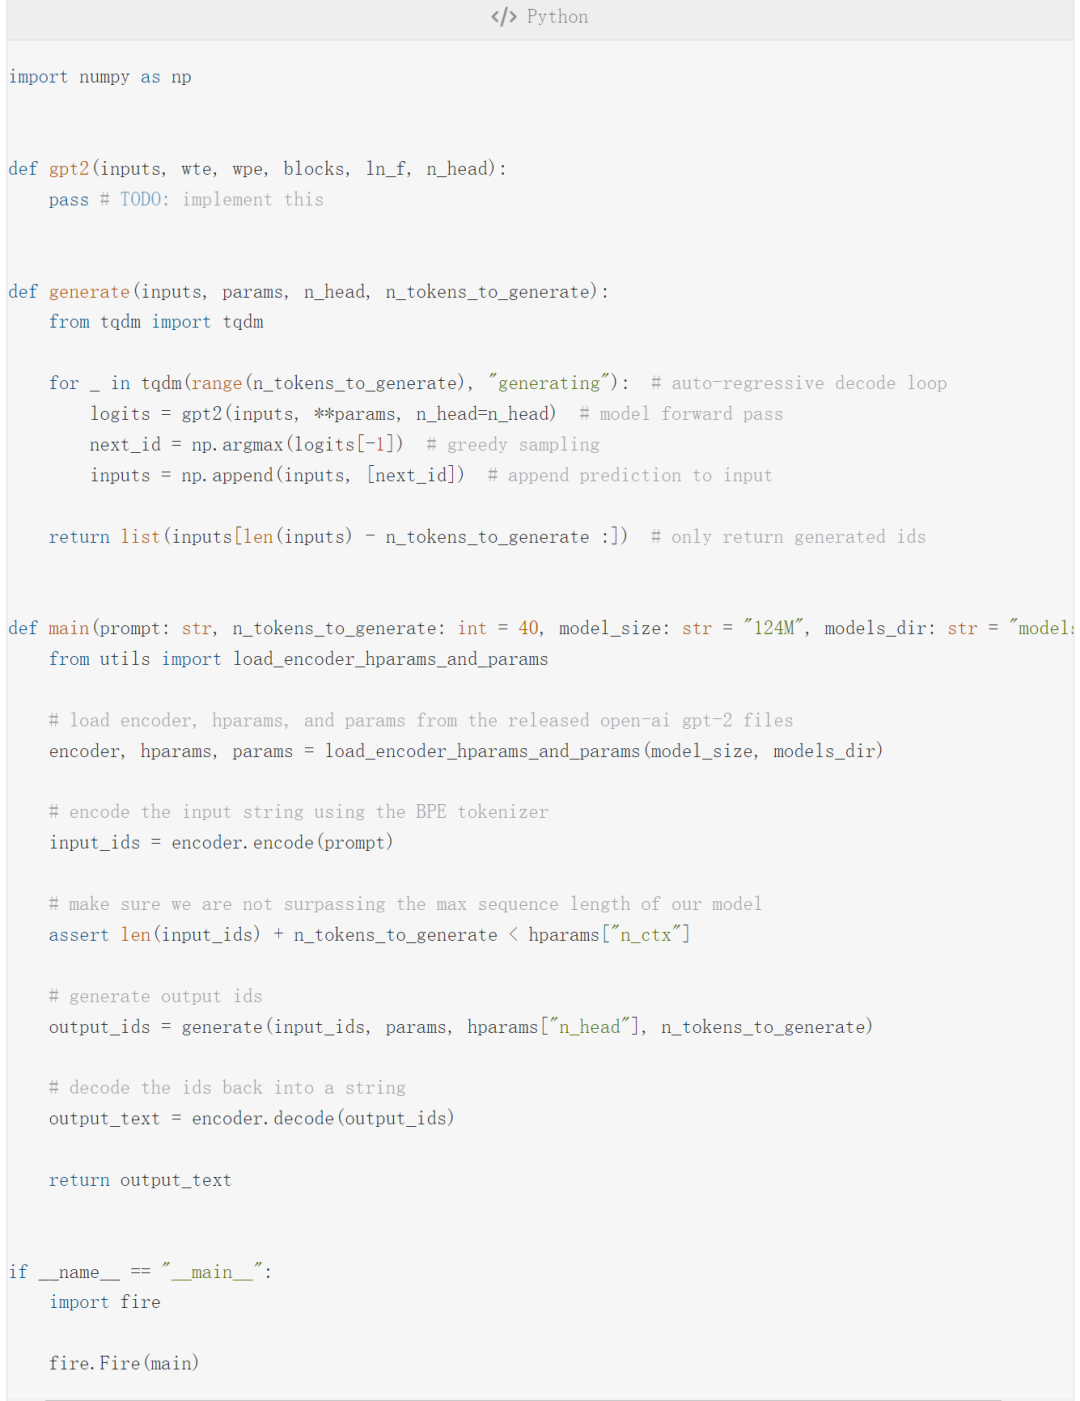
上述代码包含 4 个主要部分:
- gpt2 函数是本次实现 GPT 的实际代码;
- generate 函数实现自回归解码算法;
- main 函数;
- fire.Fire (main) 将文件转换为 CLI 应用程序,以便最终可以运行代码:python gpt2.py "some prompt here"。
main 函数包含有 encode、hparams、params 参数,执行下列代码:
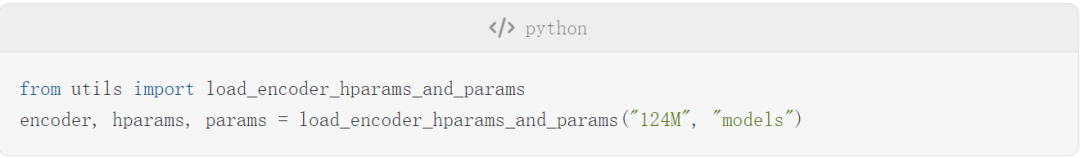
接着必要的模型以及 tokenizer 文件将被下载到 models/124M 文件。
设置完成之后,作者开始介绍编码器、超参数、参数的一些细节内容。就拿编码器来说,本文的编码器和 GPT-2 使用的 BPE tokenizer 一样。下面是该编码器编码和解码的一些文本示例:
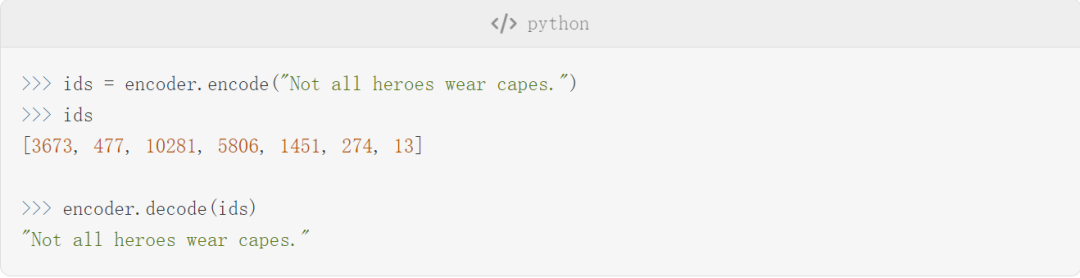
实际的 token 长这个样子:
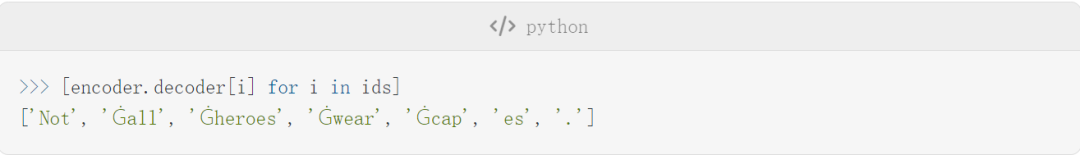
需要注意,有时 token 是单词(例如 Not),有时它们是单词但前面有一个空格(例如 Ġall,Ġ 代表一个空格),有时是单词的一部分(例如 capes 被拆分为 Ġcap 和 es),有时它们是标点符号(例如 .)。
BPE 的一个好处是它可以对任意字符串进行编码,如果遇到词汇表中不存在的内容,它会将其分解为它能理解的子字符串:
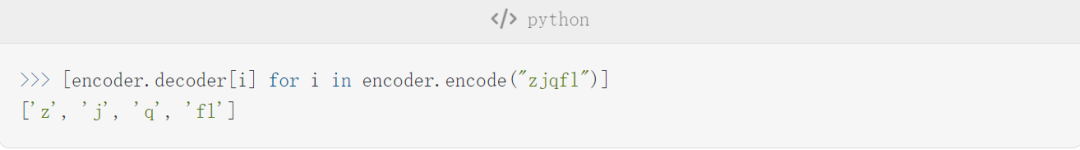
更细节的内容不再赘述。接下来介绍基础神经网络,这一部分就更加基础了,主要包括 GELU、Softmax 函数以及 Layer Normalization 和 Linear。
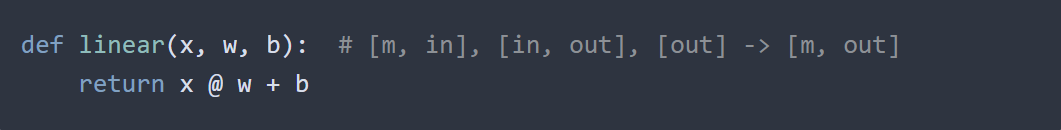
每一小部分都有代码示例,例如在 Linear 部分,作者展示了标准矩阵乘法 + 偏置:
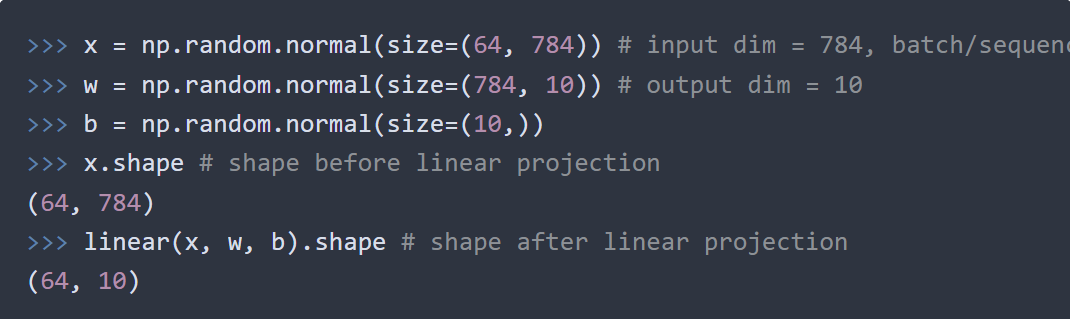
线性层从一个向量空间投影到另一个向量空间的代码如下:
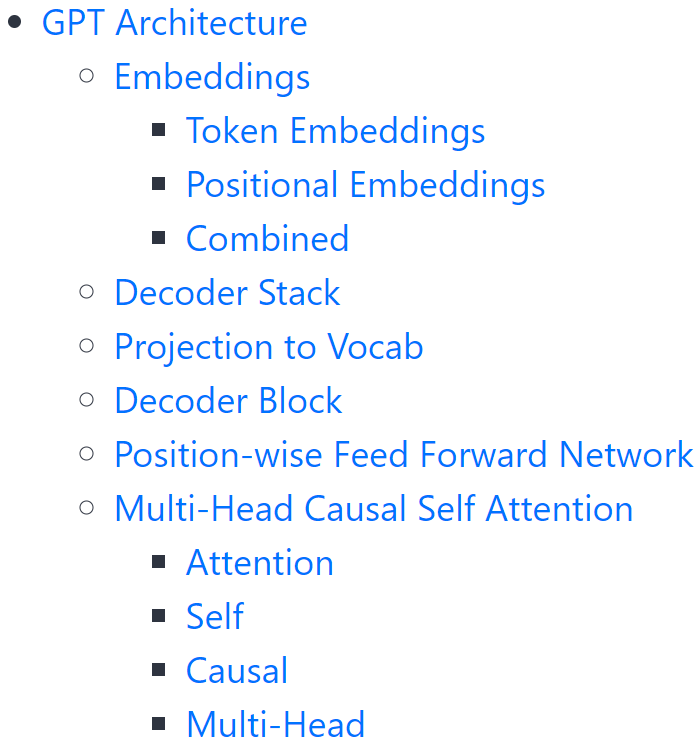
GPT 架构
这部分介绍 GPT 自身架构。
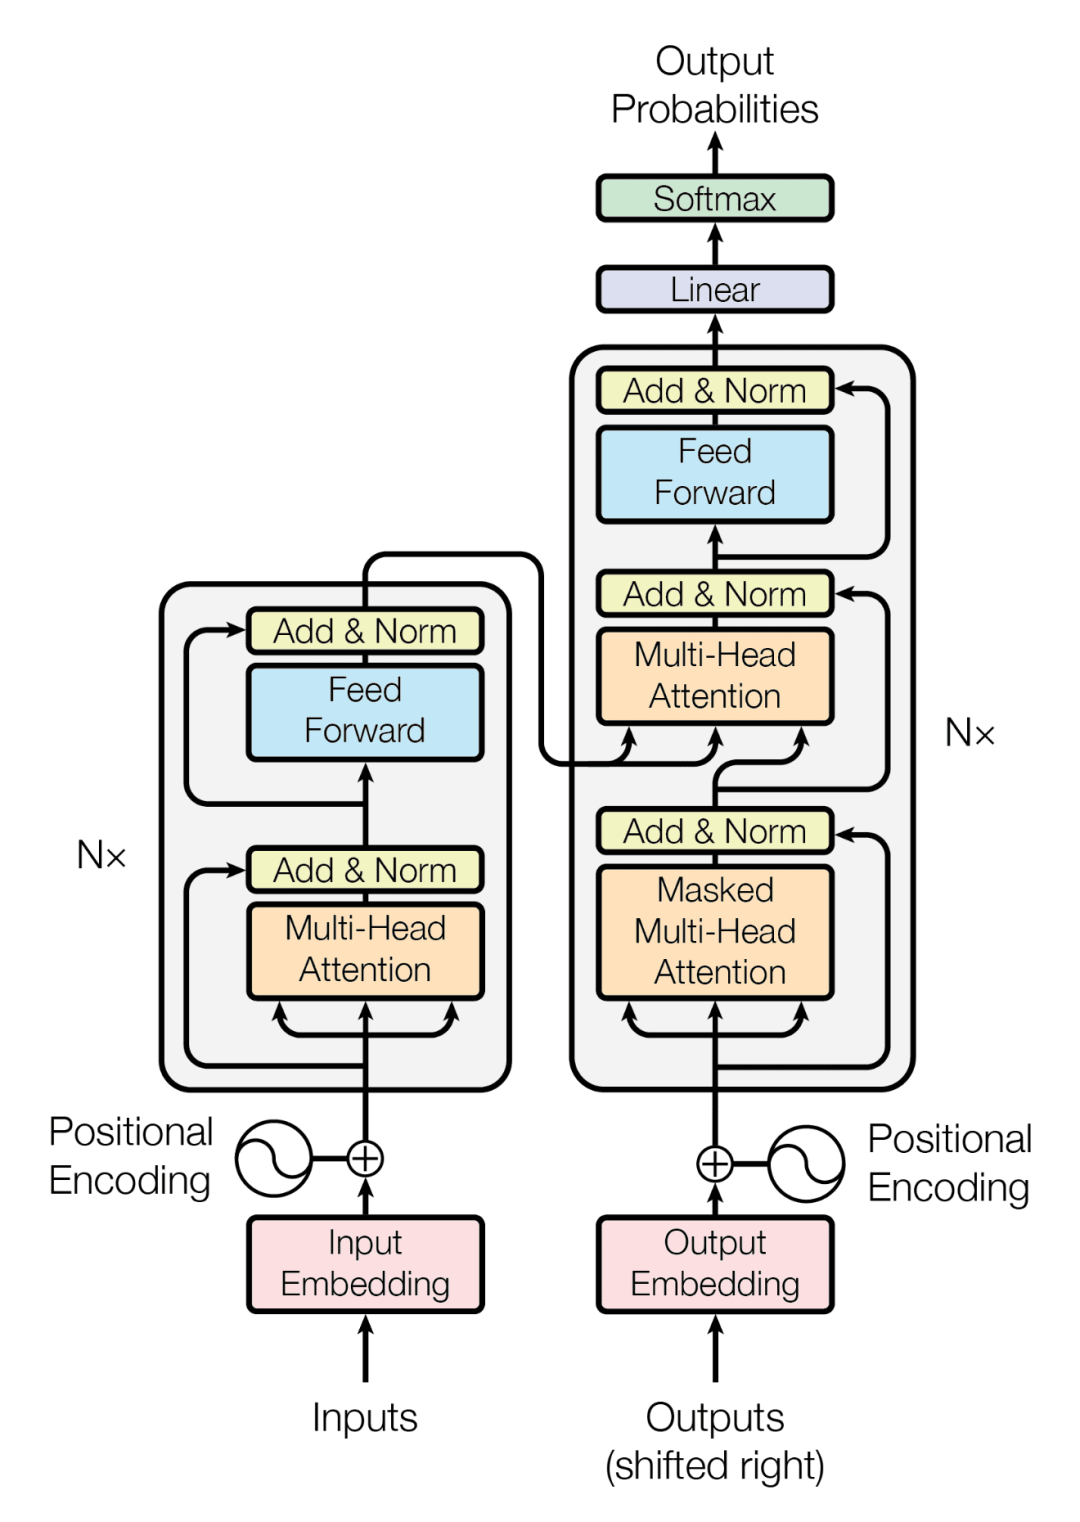
Transformer 架构如下:
Transformer 仅使用解码器堆栈(图的右侧部分):
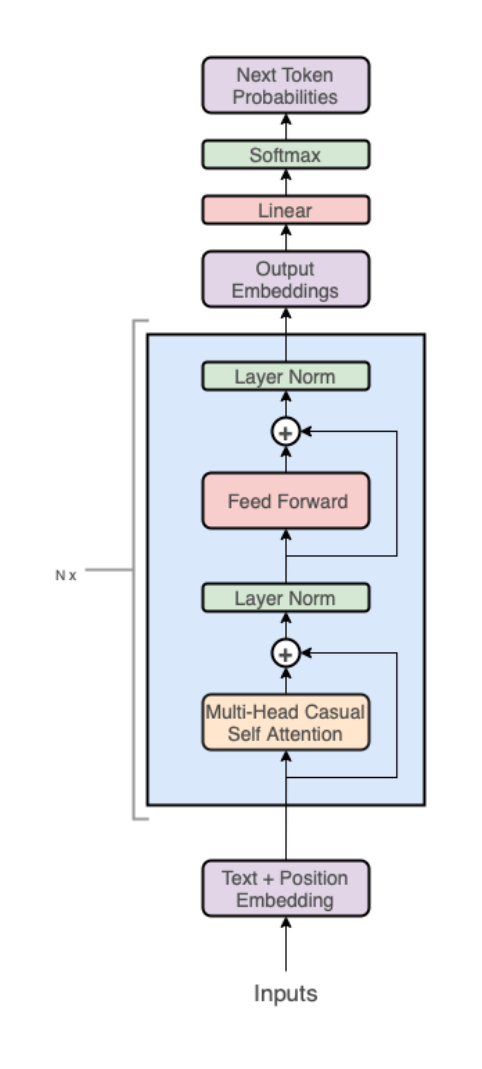
需要注意,由于摆脱了编码器,中间的交叉注意力层也被删除了。
在高层次上,GPT 体系架构有以下三个部分:
- 文本 + 位置嵌入;
- Transformer 解码器堆栈;
- 投影到词汇表。
代码就像下面这样:
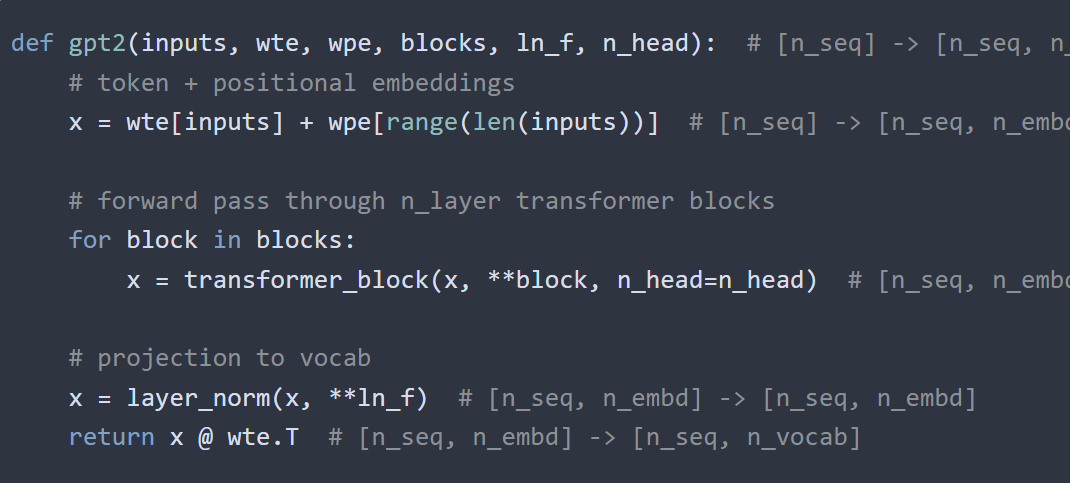
代码部分截图
接下来更详细地分解以上三个部分中的每一个部分,这里也不再赘述。
以上就是作者对 GPT 的实现,接下来就是将它们组合在一起并运行代码,得到 gpt2.py。它的全部内容只有 120 行代码(如果删除注释和空格,则为 60 行)。
作者通过以下方式测试结果:
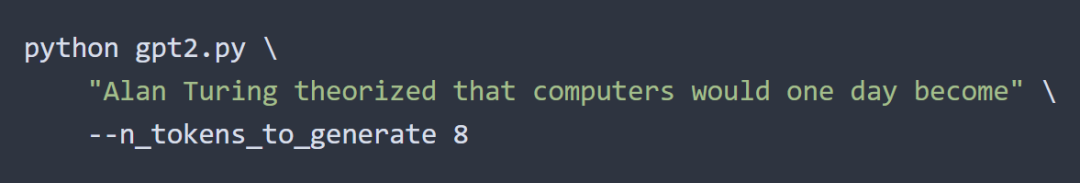
输出结果如下:
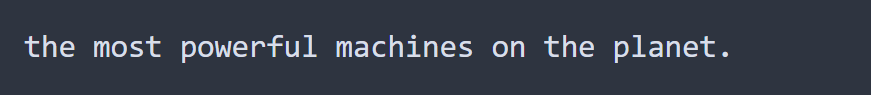
正如作者说的:这次实验成功了。
本文只是跟着作者的思路大概介绍了整体流程,想要了解更多内容的小伙伴,可以参考原文链接。
原文链接:https://jaykmody.com/blog/gpt-from-scratch/#basic-layers
想给硬盘换个分区表格式,但又不想重装系统、丢失数据?这事儿其实挺常见的。无论是为了用上超过2TB的大容量硬盘,还是想切换到更现代的UEFI启动模式,将MBR无损转换为GPT都是一个关键操作。好消息是,现在有好几种成熟的方法可以帮你安全实现这个目标,下面就来详细聊聊。 一、使用 MBR2GPT 工具(


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
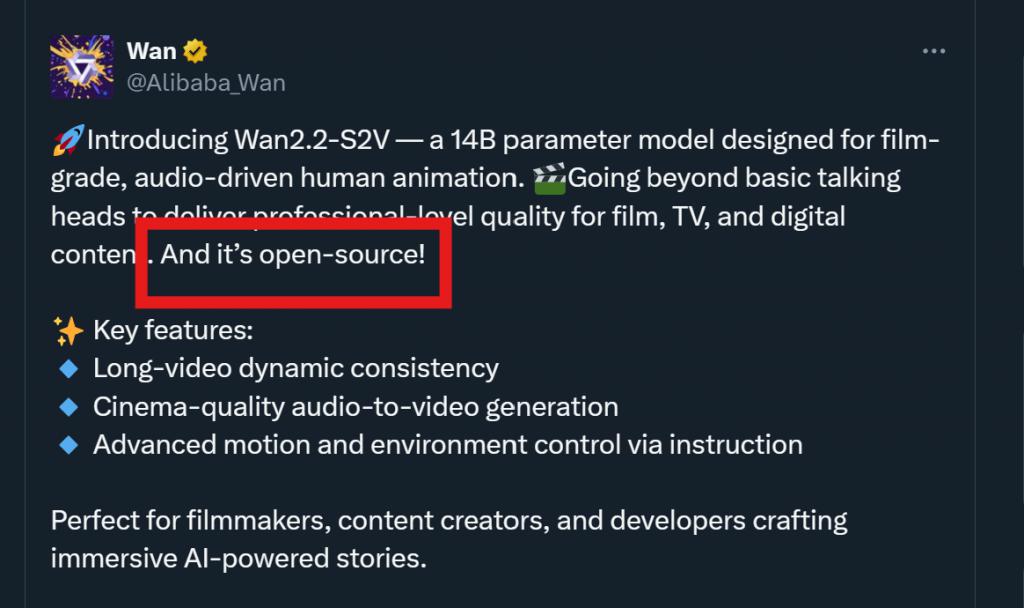
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
编辑|萝卜皮OpenAI的GPT和MetaAI的Llama等大型语言模型(LLM)因其在化学信息学领域的潜力而日益受到认可,特别是在理解简化分子输入行输入系统(SMILES)方面。这些LLM还能够将SMILES字符串解码为矢量表示。加拿大温莎大学(UniversityofWindsor)的研究人员比较了GPT和Llama与SMILES上的预训练模型在下游任务中嵌入SMILES字符串的性能,重点关注两个关键应用:分子特性预测和药物-药物相互作用预测。该研究以「Canlargelanguagemodelsun
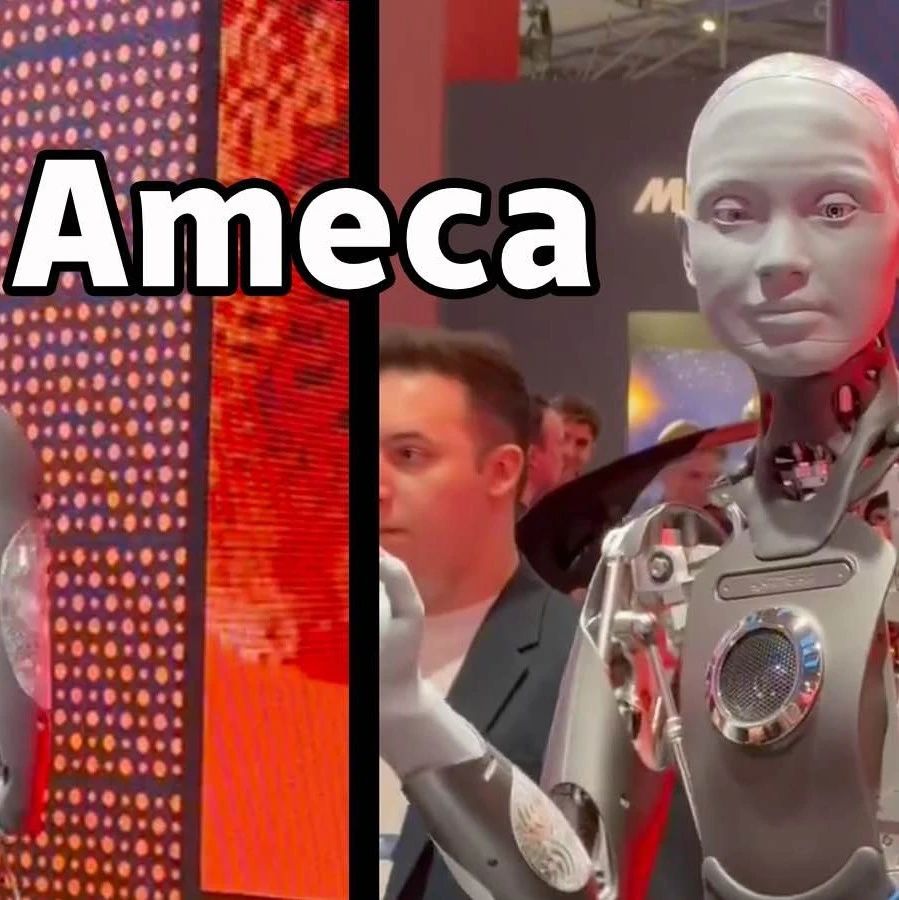
编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



