

蒸馏也能Step-by-Step:新方法让小模型也能媲美2000倍体量大模型
大型语言模型能力惊人,但在部署过程中往往由于规模而消耗巨大的成本。华盛顿大学联合谷歌云计算人工智能研究院、谷歌研究院针对该问题进行了进一步解决,提出了逐步蒸馏(DistillingStep-by-Step)范式帮助模型训练。该方法在训练用于特定任务的小型模型方面优于LLM,训练数据远少于传统的微调和蒸馏。他们的770MT5模型在一个基准任务上表现优于540BPaLM模型。令人印象深刻的是,他们的模型只使用了可用数据的80%。虽然大型语言模型(LLMs)展现了令人印象深刻的少样本学习能力,但将这样大规模的模
大型语言模型能力惊人,但在部署过程中往往由于规模而消耗巨大的成本。华盛顿大学联合谷歌云计算人工智能研究院、谷歌研究院针对该问题进行了进一步解决,提出了逐步蒸馏(Distilling Step-by-Step)范式帮助模型训练。该方法在训练用于特定任务的小型模型方面优于 LLM,训练数据远少于传统的微调和蒸馏。他们的 770M T5 模型在一个基准任务上表现优于 540B PaLM 模型。令人印象深刻的是,他们的模型只使用了可用数据的 80%。
虽然大型语言模型(LLMs)展现了令人印象深刻的少样本学习能力,但将这样大规模的模型部署在现实应用中是很难的。为 1750 亿参数规模的 LLM 提供服务的专门基础设施,至少需要 350GB 的 GPU 内存。更甚者,现今最先进的 LLM 是由超过 5000 亿的参数组成的,这意味着它需要更多的内存和计算资源。这样的计算要求对于大多数生产商来说都是难以企及的,更何况是要求低延迟的应用了。
为了解决大型模型的这个问题,部署者往往采用小一些的特定模型来替代。这些小一点的模型用常见范式 —— 微调或是蒸馏来进行训练。微调使用下游的人类注释数据升级一个预训练过的小模型。蒸馏用较大的 LLM 产生的标签训练同样较小的模型。但是很遗憾,这些范式在缩小模型规模的同时也付出了代价:为了达到与 LLM 相当的性能,微调需要昂贵的人类标签,而蒸馏需要大量很难获得的无标签数据。
在一篇题为「Distilling Step-by-Step! Outperforming Larger Language Models with Less Training Data and Smaller Model Sizes」的论文中,来自华盛顿大学、谷歌的研究者引入了一种新的简单机制 —— 逐步蒸馏(Distilling step-bystep),用于使用更少的训练数据来训练更小的模型。这种机制减少了微调和蒸馏 LLM 所需的训练数据量,使之有更小的模型规模。
论文链接:https://arxiv.org/pdf/2305.02301v1.pdf
该机制的核心是换一种角度,将 LLM 看作是可以推理的 agent,而不是噪声标签的来源。LLM 可以产生自然语言的理由(rationale),这些理由可以用来解释和支持模型所预测的标签。例如,当被问及「一位先生携带着打高尔夫球的设备,他可能有什么?(a) 球杆,(b) 礼堂,(c) 冥想中心,(d) 会议,(e) 教堂」,LLM 可以通过思维链(CoT)推理回答出「(a)球杆」,并通过说明「答案一定是用来打高尔夫球的东西」来合理化这个标签。在上述选择中,只有球杆是用来打高尔夫的。研究者使用这些理由作为额外更丰富的信息在多任务训练设置中训练较小的模型,并进行标签预测和理由预测。
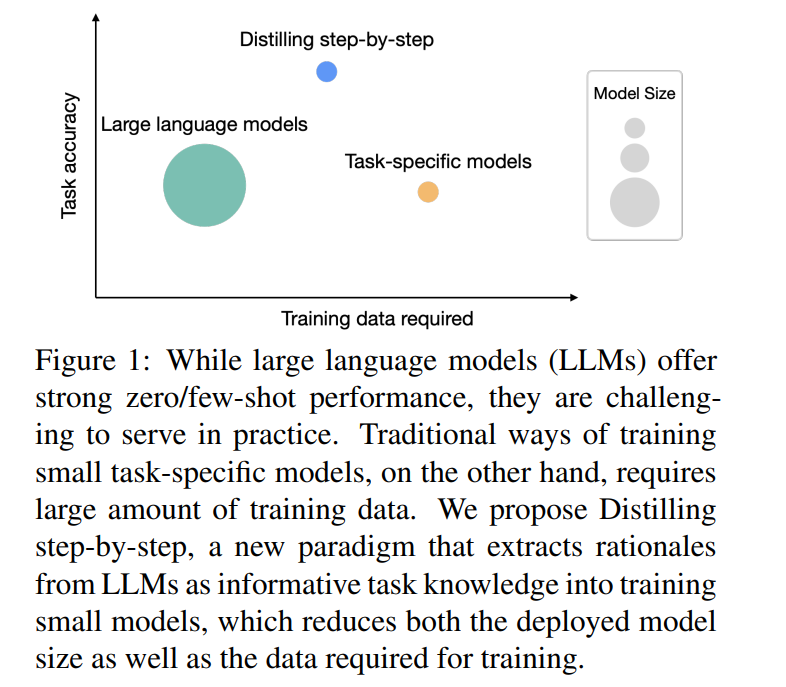
如图 1 所示,逐步蒸馏可以学习特定任务的小模型,这些模型的参数量还不到 LLM 的 1/500。与传统的微调或蒸馏相比,逐步蒸馏使用的训练示例要也少得多。
实验结果显示,在 4 个 NLP 基准中,有三个有希望的实验结论。
- 第一,相对于微调和蒸馏,逐步蒸馏模型在各数据集上实现了更好的性能,平均减少了 50% 以上的训练实例(最多可减少 85% 以上)。
- 第二,我们的模型在模型尺寸更小的情况下表现优于 LLM(最多可以小到 2000 倍),极大地降低了模型部署所需的计算成本。
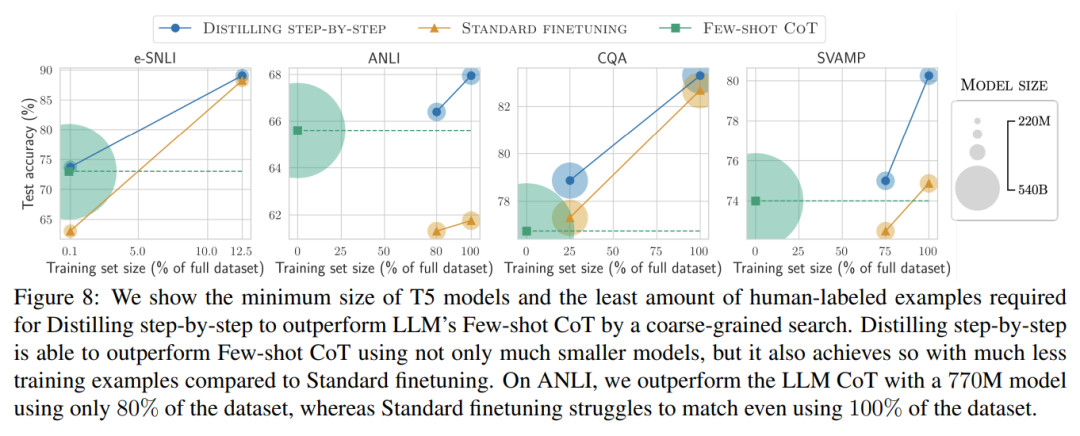
- 第三,该研究在缩减模型尺寸的同时,也减少了超越 LLM 所需要的数据量。研究者使用一个 770M 的 T5 模型超越了 540B 参数的 LLM 的性能。这个较小的模型只使用了现有微调方法 80% 的标记数据集。
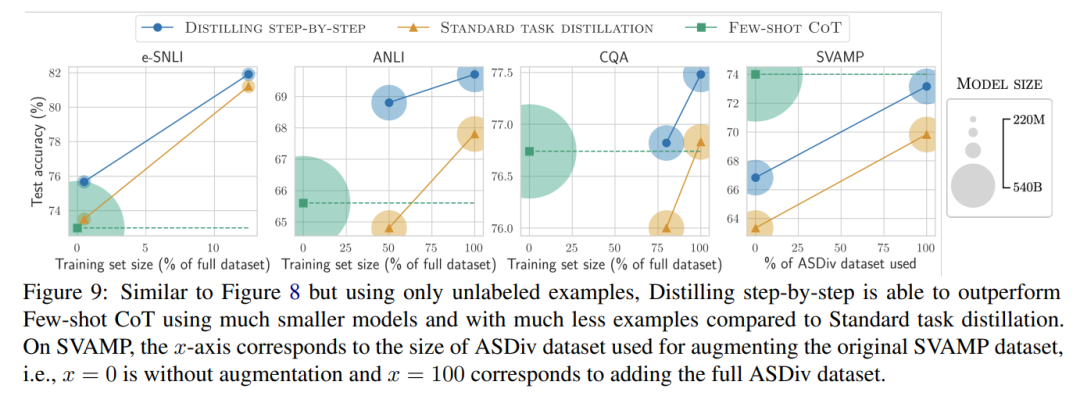
当只有未标记的数据时,小模型的表现相比 LLM 而言仍然有过之而无不及 —— 只用一个 11B 的 T5 模型就超过了 540B 的 PaLM 的性能。
该研究进一步表明,当一个较小的模型表现比 LLM 差时,与标准的蒸馏方法相比,逐步蒸馏可以更有效地利用额外的无标签数据来使较小的模型媲美 LLM 的性能。
逐步蒸馏
研究者提出了逐步蒸馏这个新范式,是利用 LLM 对其预测的推理能力,以数据高效率的方式训练更小的模型。整体框架如图 2 所示。
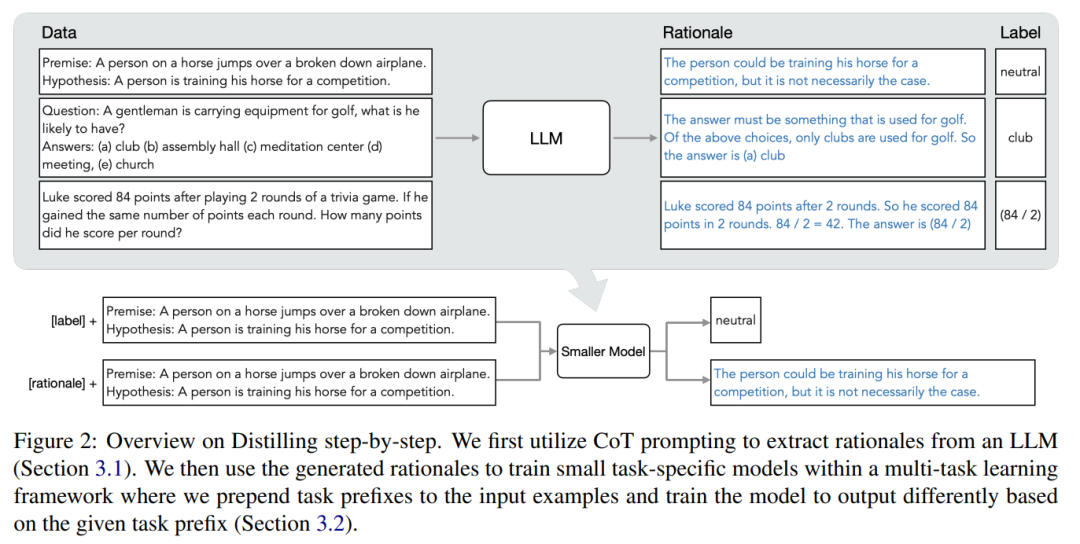
该范式有两个简单的步骤:首先,给定一个 LLM 和一个无标签的数据集,提示 LLM 生成输出标签以及证明该标签成立的理由。理由用自然语言解释,为模型预测的标签提供支持(见图 2)。理由是当前自监督 LLM 的一个涌现的行为属性。
然后,除了任务标签之外,利用这些理由来训练更小的下游模型。说白了,理由能提供了更丰富、更详细的信息,来说明一个输入为什么被映射到一个特定的输出标签。
实验结果
研究者在实验中验证了逐步蒸馏的有效性。首先,与标准的微调和任务蒸馏方法相比,逐步蒸馏有助于实现更好的性能,训练实例的数量少得多,大幅提高了学习小型特定任务模型的数据效率。
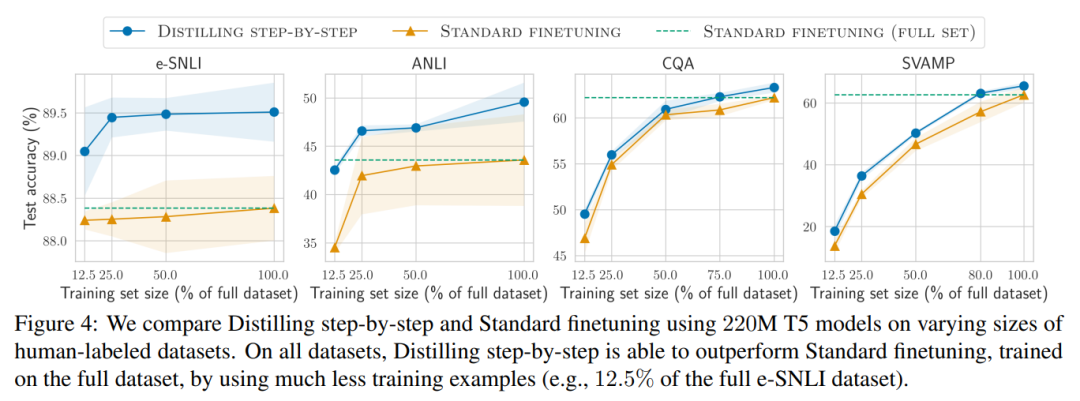
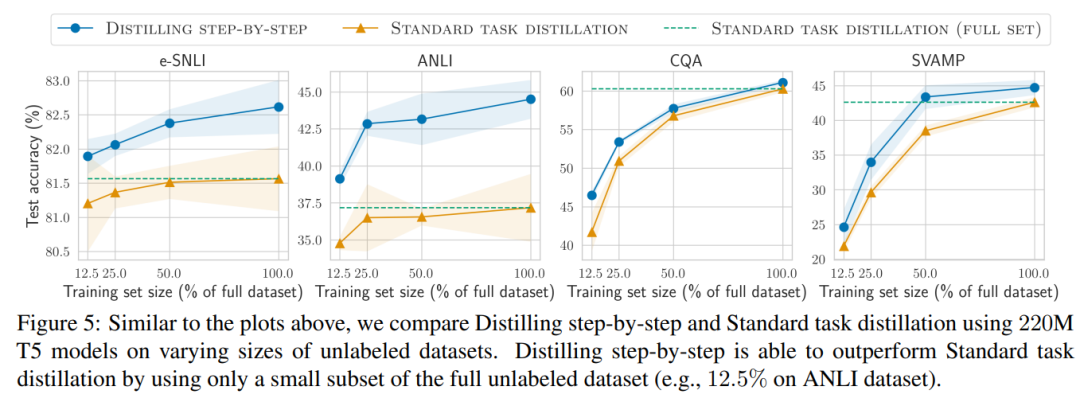
其次,研究表明,逐步蒸馏方法以更小的模型大小超越了 LLM 的性能,与 llm 相比,大大降低了部署成本。
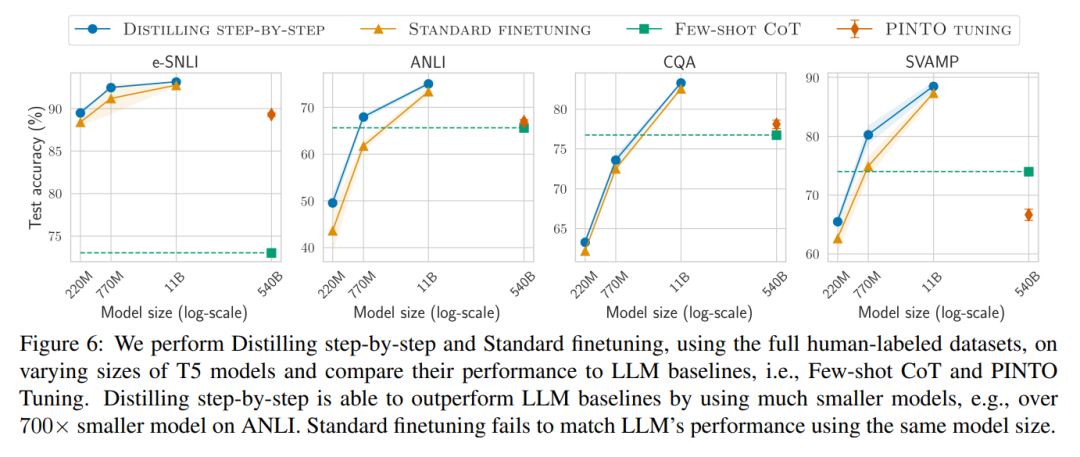
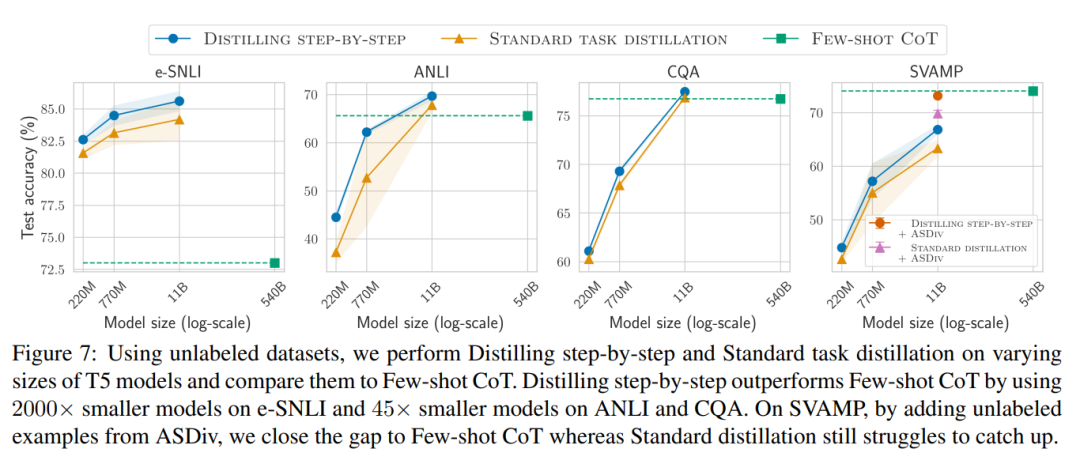
最后,研究者调查了逐步蒸馏方法在超过 LLM 的性能方面所需的最低资源,包括训练示例数量和模型大小。他们展示了逐步蒸馏方法通过使用更少的数据和更小的模型,同时提高了数据效率和部署效率。
在开始之前,先确认硬件已经就位:关机,把新硬盘装上,再重新开机。开机后第一件事,就是检查系统是否识别到了新设备。用 dmesg | grep ad2 看一眼,如果输出类似 ad2: 9765MB [19841/16/63] at ata1-master UDMA33 这样的信息,说明新硬盘已经被成功
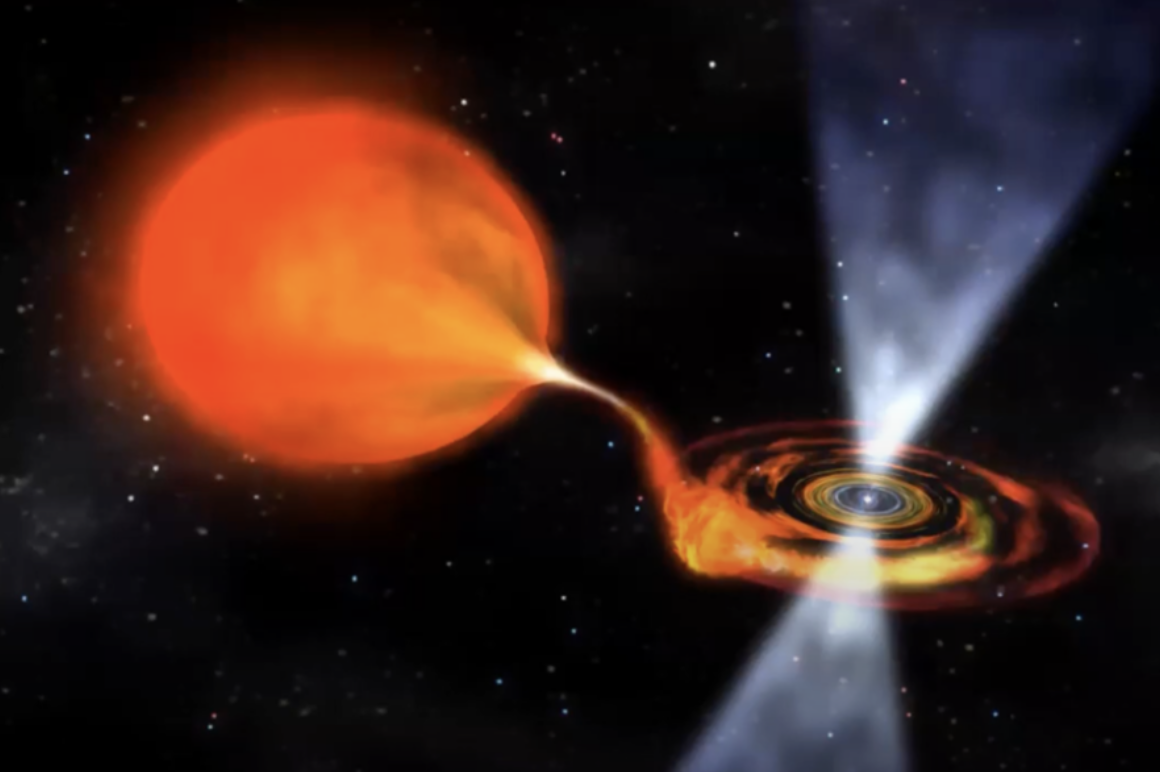
7月25日消息 天文学界最近有一项挺有意思的发现。根据中国科学院发布的信息,由南京天文光学技术研究所研究员王靓团队,联合国家天文台研究员罗阿理等人,利用LAMOST望远镜第十次公开的海量光谱数据,再结合多种测光数据,成功揪出了两颗全新的共生星,同时还锁定了12颗“仅吸积共生星”的候选体。这成果可不只
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
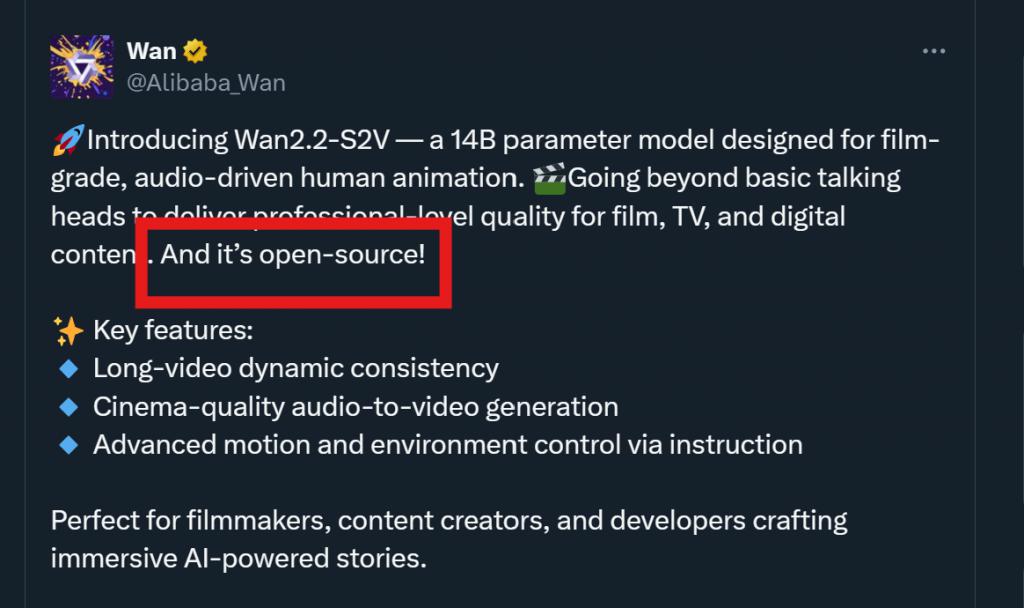
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
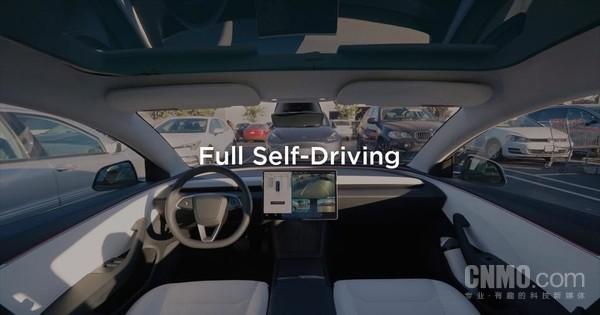
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
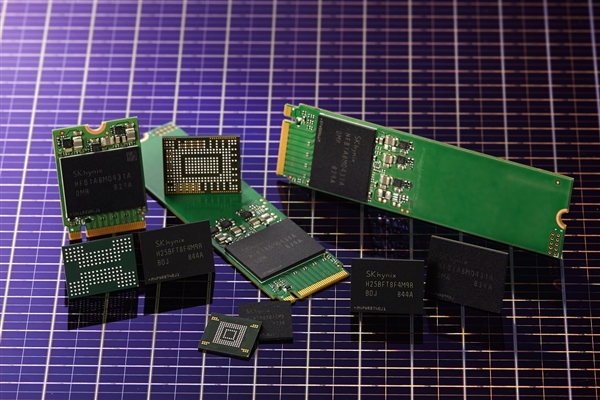
在千兆宽带、5G通信与云服务深度普及的2026年,大众普遍以为超大文件传输已步入“秒级时代”,但现实远未达到这般畅快。当面对数TB乃至数十TB级别的庞大数据集时,当下最可靠、最迅捷且兼顾安全性的传输方案,依然是“物理位移”——依靠人工携带存储介质完成跨地域交付。一位来自河南信阳的用户讲述了真实经历:他曾需将4TB资料从信阳送往郑州,首次尝试纯网络传输,系统预估总耗时近72小时;最终改用专人驱车运送,单程仅需约2.5小时,当天即完成取件与送达,整体效率显著超越线上方式。该实例迅速引发热议,多位资深IT博主随
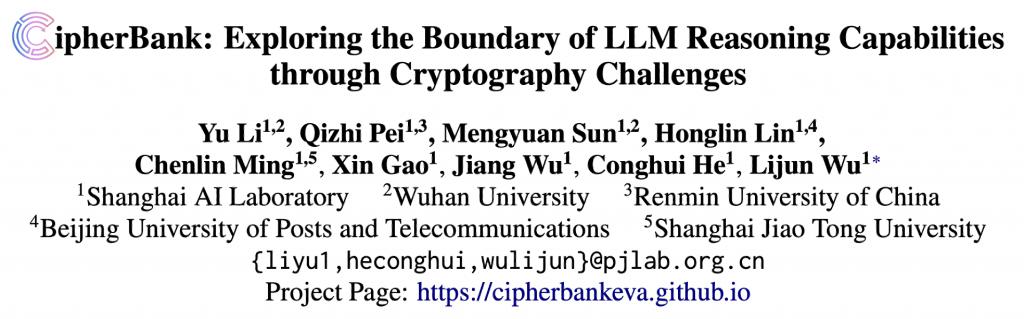
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



