

大模型迎来「开源季」,盘点过去一个月那些开源的LLM和数据集
前段时间,谷歌泄露的内部文件表达了这样一个观点,虽然表面看起来OpenAI和谷歌在AI大模型上你追我赶,但真正的赢家未必会从这两家中产生,因为有一个第三方力量正在悄然崛起。这个力量就是「开源」。围绕Meta的LLaMA开源模型,整个社区正在迅速构建与OpenAI、谷歌大模型能力类似的模型,而且开源模型的迭代速度更快,可定制性更强,更有私密性。近日,前威斯康星大学麦迪逊分校助理教授、初创公司LightningAI首席AI教育官SebastianRaschka表示,对于开源而言,过去一个月很伟大。不过,那么多
前段时间,谷歌泄露的内部文件表达了这样一个观点,虽然表面看起来 OpenAI 和谷歌在 AI 大模型上你追我赶,但真正的赢家未必会从这两家中产生,因为有一个第三方力量正在悄然崛起。这个力量就是「开源」。
围绕 Meta 的 LLaMA 开源模型,整个社区正在迅速构建与 OpenAI、谷歌大模型能力类似的模型,而且开源模型的迭代速度更快,可定制性更强,更有私密性。
近日,前威斯康星大学麦迪逊分校助理教授、初创公司 Lightning AI 首席 AI 教育官 Sebastian Raschka 表示,对于开源而言,过去一个月很伟大。
不过,那么多大语言模型(LLM)纷纷出现,要紧紧把握住所有模型并不容易。所以,Sebastian 在本文中分享了关于最新开源 LLM 和数据集的资源和研究洞见。

论文与趋势
过去一个月出现了很多研究论文,因此很难从中挑选出最中意的几篇进行深入的探讨。Sebastian 更喜欢提供额外洞见而非简单展示更强大模型的论文。鉴于此,引起他注意力的首先是 Eleuther AI 和耶鲁大学等机构研究者共同撰写的 Pythia 论文。

论文地址:https://arxiv.org/pdf/2304.01373.pdf
Pythia:从大规模训练中得到洞见
开源 Pythia 系列大模型真的是其他自回归解码器风格模型(即类 GPT 模型)的有趣平替。论文中揭示了关于训练机制的一些有趣洞见,并介绍了从 70M 到 12B 参数不等的相应模型。
Pythia 模型架构与 GPT-3 相似,但包含一些改进,比如 Flash 注意力(像 LLaMA)和旋转位置嵌入(像 PaLM)。同时 Pythia 在 800GB 的多样化文本数据集 Pile 上接受了 300B token 的训练(其中在常规 Pile 上训练 1 个 epoch,在去重 Pile 上训练 1.5 个 epoch )。

下面为一些从 Pythia 论文中得到的洞见和思考:
- 在重复数据上的训练(即训练 epoch>1)会不会有什么影响?结果表明,数据去重不会改善或损害性能;
- 训练命令会影响记忆吗?遗憾的是,结果表明并不会。之所以说遗憾,是因为如果影响的话,则可以通过训练数据的重新排序来减轻讨厌的逐字记忆问题;
- batch 大小加倍可以将训练时间减半但不损害收敛。
开源数据
对于开源 AI,过去一个月特别令人兴奋,出现了几个 LLM 的开源实现和一大波开源数据集。这些数据集包括 Databricks Dolly 15k、用于指令微调的 OpenAssistant Conversations (OASST1)、用于预训练的 RedPajama。这些数据集工作尤其值得称赞,因为数据收集和清理占了真实世界机器学习项目的 90%,但很少有人喜欢这项工作。
Databricks-Dolly-15 数据集
Databricks-Dolly-15 是一个用于 LLM 微调的数据集,它由数千名 DataBricks 员工编写了超过 15,000 个指令对(与训练 InstructGPT 和 ChatGPT 等系统类似)。
OASST1 数据集
OASST1 数据集用于在由人类创建和标注的类 ChatGPT 助手的对话集合上微调预训练 LLM,包含了 35 种语言编写的 161,443 条消息以及 461,292 个质量评估。这些是在超过 10,000 个完全标注的对话树中组织起来。
用于预训练的 RedPajama 数据集

RedPajama 是一个用于 LLM 预训练的开源数据集,类似于 Meta 的 SOTA LLaMA 模型。该数据集旨在创建一个媲美大多数流行 LLM 的开源竞争者,目前这些 LLM 要么是闭源商业模型要么仅部分开源。
RedPajama 的大部分由 CommonCrawl 组成,它对英文网站进行了过滤,但维基百科的文章涵盖了 20 种不同的语言。

LongForm 数据集
论文《The LongForm: Optimizing Instruction Tuning for Long Text Generation with Corpus Extraction》介绍了基于 C4 和 Wikipedia 等已有语料库的人工创作文档集合以及这些文档的指令,从而创建了一个适合长文本生成的指令调优数据集。
论文地址:https://arxiv.org/abs/2304.08460
Alpaca Libre 项目
Alpaca Libre 项目旨在通过将来自 Anthropics HH-RLHF 存储库的 100k + 个 MIT 许可演示转换为 Alpaca 兼容格式,以重现 Alpaca 项目。
扩展开源数据集
指令微调是我们从类 GPT-3 预训练基础模型演化到更强大类 ChatGPT 大语言模型的关键方式。Databricks-Dolly-15 等开源人工生成指令数据集有助于实现这一点。但我们如何进一步扩展呢?是否可以不收集额外数据呢?一种方法是从自身的迭代中bootstrap 一个 LLM。虽然 Self-Instruct 方法在 5 个月前提出(以如今标准来看过时了),但它仍是一种非常有趣的方法。值得强调的是,由于 Self-Instruct 一种几乎不需要注释的方法,因而可以将预训练 LLM 与指令对齐。
如何运作呢?简而言之可以分为以下四个步骤:
- 首先是具有一组人工编写指令(本例中为 175)和样本指令的种子任务池;
- 其次使用一个预训练 LLM(如 GPT-3)来确定任务类别;
- 接着给定新指令,使预训练 LLM 生成响应;
- 最后在将指令添加到任务池之前收集、修剪和过滤响应。

在实践中,基于 ROUGE 分数的工作会比较有效、例如 Self-Instruct 微调的 LLM 优于 GPT-3 基础 LLM,并可以在大型人工编写指令集上预训练的 LLM 竞争。同时 self-instruct 也可以使在人工指令上微调过的 LLM 收益。
但是当然,评估 LLM 的黄金标准是询问人类评分员。基于人类评估,Self-Instruct 优于基础 LLM、以及以监督方式在人类指令数据集上训练的 LLM(比如 SuperNI, T0 Trainer)。不过有趣的是,Self-Instruct 的表现并不优于通过人类反馈强化学习(RLHF)训练的方法。
人工生成 vs 合成训练数据集
人工生成指令数据集和 self-instruct 数据集,它们两个哪个更有前途呢?Sebastian 认为两者皆有前途。为什么不从人工生成指令数据集(例如 15k 指令的 databricks-dolly-15k)开始,然后使用 self-instruct 对它进行扩展呢?论文《Synthetic Data from Diffusion Models Improves ImageNet Classification》表明,真实图像训练集与 AI 生成图像相结合可以提升模型性能。探究对于文本数据是否也是这样是一件有趣的事情。
论文地址:https://arxiv.org/abs/2304.08466
最近的论文《Better Language Models of Code through Self-Improvement》就是关于这一方向的研究。研究者发现如果一个预训练 LLM 使用它自己生成的数据,则可以改进代码生成任务。
论文地址:https://arxiv.org/abs/2304.01228
少即是多(Less is more)?
此外,除了在越来越大的数据集上预训练和微调模型之外,又如何提高在更小数据集上的效率呢?论文《Distilling Step-by-Step! Outperforming Larger Language Models with Less Training Data and Smaller Model Sizes》中提出使用一种蒸馏机制来管理任务特定的更小模型,它们使用更少的训练数据却超越了标准微调的性能。
论文地址:https://arxiv.org/abs/2305.02301

追踪开源 LLM
开源 LLM 的数量呈爆炸式增长,一方面是非常好的发展趋势(相较于通过付费 API 控制模型),但另一方面追踪这一切可能很麻烦。以下四种资源提供了大多数相关模型的不同摘要,包括它们的关系、底层数据集和各种许可信息。
第一种资源是基于论文《Ecosystem Graphs: The Social Footprint of Foundation Models》的生态系统图网站,提供如下表格和交互式依赖图(这里未展示)。
这个生态系统图是 Sebastian 迄今为止见过的最全面的列表,但由于包含了很多不太流行的 LLM,因而可能显得有点混乱。检查相应的 GitHub 库发现,它已经更新了至少一个月。此外尚不清楚它会不会添加更新的模型。

- 论文地址:https://arxiv.org/abs/2303.15772
- 生态系统图网站地址:https://crfm.stanford.edu/ecosystem-graphs/index.html?mode=table
第二种资源是最近论文《Harnessing the Power of LLMs in Practice: A Survey on ChatGPT and Beyond》中绘制精美的进化树,该论文侧重于最流行的 LLM 和它们的关系。
虽然读者看到了非常美观和清晰的可视化 LLM 进化树,但也有一些小的疑惑。例如不清楚为什么底部没有从原始 transformer 架构开始。此外开源标签并不是非常的准确,例如 LLaMA 被列为开源,但权重在开源许可下不可用(只有推理代码是这样的)。

论文地址:https://arxiv.org/abs/2304.13712
第三种资源是 Sebastian 同事 Daniela Dapena 绘制的表格,出自于博客《The Ultimate Battle of Language Models: Lit-LLaMA vs GPT3.5 vs Bloom vs …》。
虽然下述表格比其他资源要小,但其优点在于包含了模型尺寸和许可信息。如果你计划在任何项目中采用这些模型,则该表格会非常有实用性。

博客地址:https://lightning.ai/pages/community/community-discussions/the-ultimate-battle-of-language-models-lit-llama-vs-gpt3.5-vs-bloom-vs/
第四种资源是 LLaMA-Cult-and-More 总览表,它提供了有关微调方法和硬件成本的额外信息。

总览表地址:https://github.com/shm007g/LLaMA-Cult-and-More/blob/main/chart.md
利用 LLaMA-Adapter V2 微调多模态 LLM
Sebastian 预测本月会看到更多的多模态 LLM 模型,因此不得不谈到不久前发布的论文《LLaMA-Adapter V2: Parameter-Efficient Visual Instruction Model》。先来回顾一下什么是 LLaMA-Adapter?它是一种参数高效的 LLM 微调技术,修改了前面几个 transformer 块并引入一种门控机制来稳定训练。
论文地址:https://arxiv.org/abs/2304.15010
使用 LLaMA-Adapter 方法,研究人员能够在 52k 个指令对上仅用 1 小时(8 块 A100 GPU)来微调一个 7B 参数的 LLaMA 模型。虽然仅对新添加的 1.2M 参数(adapter 层)进行了微调,但 7B LLaMA 模型仍处于冻结(frozen)状态。
LLaMA-Adapter V2 的重点在多模态,即构建一个可以接收图像输入的视觉指令模型。最初的 V1 虽然可以接收文本 token 和图像 token,但在图像方面没有得到充分探索。
LLaMA-Adapter 从 V1 到 V2,研究人员通过以下三个主要技巧来改进 adapter 方法。
- 早期视觉知识融合:不再在每个 adapted 层融合视觉和 adapted 提示,而是在第一个 transformer 块中将视觉 token 与单词 token 连接起来;
- 使用更多参数:解冻(unfreeze)所有归一化层,并将偏置单元和缩放因子添加到 transformer 块中每个线性层;
- 具有不相交参数的联合训练:对于图文字幕数据,仅训练视觉投影层;针对指令遵循的数据仅训练 adaption 层(以及上述新添加的参数)。
LLaMA V2(14M)比 LLaMA V1 (1.2 M) 的参数多了很多,但它仍是轻量级,仅占 65B LLaMA 总参数的 0.02%。特别令人印象深刻的是,通过仅对 65B LLaMA 模型的 14M 参数进行微调,得到的 LLaMA-Adapter V2 在性能上媲美 ChatGPT(当使用 GPT-4 模型进行评估)。LLaMA-Adapter V2 还优于使用全微调方法的 13B Vicuna 模型。
遗憾的是,LLaMA-Adapter V2 论文省略了 V1 论文中包含的计算性能基准,但我们可以假设 V2 仍然比全微调方法快得多。

其他开源 LLM
大模型的发展速度奇快,我们无法一一列举,本月推出的一些著名的开源 LLM 和聊天机器人包括 Open-Assistant、Baize、StableVicuna、ColossalChat、Mosaic 的 MPT 等。此外,下面是两个特别有趣的多模态 LLM。
OpenFlamingo
OpenFlamingo 是 Google DeepMind 去年发布的 Flamingo 模型的开源复制版。OpenFlamingo 旨在为 LLM 提供多模式图像推理功能,让人们能够交错输入文本和图像。
MiniGPT-4
MiniGPT-4 是另一种具有视觉语言功能的开源模型。它基于 BLIP-27 的冻结视觉编码器和冻结的 Vicuna LLM。

NeMo Guardrails
随着这些大语言模型的出现,许多公司都在思考如何以及是否应该部署它们,安全方面的担忧尤为突出。目前还没有好的解决方案,但至少有一个更有前途的方法:英伟达开源了一个工具包来解决 LLM 的幻觉问题。
简而言之,它的工作原理是此方法使用数据库链接到硬编码的 prompt,这些 prompt 必须手动管理。然后,如果用户输入 prompt,该内容将首先与该数据库中最相似的条目相匹配。然后数据库返回一个硬编码的 prompt,然后传递给 LLM。因此,如果有人仔细测试硬编码 prompt,就可以确保交互不会偏离允许的主题等。

这是一种有趣但不是开创性的方法,因为它没有为 LLM 提供更好的或新的能力,它只是限制了用户可以与 LLM 交互的程度。尽管如此,在研究人员找到减轻 LLM 中的幻觉问题和负面行为的替代方法之前,这可能是一种可行的方法。
guardrails 方法还可以与其他对齐技术相结合,例如作者在上一期 Ahead of AI 中介绍的流行的人类反馈强化学习训练范例。
一致性模型
谈论 LLM 以外的有趣模型是一个不错的尝试,OpenAI 终于开源了他们一致性模型的代码:https://github.com/openai/consistency_models。
一致性模型被认为是扩散模型的可行、有效的替代方案。你可以在一致性模型的论文中获得更多信息。
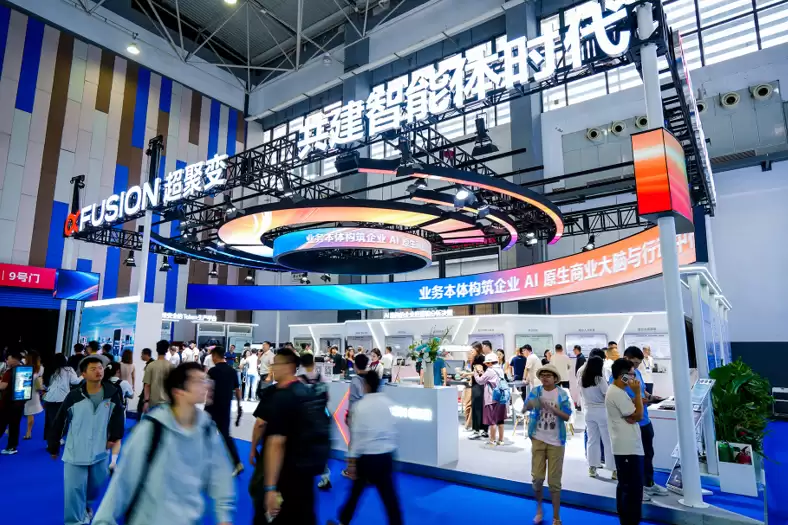
本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。

从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
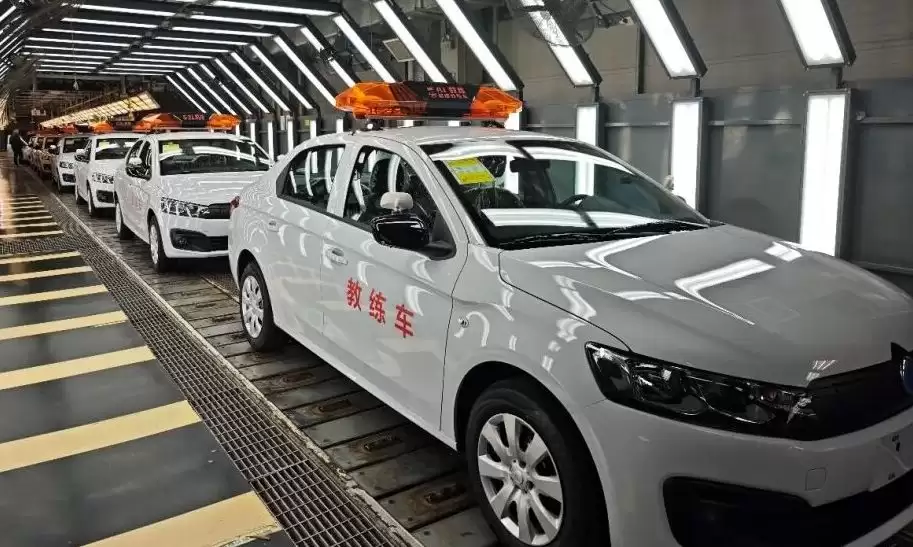
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。
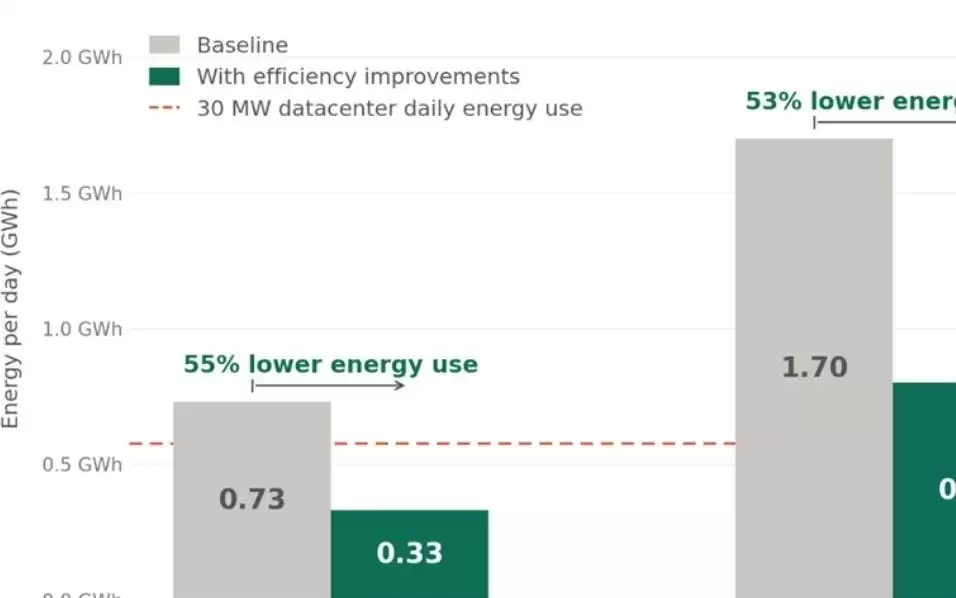
据微软引用《Joule》期刊的一项研究指出,每一次典型人工智能查询耗电量零点一六至零点六零瓦时,其冷却用水量中位数不足一滴水。大规模部署下,单位查询的效率会更高,总能耗可以降低一半以上。
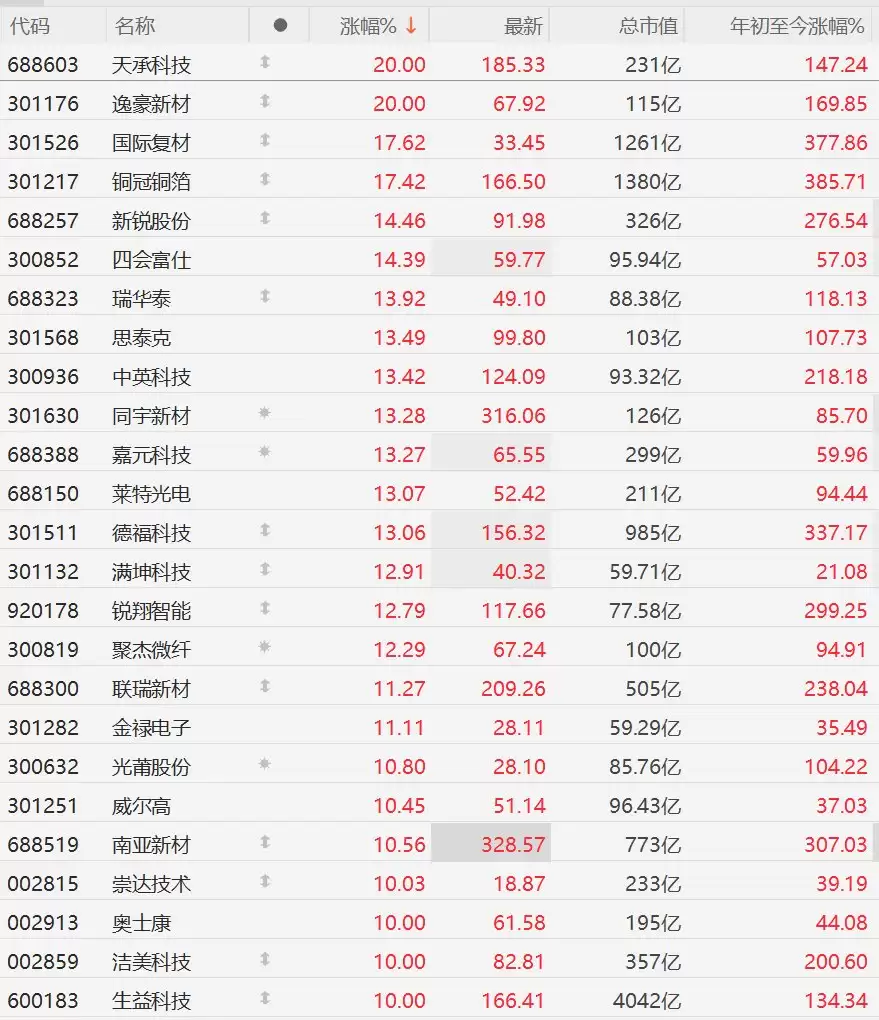
A股PCB概念板块掀起涨停潮,因摩根士丹利报告预测AI光模块PCB市场三年增长超5倍,2025至2028年规模从6.2亿美元增至37.7亿美元,年复合增速高达83%,远超光模块整体增速。
哈啰推出的A70云朵共享单车搭载海思芯片与鸿蒙系统,实现200毫秒极速开锁;追风者自动变速车客单价提升30%,用户复购率超40%。技术升级使运维成本占比降至25%,日均使用频次升至4.8次,分层运营策略有效分摊成本,推动共享单车从交通工具向智能终端转型。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
