

机器学习必备:如何防止过拟合?
其实正则化的本质很简单,就是对某一问题加以先验的限制或约束以达到某种特定目的的一种手段或操作。在算法中使用正则化的目的是防止模型出现过拟合。一提到正则化,很多同学可能马上会想到常用的L1范数和L2范数,在汇总之前,我们先看下LP范数是什么?LP范数范数简单可以理解为用来表征向量空间中的距离,而距离的定义很抽象,只要满足非负、自反、三角不等式就可以称之为距离。LP范数不是一个范数,而是一组范数,其定义如下:p的范围是[1,∞)。p在(0,1)范围内定义的并不是范数,因为违反了三角不等式。根据pp的变化,范数
其实正则化的本质很简单,就是对某一问题加以先验的限制或约束以达到某种特定目的的一种手段或操作。在算法中使用正则化的目的是防止模型出现过拟合。一提到正则化,很多同学可能马上会想到常用的L1范数和L2范数,在汇总之前,我们先看下LP范数是什么?
LP范数
范数简单可以理解为用来表征向量空间中的距离,而距离的定义很抽象,只要满足非负、自反、三角不等式就可以称之为距离。
LP范数不是一个范数,而是一组范数,其定义如下:
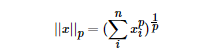
p的范围是[1,∞)。p在(0,1)范围内定义的并不是范数,因为违反了三角不等式。
根据pp的变化,范数也有着不同的变化,借用一个经典的有关P范数的变化图如下:

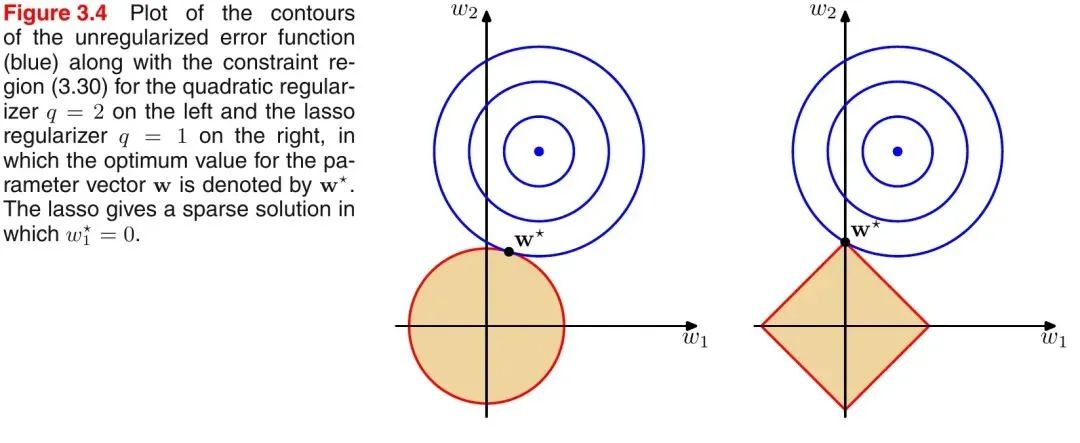
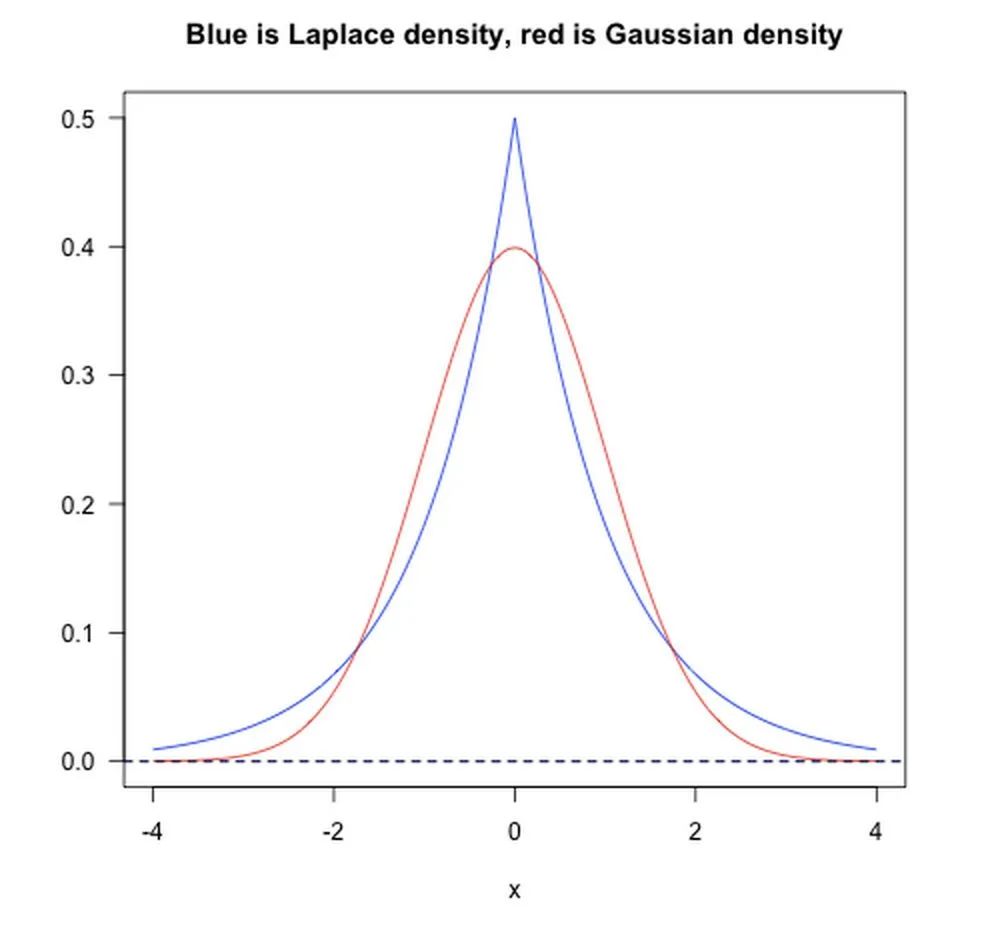
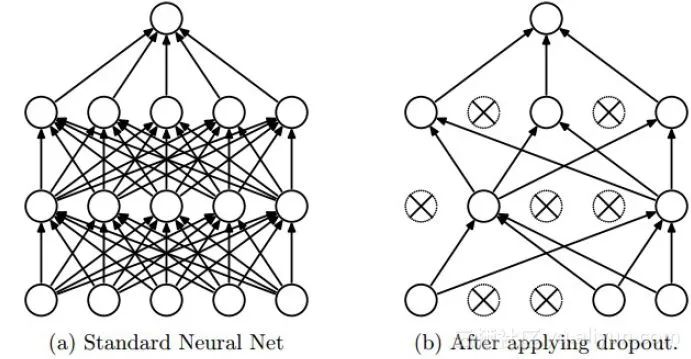
上图表示了p从0到正无穷变化时,单位球(unit ball)的变化情况。在P范数下定义的单位球都是凸集,但是当0 那问题来了,L0范数是啥玩意?L0范数表示向量中非零元素的个数,用公式表示如下: 我们可以通过最小化L0范数,来寻找最少最优的稀疏特征项。但不幸的是,L0范数的最优化问题是一个NP hard问题(L0范数同样是非凸的)。因此,在实际应用中我们经常对L0进行凸松弛,理论上有证明,L1范数是L0范数的最优凸近似,因此通常使用L1范数来代替直接优化L0范数。 根据LP范数的定义我们可以很轻松的得到L1范数的数学形式: 通过上式可以看到,L1范数就是向量各元素的绝对值之和,也被称为是"稀疏规则算子"(Lasso regularization)。那么问题来了,为什么我们希望稀疏化?稀疏化有很多好处,最直接的两个: L2范数是最熟悉的,它就是欧几里得距离,公式如下: L2范数有很多名称,有人把它的回归叫“岭回归”(Ridge Regression),也有人叫它“权值衰减”(Weight Decay)。以L2范数作为正则项可以得到稠密解,即每个特征对应的参数ww都很小,接近于0但是不为0;此外,L2范数作为正则化项,可以防止模型为了迎合训练集而过于复杂造成过拟合的情况,从而提高模型的泛化能力。 引入PRML一个经典的图来说明下L1和L2范数的区别,如下图所示: 如上图所示,蓝色的圆圈表示问题可能的解范围,橘色的表示正则项可能的解范围。而整个目标函数(原问题+正则项)有解当且仅当两个解范围相切。从上图可以很容易地看出,由于L2范数解范围是圆,所以相切的点有很大可能不在坐标轴上,而由于L1范数是菱形(顶点是凸出来的),其相切的点更可能在坐标轴上,而坐标轴上的点有一个特点,其只有一个坐标分量不为零,其他坐标分量为零,即是稀疏的。所以有如下结论,L1范数可以导致稀疏解,L2范数导致稠密解。 从贝叶斯先验的角度看,当训练一个模型时,仅依靠当前的训练数据集是不够的,为了实现更好的泛化能力,往往需要加入先验项,而加入正则项相当于加入了一种先验。 如下图所示: Dropout是深度学习中经常采用的一种正则化方法。它的做法可以简单的理解为在DNNs训练的过程中以概率pp丢弃部分神经元,即使得被丢弃的神经元输出为0。Dropout可以实例化的表示为下图: 我们可以从两个方面去直观地理解Dropout的正则化效果: 批规范化(Batch Normalization)严格意义上讲属于归一化手段,主要用于加速网络的收敛,但也具有一定程度的正则化效果。 这里借鉴下魏秀参博士的知乎回答中对covariate shift的解释。 注:以下内容引自魏秀参博士的知乎回答大家都知道在统计机器学习中的一个经典假设是“源空间(source domain)和目标空间(target domain)的数据分布(distribution)是一致的”。如果不一致,那么就出现了新的机器学习问题,如transfer learning/domain adaptation等。而covariate shift就是分布不一致假设之下的一个分支问题,它是指源空间和目标空间的条件概率是一致的,但是其边缘概率不同。大家细想便会发现,的确,对于神经网络的各层输出,由于它们经过了层内操作作用,其分布显然与各层对应的输入信号分布不同,而且差异会随着网络深度增大而增大,可是它们所能“指示”的样本标记(label)仍然是不变的,这便符合了covariate shift的定义。 BN的基本思想其实相当直观,因为神经网络在做非线性变换前的激活输入值(X=WU+B,U是输入)随着网络深度加深,其分布逐渐发生偏移或者变动(即上述的covariate shift)。之所以训练收敛慢,一般是整体分布逐渐往非线性函数的取值区间的上下限两端靠近(对于Sigmoid函数来说,意味着激活输入值X=WU+B是大的负值或正值),所以这导致后向传播时低层神经网络的梯度消失,这是训练深层神经网络收敛越来越慢的本质原因。而BN就是通过一定的规范化手段,把每层神经网络任意神经元这个输入值的分布强行拉回到均值为0方差为1的标准正态分布,避免因为激活函数导致的梯度弥散问题。所以与其说BN的作用是缓解covariate shift,倒不如说BN可缓解梯度弥散问题。 正则化我们以及提到过了,这里简单提一下归一化和标准化。归一化(Normalization):归一化的目标是找到某种映射关系,将原数据映射到[a,b]区间上。一般a,b会取[−1,1],[0,1]这些组合。一般有两种应用场景: 常用min-max normalization: 标准化(Standardization):用大数定理将数据转化为一个标准正态分布,标准化公式为: 我们可以这样简单地解释:归一化的缩放是“拍扁”统一到区间(仅由极值决定),而标准化的缩放是更加“弹性”和“动态”的,和整体样本的分布有很大的关系。值得注意: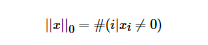
L1范数
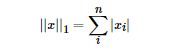
L2范数
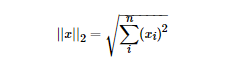
L1范数和L2范数的区别

Dropout
Batch Normalization
归一化、标准化 & 正则化
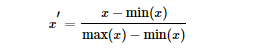
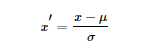
归一化和标准化的区别:
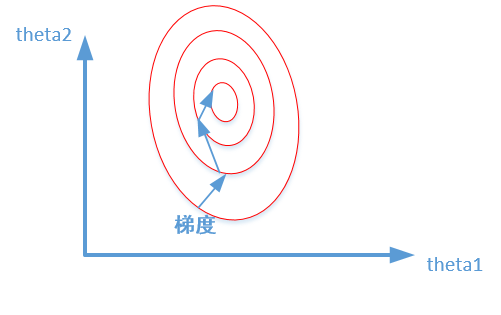
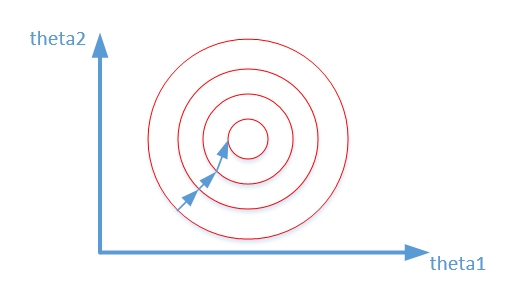
为什么要标准化和归一化?
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
6月29日,中科院计算机网络信息中心等单位发布“异算方舟”国产计算系统软件生态全栈平台。该平台针对算法供给不足、代码迁移困难、智能应用落地慢三大痛点,打造九衍枢算法库、无界BoundX代码转换大模型、Agent-HiReFlow自动化仿真智能体三大能力,提供从底层算法到代码适配再到智能应用的一体化解决方案。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科
背景由于云计算在资源成本和弹性扩容方面的天然优势,越来越多客户愿意在云上构建 AI 系统,而以容器、Kubernetes 为代表的云原生技术,已经成为释放云价值的最短路径, 在云上基于 Kubernetes 构建 AI 平台已经成为趋势。在面对较为复杂的模型训练或者大量数据时,单机的计算能力往往难以
轻量化浏览器的崛起:当极简主义成为生产力 这些年,浏览器的战场早已不再局限于功能和扩展的堆砌。一股轻量、高效的“清流”正在改变用户的上网习惯,而夸克浏览器无疑是这股潮流中的佼佼者。它以清爽的界面和高效的核心性能,成功在移动端圈粉无数。好消息是,这股清爽之风如今也吹到了电脑桌面上——通过官方网页版入口
学习通网页版登录入口:通往数字课堂的便捷通道 作为师生获取在线教育资源的关键门户,学习通网页版登录入口的设计直接影响到数字化学习体验的流畅度。下面这份指南将带你系统掌握官方认证通道的使用要领,让每次登录都成为高效学习的开端。 官方登录入口:直达学习核心区 超星官方指定的入口地址始终是最可靠的选择:点
漫画爱好者的掌上宝库:喵趣漫画官方下载全解析 对于漫画迷而言,找到合适的阅读平台至关重要。喵趣漫画官方下载入口恰好提供了这样的解决方案——这里不仅是海量正版资源的聚集地,更打造了一站式的跨终端阅读体验。应用内覆盖了热血、恋爱、悬疑等主流题材,配合智能设备适配技术,让阅读真正实现无缝衔接。界面设计简洁
熵基科技发布HuggingZKT算法商城,面向空间智能领域打造端云协同AI算法管理平台,覆盖算法训练、发布、订阅、升级等全生命周期,形成开放高效的算法服务体系,推动园区、楼宇等场景的AI能力敏捷调用,助力空间智能规模化应用迈入新阶段。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



