

深入浅出,解析ChatGPT背后的工作原理
ChatGPT是OpenAI发布的最新语言模型,比其前身GPT-3有显著提升。与许多大型语言模型类似,ChatGPT能以不同样式、不同目的生成文本,并且在准确度、叙述细节和上下文连贯性上具有更优的表现。它代表了OpenAI最新一代的大型语言模型,并且在设计上非常注重交互性。OpenAI使用监督学习和强化学习的组合来调优ChatGPT,其中的强化学习组件使ChatGPT独一无二。OpenAI使用了「人类反馈强化学习」(RLHF)的训练方法,该方法在训练中使用人类反馈,以最小化无益、
ChatGPT 是 OpenAI 发布的最新语言模型,比其前身 GPT-3 有显著提升。与许多大型语言模型类似,ChatGPT 能以不同样式、不同目的生成文本,并且在准确度、叙述细节和上下文连贯性上具有更优的表现。它代表了 OpenAI 最新一代的大型语言模型,并且在设计上非常注重交互性。
OpenAI 使用监督学习和强化学习的组合来调优 ChatGPT,其中的强化学习组件使 ChatGPT 独一无二。OpenAI 使用了「人类反馈强化学习」(RLHF)的训练方法,该方法在训练中使用人类反馈,以最小化无益、失真或偏见的输出。
本文将剖析 GPT-3 的局限性及其从训练过程中产生的原因,同时将解释 RLHF 的原理和理解 ChatGPT 如何使用 RLHF 来克服 GPT-3 存在的问题,最后将探讨这种方法的局限性。
大型语言模型中的能力与一致性
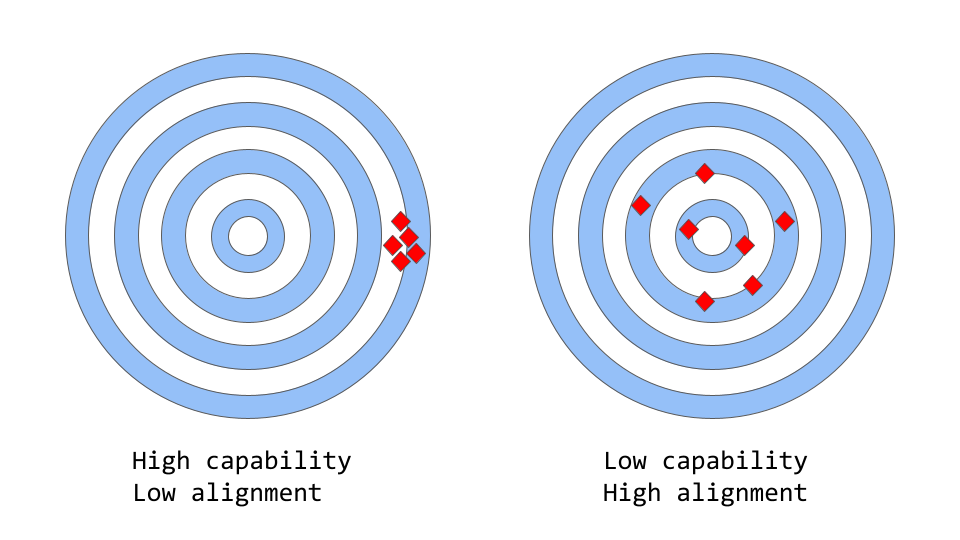
「一致性 vs 能力」可以被认为是「准确性 vs 精确性」的更抽象的类比。
在机器学习中,模型的能力是指模型执行特定任务或一组任务的能力。模型的能力通常通过它能够优化其目标函数的程度来评估。例如,用来预测市场价格的模型可能有一个衡量模型预测准确性的目标函数。如果该模型能够准确预测票价随时间的变化,则认为该模型具有很高的执行能力。
一致性关注的是实际希望模型做什么,而不是它被训练做什么。它提出的问题是「目标函数是否符合预期」,根据的是模型目标和行为在多大程度上符合人类的期望。假设要训练一个鸟类分类器,将鸟分类为「麻雀」或「知更鸟」,使用对数损失作为训练目标,而最终目标是很高的分类精度。该模型可能具有较低的对数损失,即该模型的能力较强,但在测试集上的精度较差,这就是一个不一致的例子,模型能够优化训练目标,但与最终目标不一致。
原始的 GPT-3 就是非一致模型。类似 GPT-3 的大型语言模型都是基于来自互联网的大量文本数据进行训练,能够生成类似人类的文本,但它们可能并不总是产生符合人类期望的输出。事实上,它们的目标函数是词序列上的概率分布,用来预测序列中的下一个单词是什么。
但在实际应用中,这些模型的目的是执行某种形式的有价值的认知工作,并且这些模型的训练方式与期望使用它们的方式之间存在明显的差异。尽管从数学上讲,机器计算词序列的统计分布可能是建模语言的高效选择,但人类其实是通过选择最适合给定情境的文本序列来生成语言,并使用已知的背景知识和常识来辅助这一过程。当语言模型用于需要高度信任或可靠性的应用程序(如对话系统或智能个人助理)时,这可能是一个问题。
尽管这些基于大量数据训练的大模型在过去几年中变得极为强大,但当用于实际以帮助人们生活更轻松时,它们往往无法发挥潜力。大型语言模型中的一致性问题通常表现为:
- 提供无效帮助:没有遵循用户的明确指示。
- 内容胡编乱造:虚构不存在或错误事实的模型。
- 缺乏可解释性:人们很难理解模型是如何得出特定决策或预测的。
- 内容偏见有害:一个基于有偏见、有害数据训练的语言模型可能会在其输出中出现这种情况,即使它没有明确指示这样做。
但具体来说,一致性问题源自何处?语言模型的训练方式本身就容易产生不一致吗?
语言模型训练策略如何产生不一致?
Next-token-prediction 和 masked-language-modeling 是用于训练语言模型的核心技术。在第一种方法中,模型被给定一个词序列作为输入,并被要求预测序列中的下一个词。如果为模型提供输入句子:
“The cat sat on the”
它可能会将下一个单词预测为「mat」、「chair」或「floor」,因为在前面的上下文中,这些单词出现的概率很高;语言模型实际上能够评估给定先前序列的每个可能词的可能性。
masked-language-modeling 方法是 Next-token-prediction 的变体,其中输入句子中的一些词被替换为特殊 token,例如 [MASK]。然后,模型被要求预测应该插入到 mask 位置的正确的词。如果给模型一个句子:
“The [MASK] sat on the ”
它可能会预测 MASK 位置应该填的词是「cat」、「dog」。
这些目标函数的优点之一是,它允许模型学习语言的统计结构,例如常见的词序列和词使用模式。这通常有助于模型生成更自然、更流畅的文本,并且是每个语言模型预训练阶段的重要步骤。
然而这些目标函数也可能导致问题,这主要是因为模型无法区分重要错误和不重要错误。一个非常简单的例子是,如果给模型输入句子:
"The Roman Empire [MASK] with the reign of Augustus."
它可能会预测 MASK 位置应该填入「began」或「ended」,因为这两个词的出现概率都很高。
一般来说,这些训练策略可能会导致语言模型在一些更复杂的任务中出现不一致,因为一个仅被训练来预测文本序列中的下一个词的模型可能不一定会学习其含义的某些更高级表征。因此,该模型很难推广到需要对语言更深入理解的任务。
研究人员正研究各种方法来解决大型语言模型中的一致性问题。ChatGPT 基于最初的 GPT-3 模型,但为了解决模型的不一致问题,使用了人类反馈来指导学习过程,对其进行了进一步训练。所使用的具体技术就是前面提到的 RLHF。ChatGPT 是第一个将此技术用于实际场景的模型。
那 ChatGPT 是如何利用人类反馈来解决一致性问题的呢?
从人类反馈中进行强化学习
方法总体上包括三个不同步骤:
- 有监督的调优:预训练的语言模型在少量已标注的数据上进行调优,以学习从给定的 prompt 列表生成输出的有监督的策略(即 SFT 模型);
- 模拟人类偏好:标注者们对相对大量的 SFT 模型输出进行投票,这就创建了一个由比较数据组成的新数据集。在此数据集上训练新模型,被称为训练回报模型(Reward Model,RM);
- 近端策略优化(PPO):RM 模型用于进一步调优和改进 SFT 模型,PPO 输出结果是的策略模式。
步骤 1 只进行一次,而步骤 2 和步骤 3 可以持续重复进行:在当前最佳策略模型上收集更多的比较数据,用于训练新的 RM 模型,然后训练新的策略。接下来,将对每一步的细节进行详述。
步骤 1:监督调优模型
第一步是收集数据,以训练有监督的策略模型。
- 数据收集:选择一个提示列表,标注人员按要求写下预期的输出。对于 ChatGPT,使用了两种不同的 prompt 来源:一些是直接使用标注人员或研究人员准备的,另一些是从 OpenAI 的 API 请求(即从 GPT-3 用户那里)获取的。虽然整个过程缓慢且昂贵,但最终得到的结果是一个相对较小、高质量的数据集(大概有 12-15k 个数据点),可用于调优预训练的语言模型。
- 模型选择:ChatGPT 的开发人员选择了 GPT-3.5 系列中的预训练模型,而不是对原始 GPT-3 模型进行调优。使用的基线模型是最新版的 text-davinci-003(通过对程序代码调优的 GPT-3 模型)。
为了创建像 ChatGPT 这样的通用聊天机器人,开发人员是在「代码模型」而不是纯文本模型之上进行调优。
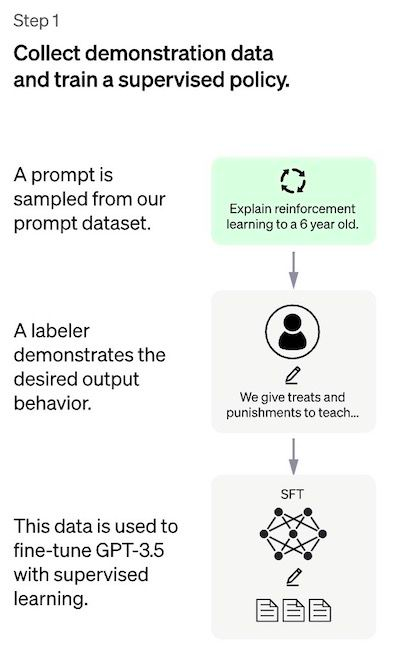
由于此步骤的数据量有限,该过程获得的 SFT 模型可能会输出仍然并非用户关注的文本,并且通常会出现不一致问题。这里的问题是监督学习步骤具有高可扩展性成本。
为了克服这个问题,使用的策略是让人工标注者对 SFT 模型的不同输出进行排序以创建 RM 模型,而不是让人工标注者创建一个更大的精选数据集。
第二步:训练回报模型
这一步的目标是直接从数据中学习目标函数。该函数的目的是为 SFT 模型输出进行打分,这代表这些输出对于人类来说可取程度有多大。这强有力地反映了选定的人类标注者的具体偏好以及他们同意遵循的共同准则。最后,这个过程将从数据中得到模仿人类偏好的系统。
它的工作原理是:
- 选择 prompt 列表,SFT 模型为每个 prompt 生成多个输出(4 到 9 之间的任意值);
- 标注者将输出从最佳到最差排序。结果是一个新的标签数据集,该数据集的大小大约是用于 SFT 模型的精确数据集的 10 倍;
- 此新数据用于训练 RM 模型 。该模型将 SFT 模型输出作为输入,并按优先顺序对它们进行排序。
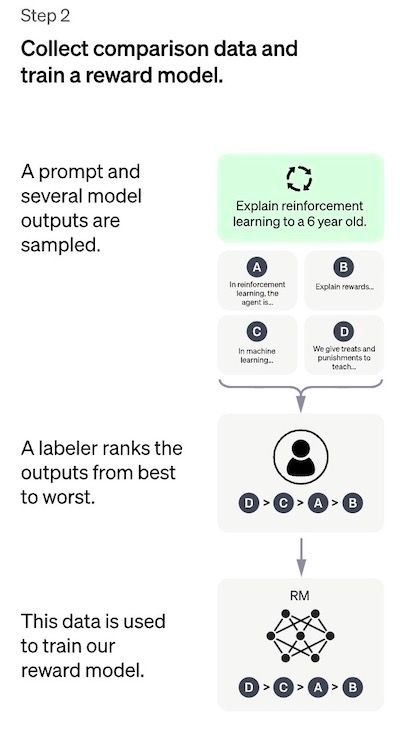
对于标注者来说,对输出进行排序比从头开始打标要容易得多,这一过程可以更有效地扩展。在实践中,所选择的 prompt 的数量大约为 30-40k,并且包括排序输出的不同组合。
步骤 3:使用 PPO 模型微调 SFT 模型
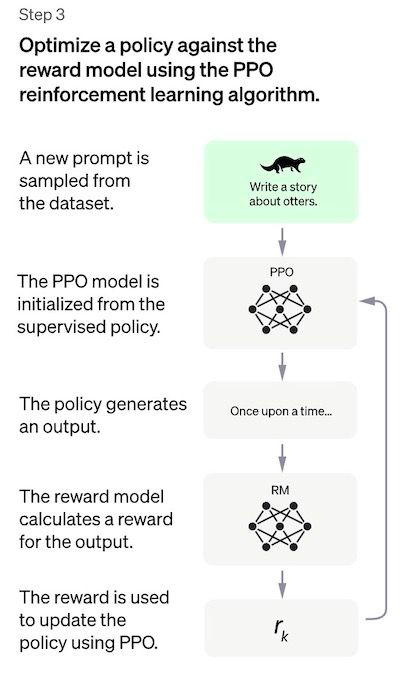
这一步里强化学习被应用于通过优化 RM 模型来调优 SFT 模型。所使用的特定算法称为近端策略优化(PPO),而调优模型称为近段策略优化模型。
什么是 PPO?该算法的主要特点如下:
- PPO 是一种用于在强化学习中训练 agent 的算法。它被称为「on-policy」算法,因为它直接学习和更新当前策略,而不是像 DQN 的「off-policy」算法那样从过去的经验中学习。PPO 根据 agent 所采取的行动和所获得的回报不断调整策略;
- PPO 使用「信任区域优化」方法来训练策略,它将策略的更改范围限制在与先前策略的一定程度内以保证稳定性。这与其它策略使用梯度方法形成鲜明对比,梯度方法有时会对策略进行大规模更新,从而破坏策略的稳定性;
- PPO 使用价值函数来估计给定状态或动作的预期回报。价值函数用于计算优势函数,它代表预期收益和当前收益之间的差异。然后使用优势函数通过比较当前策略采取的操作与先前策略将采取的操作来更新策略。这使 PPO 可以根据所采取行动的估计价值对策略进行更明智的更新。
在这一步中,PPO 模型由 SFT 模型初始化,价值函数由 RM 模型初始化。该环境是一个「bandit environment」,它会产生随机 prompt 并期望对 prompt 做出响应。对于给定的 prompt 和响应,它会产生相应的回报(由 RM 模型决定)。SFT 模型会对每个 token 添加 KL 惩罚因子,以尽量避免 RM 模型的过度优化。
性能评估
因为模型是根据人工标注的输入进行训练的,所以评估的核心部分也基于人工输入,即通过让标注者对模型输出的质量评分来进行。为避免训练阶段涉及的标注者的判断过拟合,测试集使用了来自其它 OpenAI 客户的 prompt,这些 prompt 未出现在训练数据中。
该模型基于三个标准进行评估:
- 帮助性:判断模型遵循用户指示以及推断指示的能力。
- 真实性:判断模型在封闭领域任务中有产生虚构事实的倾向。
- 无害性:标注者评估模型的输出是否适当、是否包含歧视性内容。
该模型还针对传统 NLP 任务(如解答问题、阅读理解和摘要)的零样本学习的性能进行了评估,开发人员发现在其中一些任务上模型的表现比 GPT-3 要差一些,这是一个「一致性税」( alignment tax) 的例子,其中基于 人类反馈强化学习的一致性程序是以降低某些任务的性能为代价的。
这些数据集的性能回归可以通过称为预训练混合的技巧大大减少:在通过梯度下降训练 PPO 模型期间,通过混合 SFT 模型和 PPO 模型的梯度来计算梯度更新。
方法的缺点
该方法的一个非常明显的局限性是,在将语言模型与人类意图保持一致的过程中,用于 fine-tuning 模型的数据会受到各种错综复杂的主观因素的影响,主要包括:
- 生成 demo 数据的人工标注者的偏好;
- 设计研究和编写标签说明的研究人员;
- 选择由开发人员制作或由 OpenAI 客户提供的 prompt;
- 标注者偏差既包含在 RM 模型训练中,也包含在模型评估中。
ChatGPT 的作者也承认一个明显的事实,即参与训练过程的标注人员和研究人员可能并不能完全代表语言模型的所有潜在最终用户。
除了这一明显的「内生」限制之外,该方法还有的一些其它缺点和需要解决的问题:
- 缺乏对照研究:报告的结果以 SFT 模型为基准衡量最终 PPO 模型的性能。这可能会产生误导:如何知道这些改进是由于 RLHF?因此对照研究非常有必要,包括投入与用于训练 RM 模型的标注工时数完全相同的时间,以创建具有高质量数据的更大的精选有监督调优的数据集。这样就可以客观地衡量 RLHF 方法与监督方法相比的性能改进。简单来说,缺乏这样的对照研究让一个基本问题完全悬而未决:RLHF 在一致性语言模型方面真的做得很好吗?
- 比较数据缺乏基本事实:标注者通常会对模型输出的排名持不同意见。技术上讲,产生的风险是在没有任何基本事实的情况下,向比较数据添加了很大的方差。
- 人类的偏好并非同质:RLHF 方法将人类的偏好视为同质和静态的。假设所有人都有相同的价值观,这明显是不准确的,虽然有大量的公共价值观,但在很多事务上人类还是存在许多不同的认知。
- RM 模型 prompt 稳定性测试:没有实验表明 RM 模型在输入 prompt 变化方面的敏感性。如果两个 prompt 在句法上不同但在语义上是等价的,RM 模型能否在模型输出的排名中显示出显著差异?即 prompt 的质量对 RM 有多重要?
- 其它问题:在 RL 方法中,模型有时可以学会控制自己的 RM 模型以实现期望的结果,从而导致「过度优化的策略」。这可能会导致模型重新创建一些模式,因为某些未知的原因,这些模式使 RM 模型得分较高。ChatGPT 通过使用 RM 函数中的 KL 惩罚项对此进行了修补。
相关阅读:
- 关于用于 ChatGPT 的 RLHF 方法的相关的论文:Training language models to follow instructions with human feedback(https://arxiv.org/pdf/2203.02155.pdf),它实际上详细描述了一个名为 InstructionGPT 的模型,OpenAI 称之为 ChatGPT 的「兄弟模型」。
- Learning to summarize from Human Feedback (https://arxiv.org/pdf/2009.01325.pdf)描述了文本摘要上下文中的 RLHF。
- PPO(https://arxiv.org/pdf/1707.06347.pdf):PPO 算法论文。
- Deep reinforcement learning from human preferences (https://arxiv.org/abs/1706.03741)
- DeepMind 在 Sparrow 中提出了 OpenAI RLHF 的替代方案 (https://arxiv.org/pdf/2209.14375.pdf) 和 GopherCite (https://arxiv.org/abs/2203.11147)文件。
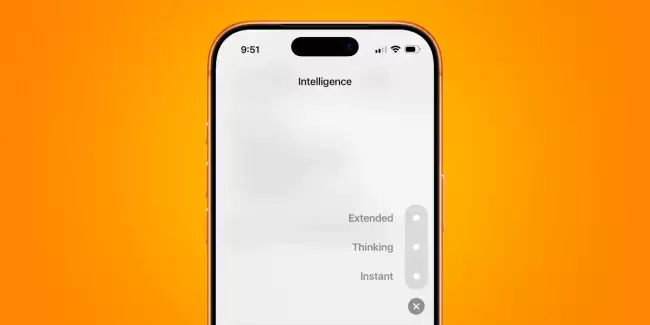
OpenAI在移动端ChatGPT中新增了智能等级选择器,用户长按发送箭头即可调出,并提供即时、思考、扩展三种推理模式;网页版则增加了长对话目录功能,当回复数达到五条时,用户可通过目录快速跳转;此外,GPT-5.5即时模型的更新,使得回答更加自然流畅。
开源库TanStack遭网络攻击波及OpenAI内部设备。黑客窃取了可签署数字证书的凭证,但核心代码与用户数据未泄露。OpenAI已撤销相关证书,并要求Mac用户在6月12日前将ChatGPT应用更新至最新版本,否则旧版将无法使用。iOS与Windows版本不受影响。
消息称苹果拆解谷歌 Gemini 模型,为 iPhone 17 等打造专属本地 AI 一则新动态,揭示了科技巨头在AI赛道的最新布局。根据科技媒体The Information于3月25日的报道,苹果公司正在采取一种相当深入的技术策略,为其未来的iPhone 17系列等设备打造更小巧、安全的端侧AI
全球最顶尖的 AI 学术会议,正在被 AI “攻陷” 这事儿听起来像个地狱笑话,但很不幸,它正在成为现实。一组最新数据揭示了一个颇为讽刺的局面:在即将到来的 ICLR 2026 会议上,竟有超过1.5 万份审稿意见被判定完全由 AI 代写。 想象一下这个场景:你耗费心血完成的论文,审稿人或许压根没细
本站7月14日消息,OpenAI因涉嫌使用限制性保密协议(NDA)限制员工发声而再次受到审查。据《华盛顿邮报》报道,举报人致信美国证券交易委员会,称OpenAI强迫员工签署“非法限制性”协议,阻止他们披露公司技术潜在的危害。该举报信指控OpenAI违反了美国证券交易委员会的规定,该规定旨在保护员工向联邦当局举报其疑虑的权利并防止报复行为。此前,举报人已于6月份正式向美国证券交易委员会提交了投诉。图源Pexels举报信中要求美国证券交易委员会“采取迅速果断的措施”来执行他们认为OpenAI已经违反的规定。涉
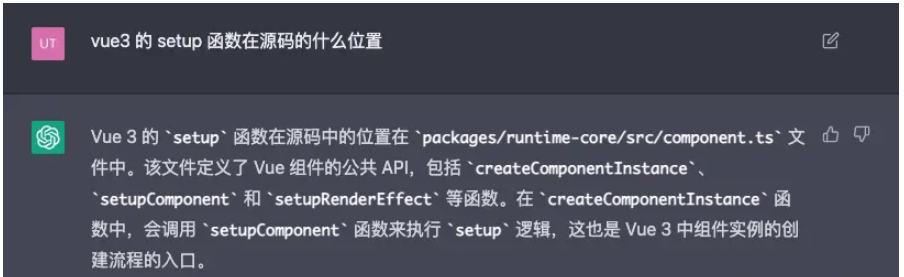
实战setupsetup函数在什么位置呢,我们不知道他的实现函数名称,于是问一下ChatGPT:ChatGPT告诉我,setup函数在packages/runtime-core/src/component.ts文件中。众所周知,runtime-core是Vue3的运行时核心代码。我们进去看一眼。按照它所说的,我们找到了setupComponent和createComponentInstance函数,并没有找到setupRenderEffect函数,ChatGPT的只知道2021年以前的知识,Vue3代码经
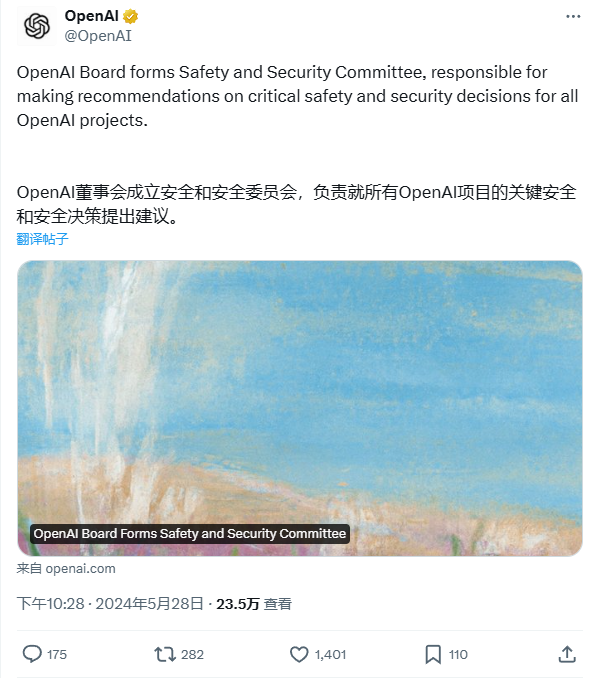
本网站5月29日消息,OpenAI宣布成立安全与安保委员会,负责就OpenAI项目和运营的关键安全与保障决策提出建议。该委员会目前首要任务是在未来90天内评估并进一步制定OpenAI的发展流程和保障措施。90天结束后,安全与保障委员会将与全体董事会分享其建议。据介绍,该委员会将由董事会BretTaylor(主席)、AdamD'Angelo、NicoleSeligman和OpenAI首席执行官SamAltman领导。除此之外,OpenAI技术和政策专家AleksanderMadry(准备工作主管)、Lili

共识首先要明确一点,chatgpt返回的文本格式是markdown的,最基本的渲染方式就是把markdown文本转换为HTML文本,然后v-html渲染即可。这里的转换和代码高亮以及防XSS攻击用到了下面三个依赖库:marked将markdwon转为htmlhighlight处理代码高亮dompurify防止XSS攻击同时我们是可以在markdown中写html元素的,这意味着我们可以直接把光标元素放到最后!将markdown转为html并处理代码高亮先贴代码MarkdownRender.vueimpor
12月20日,在OpenAI举办的"12DaysofOpenAI"活动进入尾声之际,公司重点展示了ChatGPT桌面版的重大功能改进。这一升级意味着ChatGPT从简单的聊天机器人向高效AI智能体工具的转型,旨在提升在桌面环境中的任务执行和协作能力。活动宣布,ChatGPT新增支持包括AppleNotes、Notion、Warp、Xcode在内的30多个应用程序。例如,在与Notion应用程序的协同演示中,ChatGPT展示了提取文档选定部分内容并生成相关内容的能力。此外,ChatGPT还展示了其在War
本站11月29日消息,有知情人士告诉路透社,虽然正面临重组,但OpenAI预计不会向微软等其他投资者提供董事会席位,包括KhoslaVentures和ThriveCapital。微软目前是OpenAI的最大支持者之一,承诺向该公司投资数十亿美元。值得一提的是,图源Pexels在上周的动荡中,OpenAI突然解雇了其首席执行官兼创始人SamAltman,而没有给出具体原因。然而,在三天后,OpenAI又宣布重新聘请Altman,并承诺将组建新的董事会。详细信息请参阅本站之前的报道TheInformation





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



