

如何正确定义测试阶段训练?顺序推理和域适应聚类方法
域适应是解决迁移学习的重要方法,当前域适应当法依赖原域和目标域数据进行同步训练。当源域数据不可得,同时目标域数据不完全可见时,测试阶段训练(Test-TimeTraining)成为新的域适应方法。当前针对Test-TimeTraining(TTT)的研究广泛利用了自监督学习、对比学习、自训练等方法,然而,如何定义真实环境下的TTT却被经常忽略,以至于不同方法间缺乏可比性。近日,华南理工、A*STAR团队和鹏城实验室联合提出了针对TTT问题的系统性分类准则,通过区分方法是否具备顺序推理能力
域适应是解决迁移学习的重要方法,当前域适应当法依赖原域和目标域数据进行同步训练。当源域数据不可得,同时目标域数据不完全可见时,测试阶段训练(Test- Time Training)成为新的域适应方法。当前针对 Test-Time Training(TTT)的研究广泛利用了自监督学习、对比学习、自训练等方法,然而,如何定义真实环境下的 TTT 却被经常忽略,以至于不同方法间缺乏可比性。
近日,华南理工、A*STAR 团队和鹏城实验室联合提出了针对 TTT 问题的系统性分类准则,通过区分方法是否具备顺序推理能力(Sequential Inference)和是否需要修改源域训练目标,对当前方法做了详细分类。同时,提出了基于目标域数据定锚聚类(Anchored Clustering)的方法,在多种 TTT 分类下取得了最高的分类准确率,本文对 TTT 的后续研究指明了正确的方向,避免了实验设置混淆带来的结果不可比问题。研究论文已被 NeurIPS 2022 接收。
- 论文:https://arxiv.org/abs/2206.02721
- 代码:https://github.com/Gorilla-Lab-SCUT/TTAC
一、引言
深度学习的成功主要归功于大量的标注数据和训练集与测试集独立同分布的假设。在一般情况下,需要在合成数据上训练,然后在真实数据上测试时,以上假设就没办法满足,这也被称为域偏移。为了缓解这个问题,域适应 (Domain Adaptation, DA) 诞生了。现有的 DA 工作要么需要在训练期间访问源域和目标域的数据,要么同时在多个域进行训练。前者需要模型在做适应 (Adaptation) 训练期间总是能访问到源域数据,而后者需要更加昂贵的计算量。为了降低对源域数据的依赖,由于隐私问题或者存储开销不能访问源域数据,无需源域数据的域适应 (Source-Free Domain Adaptation, SFDA) 解决无法访问源域数据的域适应问题。作者发现 SFDA 需要在整个目标数据集上训练多个轮次才能达到收敛,在面对流式数据需要及时做出推断预测的时候 SFDA 无法解决此类问题。这种面对流式数据需要及时适应并做出推断预测的更现实的设定,被称为测试时训练 (Test-Time Training, TTT) 或测试时适应(Test-Time Adaptation, TTA)。
作者注意到在社区里对 TTT 的定义存在混乱从而导致比较的不公平。论文以两个关键的因素对现有的 TTT 方法进行分类:
- 对于数据是流式出现的并需要对当前出现的数据作出及时预测的,称之为单轮适应协议(One-Pass Adaptation);对于其他不符合以上设定的称为多轮适应协议(Multi-Pass Adaptation),模型可能需要在整个测试集上进行多轮次的更新后,再进行从头到尾的推断预测。
- 根据是否需要修改源域的训练损失方程,比如引入额外的自监督分支以达到更有效的 TTT。
这篇论文的目标是解决最现实和最具挑战性的 TTT 协议,即单轮适应并无需修改训练损失方程。这个设定类似于 TENT[1]提出的 TTA,但不限于使用来自源域的轻量级信息,如特征的统计量。鉴于 TTT 在测试时高效适应的目标,该假设在计算上是高效的,并大大提高了 TTT 的性能。作者将这个新的 TTT 协议命名为顺序测试时训练(sequential Test Time Training, sTTT)。
除了以上对不同 TTT 方法的分类外,论文还提出了两个技术让 sTTT 更加有效和准确:
- 论文提出了测试时锚定聚类 (Test-Time Anchored Clustering, TTAC) 方法。
- 为了降低错误伪标签对聚类更新的影响,论文根据网络对样本的预测稳定性和自信度对伪标签进行过滤。
二、方法介绍
论文分了四部分来阐述所提出的方法,分别是 1)介绍测试时训练 (TTT) 的锚定聚类模块,如图 1 中的 Anchored Clustering 部分;2)介绍用于过滤伪标签的一些策略,如图 1 中的 Pseudo Label Filter 部分;3)不同于 TTT++[2]中的使用 L2 距离来衡量两个分布的距离,作者使用了 KL 散度来度量两个全局特征分布间的距离;4)介绍在测试时训练 (TTT) 过程的特征统计量的有效更新迭代方法。最后第五小节给出了整个算法的过程代码。
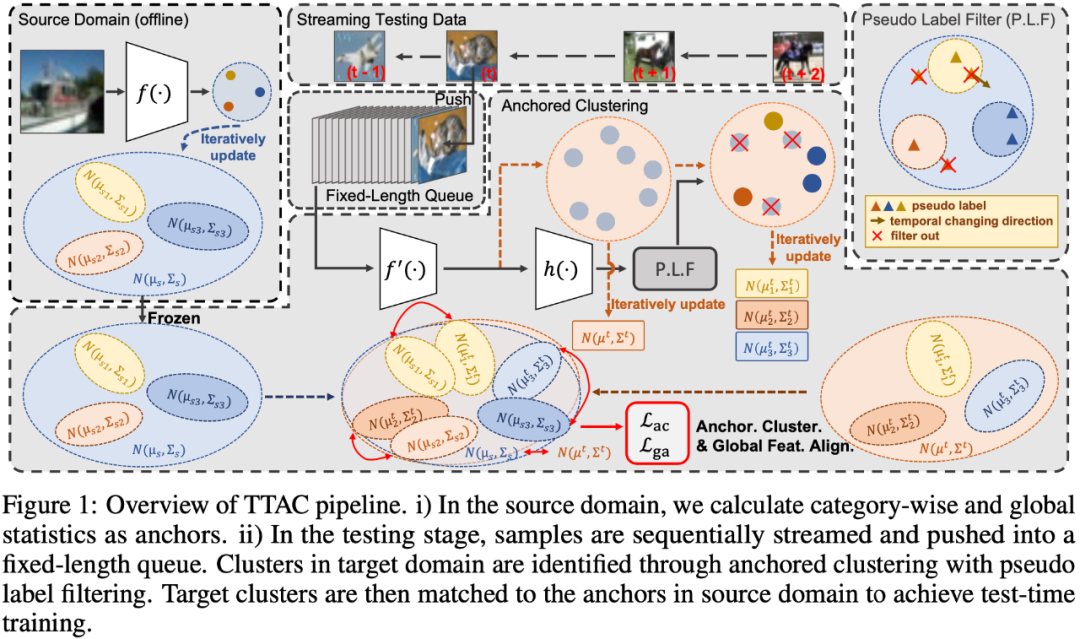
第一部分 在锚定聚类里,作者首先使用混合高斯对目标域的特征进行建模,其中每个高斯分量代表一个被发现的聚类。然后,作者使用源域中每个类别的分布作为目标域分布的锚点来进行匹配。通过这种方式,测试数据特征可以同时形成集群,并且集群与源域类别相关联,从而达到了对目标域的推广。概述来说就是,将源域和目标域的特征分别根据类别信息建模成:
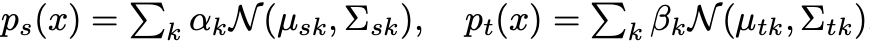
然后通过 KL 散度度量两个混合高斯分布的距离,并通过减少 KL 散度来达到两个域特征的匹配。可是,在两个混合高斯分布上直接求解 KL 散度并没有闭式解,这导致了无法使用有效的梯度优化方法。在这篇论文中,作者在源域和目标域中分配相同数量的集群,每个目标域集群被分配给一个源域集群,这样就可以将整个混合高斯的 KL 散度求解变成了各对高斯之间的 KL 散度之和。如下式:
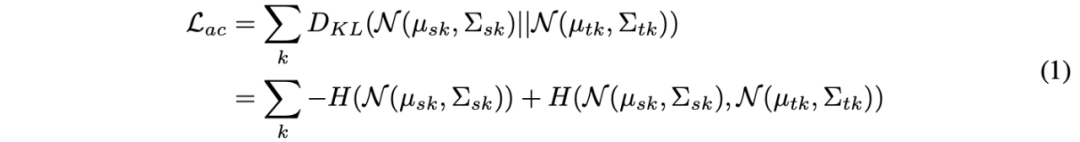
上式的闭式解形式为:
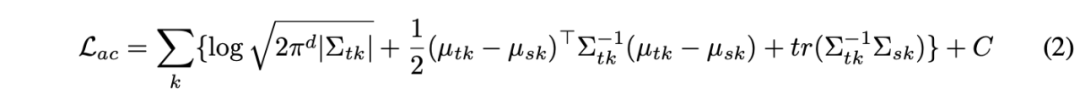
在公式 2 中,源域集群的参数可以线下收集完,而且由于只用到了轻量化统计数据,所以不会导致隐私泄漏问题且只使用了少量的计算和存储开销。对于目标域的变量,涉及到了伪标签的使用,作者为此设计了一套有效的且轻量的伪标签过滤策略。
第二部分 伪标签过滤的策略主要分为两部分:
1)时序上一致性预测的过滤:
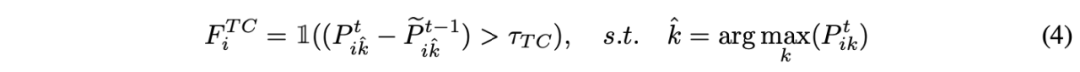
2)根据后验概率的过滤:
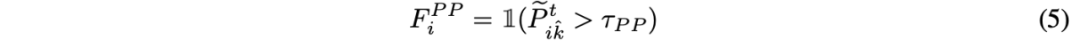
最后,使用过滤后的样本来求解目标域集群的统计量:
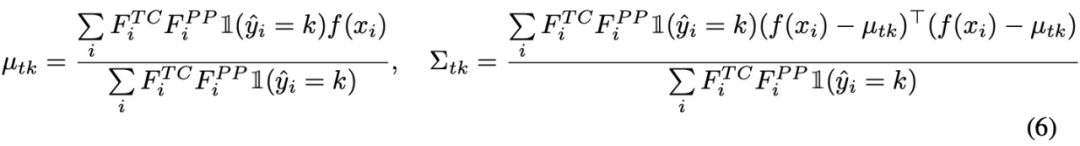
第三部分 由于在锚定聚类中,部分被滤除的样本并没有参与目标域的估计。作者还对所有测试样本进行全局特征对齐,类似锚定聚类中对集群的做法,这里将所有样本看作一个整体的集群,在源域和目标域分别定义
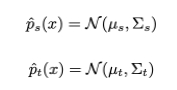
然后再次以最小化 KL 散度为目标对齐全局特征分布:
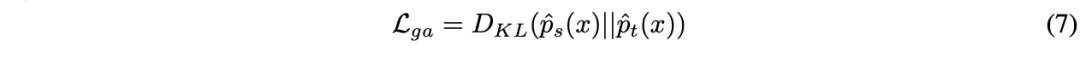
第四部分 以上三部分都在介绍一些域对齐的手段,但在 TTT 过程中,想要估计一个目标域的分布是不简单的,因为我们无法观测整个目标域的数据。在前沿的工作中,TTT++[2]使用了一个特征队列来存储过去的部分样本,来计算一个局部分布来估计整体分布。但这样不但带来了内存开销还导致了精度与内存之间的 trade off。在这篇论文中,作者提出了迭代更新统计量的方式来缓解内存开销。具体的迭代更新式子如下:
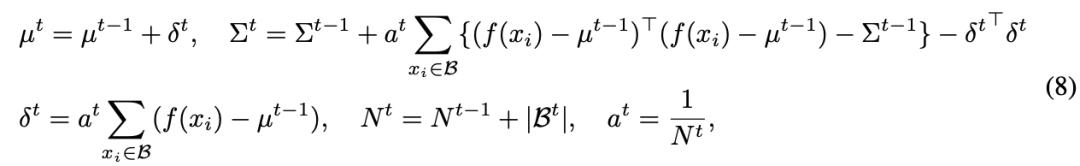
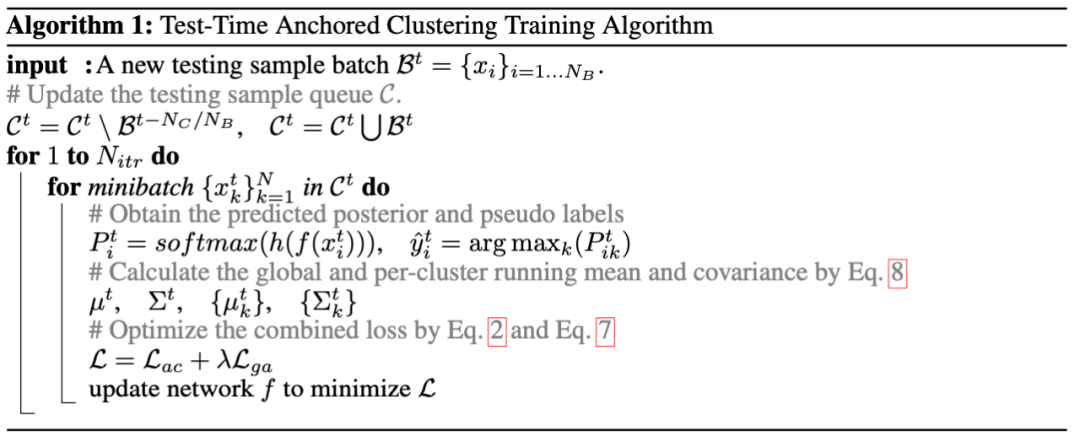
总的来说,整个算法如下算法 1 所示:
三、实验结果
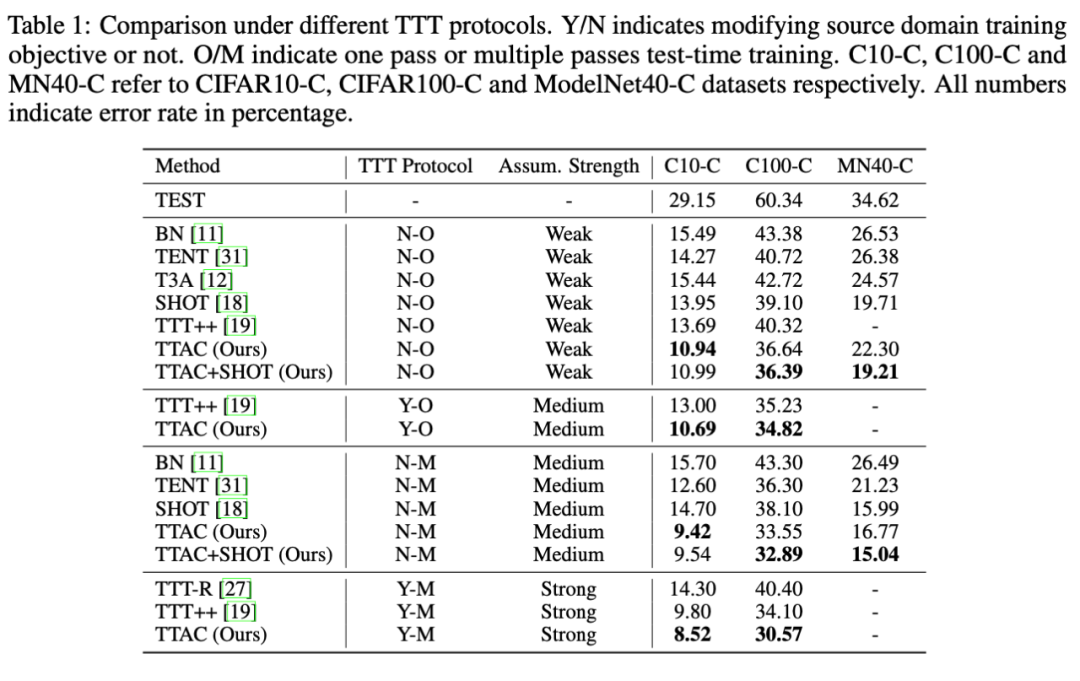
正如引言部分所说,这篇论文中作者非常注重不同 TTT 策略下的不同方法的公平比较。作者将所有 TTT 方法根据以下两个关键因素来分类:1)是否单轮适应协议 (One-Pass Adaptation) 和 2)修改源域的训练损失方程,分别记为 Y/N 表示需要或不需要修改源域训练方程,O/M 表示单轮适应或多轮适应。除此之外,作者在 6 个基准的数据集上进行了充分的对比实验和一些进一步的分析。
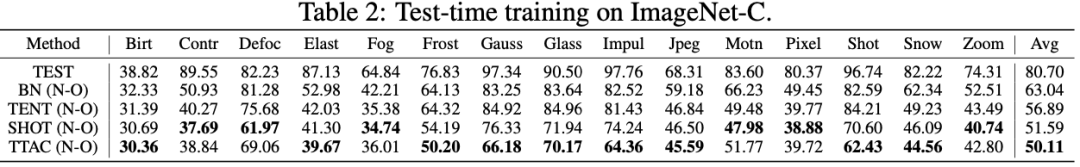
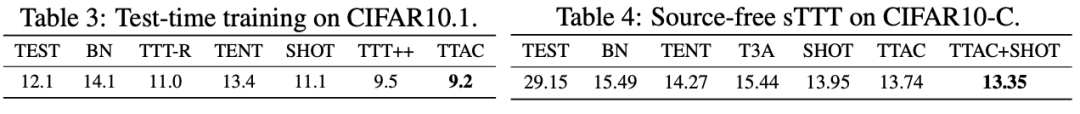
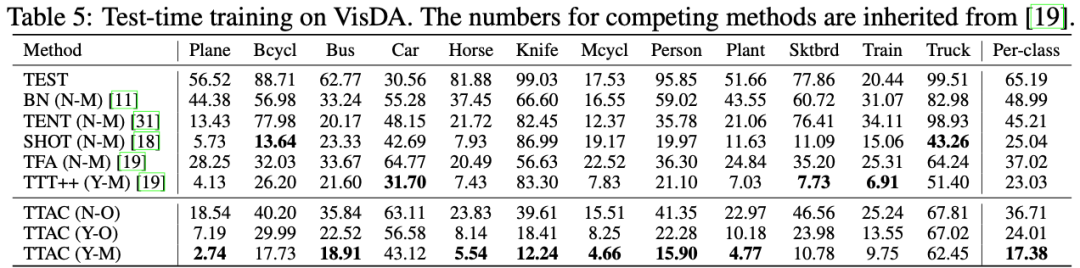
如表一所示,TTT++[2]同时出现在了 N-O 和 Y-O 的协议下,是因为 TTT++[2]拥有一个额外的自监督分支,我们在 N-O 协议下将不添加自监督分支的损失,而在 Y-O 下可以正常使用此分子的损失。TTAC 在 Y-O 下也是使用了跟 TTT++[2]一样的自监督分支。从表中可以看到,在所有的 TTT 协议下所有数据集下,TTAC 均取得到最优的结果;在 CIFAR10-C 和 CIFAR100-C 数据集上,TTAC 都取得了 3% 以上的提升。从表 2 - 表 5 分别是 ImageNet-C、CIFAR10.1、VisDA 上的数据,TTAC 均取到了最优的结果。
此外,作者在多个 TTT 协议下同时做了严格的消融实验,清晰地看出了每个部件的作用,如表 6 所示。首先从 L2 Dist 和 KLD 的对比中,可以看出使用 KL 散度来衡量两个分布具有更优的效果;其次,发现如果单单使用 Anchored Clustering 或单独使用伪标签监督提升只有 14%,但如果结合了 Anchored Cluster 和 Pseudo Label Filter 就可以看到性能显著提高 29.15% -> 11.33%。这也可以看出每个部件的必要性和有效的结合。
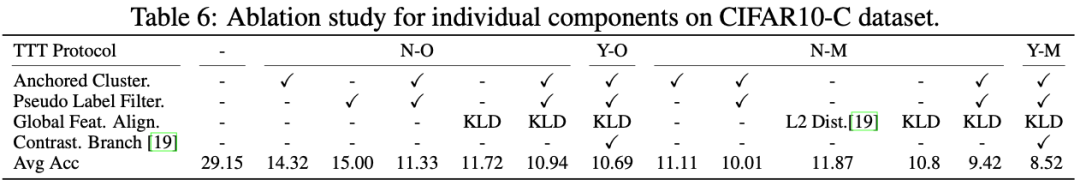
最后,作者在正文的尾部从五个维度对 TTAC 展开了充分的分析,分别是 sTTT (N-O)下的累计表现、TTAC 特征的 TSNE 可视化、源域无关的 TTT 分析、测试样本队列和更新轮次的分析、以 wall-clock 时间度量计算开销。还有更多有趣的证明和分析会展示在文章的附录中。
四、总结
本文只是粗糙地介绍了 TTAC 这篇工作的贡献点:对已有 TTT 方法的分类比较、提出的方法、以及各个 TTT 协议分类下的实验。论文和附录中会有更加详细的讨论和分析。我们希望这项工作能够为 TTT 方法提供一个公平的基准,未来的研究应该在各自的协议内进行比较。
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
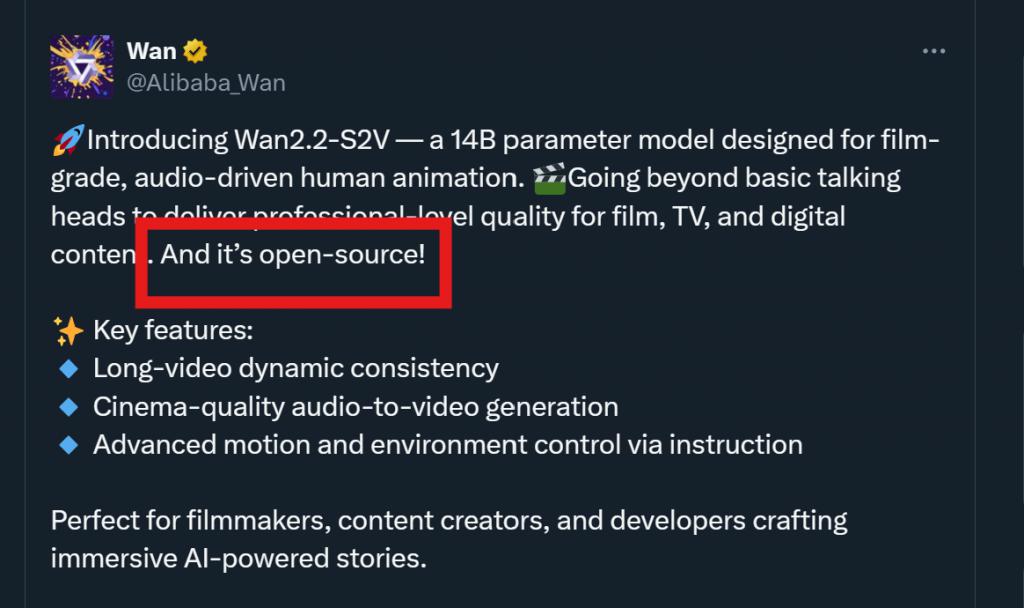
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
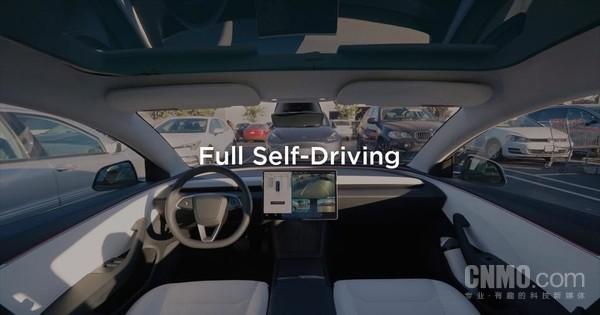
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限
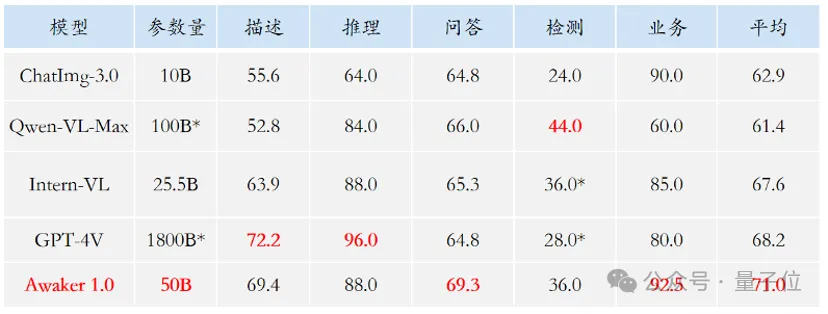
哭死啊,全球狂炼大模型,一互联网的数据不够用,根本不够用。训练模型搞得跟《饥饿游戏》似的,全球AI研究者,都在苦恼怎么才能喂饱这群数据大胃王。尤其在多模态任务中,这一问题尤为突出。一筹莫展之际,来自人大系的初创团队,用自家的新模型,率先在国内把“模型生成数据自己喂自己”变成了现实。而且还是理解侧和生成侧双管齐下,两侧都能生成高质量、多模态的新数据,对模型本身进行数据反哺。模型是啥?中关村论坛上刚刚露面的多模态大模型Awaker1.0。团队是谁?智子引擎。由人大高瓴人工智能学院博士生高一钊创立,高瓴人工智能
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



