

人工智能如何让硬件发展的更好

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
多年来,计算机硬件一直是一个不太活跃的市场。占主导地位的x86微处理器架构已经达到了通过小型化可以实现的性能增益的极限,因此制造商主要关注将更多的内核封装到芯片中。对于快速发展的机器学习和深度学习来说,GPU就是救星。GPU最初是为图形处理设计的,它可以有数千个小内核,非常适合AI训练所需的并行处理能力。人工智能的本质是得益于并行处理,大约10年前,人们发现,设计用于在屏幕上显示像素的GPU很适合这一点,因为它们是并行处理引擎,可以在其中放入很多核心。这对英伟达公司来说是个好消息,该企业的市值从2015年
多年来,计算机硬件一直是一个不太活跃的市场。占主导地位的x86微处理器架构已经达到了通过小型化可以实现的性能增益的极限,因此制造商主要关注将更多的内核封装到芯片中。
对于快速发展的机器学习和深度学习来说,GPU就是救星。GPU最初是为图形处理设计的,它可以有数千个小内核,非常适合AI训练所需的并行处理能力。
人工智能的本质是得益于并行处理,大约10年前,人们发现,设计用于在屏幕上显示像素的GPU很适合这一点,因为它们是并行处理引擎,可以在其中放入很多核心。
这对英伟达公司来说是个好消息,该企业的市值从2015年的不到180亿美元飙升至去年市场收缩之前的7350亿美元。直到最近,该企业还几乎独揽了整个市场。但许多竞争对手正试图改变这种局面。
在人工智能工作负载方面,到目前为止主要是英伟达的GPU,但用户正在寻找可以将其提升到新水平的技术,随着高性能计算和AI工作负载的不断融合,我们将会看到更多种类的加速器出现。
加速推动新型硬件的发展
大型芯片制造商并没有停滞不前。三年前,英特尔收购了以色列芯片制造商哈瓦那实验室,并让这家企业成为其人工智能开发工作的重点。
哈瓦那去年春天推出的Gaudi2训练优化处理器和Greco推理处理器,据称速度至少是英伟达旗舰处理器A100的两倍。
今年3月,英伟达推出了拥有800亿个晶体管的H100加速器GPU,并支持该公司的高速NVLink互连。它具有一个专用引擎,与上一代相比,它可以将自然语言处理中,使用的基于Transformer的模型的执行速度提高六倍。最近使用MLPerf基准的测试显示,在大多数深度学习测试中,H100优于Gaudi2。英伟达也被认为在其软件堆栈中具有优势。
许多用户选择GPU,因为他们可以进入集中式软件的生态系统,英伟达之所以如此成功,是因为他们建立了生态系统战略。
超规模云计算公司甚至比芯片制造商更早进入这一领域。谷歌有限责任公司的Tensor处理单元是一种专用集成电路,于2016年推出,目前已经是第四代。亚马逊网络服务公司在2018年推出了面向机器学习的推理处理加速器,声称其性能是GPU加速实例的两倍多。
上个月,该公司宣布了基于其Trainium芯片的云实例的普遍可用性,称在深度学习模型训练场景中,以可比的性能,它们的成本比基于GPU的EC2低50%。两家企业的努力主要集中在通过云服务交付。
虽然成熟的市场领导者专注于增量改进,但许多更有趣的创新正在构建AI专用硬件的初创企业中进行。根据数据显示,在去年投资于芯片初创公司的18亿美元风险投资家中,他们吸引了大部分的投资,是2017年的两倍多。
他们正在追逐一个可能带来巨大收益的市场,预计到2030年,全球人工智能芯片市场将从2020年的80亿美元增长到近1950亿美元。
更小、更快、更便宜
很少有初创公司想要取代x86CPU,但这是因为这样做的杠杆相对较小。芯片不再是瓶颈,不同芯片之间的通信才是一个巨大的瓶颈。
CPU执行低级操作,如管理文件和分配任务,但纯粹的CPU专用方法不再适用于扩展,CPU设计用于从打开文件到管理内存缓存的各种活动,必须是通用的。这意味着它不太适合人工智能模型训练所需的大规模并行矩阵算术运算。
市场上的大多数活动都围绕着协处理器加速器、专用集成电路,以及在较小程度上可以针对特定用途进行微调的现场可编程门阵列。
每个人都在遵循谷歌的说法,即开发协同处理器,与CPU协同工作,通过将算法硬编码到处理器中,而不是作为软件运行,来针对AI工作量的特定部分。
加速度方程
加速度方程用于开发所谓的图形流处理器,用于自动驾驶汽车和视频监控等边缘计算场景。完全可编程芯片组承担了CPU的许多功能,但在任务级并行和流执行处理方面进行了优化,仅使用7瓦的电源。
体系结构基于图数据结构,其中对象之间的关系表示为连接的节点和边。每个机器学习框架都使用图形概念,在整个芯片的设计中都保持着同样的语义。可以执行包括CMM但包含自定义节点的整个图。我们可以在这些图形中加速任何平行的东西。
其基于图形的架构解决了GPU和CPU的一些容量限制,并能更灵活地适应不同类型的AI任务。它还允许开发人员将更多的处理转移到边缘,以便更好地推断。如果企业能对80%的处理过程进行预处理,就能节省大量时间和成本。
这些应用可以让智能更接近数据,实现快速决策。大多数的目标是推断,这是AI模型的现场部署,而不是更计算密集型的训练任务。
某企业正在开发一种使用内存计算的芯片,以减少延迟和对外置存储设备的需求。其人工智能平台将提供灵活性和运行多个神经网络的能力,同时保持较高的准确性。
其数据处理单元系列为大规模并行处理器阵列,拥有可伸缩的80核处理器,能够并行执行数十个任务。关键创新是在每个处理元素内部紧密集成一个张量协处理器,并支持元素之间的直接张量数据交换,以避免内存带宽瓶颈。这可以实现高效的AI应用加速,因为预处理和后处理是在相同的处理元素上执行的。
而有些企业专注于利用缩略图大小的芯片组推断深度学习模型,该企业称该芯片组每秒可以执行26万亿次操作,而消耗的电力不到3瓦。在某种程度上,它是通过将用于训练深度学习模型的每个网络层分解为所需的计算元素,并将它们整合在一个专门为深度学习构建的芯片上实现的。
板载内存的使用进一步减少了开销,整个网络都在芯片内部,更没有外部存储器,这意味着芯片可以更小,消耗更少的能量。该芯片可以在接近实时的高清图像上运行深度学习模型,使单个设备能够同时在四条车道上运行自动车牌识别。
硬件目前的发展
一些初创企业采取的更多的是登月的方法,旨在重新定义人工智能模型训练和运行的整个平台。
例如,针对机器学习进行了优化的人工智能处理器,在接近9,000个并发线程和900兆处理器内内存的情况下,每秒可以管理高达350万亿次处理操作。综合计算系统被称为Bow-2000IPU机器,据称可以每秒进行1.4千万亿次运算。
其不同之处在于其三维堆叠晶片设计,使其能够在一个芯片中封装近1500个并行处理核。所有这些企业都能够运行完全不同的业务。这与广泛使用的GPU架构不同,后者更倾向于对大数据块运行相同的操作。
再比如,有些企业正在解决互连问题,也就是集成电路中连接元件之间的布线。随着处理器达到理论上的最高速度,移动比特的路径越来越成为瓶颈,特别是当多个处理器同时访问内存时,如今的芯片不再是互连的瓶颈。
该芯片在一个人工智能平台中使用纳米光子波导,该平台称其在低能量封装中结合了高速和大带宽。它本质上是一个光通信层,可以连接多个其他处理器和加速器。
人工智能结果的质量来自于同时支持非常庞大和复杂的模型的能力,同时实现非常高的吞吐量响应,这两者都是可以实现的。这适用于任何可以使用线性代数完成的操作,包括大多数人工智能的应用。
人们对其集成硬件和软件平台的期望极高。而企业则抓住了这一要点,例如研发平台可以在从数据中心到边缘的任何地方,运行人工智能和其他数据密集型应用。
而硬件平台使用专为机器和深度学习设计的定制7纳米芯片。其可重新配置的数据流架构运行AI优化的软件堆栈,其硬件架构旨在最小化内存访问,从而减少互连瓶颈。
处理器更是可以重新配置,以适应AI或高性能计算HPC工作负载,处理器被设计为以更高的性能水平处理大规模矩阵操作,这对工作量变化的客户来说是一个加分项。
虽然CPU、GPU甚至FPGA都非常适合于事务系统和ERP等确定性软件,但是,机器学习算法是概率的,这意味着结果是不提前知道的,这需要一种完全不同的硬件基础设施。
平台通过将1tb的高速双数据速率同步存储器连接到处理器上,最大限度地减少了互连问题,基本上可以用快20倍的片上存储器来掩盖DDR控制器的延迟,所以这对用户来说是透明的,这使我们能够训练更高参数计数的语言模型和最高分辨率的图像,而无需平铺或下采样。
平铺是一种用于图像分析的技术,它通过将图像分割成更小的块,分析每个块,然后重新组合,来减少对计算能力的需求。下采样在训练数据的随机子集上训练模型,以节省时间和计算资源。其结果是一个系统,不仅比基于GPU的系统更快,而且能够解决更大的问题。
总结
由于许多企业都在为同样的问题寻求解决方案,一场洗牌是不可避免的,但没有人预计这种洗牌会很快到来。GPU将存在很长一段时间,可能仍然是人工智能训练和推断项目中最具成本效益的解决方案,而这些项目不需要极端性能。
尽管如此,随着高端市场的模型越来越大、越来越复杂,对特定功能架构的需求也越来越大。从现在开始的三到五年内,我们可能会看到GPU和AI加速器的多样性,这是我们能够扩大规模以满足本十年结束及以后需求的唯一途径。
预计领先的芯片制造商将继续做他们擅长的事情,并逐步建立现有的技术。许多企业还将效仿英特尔,收购专注于人工智能的初创公司。高性能计算界也在关注人工智能的潜力,以帮助解决大规模模拟和气候建模等经典问题。
高性能计算生态系统总是在寻找他们可以吸收的新技术,以保持领先地位,他们正在探索人工智能能带来什么。而潜伏在幕后的是量子计算,这是一项仍停留在理论层面而非实际层面的技术,但它有可能彻底改变计算方式。
无论哪种新架构受到青睐,人工智能的激增无疑已经重新点燃了人们对硬件创新潜力的兴趣,从而开辟了软件领域的新领域。
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。

本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。

本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。
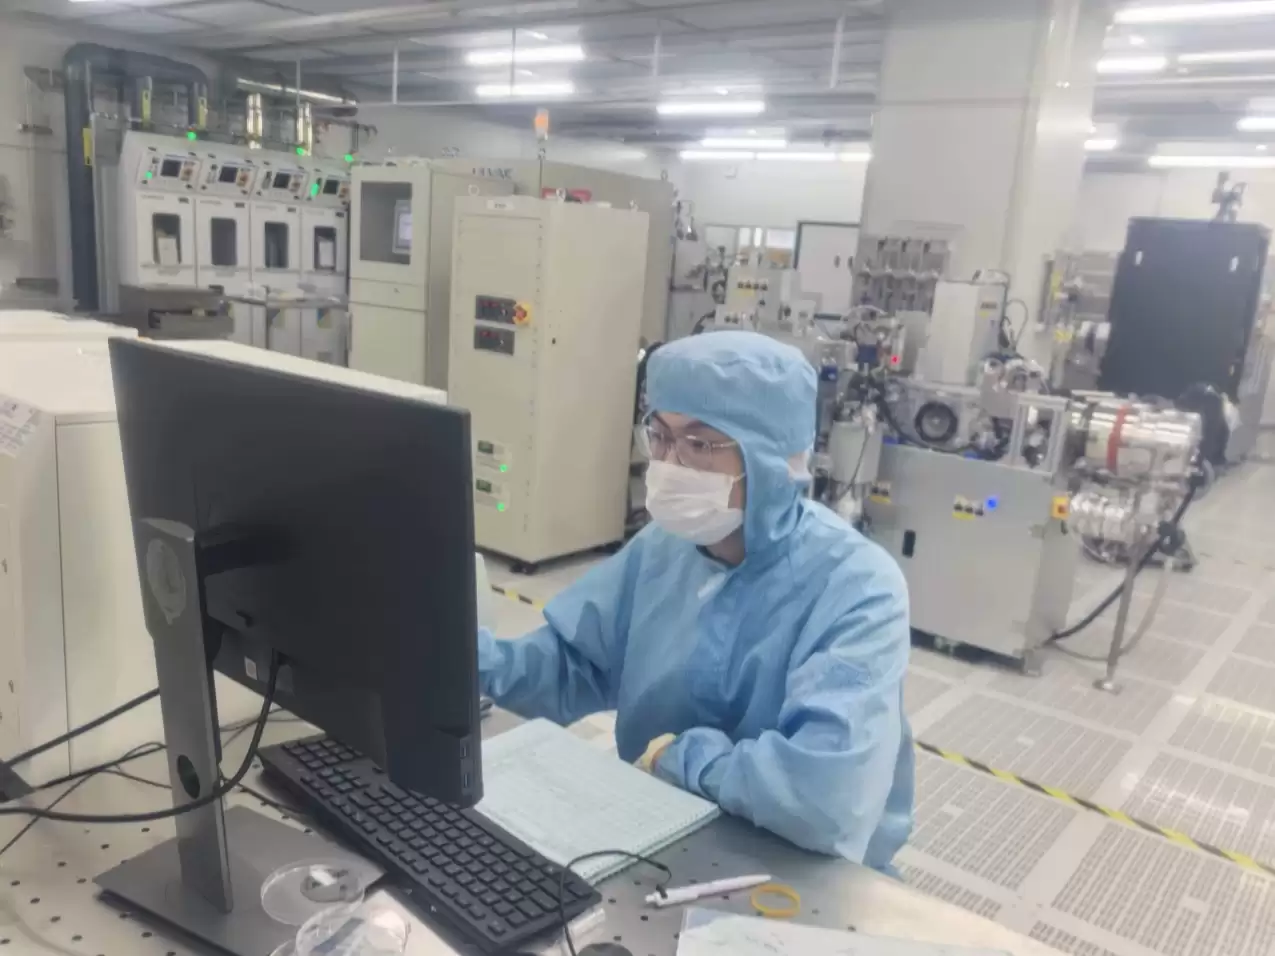
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。


苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。

从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



