

中国人民大学AI团队揭开大语言模型的隐藏秘密
一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。
这项由中国人民大学高瓴人工智能学院、联想集团与武汉大学联合开展的研究,以预印本形式于2026年6月发表,论文编号为arXiv:2606.07502,感兴趣的读者可以通过该编号查询完整论文。
当你用手机上的AI搜索“附近有什么好吃的川菜”时,AI需要先“读懂”你的这句话,然后在数以百万计的内容里找到和你问题最相关的结果。这个“读懂”的过程,在技术上叫做文本嵌入(text embedding)——把一段文字变成一串数字,数字之间的距离反映文字之间的语义相似程度。
大语言模型(Large Language Model,简称LLM),也就是ChatGPT、文心一言这类AI背后的核心技术,理论上应该非常擅长这件事。毕竟,它们读过互联网上几乎所有的文字,理解语言的能力令人叹为观止。然而,当研究人员真正测试这些模型在文本嵌入任务上的表现时,却发现了一个令人费解的现象:这些号称无所不能的大语言模型,在把文章“记成数字”这件事上,表现居然相当平庸。
这就好像一位博览群书、出口成章的学者,你让他帮你给图书馆里的书做分类标签,他却总是把各种书都贴上同样的标签——“的”、“了”、“是”——这些在任何书里都高频出现、却几乎毫无意义的词语。研究团队正是从这个奇怪的现象出发,展开了一场深入AI内部的“侦查”工作,最终不仅找到了问题的根源,还提出了一个简洁却有效的解决方案,命名为EmbedFilter。
一、为什么AI总是记住“的了是”,而不是真正的意思
要理解这个问题,先来了解一下大语言模型内部有一个叫做“反嵌入矩阵”(unembedding matrix)的零件。它的正常功能是:给模型一个思考状态(一串数字),它帮模型判断下一个词最可能是什么。打个比方,就像一个翻译官,把AI内心的“想法”翻译成我们能看懂的文字。
研究团队使用了一个叫做“逻辑透镜”(Logit Lens)的工具。原理很直接:把一段文字的嵌入表示(也就是那串代表文字含义的数字)丢给翻译官,看看翻译官觉得这段话“最像”在说哪个词。如果AI真的理解了文章的语义,翻译官应该能输出一些和文章内容相关的关键词。
然而,实验结果让研究人员大吃一惊。他们在三个主流大语言模型家族——阿里的Qwen、Meta的Llama以及Mistral——上分别测试,把同一段关于“逻辑透镜”工具本身介绍的英文文本输入模型,然后观察翻译官的输出。结果,三个模型不约而同地输出了大量毫无意义的高频词:引号、换行符、“the”、“is”、“and”……这些词在任何文本里都出现得极其频繁,但几乎不携带任何实质性的语义信息。
这意味着,模型保存下来的文字“印象”,并不是文章讲的是什么,而是文章“表面上用了哪些最常见的词”。好比,你请一个人帮你记住一首诗的含义,他却只记住了“诗里面用了很多‘的’字”。
更关键的是,这个现象在三个完全不同的模型家族里都出现了,说明这不是某一个模型的特殊毛病,而是大语言模型在设计上的一个普遍性问题。
二、问题的根源:AI内部的“平均脸陷阱”
找到了现象,研究团队开始追问:为什么会这样?他们的推理过程像是一步步拼图。
第一块拼图来自此前学术界已经观察到的一个现象:文本嵌入具有“各向异性”(anisotropy)。这个词听起来很专业,但背后的意思其实很好理解。假设嵌入空间是一个三维房间,所有文本的嵌入向量本来应该均匀分布在整个房间里,这样两段内容差异大的文字就会“站”在房间里相距很远的位置,内容相似的就“站”得很近。然而,实际观测发现,几乎所有文本的嵌入向量都挤在房间的一个狭小角落里。这意味着,随便找两段文字,它们的嵌入向量都非常相似——即便这两段文字讲的是完全不同的事情。
第二块拼图是:这个狭小角落的“中心点”是什么?研究团队猜测,这个中心点代表的是一个“平均词”——所有在训练数据里出现过的词,按照出现频率加权平均,得到的那个“最典型”的词的嵌入表示。
为了验证这个猜测,研究团队做了一件很有创意的事情:他们反向工程出了这个“平均词”的隐藏表示。具体做法是,从公开语料库RedPajama里统计出每个词的出现频率,然后利用反嵌入矩阵的数学性质(用了一种叫做摩尔-彭罗斯伪逆的数学工具),反推出一个能够产生这种频率分布的“假想隐藏状态”。这个假想隐藏状态,就是他们所说的“平均词的表示”。
有了这个“平均词”,他们就能更精确地研究:AI内部哪个部分负责把这种“平均词偏见”写进文本嵌入里。
三、发现“边缘频谱”:AI内部的高频词制造机
接下来是最关键的侦查步骤。研究团队使用了另一个工具,叫做“逻辑频谱分析”(Logit Spectroscopy)。
先解释一下什么是“频谱”。反嵌入矩阵是一个巨大的数学矩阵,可以用一种叫做奇异值分解(SVD)的技术把它拆解成一系列“方向”和对应的“重要程度”(奇异值)。这就好比把一首交响乐分解成不同乐器的声部:小提琴声部、大提琴声部、打击乐声部……每个声部对整体音效的贡献不同。
逻辑频谱分析做的事情是:逐一“静音”每一个声部(滤掉每一个方向的贡献),然后观察“平均词”的翻译结果发生了什么变化。如果静音某个声部之后,高频词的得分大幅下降,就说明那个声部是高频词偏见的主要来源。
实验结果非常清晰:在三个模型上,当研究团队静音频谱两端的声部时——也就是那些奇异值最大和最小的方向——高频词的得分急剧崩塌,受到的影响远超其他中间位置的声部。而当他们静音中间位置的声部时,高频词的得分几乎没有变化。
这个规律在Qwen、Llama、Mistral三个模型上表现一致,最大扰动可以达到20%以上。研究团队把这两端的频谱方向命名为“边缘频谱”(edge spectrum),因为它们处于整个频谱的两个边缘位置。
作为对照,研究团队还用同样的方法分析了低频词和随机采样词的情况。结果发现,低频词和随机词对边缘频谱的敏感度远比高频词低得多,这进一步确认了边缘频谱与高频词偏见之间的特异性关联。
换句话说,研究团队找到了那个“制造麻烦的零件”:反嵌入矩阵里处于频谱两端的那部分,负责把高频词的信息强行写进文本嵌入,干扰了真正的语义信号。
四、EmbedFilter:一把精准的“语义滤镜”
找到了问题的根源,解决方案就呼之欲出了。研究团队提出的EmbedFilter,原理可以用一个简单的生活比喻来理解。
假设你在拍一张风景照,但镜头上有几片灰尘,导致照片里出现了几个模糊的污点。与其重新买一个镜头或者重新拍摄,你可以用一块专门的擦镜布,把那几片灰尘擦掉,照片立刻就清晰了。EmbedFilter做的正是这件事:它是一块专门针对“边缘频谱灰尘”的擦镜布。
从数学层面说,EmbedFilter是一个线性变换(Bulk Spectrum Transformation,简称Φ)。它的做法是:从反嵌入矩阵的奇异值分解中,只保留中间那部分方向(去掉两端的边缘频谱),用这些“纯净”的中间方向重新构造一个投影矩阵,然后用这个矩阵对原始的文本嵌入进行过滤。
这个操作有几个值得注意的特点。第一,它完全不需要重新训练模型,也不需要任何额外的标注数据或校准数据集,所有需要的信息(也就是反嵌入矩阵本身)都已经存在于模型内部,拿来直接用就好。第二,计算量极小,相比于模型本身每秒处理的海量运算,这个过滤步骤几乎可以忽略不计。第三,这个方法是通用的,可以叠加在任何已有的文本嵌入提取方法之上,不限于特定的模型或提示工程策略。
研究团队还重新做了一遍逻辑透镜分析,这次用的是经过EmbedFilter处理后的嵌入表示。结果令人振奋:三个模型输出的高频词几乎完全消失,取而代之的是与输入文本真正相关的词汇。比如,对于那段关于“逻辑透镜”的测试文本,Llama模型过滤前输出的是“_the”、“,”、“_a”这类无意义词,过滤后输出的变成了“_activations”(激活值)、“_representations”(表示)、“_viewpoints”(视角)等与文章内容直接相关的词。这直观地证明,过滤掉边缘频谱之后,嵌入表示确实“看到”了更多真实的语义内容。
五、降维红利:更小、更快、更好
EmbedFilter还带来了一个意外的惊喜,那就是免费的维度压缩。
文本嵌入通常是高维度的向量,比如Llama-3.1-8B的嵌入维度是4096,意思是每段文字要用4096个数字来表示。维度越高,存储这些嵌入所需的空间越大,计算两段文字之间相似度的速度也越慢。对于需要处理数百万甚至数十亿条文本的实际应用来说,这是一笔相当可观的成本。
EmbedFilter的核心操作是从反嵌入矩阵的奇异向量中选取一个子集(去掉两端,只保留中间部分),然后把文本嵌入投影到这个子集所张成的空间里。由于这个子集的维度小于原始维度,投影后的向量自然就变短了。研究团队定义了一个参数τ来控制压缩比例:τ=2表示把维度压缩到原来的1/2,τ=4表示压缩到1/4,τ=8表示压缩到1/8。
更妙的是,这个降维操作在数学上是距离保持的(distance-preserving),也就是说,两段文字在原始高维空间里的相对远近关系,在压缩后的低维空间里依然保持不变。研究团队在论文附录中给出了严格的数学证明,其核心在于奇异向量矩阵是正交矩阵(各方向互相垂直、互不干扰),因此投影操作不会扭曲距离关系。换句话说,用压缩后的向量来判断文章相似度,理论上和用原始向量一样准确,但计算量和存储需求都大幅降低。
六、实验验证:在49项任务上全面碾压
研究团队在学术界通用的MTEB(Massive Text Embedding Benchmark,大规模文本嵌入基准测试)上进行了全面评估。这个基准包含49项不同的任务,涵盖语义相似度判断(STS)、文本分类(Classification)、聚类(Clustering)、配对分类(PairClassification)、重排序(Reranking)、检索(Retrieval)和摘要评分(Summarization)七大类。
实验在三个模型上进行:Qwen-2.5-0.5B(0.5亿参数的小模型)、Llama-3.1-8B-Instruct(80亿参数的中型模型)和Mistral-7B-Instruct-v0.3(70亿参数)。每个模型分别搭配两种主流的提示工程基线方法:PromptEOL(用“把这段话总结成一个词”的提示帮助模型压缩语义)和ECHO(通过重复输入文本让模型更好地捕捉语义)。
结果相当亮眼。以Qwen模型搭配ECHO为例,基线方法的MTEB综合得分是46.03分,加上EmbedFilter之后跃升至52.55分,提升幅度达到14.1%,这是全部实验配置中最大的单次提升。Llama搭配ECHO的配置从53.52分提升到57.70分,提升7.8%。Mistral搭配ECHO从53.21分提升到56.10分,提升5.4%。在所有49个测试配置中,加入EmbedFilter后的得分几乎清一色高于对应基线,体现出相当强的普适性。
当压缩比τ从2增大到4再到8时,性能确实有所下降,但下降幅度相当温和。以Llama搭配ECHO为例,τ=2时综合得分57.70,τ=4时57.32,τ=8时56.61——即便把维度压缩到原来的八分之一,性能依然显著优于未使用EmbedFilter的基线(53.52分)。这意味着,在实际部署中,可以用一个小得多的存储空间和快得多的检索速度,同时获得更好的语义表示质量。
研究团队还额外测试了EmbedFilter与更复杂的提示工程框架的兼容性。MetaEOL是一种需要借助大型商业语言模型生成多样化提示的方法,GenEOL则是利用模型的生成能力从不同角度改写原文再取平均嵌入的框架。EmbedFilter叠加在这两种方法上之后,同样带来了稳定的提升:MetaEOL搭配Qwen从52.23分提升到55.39分(+6.1%),搭配Llama从56.73分提升到58.79分(+3.6%);GenEOL的STS任务平均分从77.73分提升到78.39分。这说明EmbedFilter不是针对某一特定方法的特殊优化,而是一个真正通用的改进工具。
七、与其他方法的比较和消融实验
研究团队还仔细排查了EmbedFilter性能提升的真正来源,确保结论的可信度。
一个自然的质疑是:EmbedFilter的提升,会不会只是因为降低了维度,而不是因为滤掉了边缘频谱?为了排除这个可能,研究团队设计了两个对照实验:一是直接截取原始嵌入向量的前半部分(Truncation);二是随机选取一半维度(Random)。这两种方法同样降低了维度,但没有进行任何语义导向的过滤。结果发现,这两种方法的得分(49.13和49.27)不仅没有超过EmbedFilter(54.57),甚至比未降维的基线(50.07)还要低。这有力地证明,维度压缩本身不能带来性能提升,EmbedFilter的有效性确实来自于对边缘频谱的精准滤除。
研究团队还对比了只滤除奇异值最大方向(Dominant)、只滤除奇异值最小方向(Secondary)、只保留边缘频谱而滤除中间部分(Bulk,即EmbedFilter的反操作)这三种变体。结果显示,完整的EmbedFilter(同时滤除两端)得分最高(54.57),而Bulk变体(只保留两端)得分最低(47.13),比基线还差。这一对比既验证了边缘频谱确实是有害成分,也从反面证明了中间频谱才是真正承载语义的部分。值得注意的是,仅滤除奇异值最小方向(Secondary,53.19)的效果远好于仅滤除奇异值最大方向(Dominant,47.53),这与之前频谱分析中观察到的、小奇异值方向对高频词的影响更大的结论是一致的。
研究团队还设计了一个“理论上限”配置(Optimal):根据频谱分析的结果,找出对高频词影响最大的那些方向进行精准滤除。这个配置需要事先做频谱分析,实现上更复杂,但代表了该框架理论上能达到的最好效果。结果显示,Optimal配置的得分是54.19,而EmbedFilter(不需要任何额外分析,直接按频谱位置过滤)的得分是54.57,甚至略高于理论上限。这说明EmbedFilter在实践中的表现已经相当接近甚至超越了更复杂的精准方案。
另一个值得一提的对比是与BERT-whitening(白化处理)的比较。白化处理是学术界已有的一种解决嵌入各向异性问题的方法,原理是用一个校准数据集(通常是NLI自然语言推理数据集)来计算嵌入的统计特性,然后对嵌入进行标准化。白化处理同样支持降维,因此两者具有可比性。在相同的降维比例(τ=2,448维)下,EmbedFilter得分54.57,白化处理得分53.04。EmbedFilter不仅表现更好,而且完全不需要任何校准数据,这在实际应用中是一个相当大的优势——因为获取高质量的校准数据本身就需要成本。
研究团队还展示了EmbedFilter在维度压缩上的实用价值,将其与预LLM时代的经典嵌入模型进行对比。SimCSE(一种经过精心对比学习训练的BERT模型)在768维下的MTEB综合得分是53.54,coCondenser(专门为密集检索优化的模型)是55.48。而Llama搭配EmbedFilter,在512维(原始4096维的八分之一)下达到了56.61分或更高,用更小的存储空间超越了这些经过专门训练的专业嵌入模型。
说到底,这项研究做的事情可以用一句话概括:在AI的大脑里找到了那个专门“制造噪音”的零件,并设计了一把精准的手术刀把它的影响切除掉。切除之后,AI对文字含义的理解变得更清晰,存储和检索的效率也同步提升。
这对普通人意味着什么?当你在搜索引擎里输入一个问题,背后的AI如果用了这种技术,就能更准确地理解你真正想问的是什么,而不是被“的了是”这类无意义词所干扰;当你用AI整理大量文档时,文档分类会更精准;在语音助手、文档检索、问答系统等各种场景里,这种改进都可能带来看得见的效果提升。而且,由于存储空间需求降低了,这些能力也可以更容易地部署在手机等资源有限的设备上。
一个值得进一步思考的问题是:既然边缘频谱对语义表示有害,在未来训练新模型时,是否可以在训练阶段就主动抑制这种偏见,而不是等到使用时再后处理?研究团队在文中也表达了同样的期待,认为这一发现可以为未来更系统化的文本嵌入训练设计提供参考。此外,边缘频谱中两端不对称的影响(小奇异值端比大奇异值端更“有害”)背后的深层原因,也是研究团队留给未来工作的开放问题。有兴趣深入探索这些问题的读者,可以通过论文编号arXiv:2606.07502查阅完整的研究报告。
Q&A
Q1:大语言模型在文本嵌入任务上为什么表现不好?
A:大语言模型生成的文本嵌入向量存在“高频词偏见”问题:把一段文字的嵌入投影回词汇空间时,模型反映的不是文章讲了什么,而是文章里出现了哪些高频但无意义的词(如“the”、“,”、换行符等)。这种偏见导致不同文本的嵌入向量过于相似,无法有效区分语义差异。
Q2:EmbedFilter是怎么改善文本嵌入质量的?
A:EmbedFilter利用大语言模型内部已有的反嵌入矩阵(unembedding matrix),通过奇异值分解找出频谱两端(边缘频谱)的方向,这些方向被识别为高频词偏见的主要来源。EmbedFilter通过一个简单的线性变换,将文本嵌入投影到去掉两端后的中间频谱子空间,从而过滤掉高频词的干扰,提升语义表示质量,不需要任何重新训练或额外数据。
Q3:EmbedFilter降维后语义相似度的计算还准确吗?
A:准确。EmbedFilter的降维操作基于正交矩阵的投影,在数学上是距离保持变换,即两段文字在原始空间的相对距离关系在压缩后的空间里完全保留。实验也验证了这一点:维度压缩至原来的八分之一后,性能仍显著优于未使用EmbedFilter的基线模型。
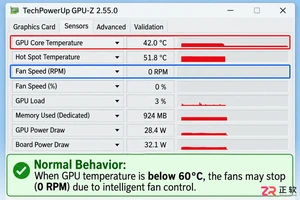
发现显卡风扇不转先别慌,这很可能是正常的智能启停功能。本文详解如何区分待机静音与硬件故障,提供从软件检测到物理清理的完整解决思路。
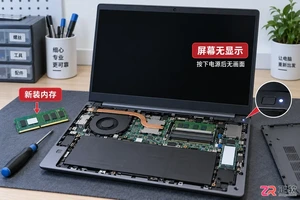
笔记本加装新内存后遇到黑屏或无法开机?不要慌张,本文通过重新插拔、清洁金手指、单根测试等具体操作步骤,帮你快速判断是安装失误还是硬件不兼容,并给出相应解决办法。
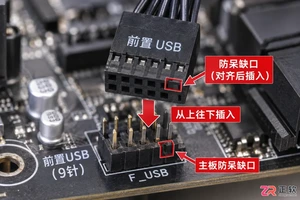
针对电脑主机前置USB接口无法识别设备的问题,本文提供一套基于因果逻辑的排查流程。涵盖检查机箱内部USB针脚连接、验证BIOS中USB控制器状态、更新芯片组驱动以及排除供电不足等常见原因,帮助用户快速恢复接口功能。
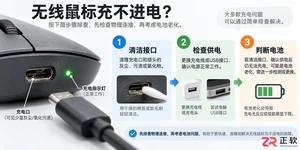
遇到无线鼠标充不进电的问题,不要急于更换设备。本文详解从清理接口氧化层、更换数据线到检测电池电压的完整排查流程,帮助你判断是临时故障还是硬件损坏。
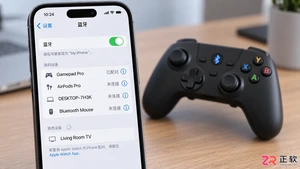
想知道如何用蓝牙手柄玩吃鸡游戏?本文详细讲解手机蓝牙手柄的连接步骤、主流映射软件的使用方法以及实战中的键位布局技巧,助你提升射击手感,同时解析外设玩家的匹配机制与注意事项。
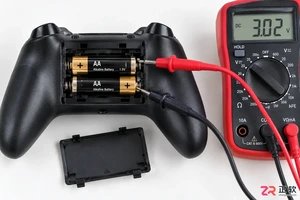
本文深入分析游戏手柄蓝牙频繁断开且需重连的根本原因,涵盖电池电压检测、操作系统电源管理策略及驱动冲突。通过具体的系统设置调整和固件更新步骤,解决蓝牙握手失败问题,恢复手柄的稳定连接状态。
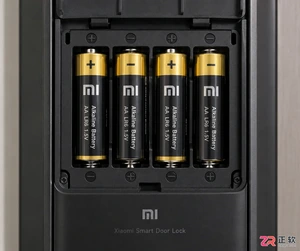
小米智能门锁更换新电池后无法开机或屏幕不亮?本文详解电池极性检查、金属触点清洁及强制重启方法,帮你快速解决供电问题,让门锁恢复正常使用。
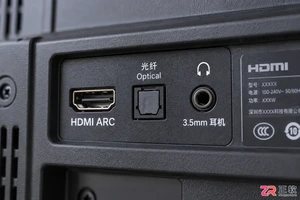
想让电视声音更震撼?本文详解如何通过HDMI ARC、光纤、蓝牙和3.5mm接口将电视连接至外置音响,包含具体设置步骤与常见问题排查,助你轻松打造家庭影院。


Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。
REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。
Ableton Live 是面向音乐制作人与现场表演者的数字音频工作站,提供编曲视图、独具特色的现场视图、音频录制、MIDI创作、实时变速、乐器及效果器。Mac版原生支持Apple芯片,并可连接音频接口、MIDI控制器和第三方插件。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。