

离视觉大一统更近一步:分割一切之后,Meta又开源一组多用途大模型
在开源了「分割一切」的SAM模型后,Meta在「视觉基础模型」的路上越走越远。这次,他们开源的是一组名叫DINOv2的模型。这些模型能产生高性能的视觉表征,无需微调就能用于分类、分割、图像检索、深度估计等下游任务。这组模型具有如下特征:使用自监督的方式进行训练,而不需要大量的标记数据;可以用作几乎所有CV任务的骨干,不需要微调,如图像分类、分割、图像检索和深度估计;直接从图像中学习特征,而不依赖文本描述,这可以使模型更好地理解局部信息;可以从任何图像集合中学习;DINOv2的预训练版本已经可用,并可以在一
在开源了「分割一切」的 SAM 模型后,Meta 在「视觉基础模型」的路上越走越远。
这次,他们开源的是一组名叫 DINOv2 的模型。这些模型能产生高性能的视觉表征,无需微调就能用于分类、分割、图像检索、深度估计等下游任务。
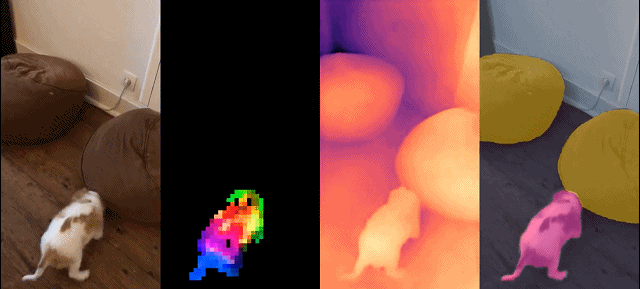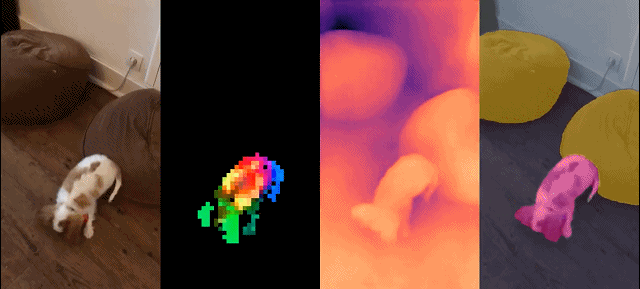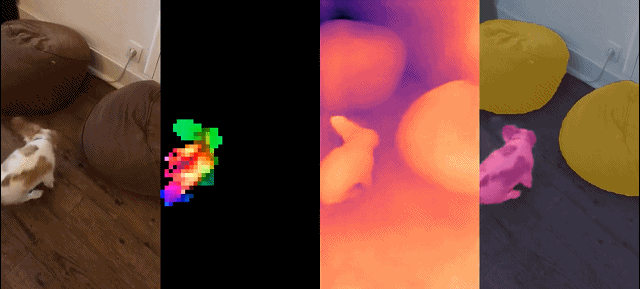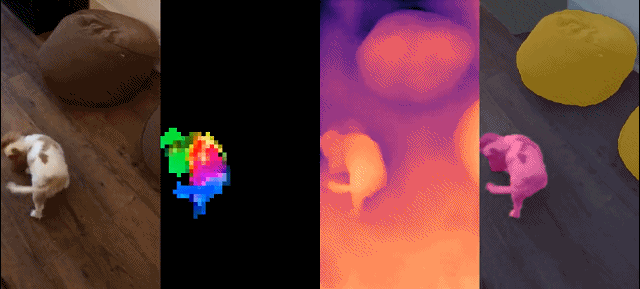
这组模型具有如下特征:
- 使用自监督的方式进行训练,而不需要大量的标记数据;
- 可以用作几乎所有 CV 任务的骨干,不需要微调,如图像分类、分割、图像检索和深度估计;
- 直接从图像中学习特征,而不依赖文本描述,这可以使模型更好地理解局部信息;
- 可以从任何图像集合中学习;
- DINOv2 的预训练版本已经可用,并可以在一系列任务上媲美 CLIP 和 OpenCLIP。
- 论文链接:https://arxiv.org/pdf/2304.07193.pdf
- 项目链接:https://dinov2.metademolab.com/
论文概览
学习非特定任务的预训练表示已成为自然语言处理的标准。大家可以「按原样」使用这些功能(无需微调),并且它们在下游任务上的表现明显优于特定任务模型的性能。这一成功得益于使用辅助目标对大量原始文本进行预训练,例如语言建模或词向量,这些不需要监督。
随着 NLP 领域发生这种范式转变,预计类似的「基础」模型将出现在计算机视觉中。这些模型应该生成在任何任务上「开箱即用」的视觉特征,无论是在图像级别(例如图像分类)还是像素级别(例如分割)。
这些基础模型有很大希望可以集中在文本引导(text-guided)的预训练上,即使用一种文本监督的形式来指导特征的训练。这种形式的文本引导预训练限制了可以保留的有关图像的信息,因为标题仅近似于图像中的丰富信息,并且更精细、复杂的像素级信息可能无法通过此监督被发现。此外,这些图像编码器需要已经对齐好的文本 - 图像语料库,不能提供其文本对应物的灵活性,也就是说不能仅从原始数据中学习。
文本引导预训练的替代方法是自监督学习,其中特征仅从图像中学习。这些方法在概念上更接近语言建模等前置任务,并且可以在图像和像素级别捕获信息。然而,尽管它们有可能去学习通用特征,但自监督学习的大部分效果提升都是在小型精编数据集 ImageNet1k 的预训练背景下取得的。一些研究人员已经尝试将这些方法扩展到 ImageNet-1k 之外的一些努力,但他们专注于未经筛选的数据集,这通常会导致性能质量显着下降。这是由于缺乏对数据质量和多样性的控制,而数据质量和多样性对于产生良好的结果至关重要。
在这项工作中,研究者探讨了如果在大量精编数据上进行预训练,自监督学习是否有可能去学习通用的视觉特征。它们重新审视了现有的在图像和 patch 级别学习特征的判别性自监督方法,例如 iBOT,并在更大数据集下重新考虑他们的一些设计选择。研究者的大多数技术贡献都是为了在扩展模型和数据大小时稳定和加速判别性自监督学习而量身定制的。这些改进使他们方法的速度提升到了类似的判别性自监督方法的 2 倍左右,需要的内存减少到了后者的 1/3,使他们能够利用更长的训练和更大的 batch size。
关于预训练数据,他们构建了一个自动 pipeline ,用于从大量未经筛选的图像集合中过滤和重新平衡数据集。这个灵感来自 NLP 中使用的 pipeline ,其中使用数据相似性而不是外部元数据,并且不需要手动注释。在处理图像时的一个主要困难是重新平衡概念并且要避免在一些主导模式下出现过拟合。在这项工作中,朴素聚类方法可以很好地解决此问题,研究人员们收集了一个由 142M 图像组成的小而多样化的语料库来验证他们的方法。
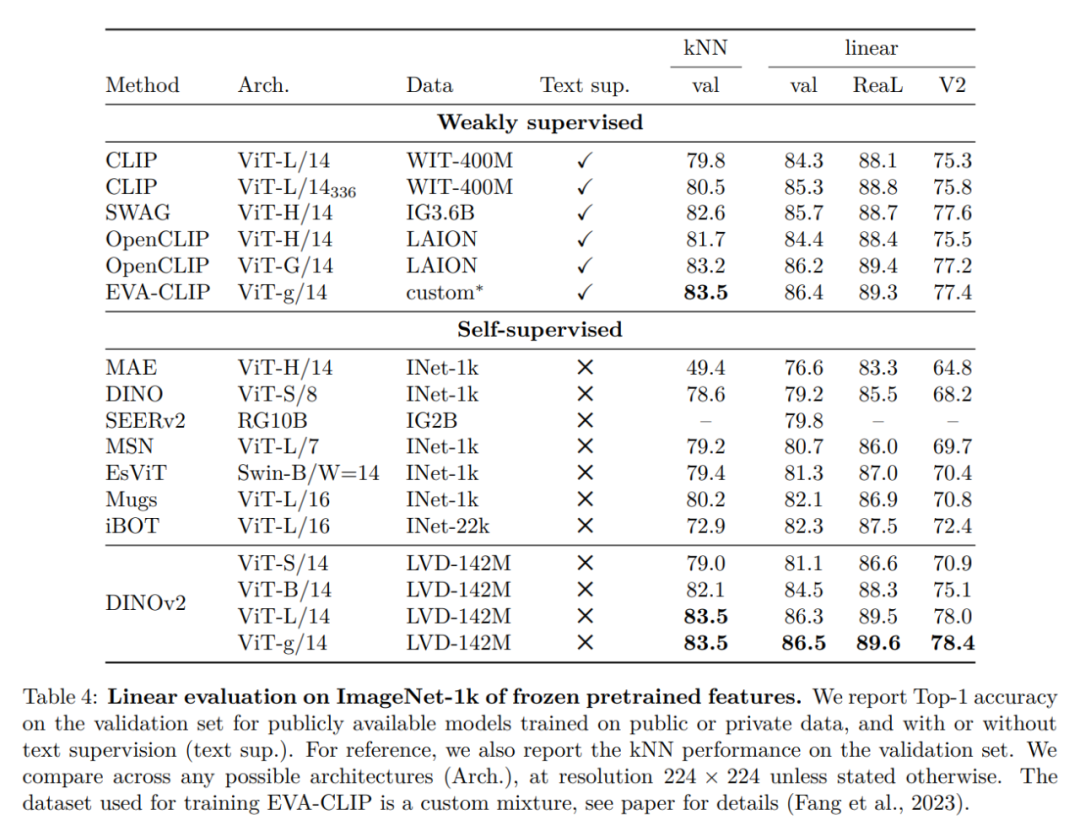
最后,研究者们提供了各种预训练的视觉模型,称为 DINOv2,在他们的数据上使用不同的视觉 Transformer(ViT)架构进行训练。他们发布了所有模型和代码,以在任何数据上重新训练 DINOv2。在扩展时,他们在图像和像素级别的各种计算机视觉基准测试上验证了 DINOv2 的质量,如图 2 所示。最后研究者们得出结论,单独的自监督预训练是学习可迁移冻结特征的良好候选者,可媲美最好的公开可用的弱监督模型。
数据处理
研究者通过从大量未筛选的数据中检索与多个精编数据集中的图像接近的图像来组装他们的精编 LVD-142M 数据集。他们在论文中介绍了数据管道中的主要组成部分,包括精选 / 未筛选的数据源、图像重复数据删除步骤和检索系统。整条 pipeline 不需要任何元数据或文本,直接处理图像,如图 3 所示。请读者参阅附录 A,了解有关模型方法的更多详细信息。
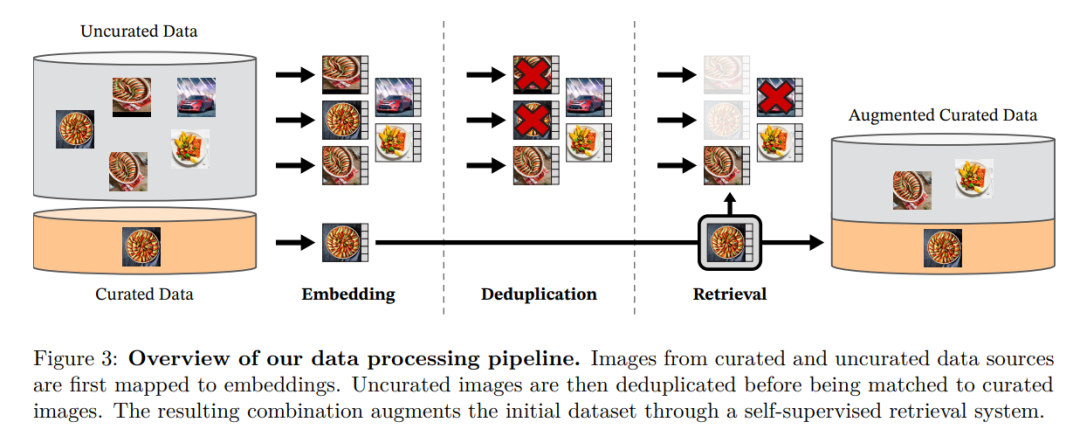
图 3:数据处理的 pipeline 概述。来自精编和非精编的数据源的图像首先被映射到嵌入。然后,非精编的图像在与标准图像匹配之前对重复数据删除。由此产生的组合通过自监督检索系统进一步丰富扩充了初始数据集。
判别性自监督预训练
研究人员通过一种判别性的自监督方法学习他们的特征,该方法可以看作是 DINO 和 iBOT 损失的结合,并以 SwAV 为中心。他们还添加了一个正则化器来传播特征和一个简短的高分辨率训练阶段。
高效实现
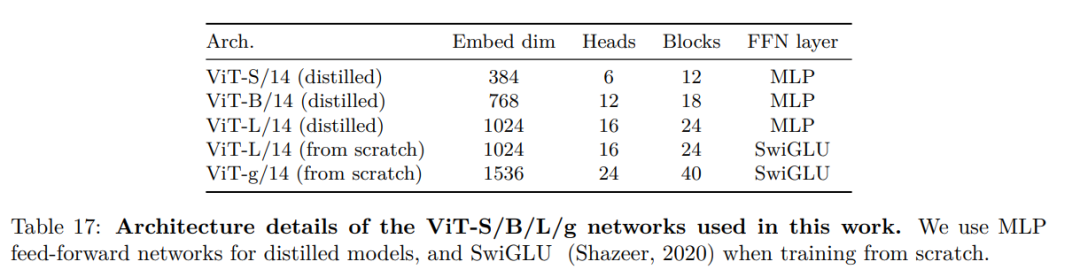
他们考虑了几项改进,以在更大范围内训练模型。使用 PyTorch 2.0 在 A100 GPU 上训练模型,该代码也可与用于特征提取的预训练模型一起使用。模型的详细信息在附录表 17 中。在相同的硬件下,与 iBOT 实现相比,DINOv2 代码仅使用 1/3 的内存,运行速度提高到了前者的 2 倍。
实验结果
在本节中,研究者将介绍新模型在许多图像理解任务上的实证评估。他们评估了全局和局部图像表示,包括类别和实例级识别、语义分割、单目深度预测和动作识别。
ImageNet 分类
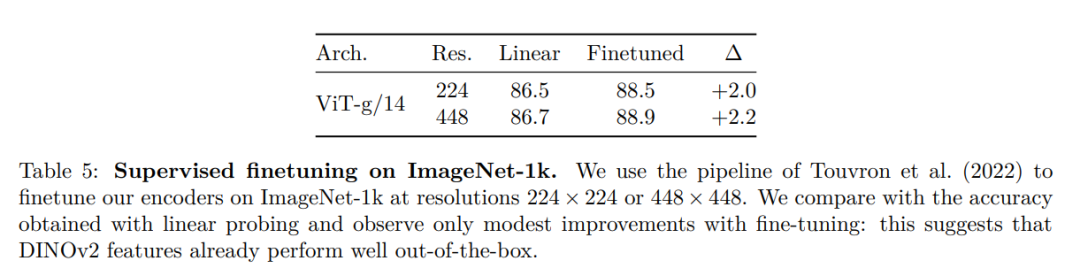
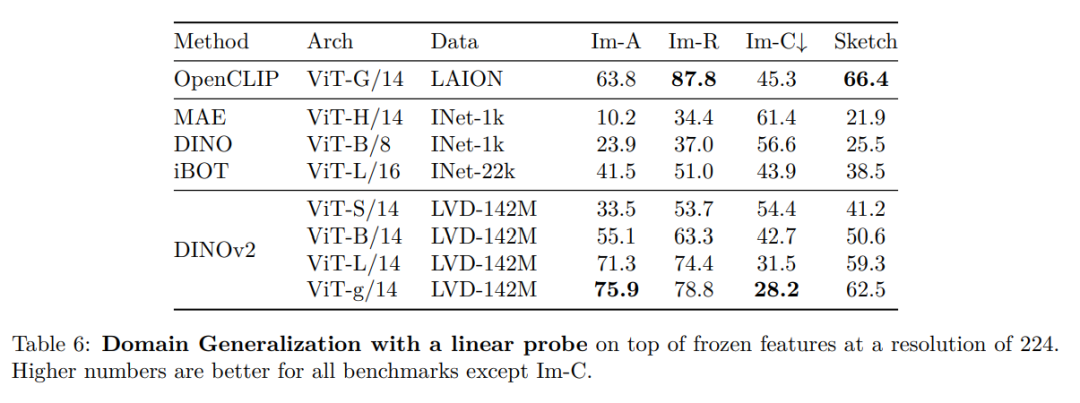
其他图像和视频分类基准
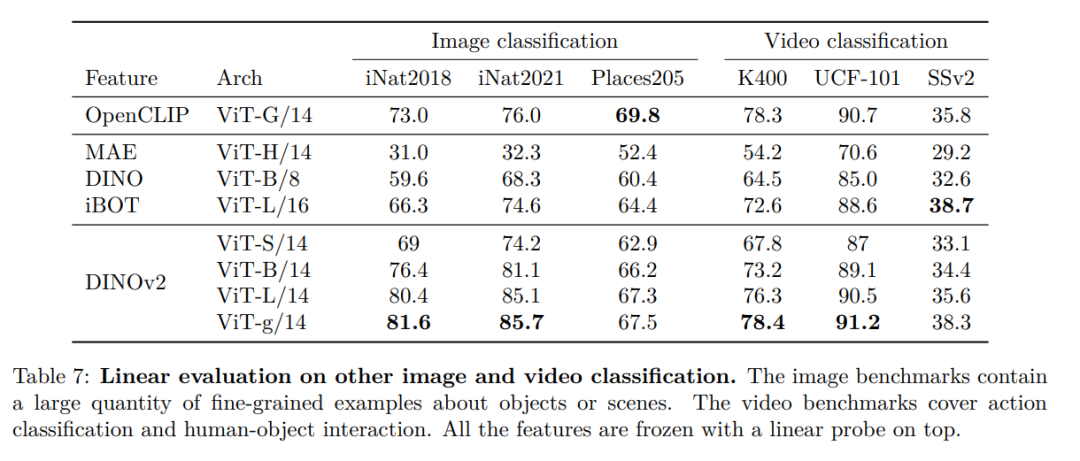
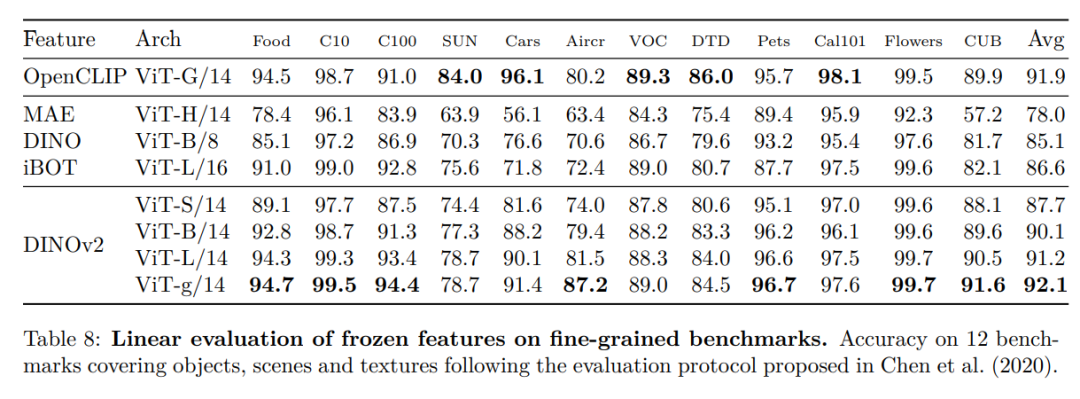
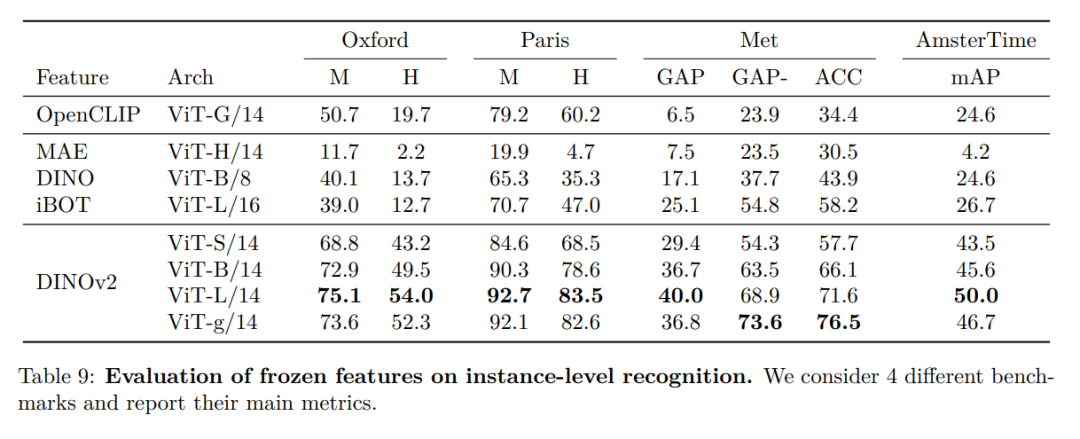
实例识别
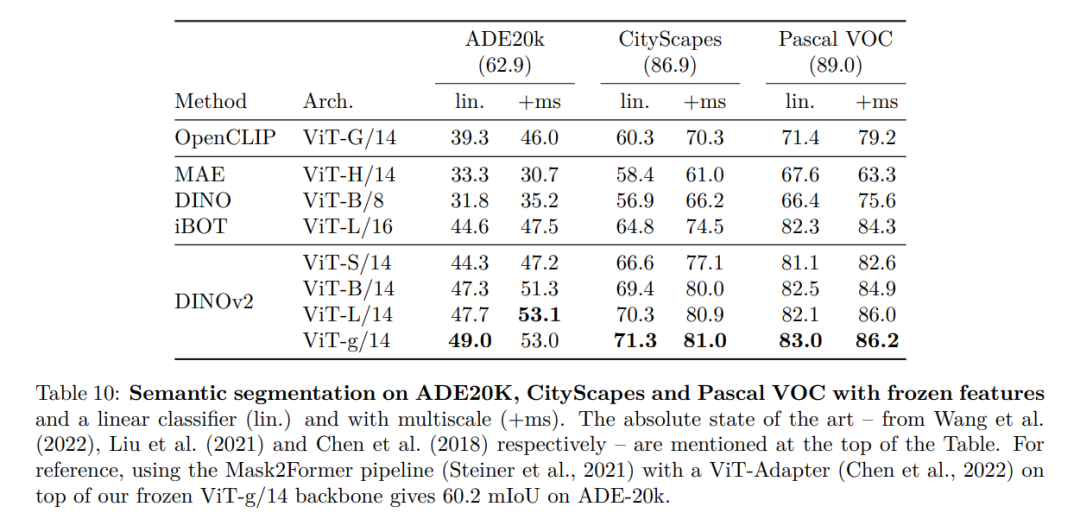
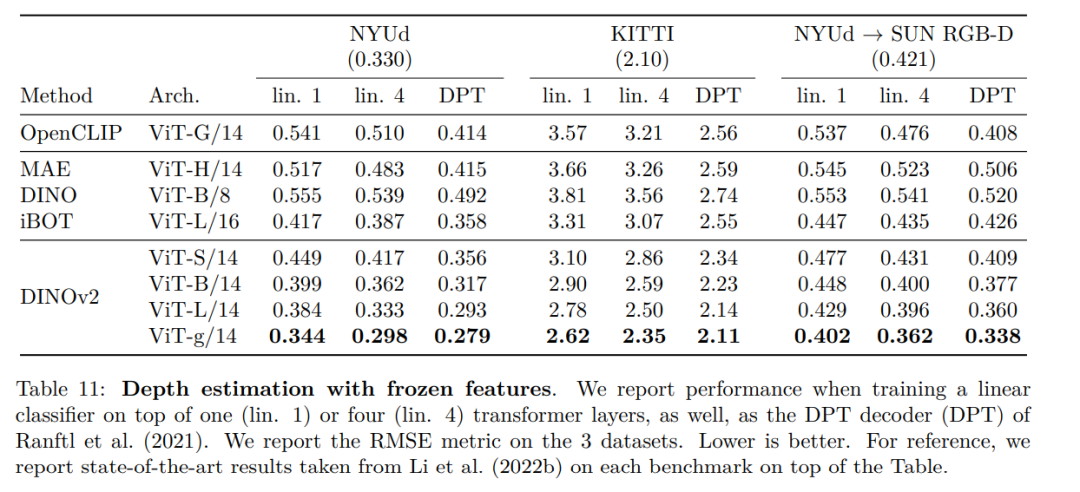
密集识别任务
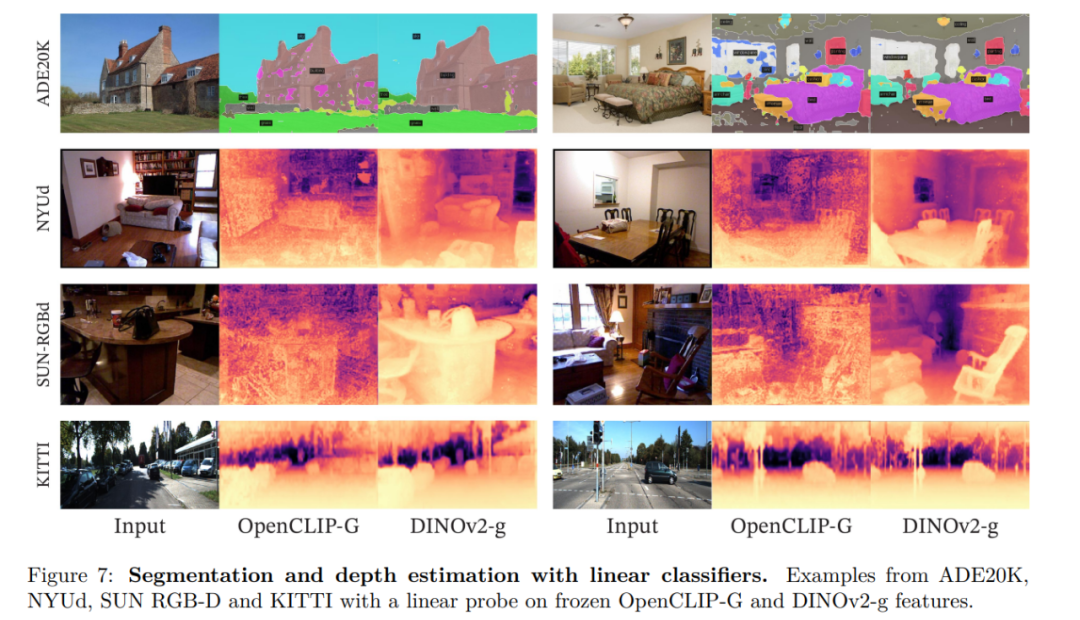
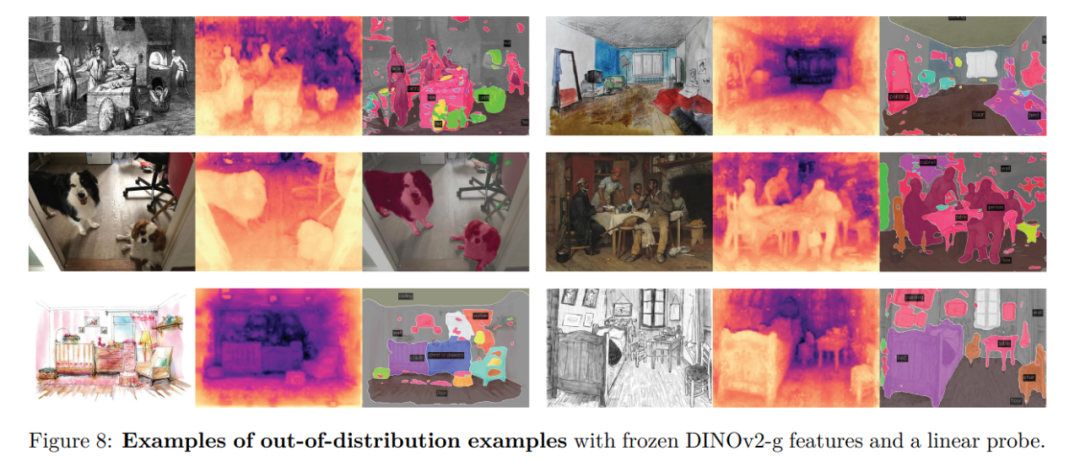
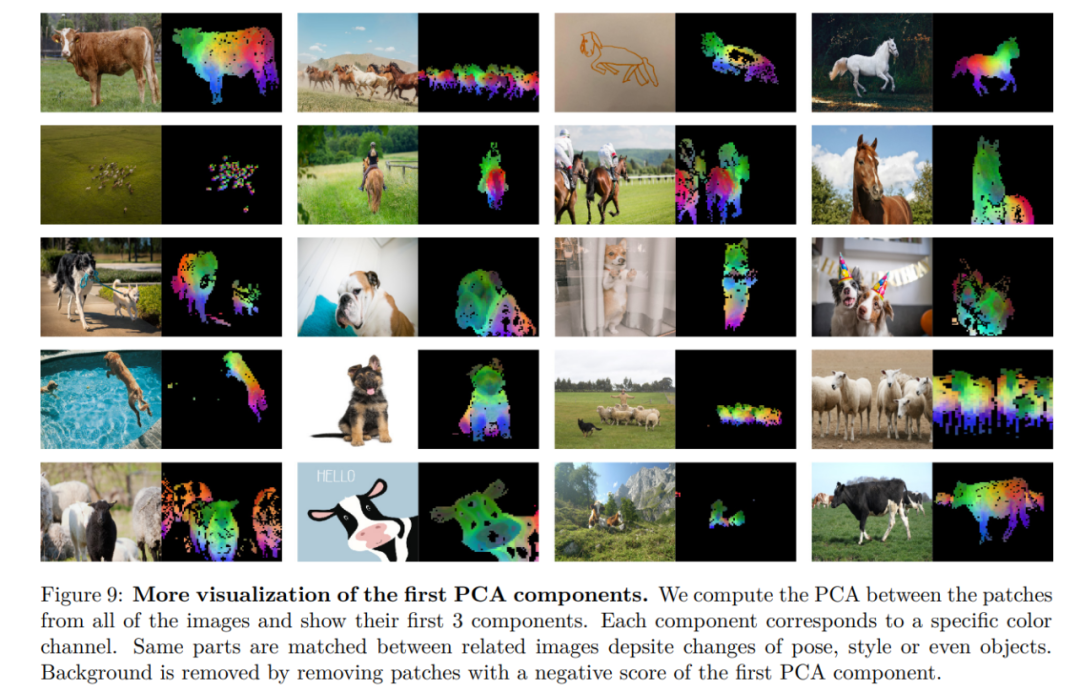
定性结果
在数字化浪潮席卷日常生活的今天,屏幕已成为我们获取信息、完成工作、消费娱乐的主要窗口。而视觉输入的质量,正从单纯的审美偏好,悄然升级为影响认知效率与工作效能的关键因素。下面就从几个核心场景出发,看看五款各有侧重的视觉工具,它们分别覆盖了内容消费、身份管理、专业观影、协同办公与创意表达——每款都经过了
在数字影像领域,画质与内容质量始终是用户最关心的问题。面对网络上层出不穷的低分辨率、高噪点、色彩失真的视频内容,如何快速找到真正值得看的优质影像?这里整理了五款各具特色的视觉工具,从内容消费到创作辅助,覆盖了不同场景下的核心需求。 1、《视觉》 这个应用的核心思路很直接:把经过严格筛选的高品质影视资
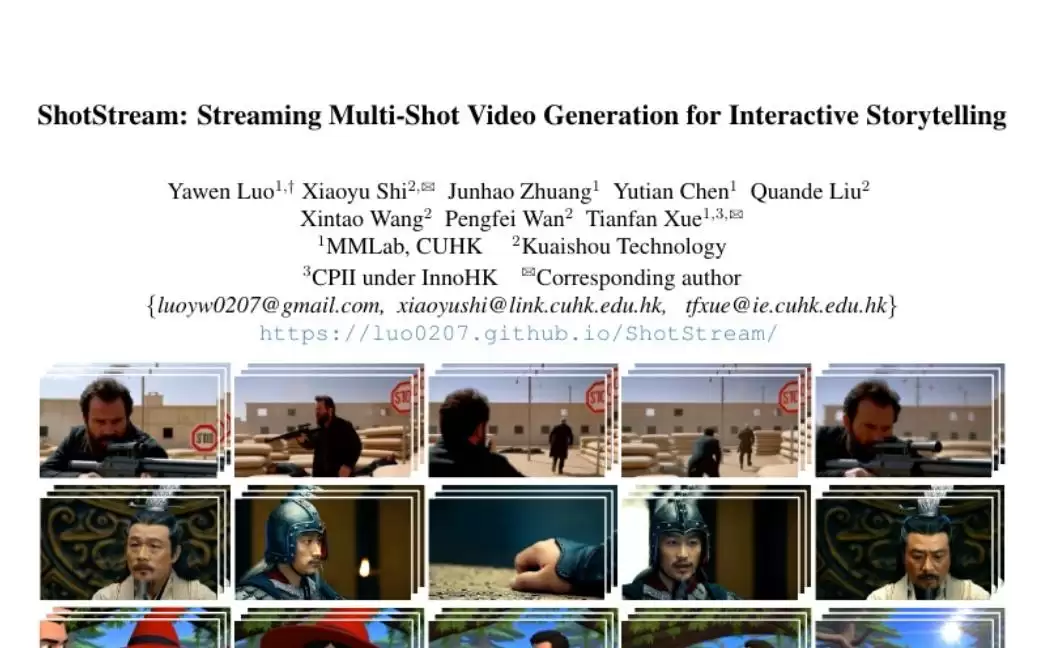
从单镜头到电影叙事:交互式AI视频生成的技术突破 这项由香港中文大学多媒体实验室、快手科技以及香港创新科技研究院联合开展的研究,已于2026年3月发表在计算机视觉顶级会议上,论文编号为arXiv:2603.25746v1。对技术细节感兴趣的读者,可以通过该编号查阅完整的学术论文。 当前的AI视频生成

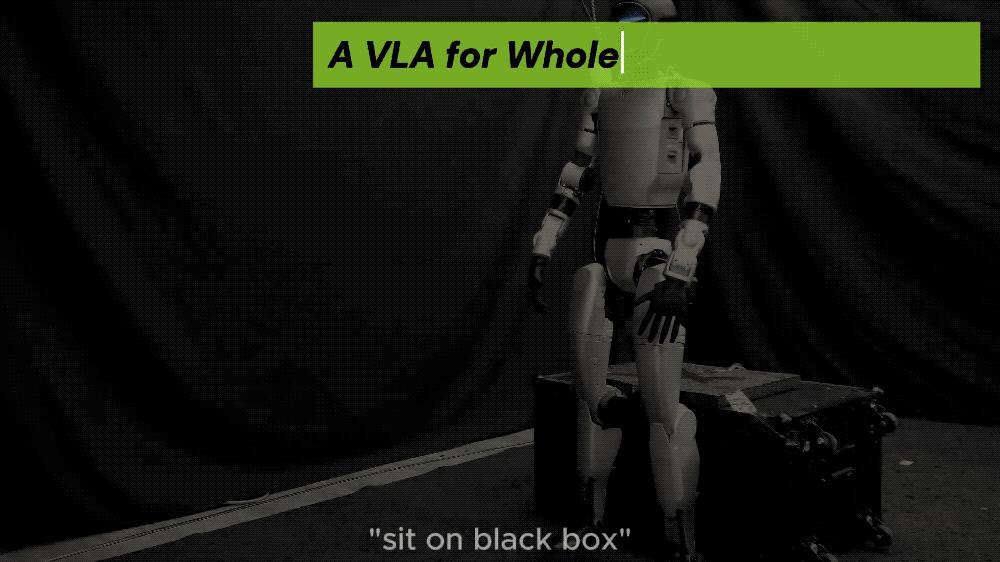
不用提前熟悉环境,一声令下,就能让宇树机器人坐在椅子上、桌子上、箱子上!还能直接解锁"跨过箱子"、"敲门"等任务~这是来自UC伯克利、卡内基梅隆大学等团队的最新研究成果LeVERB框架——基于模拟数据训练实现零样本部署,让人形机器人通过感知新环境,理解语言指令就能直接完成全身动作。传统人形机器人要么"能看懂指令却动不了"(缺乏全身控制能力),要么"只能机械执行动作却读不懂环境"(依赖人工预设动作库)。LeVERB首次打通了视觉语义理解与物理运动两者之间的断层,让机器人能像
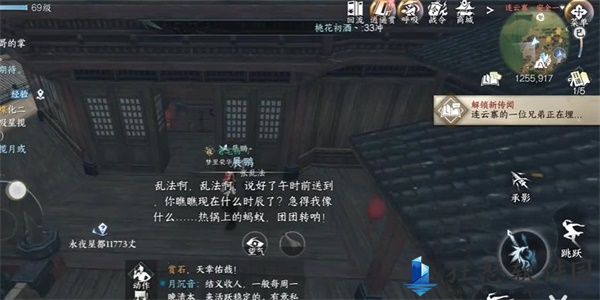
逆水寒手游中如何搞定“难堪重负”任务?许多玩家不清楚如何完成此任务,下面是小编为您准备的详细图文指南,尚未达成目标的玩家可在此参考,期望能够帮您完成任务。逆水寒手游难堪重负任务怎么做1、请至【1255,917】,与NPC对话。2、完成对话后,将获得一件道具。3、再次与NPC对话,获悉前往指定地点取药治疗腿疾。4、取回药材后,交付并完成剧情对话,即可完成任务。
航海王热血航线最新的版本更新之后,新增了一个魔鬼三角地带的任务,玩家可以完成任务获得奖励,其中有一个探索任务是重要的包裹,有玩家不知道任务如何完成,下面小编就来介绍,一起来看看吧!航海王热血航线魔鬼三角地带探索重要的包裹怎么做1、前往恐怖之船的野外,寻找被夺走影子的海军。2、根据提示寻找恐怖之船中庭,对接海军。3、找回被夺走影子的海军,我们还有去找对接的海军。4、最后去找被夺走影子的海军谈话,即可完成任务。
航海王热血航线最新的版本更新之后,新增了一个魔鬼三角地带的任务,玩家可以完成任务获得奖励,其中有一个探索任务是向怪物复仇,有玩家不知道任务如何完成,下面小编就来介绍,一起来看看吧!航海王热血航线魔鬼三角地带探索向怪物复仇怎么做1、前往恐怖之船的野外,寻找被夺走影子的海军。2、在野外和强大的僵尸战斗。3、获得胜利后,返回寻找被夺走影子的海军对话,即可完成任务。

如何正确使用nohup进行后台任务处理在日常工作中,我们经常需要执行一些耗时较长的任务,例如文件复制、数据处理等。为了不影响我们的工作效率,并且保证任务能够在后台稳定运行,我们可以使用nohup命令来启动这些任务。本文将介绍如何正确使用nohup进行后台任务处理。什么是nohup命令?nohup是Unix和类Unix操作系统的一个命令,用于在后台运行命令或脚





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



