

DALL-E和Flamingo能相互理解吗?三个预训练SOTA神经网络统一图像和文本
多模态研究的一个重要目标就是提高机器对于图像和文本的理解能力。特别是针对如何在两种模型之间实现有意义的交流,研究者们付出了巨大努力。举例来说,图像描述(imagecaptioning)生成应当能将图像的语义内容转换输出为可被人们理解的连贯文本。相反,文本-图像生成模型也可利用文本描述的语义来创建逼真的图像。这就会带来一些同语义相关的有趣问题:对于给定的图像,哪种文本描述最准确地描述了图像?同样地,对于给定的文本,最有意义的图像实现方式又是哪种?针对第一个问题,一些研究宣称最佳的图像描述应该是既自然且
多模态研究的一个重要目标就是提高机器对于图像和文本的理解能力。特别是针对如何在两种模型之间实现有意义的交流,研究者们付出了巨大努力。举例来说,图像描述(image captioning)生成应当能将图像的语义内容转换输出为可被人们理解的连贯文本。相反,文本 - 图像生成模型也可利用文本描述的语义来创建逼真的图像。
这就会带来一些同语义相关的有趣问题:对于给定的图像,哪种文本描述最准确地描述了图像?同样地,对于给定的文本,最有意义的图像实现方式又是哪种?针对第一个问题,一些研究宣称最佳的图像描述应该是既自然且还能还原视觉内容的信息。而对于第二个问题,有意义的图像应该是高质量的、多样性的且忠于文本内容的。
不论怎样,在人类交流的推动下,包含文本 - 图像生成模型及图像 - 文本生成模型的交互任务可以帮助我们选择最准确的图像文本对。
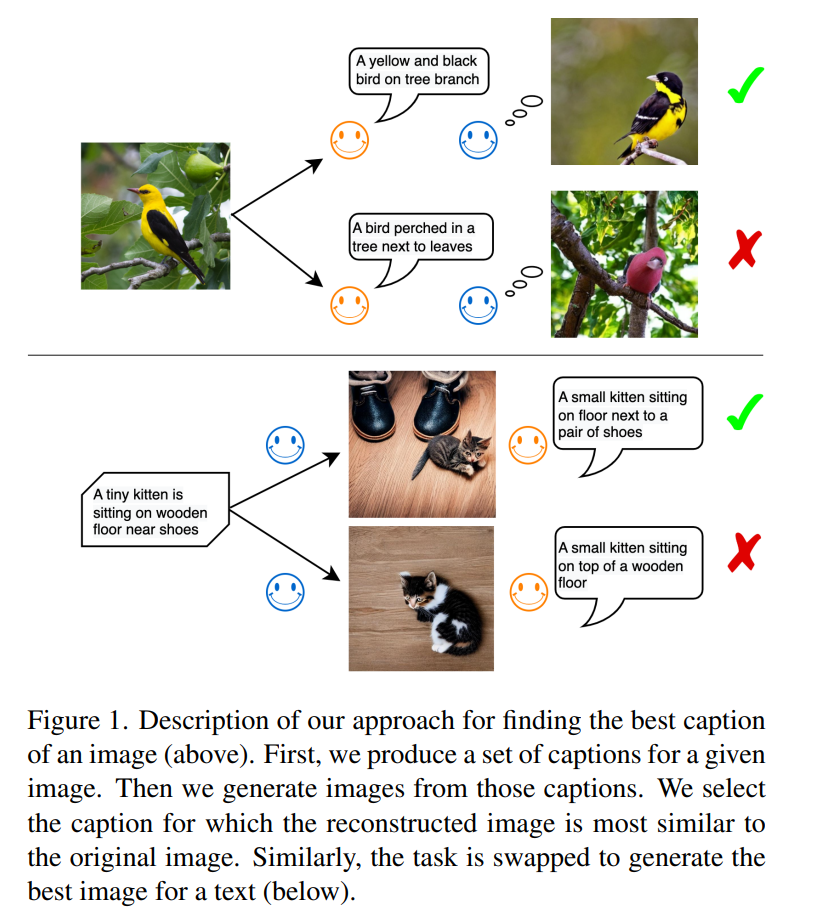
如图 1 所示,在第一个任务中,图像 - 文本模型是信息发送者,文本 - 图像模型是信息接收者。发送者的目标是使用自然语言将图像的内容传达给接收者,以便其理解该语言并重建真实的视觉表征。一旦接收者可以高保真地重建原始图像信息,则表明信息已传递成功。研究者认为这样生成的文本描述即为最优的,通过其产生的图像也最近似于原始图像。
这一规律受到人们使用语言进行交流的启发。试想如下情形:在一个紧急呼救的场景中,警察通过电话获知车祸的情况和受伤人员的状况。这本质上涉及现场目击者的图像描述过程。警方需要根据语言描述在脑海中重建环境场景,以组织恰当的救援行动。显然,最好的文本描述应该是该场景重建的最佳指南。
第二个任务涉及文本重建:文本 - 图像模型成为信息发送者,图像 - 文本模型则成为信息接收者。一旦两个模型就文本层面上信息内容达成一致,那么用于传达信息的图像媒介即为重现源文本的最优图像。
本文中,来自慕尼黑大学、西门子公司等机构的研究者提出的方法,同智能体间通信紧密相关。语言是智能体之间交换信息的主要方法。可我们如何确定第一个智能体与第二个智能体对什么是猫或什么是狗这样的问题有相同的理解呢?
论文地址:https://arxiv.org/pdf/2212.12249.pdf
本文所想要探求的想法是让第一个智能体分析图像并生成描述该图像的文本,而后第二个智能体获取该文本并据此来模拟图像。其中,后一个过程可以被认为是一个具象化体现的过程。该研究认为,如果第二个智能体模拟的图像与第一个智能体接收到的输入图像相似(见图 1),则通信成功。
在实验中,该研究使用现成的模型,特别是近期开发的大规模预训练模型。例如,Flamingo 和 BLIP 是图像描述模型,可以基于图像自动生成文本描述。同样地,基于图像 - 文本对所训练的图像生成模型可以理解文本的深层语义并合成高质量的图像,例如 DALL-E 模型和潜在扩散模型 (SD) 即为这种模型。
此外,该研究还利用 CLIP 模型来比较图像或文本。CLIP 是一种视觉语言模型,可将图像和文本对应起来表现在共享的嵌入空间(embedding space)中。该研究使用手动创建的图像文本数据集,例如 COCO 和 NoCaps 来评估生成的文本的质量。图像和文本生成模型具有允许从分布中采样的随机分量,因而可以从一系列候选的文本和图像中选择最佳的。不同的采样方法,包括核采样,均可以被用于图像描述模型,而本文采用核采样作为基础模型,以此来显示本文所使用方法的优越性。
方法概览
本文框架由三个预训练的 SOTA 神经网络组成。第一,图像 - 文本生成模型;第二,文本 - 图像生成模型;第三,由图像编码器和文本编码器组成的多模态表示模型,它可以将图像或文本分别映射到其语义嵌入中。
通过文本描述的图像重建
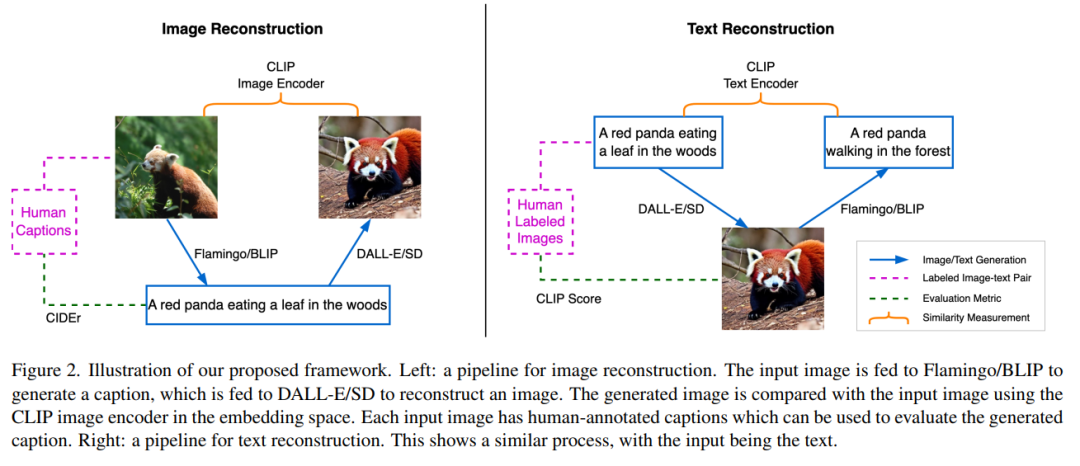
如图 2 左半部分所示,图像重建任务是使用语言作为指令重建源图像,此过程的效果实现将促使描述源场景的最佳文本生成。首先,源图像 x 被输送到 BLIP 模型以生成多个候选文本 y_k。例如,一只小熊猫在树林中吃树叶。生成的文本候选集合用 C 表示,然后文本 y_k 被发送到 SD 模型以生成图像 x’_k。这里 x’_k 是指基于小熊猫生成的图像。随后,使用 CLIP 图像编码器从源图像和生成的图像中提取语义特征: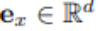 和
 。
然后计算这两个嵌入向量之间的余弦相似度,目的是找到候选的文本描述 y_s, 即
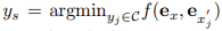
其中 s 为最接近源图像的图像索引。
该研究使用 CIDEr(图像描述度量指标)并参照人类注解来评估最佳文本。由于对生成的文本质量感兴趣,该研究将 BLIP 模型设定为输出长度大致相同的文本。这样就能保证进行相对公平的比较,因为文字的长度与可传递图像中信息量的多少呈正相关。在这项工作中,所有模型都会被冻结,不会进行任何微调。
通过图像实现文本重建
图 2 中右侧部分显示了与上一节描述过程的相反过程。BLIP 模型需要在 SD 的引导下猜测源文本,SD 可以访问文本但只能以图像的格式呈现其内容。该过程始于使用 SD 为文本 y 生成候选图像 x_k ,生成的候选图像集用 K 来表示。使用 SD 生成图像会涉及随机采样过程,其中每一次生成过程都可能会以在巨大的像素空间中得到不同的有效图像样本为终点。这种采样多样性会提供一个候选池来为筛选出最佳图像。随后,BLIP 模型为每个采样图像 x_k 生成一个文本描述 y’_k。这里 y’_k 指的是初始文本一只小熊猫在森林里爬行。然后该研究使用 CLIP 文本编码器提取源文本和生成文本的特征,分别用 和
 表示。此任务的目的是寻找匹配文本 y 语义的最佳候选图像 x_s。为此,该研究需要比较生成文本和输入文本之间的距离,然后选择出配对文本距离最小的图像,即
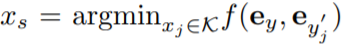
该研究认为图像 x_s 可以最好地描绘出文本描述 y,因为它可以以最小的信息损失将内容传递给接收者。此外,该研究将与文本 y 相对应的图像 视为 y 的参考表示(reference presentation),并将最佳图像量化为它与参考图像的接近程度。
实验结果
图 3 中的左侧图表显示了两个数据集上图像重建质量和描述文本质量之间的相关性。对于每个给定图像,重建图像质量(在 x 轴中显示)越好,文本描述质量(在 y 轴中显示的)也越好。
图 3 的右侧图表揭示了恢复的文本质量和生成的图像质量之间的关系:对于每个给定的文本,重建的文本描述(显示在 x 轴上)越好,图像质量(显示在 y 轴上)就越好。
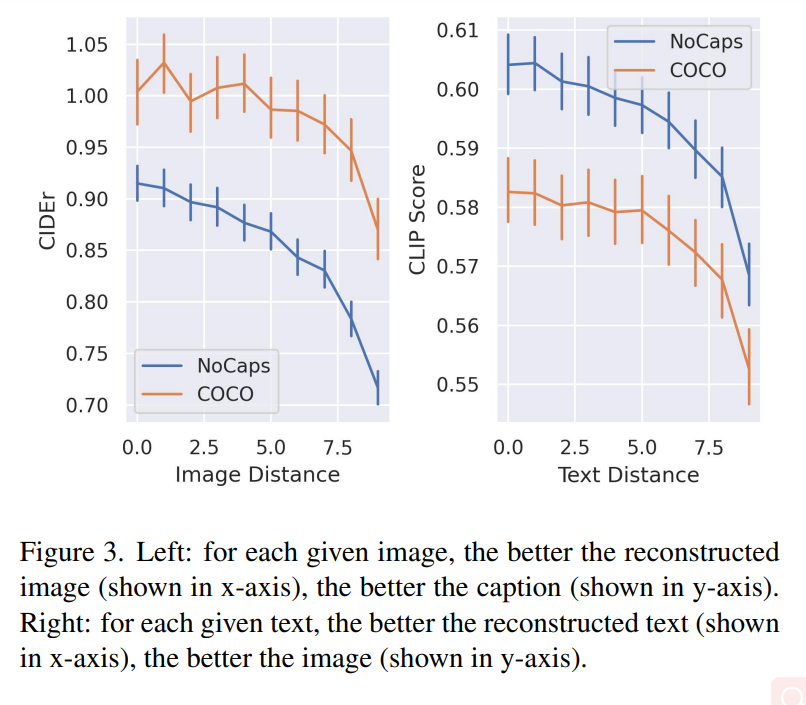
图 4(a)和(b)显示了图像重建质量和基于源图像的平均文本质量之间的关系。图 4(c)和(d)显示了文本距离(text distance)与重建图像质量之间的相关性。
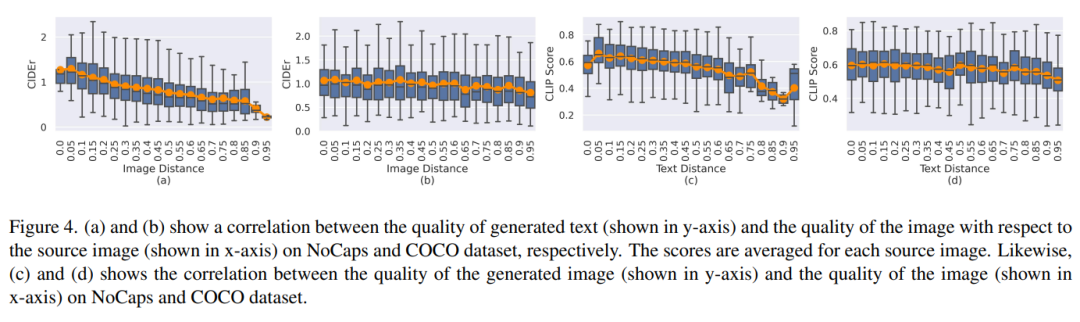
表 1 显示出该研究的采样方法在每个度量标准下都优于核采样,模型的相对增益可以高达 7.7%。
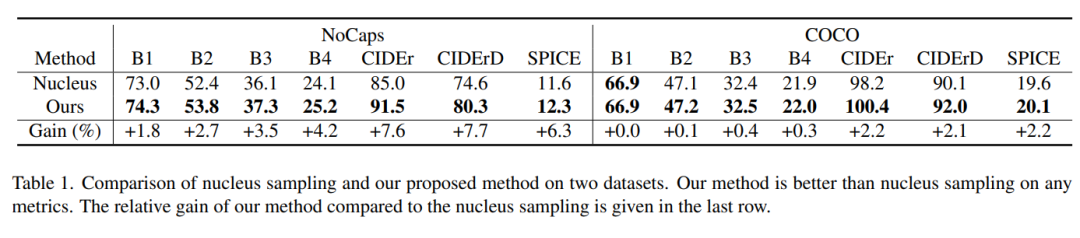
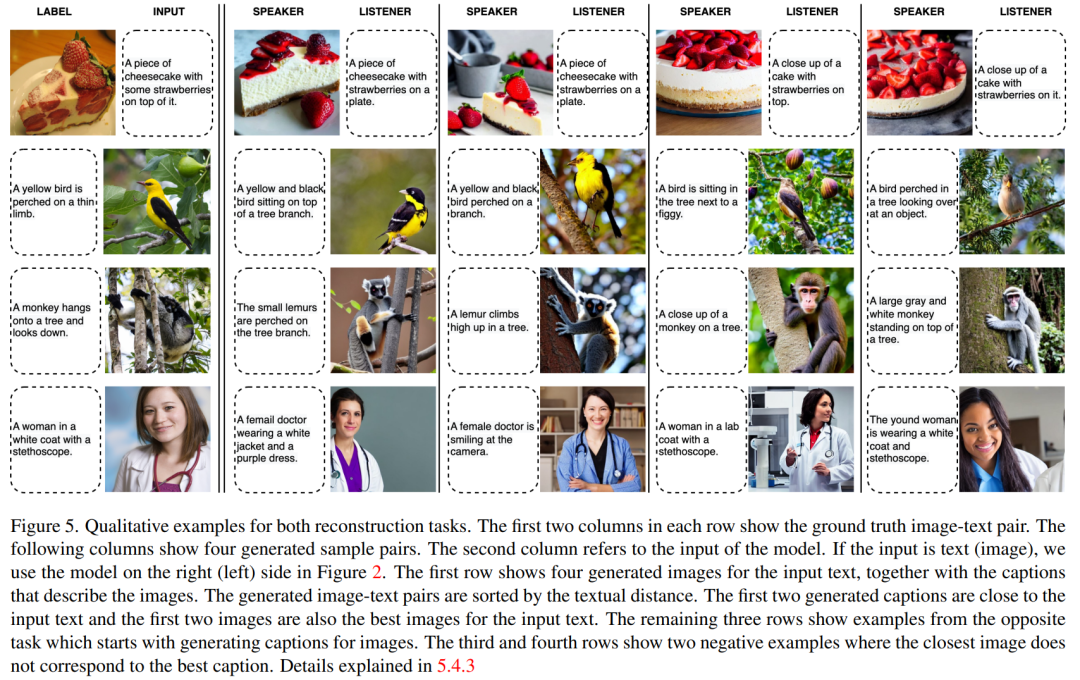
图 5 显示了两个重建任务的定性示例。


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
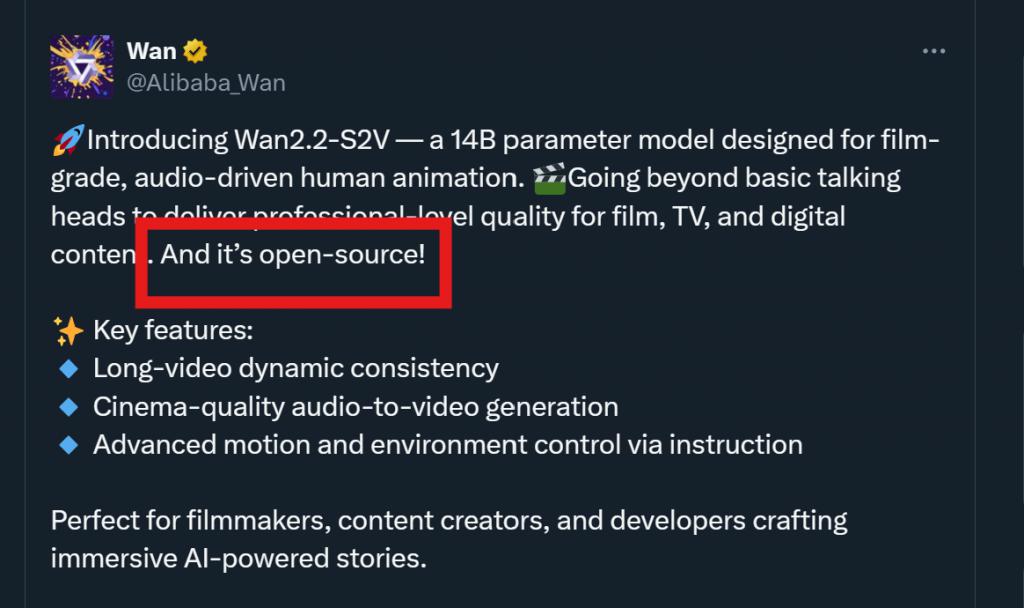
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
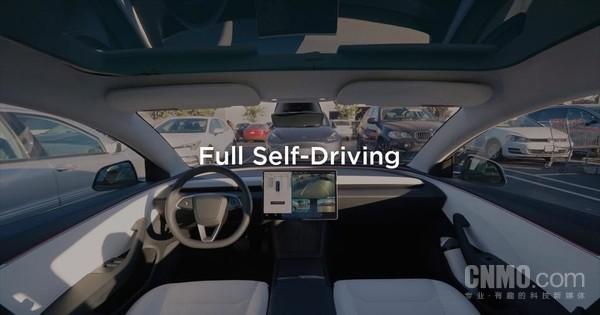
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
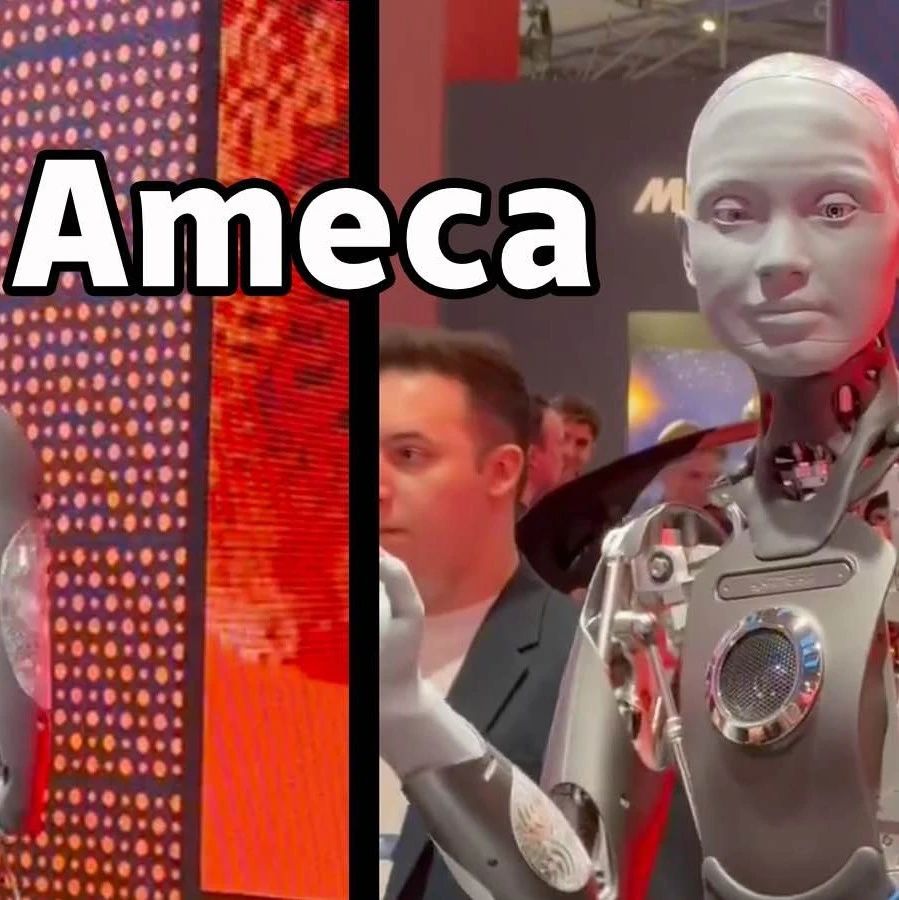
编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了
4月2日,HuggingFace大模型榜单迎来更新,阿里通义千问近期开源的端到端全模态大模型Qwen2.5-Omni力压群雄,荣登榜首!DeepSeek-V3-0324和群核的SpatialLM-Llama-1B紧随其后,杭州公司包揽榜单前三甲。Qwen2.5-Omni展现出卓越的多模态处理能力,能够流畅处理文本、图像、音频和视频等多种数据类型,并实时生成文本及语音输出。在OmniBench等权威多模态融合任务评测中,其性能表现创下新纪录。令人惊喜的是,它仅拥有70亿参数的小巧体积,这使得全模态大模
斯坦福李飞飞创业后,首次揭秘新概念“空间智能”。这不仅是她的创业方向,也是指引她的“北极星”,被她认为是“解决人工智能难题的关键拼图”。视觉化为洞察;看见成为理解;理解导致行动。在李飞飞15分钟TED演讲完整公开的基础上,从数亿年前生命进化的起源开始,到人类如何不满足于自然赋予而发展人工智能,直到下一步如何构建空间智能。9年前,李飞飞在同一个舞台上,向世界介绍了刚诞生不久的ImageNet——这一轮深度学习爆发的起点之一。她本人也向网友自我安利:如果把两个视频都看了,你就能对过去10年的计算机视觉、空间智





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



