

扩散+超分辨率模型强强联合,谷歌图像生成器Imagen背后的技术
近年来,多模态学习受到重视,特别是文本-图像合成和图像-文本对比学习两个方向。一些AI模型因在创意图像生成、编辑方面的应用引起了公众的广泛关注,例如OpenAI先后推出的文本图像模型DALL・E和DALL-E2,以及英伟达的GauGAN和GauGAN2。谷歌也不甘落后,在5月底发布了自己的文本到图像模型Imagen,看起来进一步拓展了字幕条件(caption-conditional)图像生成的边界。仅仅给出一个场景的描述,Imagen就能生成高质量、高分辨率的图像,无
近年来,多模态学习受到重视,特别是文本 - 图像合成和图像 - 文本对比学习两个方向。一些 AI 模型因在创意图像生成、编辑方面的应用引起了公众的广泛关注,例如 OpenAI 先后推出的文本图像模型 DALL・E 和 DALL-E 2,以及英伟达的 GauGAN 和 GauGAN2。
谷歌也不甘落后,在 5 月底发布了自己的文本到图像模型 Imagen,看起来进一步拓展了字幕条件(caption-conditional)图像生成的边界。
仅仅给出一个场景的描述,Imagen 就能生成高质量、高分辨率的图像,无论这种场景在现实世界中是否合乎逻辑。下图为 Imagen 文本生成图像的几个示例,在图像下方显示出了相应的字幕。
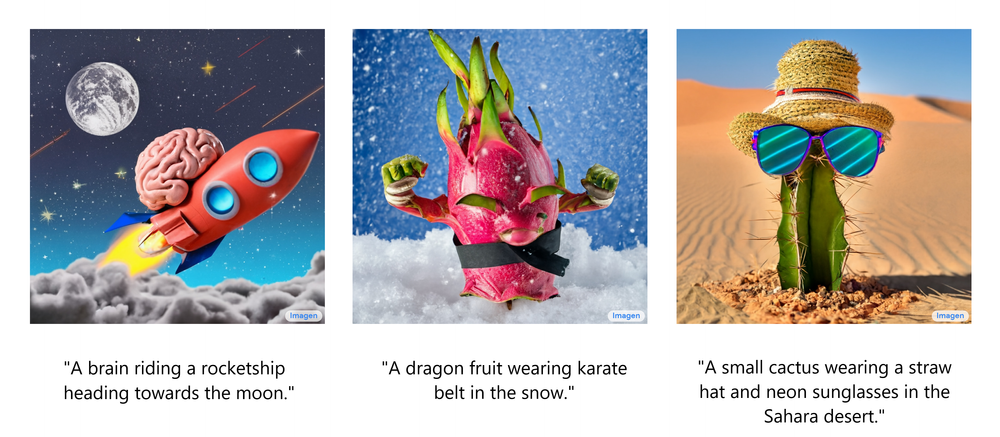
这些令人印象深刻的生成图像不禁让人想了解:Imagen 到底是如何工作的呢?
近期,开发者讲师 Ryan O'Connor 在 AssemblyAI 博客撰写了一篇长文《How Imagen Actually Works》,详细解读了 Imagen 的工作原理,对 Imagen 进行了概览介绍,分析并理解其高级组件以及它们之间的关联。
Imagen 工作原理概览
在这部分,作者展示了 Imagen 的整体架构,并对其它的工作原理做了高级解读;然后依次更透彻地剖析了 Imagen 的每个组件。如下动图为 Imagen 的工作流程。
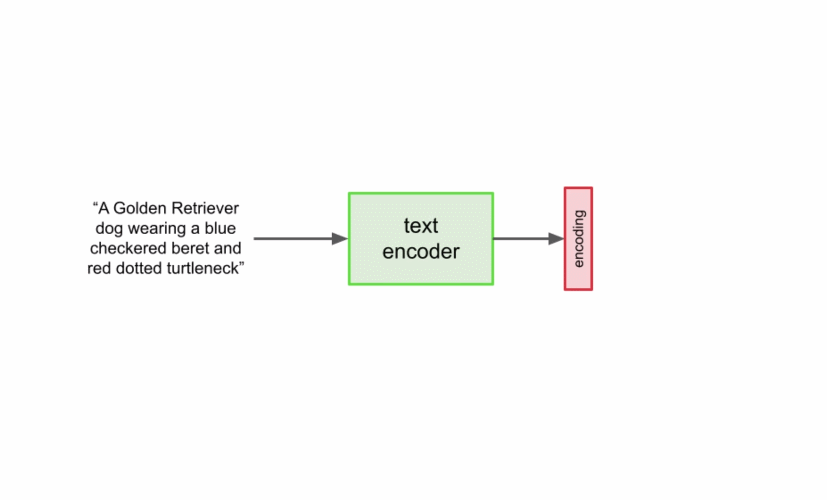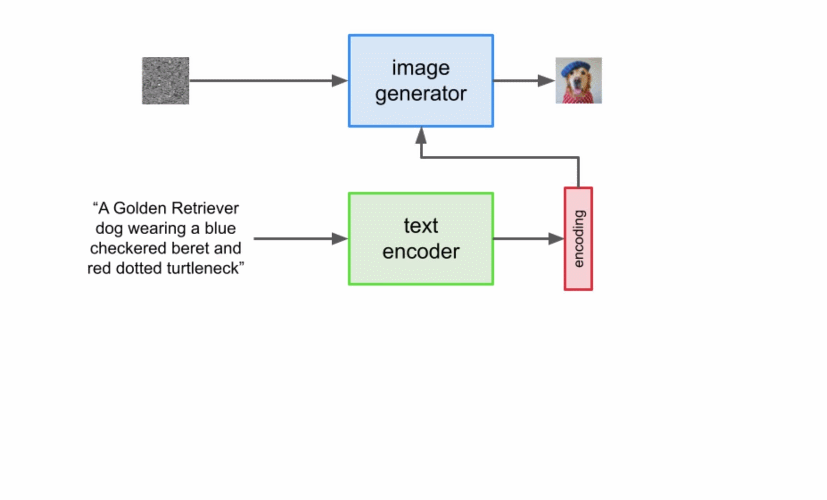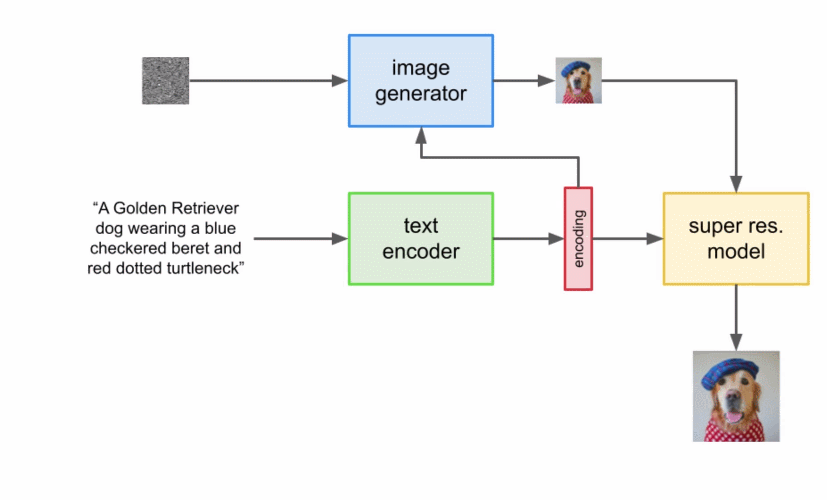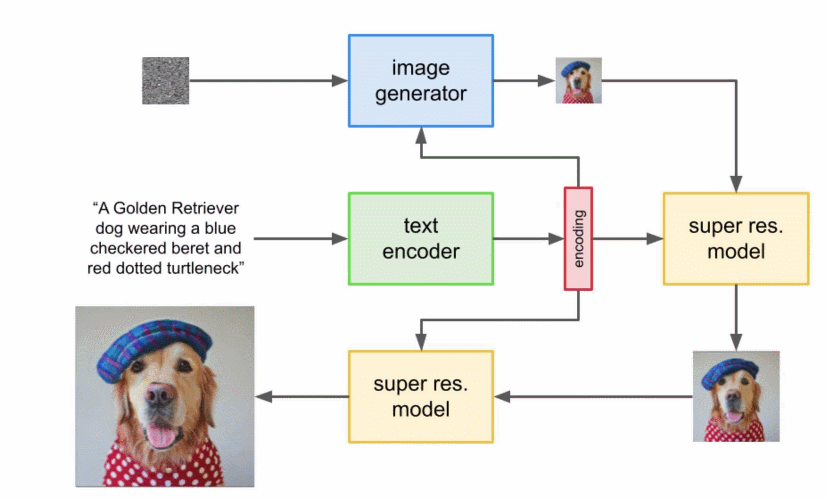
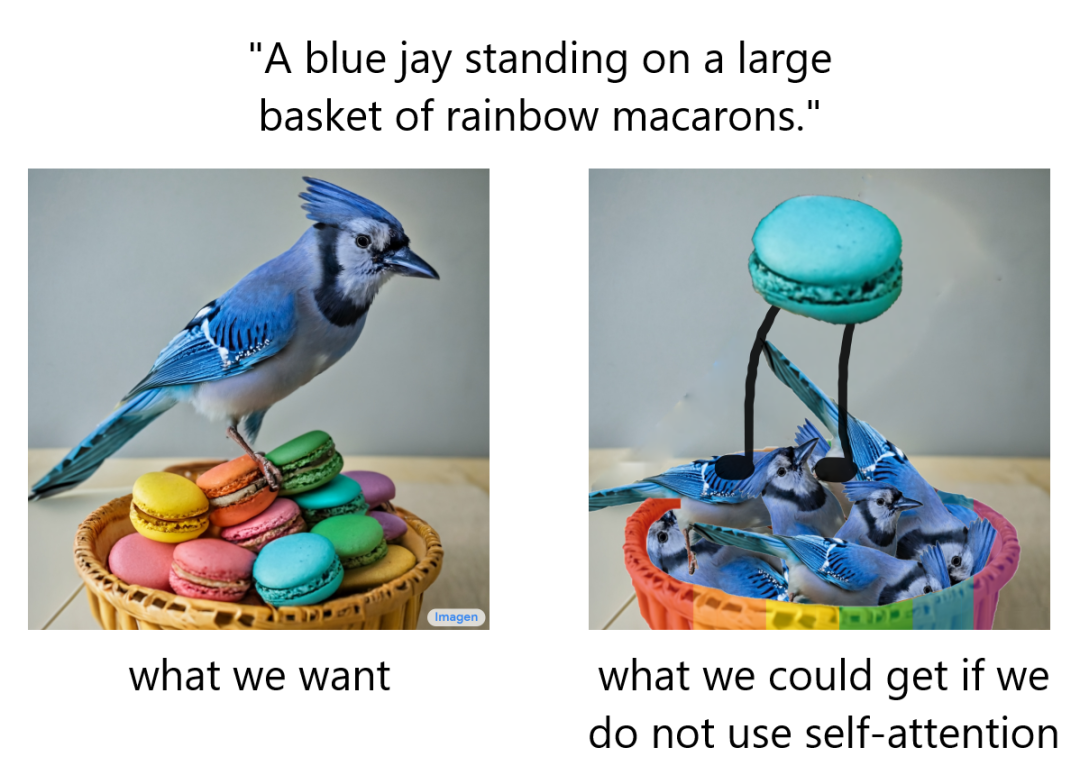
首先,将字幕输入到文本编码器。该编码器将文本字幕转换成数值表示,后者将语义信息封装在文本中。Imagen 中的文本编码器是一个 Transformer 编码器,其确保文本编码能够理解字幕中的单词如何彼此关联,这里使用自注意力方法。
如果 Imagen 只关注单个单词而不是它们之间的关联,虽然可以获得能够捕获字幕各个元素的高质量图像,但描述这些图像时无法以恰当的方式反映字幕语义。如下图示例所示,如果不考虑单词之间的关联,就会产生截然不同的生成效果。
虽然文本编码器为 Imagen 的字幕输入生成了有用的表示,但仍需要设计一种方法生成使用这一表示的图像,也即图像生成器。为此,Imagen 使用了扩散模型,它是一种生成模型,近年来得益于其在多项任务上的 SOTA 性能而广受欢迎。
扩散模型通过添加噪声来破坏训练数据以实现训练,然后通过反转这个噪声过程来学习恢复数据。给定输入图像,扩散模型将在一系列时间步中迭代地利用高斯噪声破坏图像,最终留下高斯噪声或电视噪音静态(TV static)。下图为扩散模型的迭代噪声过程:
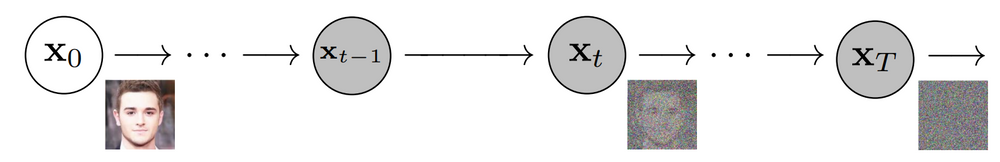
然后,扩散模型将向后 work,学习如何在每个时间步上隔离和消除噪声,抵消刚刚发生的破坏过程。训练完成后,模型可以一分为二。这样可以从随机采样高斯噪声开始,使用扩散模型逐渐去噪以生成图像,具体如下图所示:
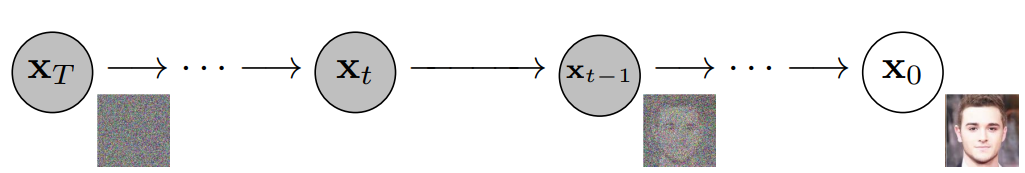
总之,经过训练的扩散模型从高斯噪声开始,然后迭代地生成与训练图像类似的图像。很明显的是,无法控制图像的实际输出,仅仅是将高斯噪声输入到模型中,并且它会输出一张看起来属于训练数据集的随机图像。
但是,目标是创建能够将输入到 Imagen 的字幕的语义信息封装起来的图像,因此需要一种将字幕合并到扩散过程中的方法。如何做到这一点呢?
上文提到文本编码器产生了有代表性的字幕编码,这种编码实际上是向量序列。为了将这一编码信息注入到扩散模型中,这些向量被聚合在一起,并在它们的基础上调整扩散模型。通过调整这一向量,扩散模型学习如何调整其去噪过程以生成与字幕匹配良好的图像。过程可视化图如下所示:
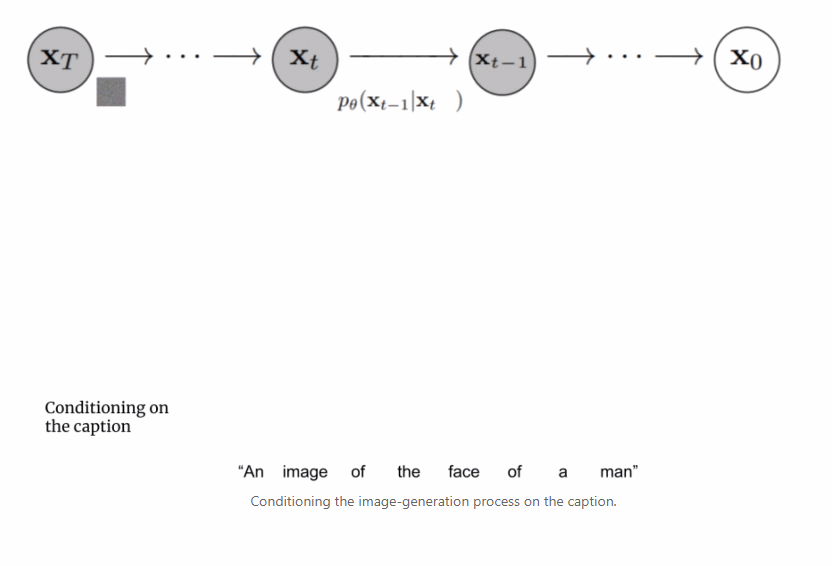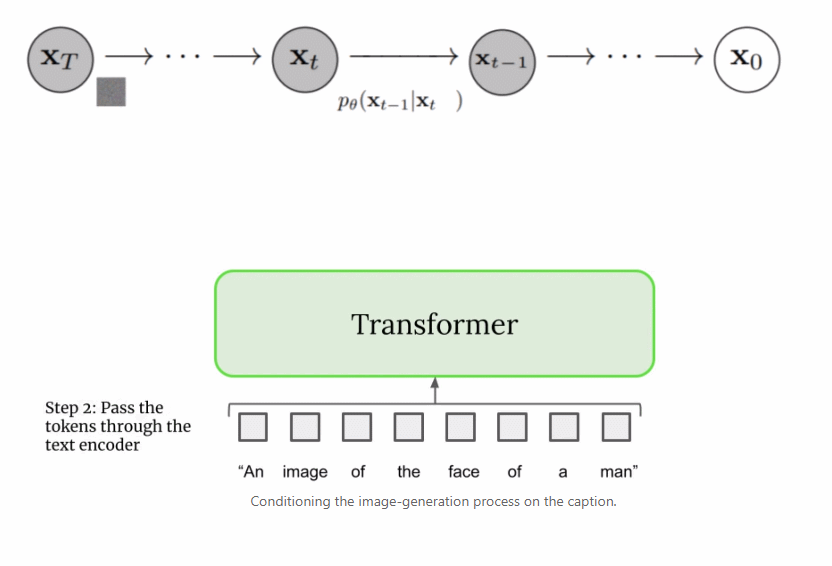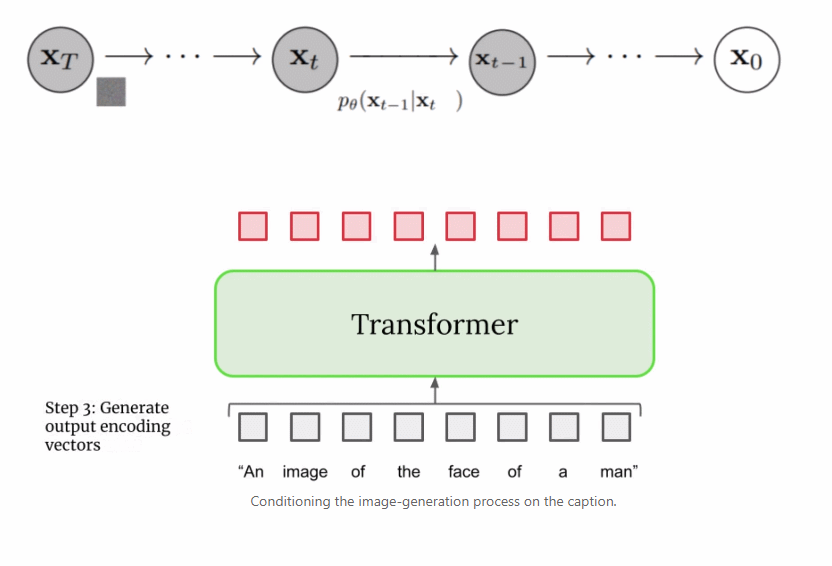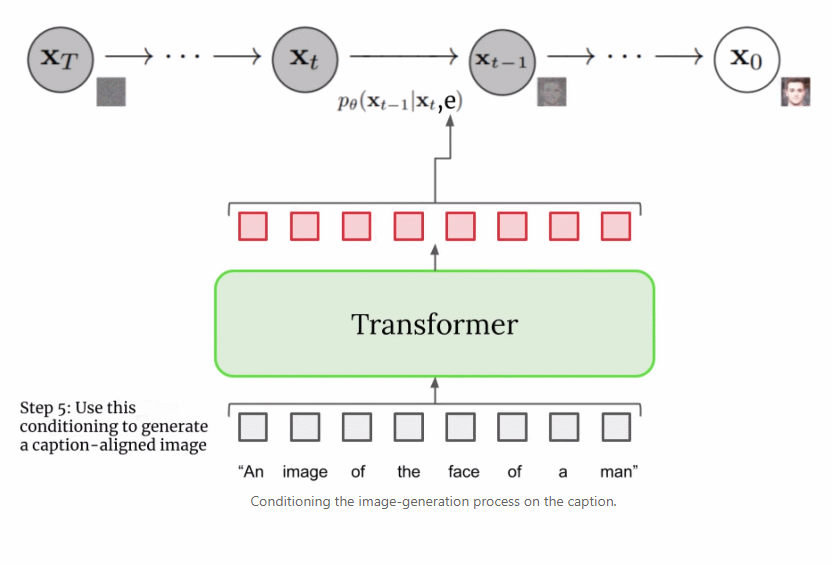
由于图像生成器或基础模型输出一个小的 64x64 图像,为了将这一模型上采样到最终的 1024x1024 版本,使用超分辨率模型智能地对图像进行上采样。
对于超分辨率模型,Imagen 再次使用了扩散模型。整体流程与基础模型基本相同,除了仅仅基于字幕编码调整外,还以正在上采样的更小图像来调整。整个过程的可视化图如下所示:
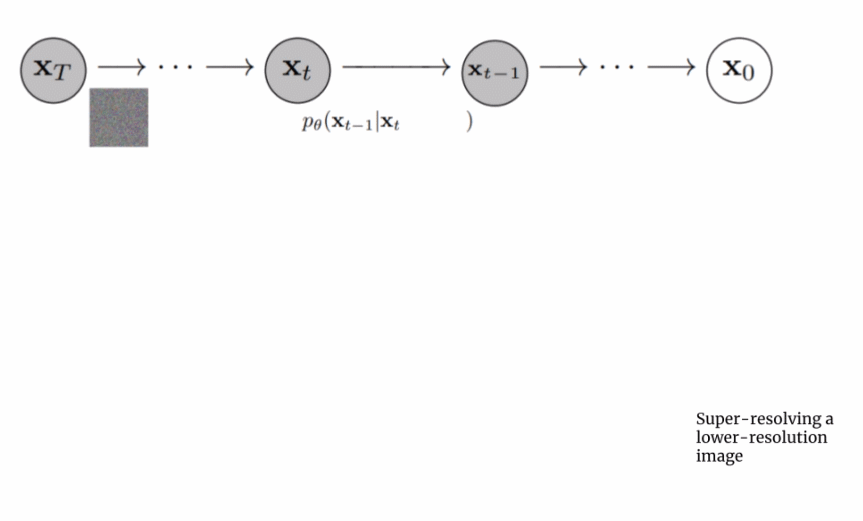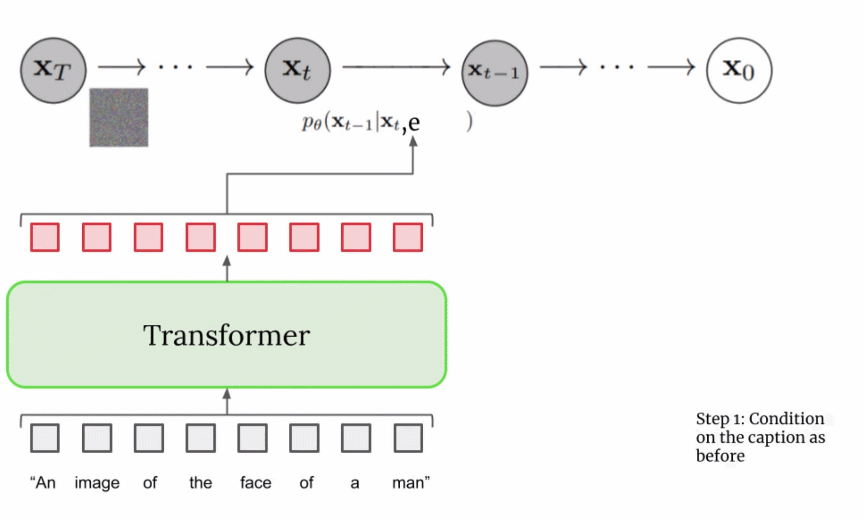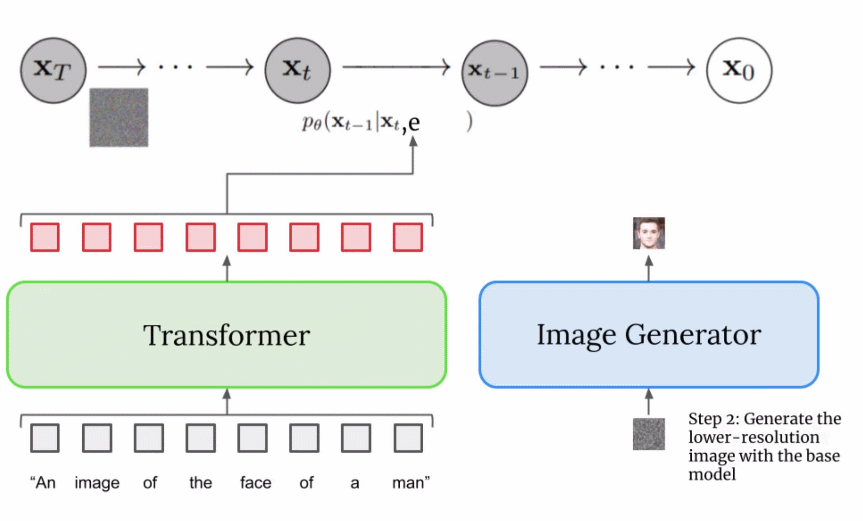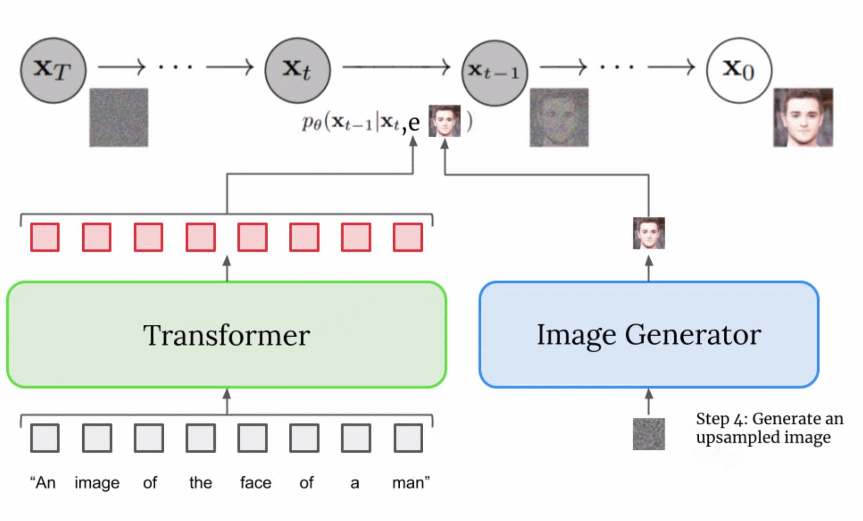
这个超分辨率模型的输出实际上并不是最终输出,而是一个中等大小的图像。为了将该图像放大到最终的 1024x1024 分辨率,又使用了另一个超分辨率模型。两个超分辨率架构大致相同,因此不再赘述。而第二个超分辨率模型的输出才是 Imagen 的最终输出。
为什么 Imagen 比 DALL-E 2 更好?
确切地回答为什么 Imagen 比 DALL-E 2 更好是困难的。然而,性能差距中不可忽视的一部分源于字幕以及提示差异。DALL-E 2 使用对比目标来确定文本编码与图像(本质上是 CLIP)的相关程度。文本和图像编码器调整它们的参数,使得相似的字幕 - 图像对的余弦相似度最大化,而不同的字幕 - 图像对的余弦相似度最小化。
性能差距的一个显著部分源于 Imagen 的文本编码器比 DALL-E 2 的文本编码器大得多,并且接受了更多数据的训练。作为这一假设的证据,我们可以在文本编码器扩展时检查 Imagen 的性能。下面为 Imagen 性能的帕累托曲线:
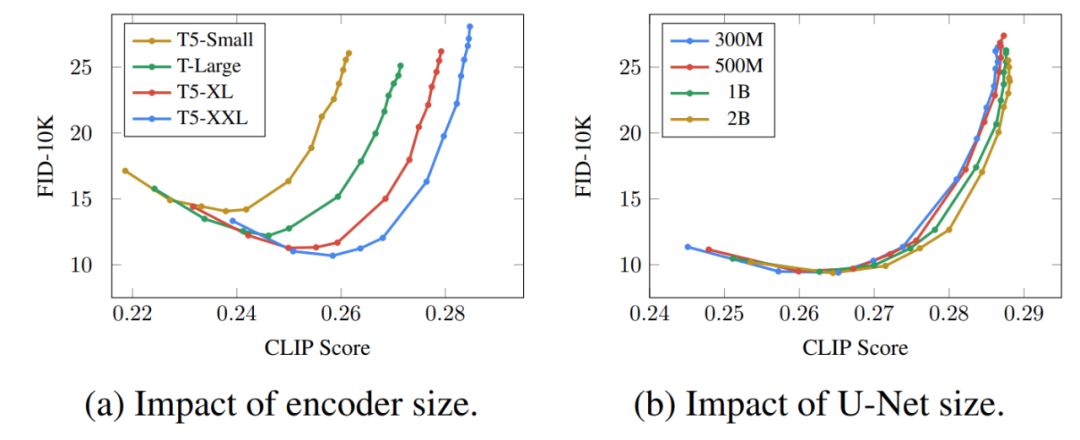
放大文本编码器的效果高得惊人,而放大 U-Net 的效果却低得惊人。这一结果表明,相对简单的扩散模型只要以强大的编码为条件,就可以产生高质量的结果。
鉴于 T5 文本编码器比 CLIP 文本编码器大得多,再加上自然语言训练数据必然比图像 - 字幕对更丰富这一事实,大部分性能差距可能归因于这种差异。
除此以外,作者还列出了 Imagen 的几个关键要点,包括以下内容:
- 扩展文本编码器是非常有效的;
- 扩展文本编码器比扩展 U-Net 大小更重要;
- 动态阈值至关重要;
- 噪声条件增强在超分辨率模型中至关重要;
- 将交叉注意用于文本条件反射至关重要;
- 高效的 U-Net 至关重要。
这些见解为正在研究扩散模型的研究人员提供了有价值的方向,而不是只在文本到图像的子领域有用。

近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
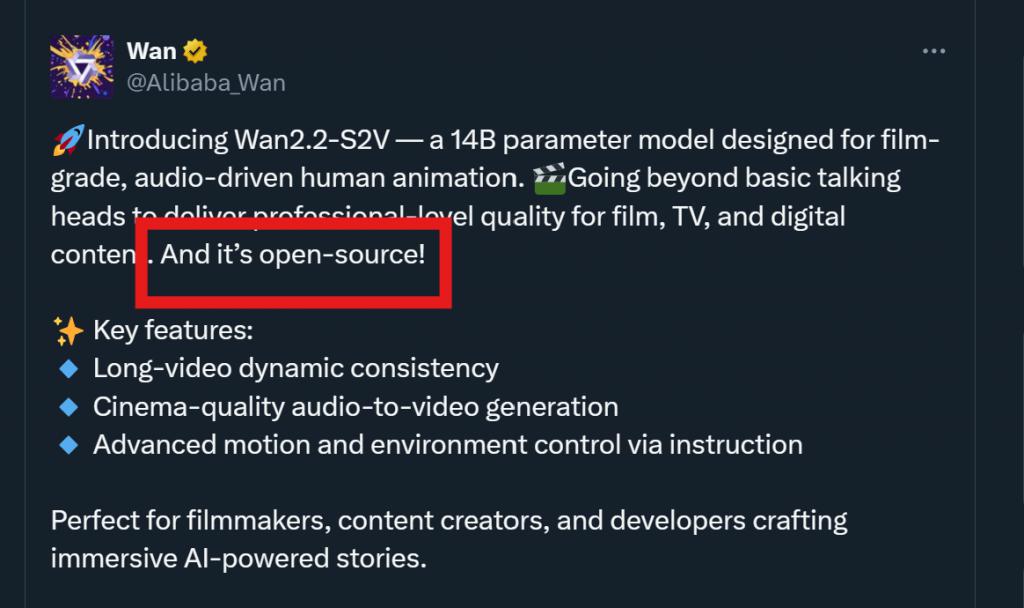
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音

5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及

大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型

强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足


编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了

4月2日,HuggingFace大模型榜单迎来更新,阿里通义千问近期开源的端到端全模态大模型Qwen2.5-Omni力压群雄,荣登榜首!DeepSeek-V3-0324和群核的SpatialLM-Llama-1B紧随其后,杭州公司包揽榜单前三甲。Qwen2.5-Omni展现出卓越的多模态处理能力,能够流畅处理文本、图像、音频和视频等多种数据类型,并实时生成文本及语音输出。在OmniBench等权威多模态融合任务评测中,其性能表现创下新纪录。令人惊喜的是,它仅拥有70亿参数的小巧体积,这使得全模态大模

比特现金(BCH)的未来发展前景看好。凭借其可扩展性、支付采用、价值存储、智能合约和坚实的社区支持,比特现金有望在多个领域取得显著发展,成为一种多功能且广泛使用的加密货币。

ACH 总共发行了 10 亿枚,用于支付网关费用、治理投票和质押奖励。ACH 基于 BEP-20 标准,采用 PoS 机制,可通过私募、公募和生态系统分配获取,其价值受服务需求、实用性和市场趋势影响,可在币安、火币等交易所购买。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
