

ChatGPT真的是「通才」吗?杨笛一等人给它来了个摸底考试
论文链接:https://arxiv.org/pdf/2302.06476.pdf大型语言模型(LLM)已经被证明能够解决各种自然语言处理(NLP)任务,而且对于给定的下游任务,它们不依赖任何训练数据,借助适当的prompt就能实现模型调整。这种根据指令执行新任务的能力可以被视为迈向通用人工智能的重要一步。尽管目前的LLM在某些情况下取得了不错的性能,但在zero-shot学习中仍然容易出现各种错误。此外,prompt的格式可以产生实质性的影响。例如,在prompt中添加「Let’s
论文链接:https://arxiv.org/pdf/2302.06476.pdf
大型语言模型(LLM)已经被证明能够解决各种自然语言处理(NLP)任务,而且对于给定的下游任务,它们不依赖任何训练数据,借助适当的 prompt 就能实现模型调整。这种根据指令执行新任务的能力可以被视为迈向通用人工智能的重要一步。
尽管目前的 LLM 在某些情况下取得了不错的性能,但在 zero-shot 学习中仍然容易出现各种错误。此外,prompt 的格式可以产生实质性的影响。例如,在 prompt 中添加「Let’s think step by step」,模型性能就能得到显著提升。这些限制说明当前的 LLM 并不是真正的通用语言系统。
近日,OpenAI 发布的 ChatGPT LLM 在 NLP 社区引发极大关注。ChatGPT 是通过「人类反馈强化学习(RLHF)」训练 GPT-3.5 系列模型而创建的。RLHF 主要包括三个步骤:使用监督学习训练语言模型;根据人类偏好收集比较数据并训练奖励模型;使用强化学习针对奖励模型优化语言模型。通过 RLHF 训练,人们观察到 ChatGPT 在各个方面都具有令人印象深刻的能力,包括对人类输入生成高质量的响应、拒绝不适当的问题以及根据后续对话自我纠正先前的错误。
虽然 ChatGPT 显示出强大的对话能力,但与现有的 LLM 相比,NLP 社区仍然不清楚 ChatGPT 是否获得了更好的 zero-shot 泛化能力。为了填补这一研究空白,研究者们通过在涵盖 7 个代表性任务类别的大量 NLP 数据集上对 ChatGPT 进行评估,系统地研究了它的 zero-shot 学习能力。这些任务包括推理(reasoning)、自然语言推断(natural language inference)、问答(阅读理解)、对话、摘要、命名实体识别和情感分析。借助广泛的实验,研究者旨在回答以下问题:
- ChatGPT 是一个通用的 NLP 任务求解器吗?ChatGPT 在哪些类型的任务上表现良好?
- 如果 ChatGPT 在某些任务上落后于其他模型,那原因是什么?
为了回答这些问题,作者根据实验结果比较了 ChatGPT 和最先进的 GPT-3.5 模型 (text-davinci-003) 的性能。此外,他们还报告了 FLAN、T0 和 PaLM 等近期工作的 zero-shot、微调或 few-shot 微调结果。
主要结论
作者表示,据他们所知,这是第一次有人对 ChatGPT 在各种 NLP 任务上的 zero-shot 能力进行研究,旨在提供 ChatGPT 的初步概况。他们的主要发现如下:
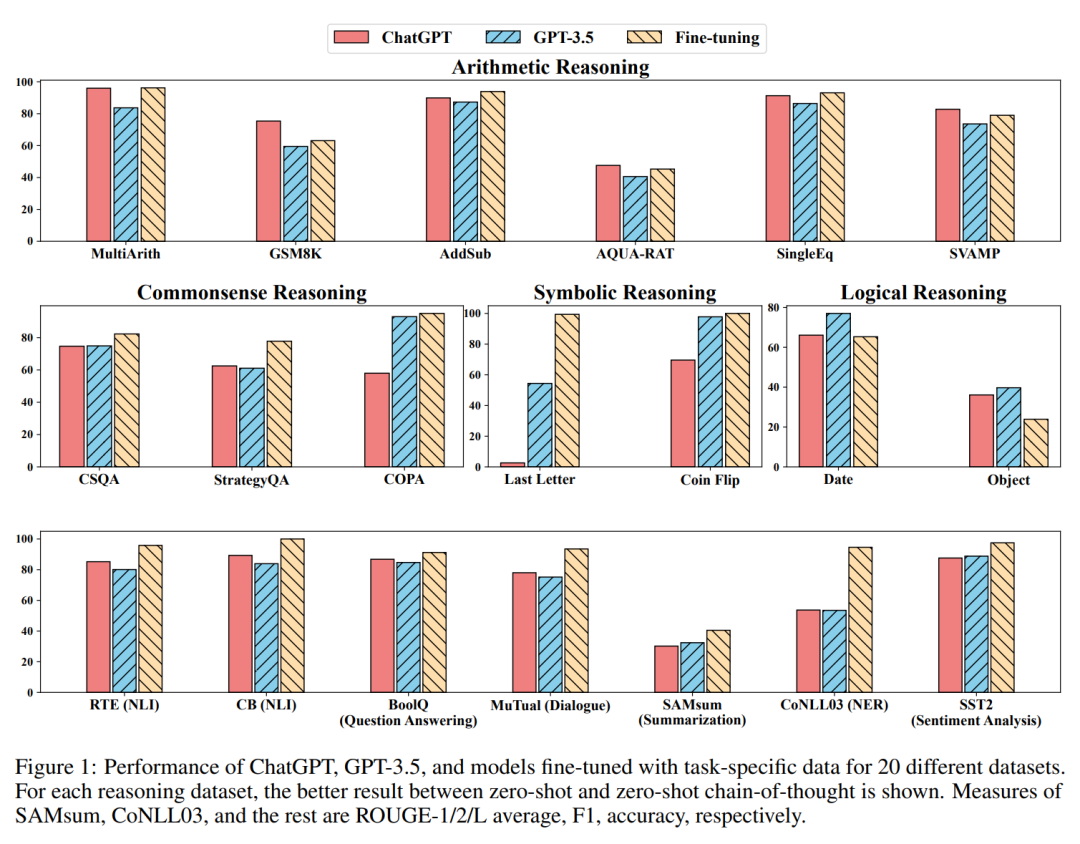
- 虽然 ChatGPT 作为一个通才模型显示了一些可以执行多个任务的能力,但它通常比针对给定任务进行微调的模型表现要差(见图 1 和第 4.3 节)。
- ChatGPT 的卓越推理(reasoning)能力在算术推理任务中得到了实验证实(第 4.2.1 节)。然而,ChatGPT 在常识、符号和逻辑推理任务中的表现通常不如 GPT-3.5,例如通过生成不确定的响应可以看出来(第 4.2.2 节)。
- ChatGPT 在偏向于推理能力的自然语言推断任务(第 4.2.3 节)和问答(阅读理解)任务(第 4.2.4 节)方面优于 GPT-3.5,例如确定文本对中的逻辑关系。具体来说,ChatGPT 更擅长处理与事实一致的文本(即,更擅长对蕴含而不是非蕴含进行分类)。
- ChatGPT 在对话任务方面优于 GPT-3.5(第 4.2.5 节)。
- 在摘要任务方面,ChatGPT 会生成更长的摘要,比 GPT-3.5 表现要差。然而,在 zero-shot 指令中明确限制摘要长度会损害摘要质量,从而导致性能降低(第 4.2.6 节)。
- 尽管显示出作为通才模型的前景,但 ChatGPT 和 GPT-3.5 在某些任务上都面临挑战,例如序列标注(第 4.2.7 节)。
- ChatGPT 的情感分析能力接近 GPT-3.5(第 4.2.8 节)。
方法
如前文所述,该研究主要比较了 ChatGPT 和 GPT-3.5 (textdavinci-003) 在不同任务下的 zero-shot 学习性能。具体而言,他们将任务指令 P 和测试问题 X 作为输入,模型用 f 表示,然后生成目标文本 Y = f (P, X) 来解决测试问题。不同任务的指令和输入格式如图 2 和图 3 所示。
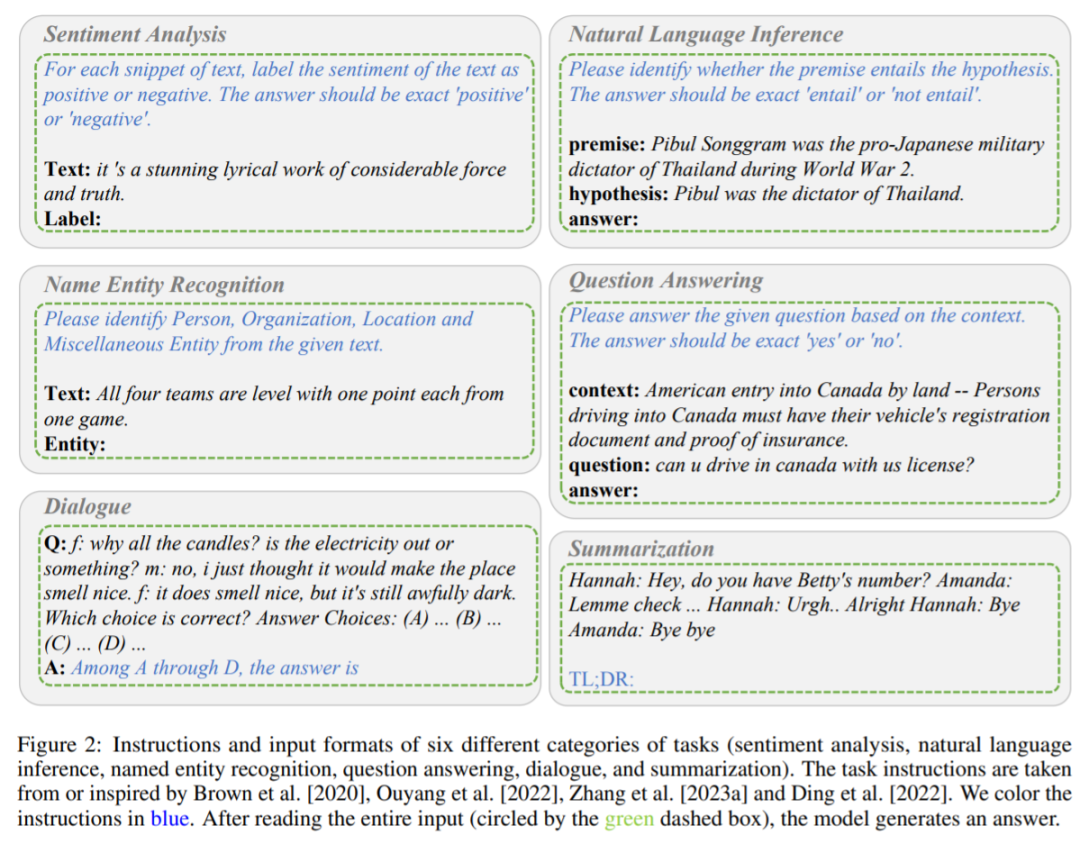
包含六种任务(情感分析、自然语言推理、命名实体识别、问答、对话和摘要)的指令和输入格式。指令为蓝色字体。
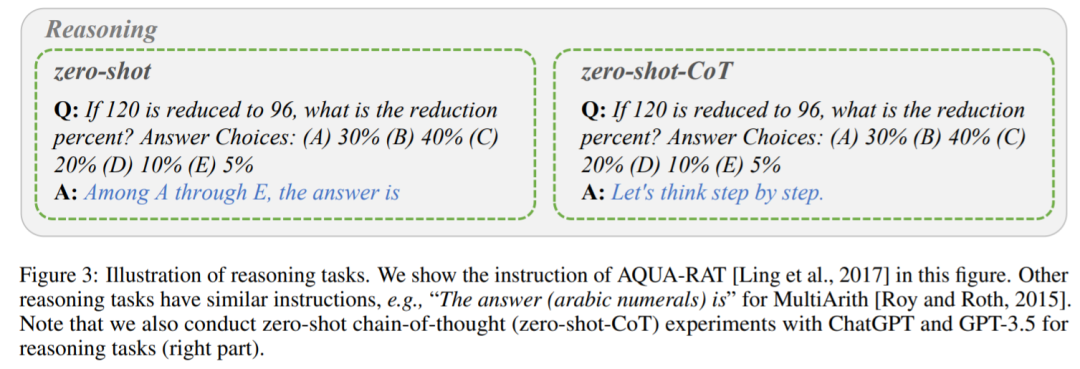
推理任务说明。
举例来说,当模型执行情感分析任务时,任务指令 P 将文本所包含的情感标记为积极或消极,则输出的答案为积极或消极。当模型在阅读了指令 P 和输入内容 X(内容为一部具有相当力量和真实性的令人惊叹的抒情作品)后,该模型经过判断,有望输出 Y 积极。
与上述单阶段 prompting 方法不同的是,该研究使用两阶段 prompting(Kojima 等人提出),来完成 zero-shot-CoT。
第一阶段采取「让模型一步一步思考(Let’s think step by step)」,指令 P_1 诱导模型生成基本原理 R。
第二阶段采用第一步生成的基本原理 R 以及原始输入 X 和指令 P_1 作为新的输入,引导模型生成最终答案。
之后一个新的指令 P_2 作为提取答案的触发语句。所有任务指令均取自 Brown、Ouyang、Zhang 等人研究,或受其启发。最后需要注意的是,每次对 ChatGPT 进行新的查询时,都要提前清除对话,以避免前面示例的影响。
实验
实验用 20 个不同的数据集来评估 ChatGPT 和 GPT-3.5,涵盖 7 类任务。
算术推理
ChatGPT 和 GPT-3.5 在没有或有 CoT 的情况下,在六个算术推理数据集上的准确率如表 2 所示。在没有 CoT 的实验中,ChatGPT 在其中 5 个数据集上的性能优于 GPT-3.5,显示了其强大的算术推理能力。
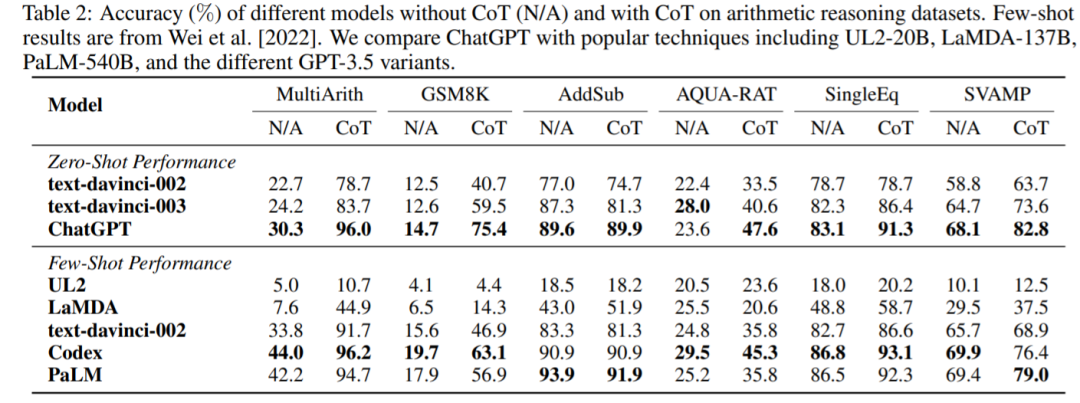
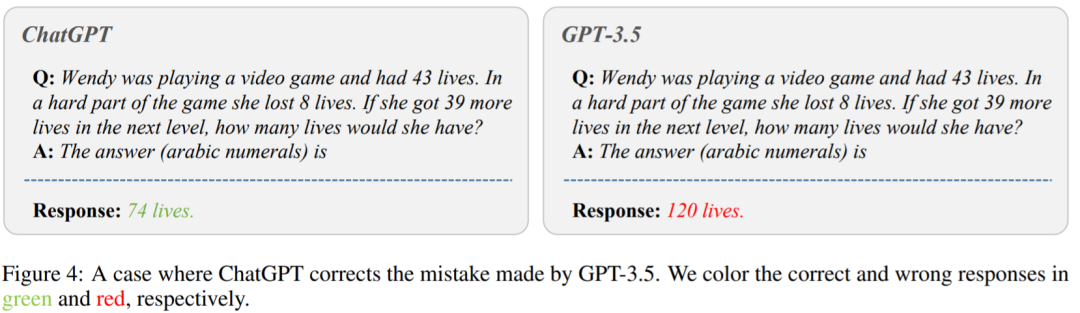
图 4 显示了 GPT-3.5 给出错误答案的情况。在图的左侧,问「温迪在玩电子游戏,有 43 条命。在游戏的艰难部分,她失去了 8 条生命。如果她在下一关多得到 39 条命,她会有多少条命?」ChatGPT 给出了正确答案。然而,GPT-3.5 生成了一个错误的答案。可以看出,在使用 CoT 时,ChatGPT 的性能都比 GPT-3.5 好得多。
常识、符号和逻辑推理
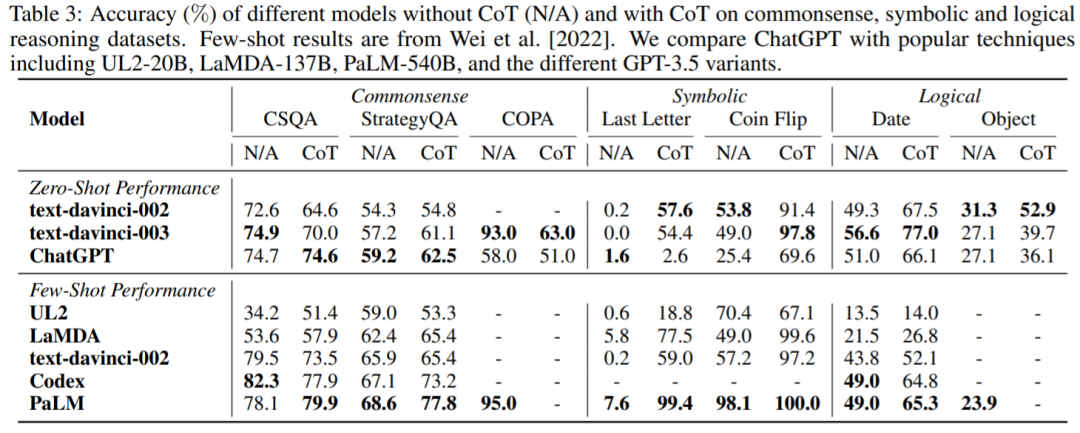
表 3 报告了 ChatGPT 与流行 LLM 在常识、符号和逻辑推理数据集上的准确率。可以得到如下观察结果:首先,使用 CoT 可能并不总是在常识推理任务中提供更好的性能,常识推理任务可能需要更细粒度的背景知识。其次,与算术推理不同,ChatGPT 在很多情况下的表现都比 GPT-3.5 差,说明 GPT-3.5 的相应能力更强。
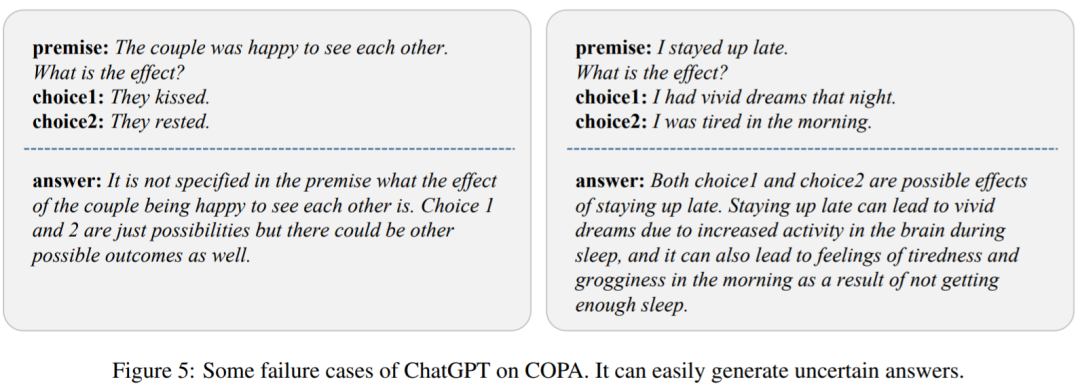
为了分析原因,该研究在图 5 中展示了 ChatGPT 的几个失败案例。我们可以观察到 ChatGPT 很容易产生不确定的响应,从而导致性能不佳。
自然语言推理
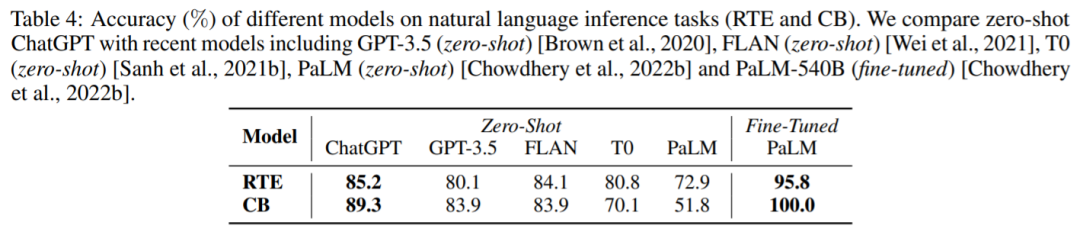
表 4 展示了不同模型在两个自然语言推理任务上的结果:RTE 和 CB。我们可以看到,在 zero-shot 设置下,ChatGPT 可以取得比 GPT-3.5、FLAN、T0 和 PaLM 更好的性能。这证明 ChatGPT 在 NLP 推理任务中,具有较好的 zero-shot 性能。
问答
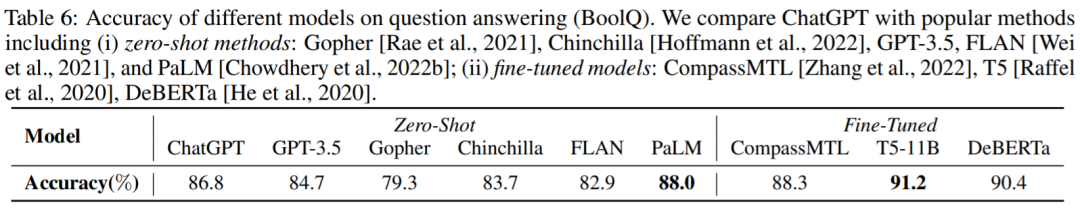
表 6 报告了不同模型在 BoolQ 数据集的准确率,ChatGPT 优于 GPT-3.5 。这表明 ChatGPT 可以更好地处理推理任务。
对话
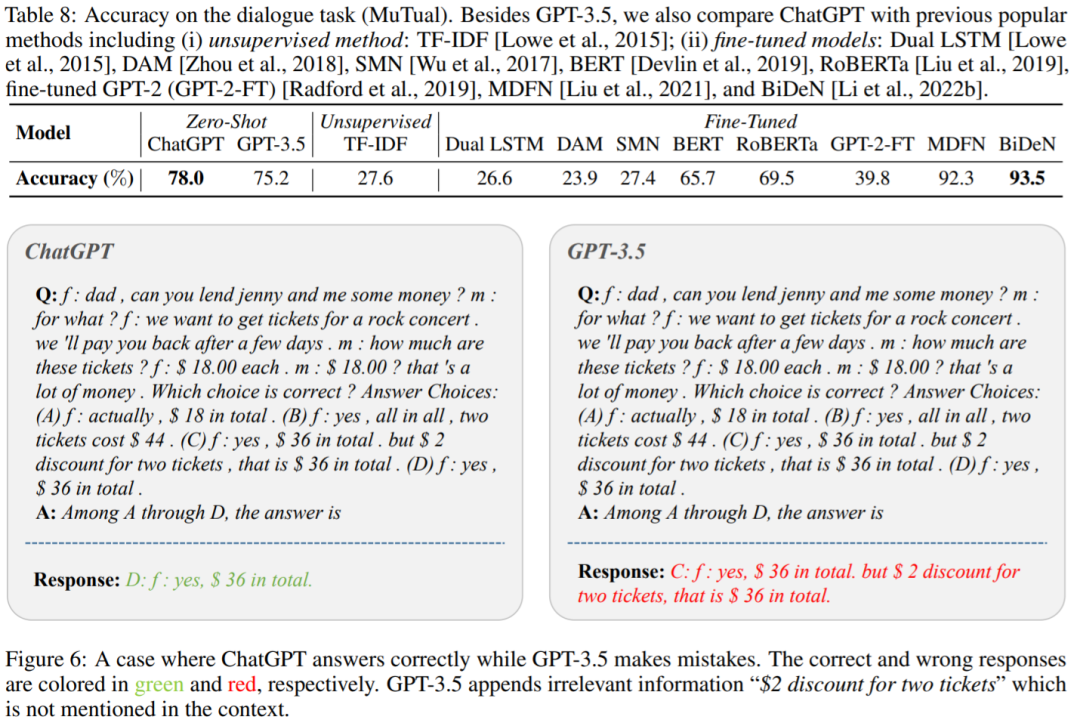
表 8 中显示了 ChatGPT 和 GPT-3.5 在 MuTual 数据集(多轮对话推理)上的准确率。正如预期的那样,ChatGPT 大大优于 GPT-3.5。
图 6 为一个具体的示例,我们可以看到 ChatGPT 能够更有效地对给定的上下文进行推理。这再次印证了 ChatGPT 超强的推理能力。
生成摘要
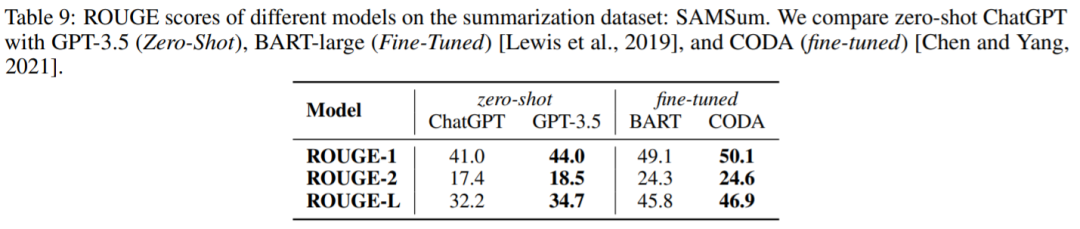
表 9 报告 ChatGPT 和 GPT-3.5 在 SAMSum 数据集上的 ROUGE 得分,令人惊讶的是,ChatGPT 在所有指标上都不如 GPT-3.5。
命名实体识别
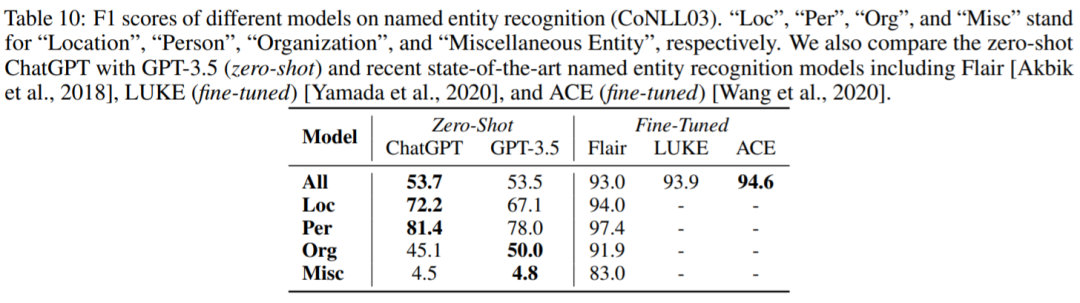
表 10 报告了 ChatGPT 和 GPT-3.5 在 CoNLL03 上的 zero-shot 性能。我们可以看到 ChatGPT 和 GPT-3.5 的整体性能非常相似。
情感分析
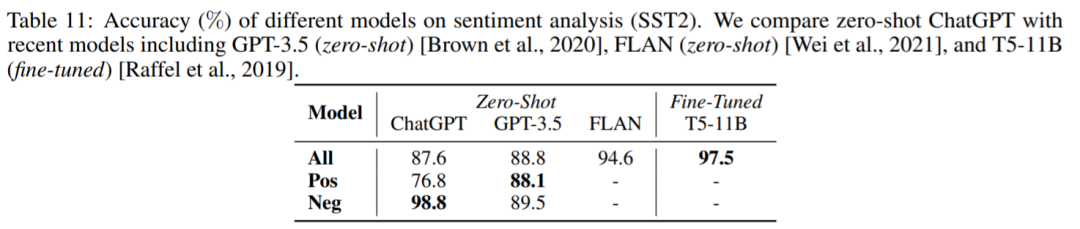
表 11 比较了不同模型在情感分析数据集 SST2 上的准确率。令人惊讶的是,ChatGPT 的表现比 GPT-3.5 差了大约 1%。
如需了解更多内容,请参考原论文。
OpenAI在移动端ChatGPT中新增了智能等级选择器,用户长按发送箭头即可调出,并提供即时、思考、扩展三种推理模式;网页版则增加了长对话目录功能,当回复数达到五条时,用户可通过目录快速跳转;此外,GPT-5.5即时模型的更新,使得回答更加自然流畅。
开源库TanStack遭网络攻击波及OpenAI内部设备。黑客窃取了可签署数字证书的凭证,但核心代码与用户数据未泄露。OpenAI已撤销相关证书,并要求Mac用户在6月12日前将ChatGPT应用更新至最新版本,否则旧版将无法使用。iOS与Windows版本不受影响。
消息称苹果拆解谷歌 Gemini 模型,为 iPhone 17 等打造专属本地 AI 一则新动态,揭示了科技巨头在AI赛道的最新布局。根据科技媒体The Information于3月25日的报道,苹果公司正在采取一种相当深入的技术策略,为其未来的iPhone 17系列等设备打造更小巧、安全的端侧AI
全球最顶尖的 AI 学术会议,正在被 AI “攻陷” 这事儿听起来像个地狱笑话,但很不幸,它正在成为现实。一组最新数据揭示了一个颇为讽刺的局面:在即将到来的 ICLR 2026 会议上,竟有超过1.5 万份审稿意见被判定完全由 AI 代写。 想象一下这个场景:你耗费心血完成的论文,审稿人或许压根没细

Go语言考试指南:全面了解考试内容,需要具体代码示例Go语言作为一种现代化的编程语言,越来越受到广大程序员的关注和青睐。对于那些希望通过考试来证明自己Go语言技能的人来说,了解考试内容并准备充分是非常重要的。本文将全面介绍Go语言考试的内容,并提供具体的代码示例,帮助读者更好地备战考试。1.基础知识在考试中,对于Go语言的基础知识的理解是至关重要的。包括但
要考Tableau证书,首先访问Tableau官方网站,了解并选择适合自己的证书类型,然后注册考试,完成学习和准备后,通过在线考试即可获得证书。选择证书时,需考虑个人职业目标和技能水平:1.DesktopSpecialist适合初学者,考核基本操作;2.CertifiedAssociate和Professional适合有经验者,前者侧重复杂分析,后者要求高级技能和项目管理。准备考试需:1.通过TableaueLearning课程学习;2.使用TableauPublic或Desktop练习;3.利用社区资源
本站7月14日消息,OpenAI因涉嫌使用限制性保密协议(NDA)限制员工发声而再次受到审查。据《华盛顿邮报》报道,举报人致信美国证券交易委员会,称OpenAI强迫员工签署“非法限制性”协议,阻止他们披露公司技术潜在的危害。该举报信指控OpenAI违反了美国证券交易委员会的规定,该规定旨在保护员工向联邦当局举报其疑虑的权利并防止报复行为。此前,举报人已于6月份正式向美国证券交易委员会提交了投诉。图源Pexels举报信中要求美国证券交易委员会“采取迅速果断的措施”来执行他们认为OpenAI已经违反的规定。涉
考前必读:Go语言考试常见问题解答Go语言作为一门快速发展的编程语言,其在企业级应用开发中已经逐渐得到广泛应用。对于想要提升自己的技能水平或参加相关考试的同学来说,熟练掌握Go语言是非常重要的。在备战考试时,了解一些常见问题及其解答,同时掌握相应的代码示例,将有助于提高应试效率和通过考试。本篇文章将针对Go语言考试中的常见问题进行解答,并提供具体的代码示例,
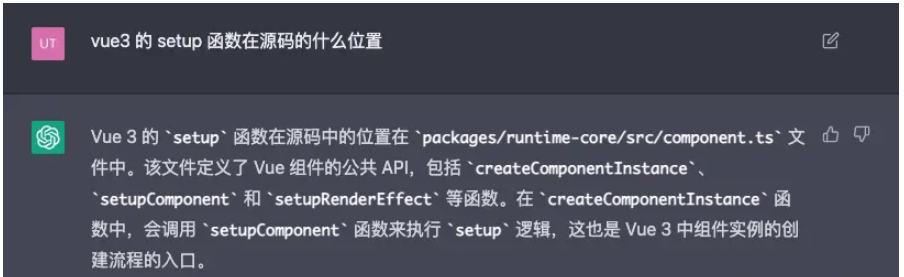
实战setupsetup函数在什么位置呢,我们不知道他的实现函数名称,于是问一下ChatGPT:ChatGPT告诉我,setup函数在packages/runtime-core/src/component.ts文件中。众所周知,runtime-core是Vue3的运行时核心代码。我们进去看一眼。按照它所说的,我们找到了setupComponent和createComponentInstance函数,并没有找到setupRenderEffect函数,ChatGPT的只知道2021年以前的知识,Vue3代码经
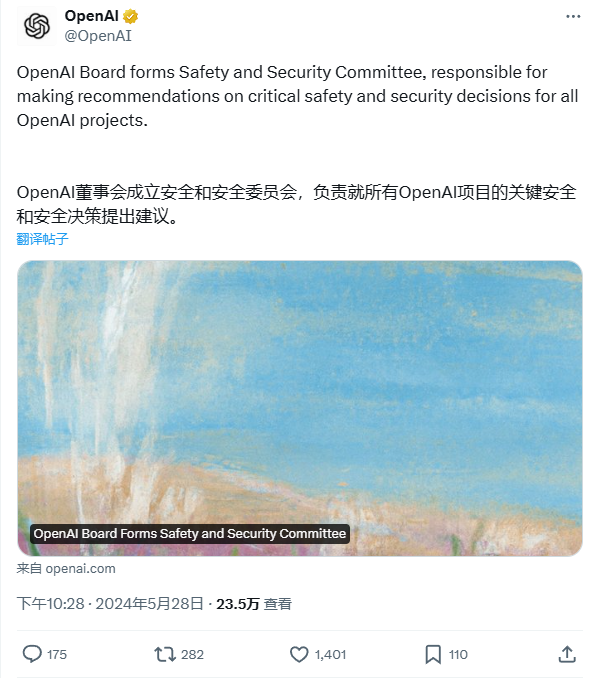
本网站5月29日消息,OpenAI宣布成立安全与安保委员会,负责就OpenAI项目和运营的关键安全与保障决策提出建议。该委员会目前首要任务是在未来90天内评估并进一步制定OpenAI的发展流程和保障措施。90天结束后,安全与保障委员会将与全体董事会分享其建议。据介绍,该委员会将由董事会BretTaylor(主席)、AdamD'Angelo、NicoleSeligman和OpenAI首席执行官SamAltman领导。除此之外,OpenAI技术和政策专家AleksanderMadry(准备工作主管)、Lili





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



