

深度剖析Tesla自动驾驶技术方案
01感知:构建实时的4D自动驾驶场景1.特斯拉摄像头布局特斯拉的摄像头视野可以覆盖车身周围360°,在前向有120°鱼眼、长焦镜头用于加强观测,布局如上图。2.特斯拉图像数据预处理特斯拉采用的是36Hz的1280*960-12bit的图像原始数据,这相对于只有8-bit的ISP后处理数据多了4位信息,动态方位扩大了16倍。特斯拉这样处理的原因有2个:1)ISP基于rule-base的算法对原始信号做了自动对焦(AF)、自动曝光(AE)、自动白平衡(AWB)、坏点校正(DNS)、高动态范围成像(HDR)
01 感知:构建实时的4D自动驾驶场景
1.特斯拉摄像头布局
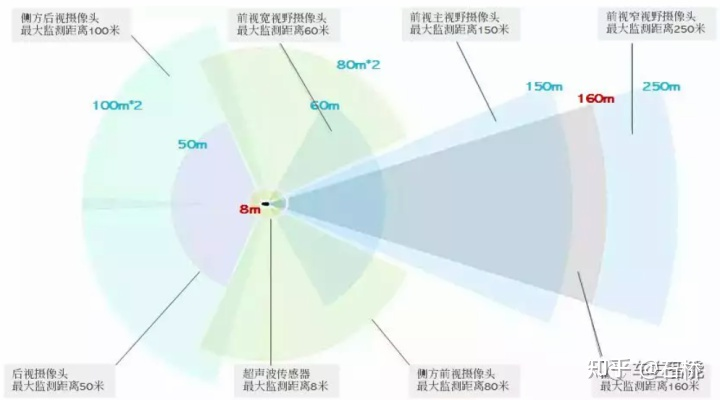
特斯拉的摄像头视野可以覆盖车身周围360°,在前向有120°鱼眼、长焦镜头用于加强观测,布局如上图。
2.特斯拉图像数据预处理
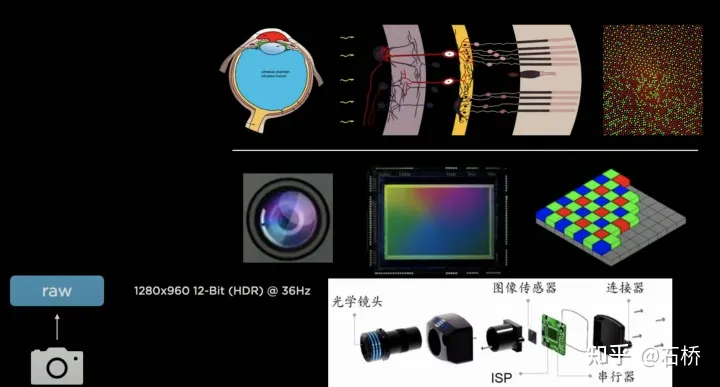
特斯拉采用的是36Hz的1280*960-12bit的图像原始数据,这相对于只有8-bit的ISP后处理数据多了4位信息,动态方位扩大了16倍。特斯拉这样处理的原因有2个:
1) ISP基于rule-base的算法对原始信号做了自动对焦(AF)、自动曝光(AE)、自动白平衡(AWB)、坏点校正(DNS)、高动态范围成像(HDR)、颜色校正(CCM)等,这些满足于人眼可视化需求,但不一定是自动驾驶的需要。相对于rule-base的ISP,神经网络的处理能力更为强大,能够更好的利用图像的原始信息,同时避免ISP带来的数据损失。
2) ISP的存在不利于数据的高速传输,影响图像的帧率。而将对原始信号的处理放在网络运算中,速度要快很多。
这种方式跨过了传统类似ISP的专业知识,直接从后端需求驱动网络学习更强的ISP能力,可以强化系统在低光照、低可见度条件下超越人眼的感知能力。基于这个原理Lidar、radar的原始数据用于网络拟合应该也是更好的方式。
3.backbone网络:Designing Network Design Spaces
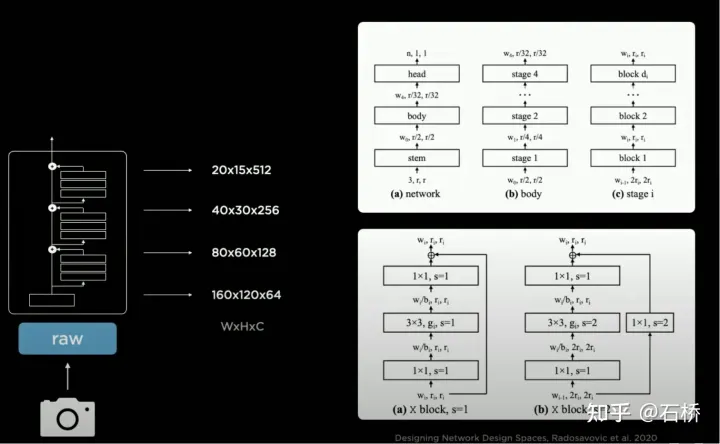
RegNet
特斯拉采用的是RegNet,相比于ResNet进行了更高一层的抽象,解决了NAS搜索设计空间(将卷积、池化等模块:连接组合/训练评估/选最优)固定、无法创建新模块的弊端,可以创建新颖的设计空间范式,能够发掘更多的场景适配新的"ResNet",从而避免专门去研究设计神经网络架构。如果出来更好的BackBone可以替换这部分。
4. neckwork : EfficientDet: Scalable and Efficient Object Detection
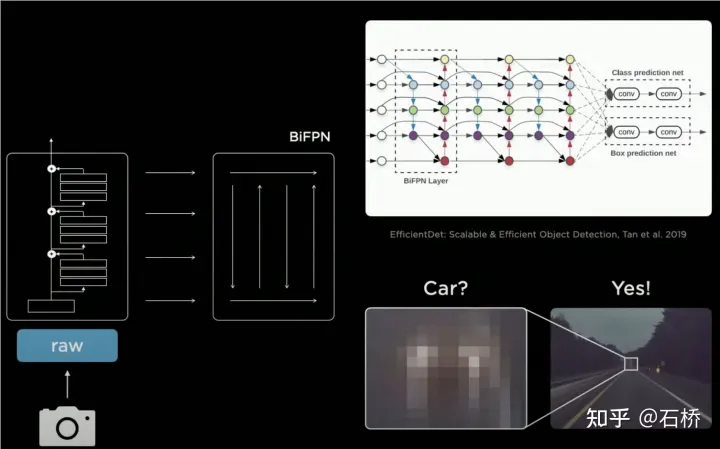
BiFPN
- PANet比FPN更准是因:在FPN自顶向下的单一路径流的基础上又额外增加了自底向上的路径流,也因此带入更高的参数与计算;
- BiFPN移除了只有一个输入的节点(最上层和最下层),因为网络的目的是融合特征,所以没有融合能力的节点直接连接就可以。
- BiFPN将输入直接连接到输出节点,在不增加计算的情况下,融合了更多特征。
- BiFPN将基础结构进行了多层堆叠,能够融合出更高纬度的特征。
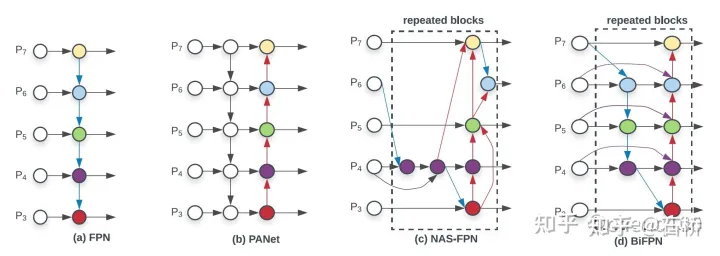
FPN->BiFPN
5.BEV Fusion:FSD感知的空间理解能力
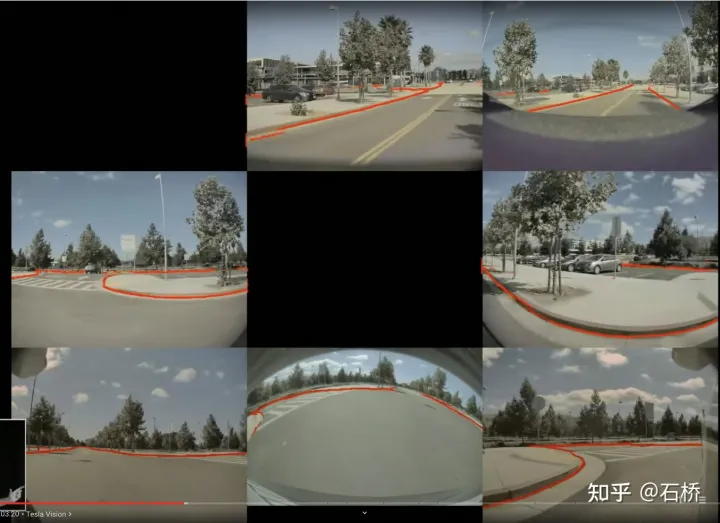
2D感知
在BEV出现之前,自动驾驶感知主流方案都是基于相机的2D Image Space,但是感知的下游应用方-决策和路径规划都是在车辆所在的2D BEV Space进行的,感知与规控之间的壁垒阻碍了FSD的发展。为了消除这个壁垒,就需要将感知从2D图像空间后置到2D的自车参考系空间,即BEV空间。
基于传统技术:
会采用IPM(Inverse Perspective Mapping)假设地面为平面利用相机-自车外参将2D Image Space转换为2D的自车空间,即BEV鸟瞰空间。这里有个很明显的缺陷:平面假设在面对道路起伏和上下坡时便不在成立。
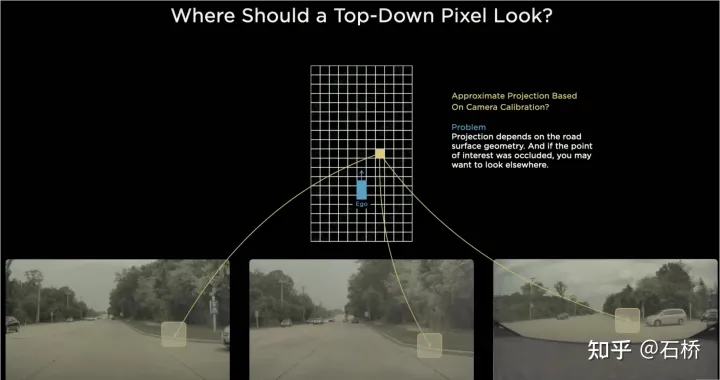
多相机接边拼接问题
由于每个摄像头的FOV有限,所以即使借助IPM将2D Image Space转换到2D BEV空间还需要解决多个相机图像的BEV空间拼接。这其实需要高精度的多相机标定算法,而且需要在线的实时校正算法。总结来说,需要实现的就是将多相机2D图像空间特征映射到BEV空间,同时解决由于标定和非平面假设引起的变换重叠问题。
Tesla基于Transformer的BEV Layer的实现方案:
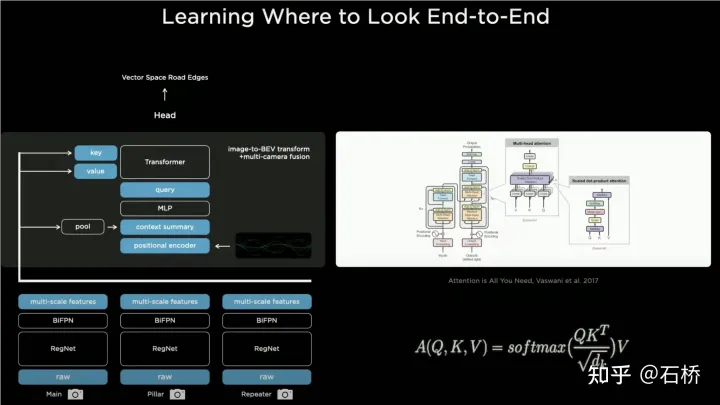
BEV_FUSION
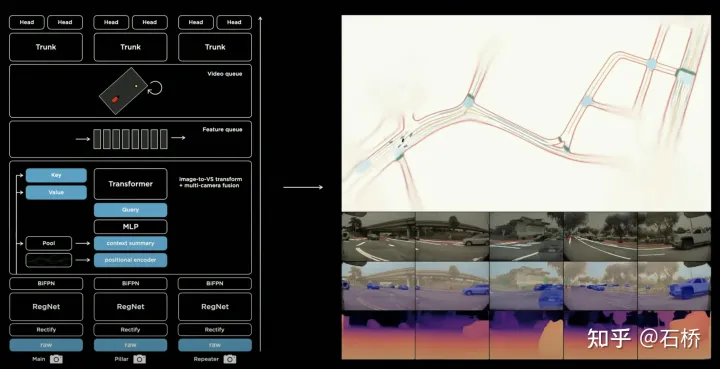
首先在各个相机分别通过CNN主干网络和BiFPN提取多尺度特征图层,多尺度特征图层一方面通过MLP层生成Transformer的方法中所需的Key和Value,另一方面对多尺度Feature Map进行Global Pooling操作得到一个全局描述向量(即图中的Context Summary),同时通过对目标输出BEV空间进行栅格化,再对每个BEV栅格进行位置编码,将这些位置编码与全局描述向量进行拼接(Concatenate)后再通过一层MLP层得到Transformer所需的Query。
在Cross Attention操作中,Query的尺度决定最终BEV层之后的输出尺度(即BEV栅格的尺度),而Key和Value分别处于2D图像坐标空间下,按照Transformer的原理,通过Query和Key建立每个BEV栅格收到2D图像平面像素的影响权重,从而建立从BEV到输入图像之间的关联,再利用这些权重加权由图像平面下的特征得到的Value,最终得到BEV坐标系下的Feature Map,完成BEV坐标转换层的使命,后面就可以基于BEV下的Feature Map利用已经成熟的各个感知功能头来直接在BEV空间下进行感知了。BEV空间下的感知结果与决策规划所在的坐标系是统一的,因此感知与后续模块就通过BEV变换紧密地联系到了一起。
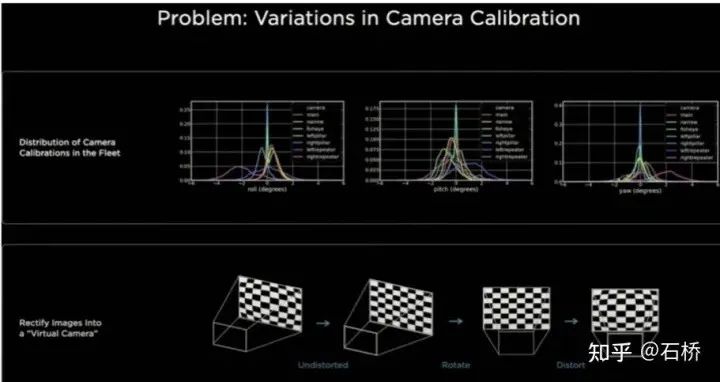
Calibration
通过这种方法,实际上相机外参以及地面几何形状的变化都在训练过程中被神经网络模型内化在参数里边。这里存在的一个问题就是使用同一套模型参数的不同车子的相机外参存在微小的差异,Karparthy在AI Day上补充了一个Tesla应对外参差异的方法:他们利用标定出来的外参将每辆车采集到的图像通过去畸变,旋转,恢复畸变的办法统一转换到同样一套虚拟标准相机的布设位置,从而消除了不同车相机外参的微小差别。
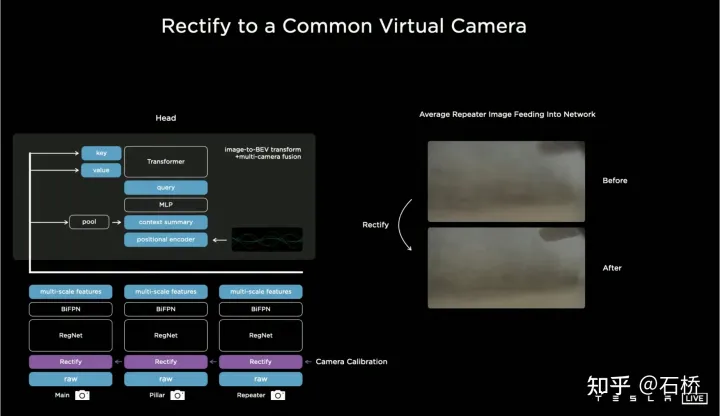
BEV的方法是一个非常有效的多相机融合框架,通过BEV的方案,原本很难进行正确关联的跨多个相机的近处的大目标的尺寸估计和追踪都变得更加准确、稳定,同时这种方案也使得算法对于某一个或几个相机短时间的遮挡,丢失有了更强的鲁棒性。简而言之,BEV解决了多摄像头的图像融合拼接,增加了鲁棒性。
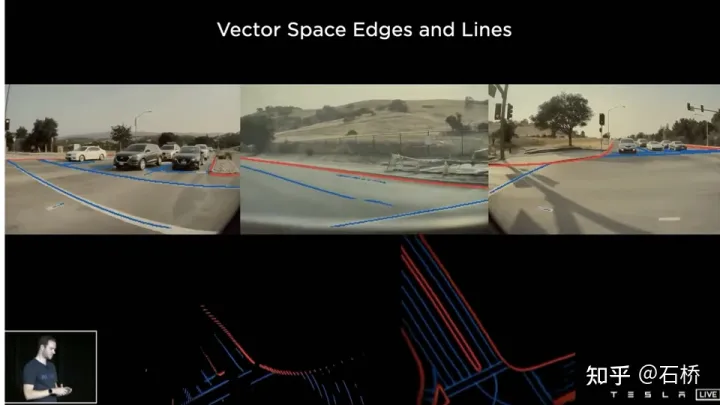
解决了多相机的车道线和边界融合
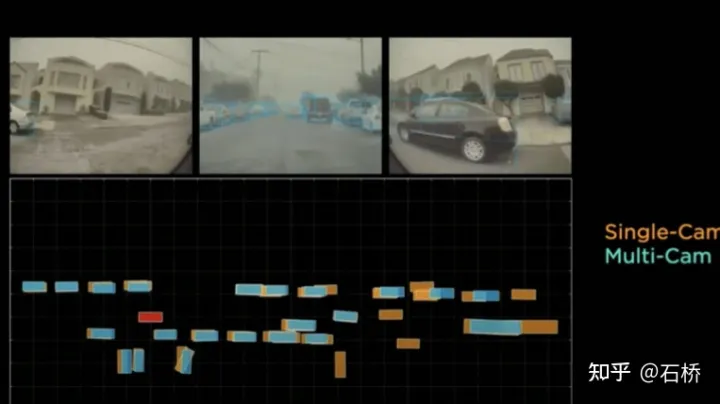
障碍物变的更稳定
(从PPT来看,特斯拉初始的方案应该是主要应用了前向相机来做感知和车道线预测的。)
6.Video Neural Net Architecture:时空序列Feature构建
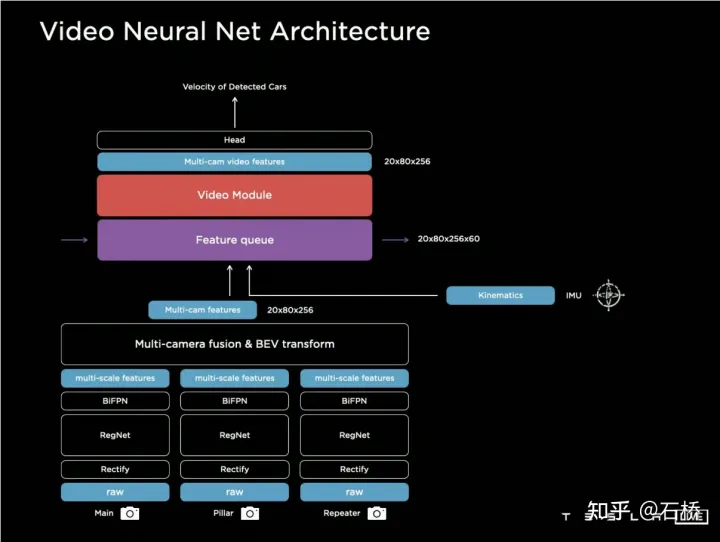
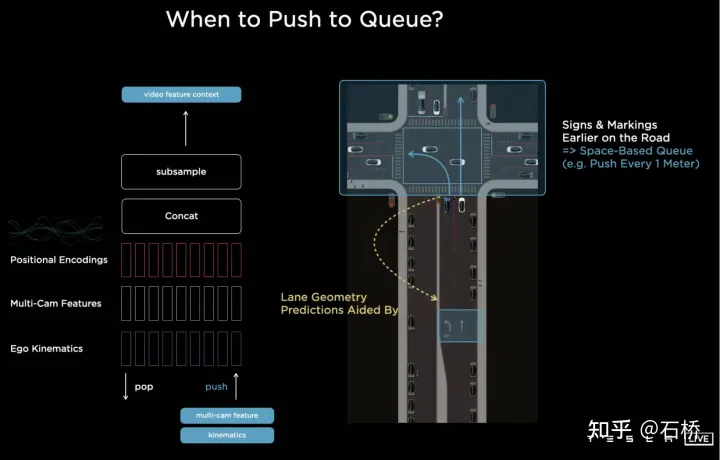
BEV的使用将感知从多相机分散的2D Image Space提升到2D的BEV 空间,但是自动驾驶实际的环境是一个4D的空间的问题,即便不考虑高程,也仍然缺少的一个维度是时间。Tesla通过使用具有时序信息的视频片段替代图像对神经网络进行训练,从而使感知模型具有短时间的记忆的能力,实现这个功能的方法是分别引入时间维度和空间维度上的特征队列进入神经网络模型。规则:每隔27毫秒push queue或每走过每隔1米远就会连同运动信息缓存在视频序列。
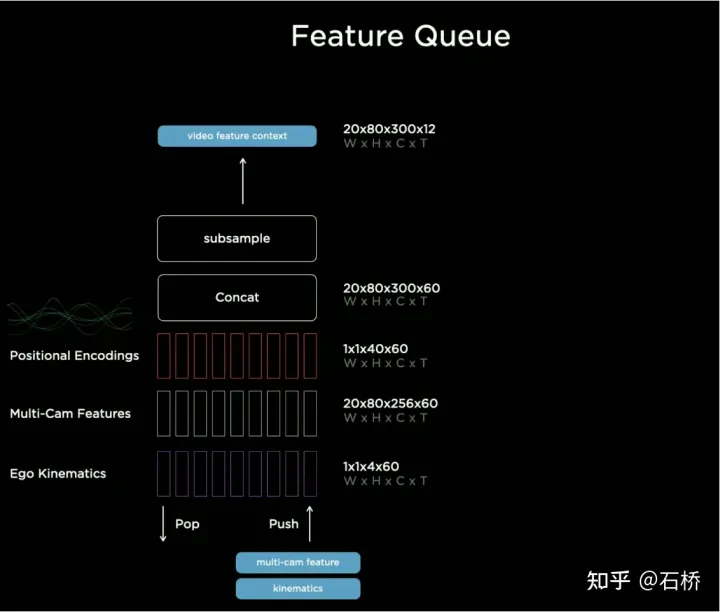
对于如何融合时序信息,Tesla尝试了三种主流的方案:3D卷积,Transformer以及RNN。这三种方法都需要把自车运动信息与单帧感知结合起来,Karparthy表示自车运动信息只使用了包括速度和加速度的四维信息,这些运动信息可以从IMU中获取,然后与BEV空间下的Feature Map(20x80x256)还有Positional Encoding相结合(Concatenate),形成20x80x300x12维的特征向量队列,这里第三维由256维视觉特征 + 4维运动学特征(vx, vy, ax, ay)以及40维位置编码(Positional Encoding)构成,因此300 = 256 + 4 + 40,最后一维是降采样过后的12帧时间/空间维度。
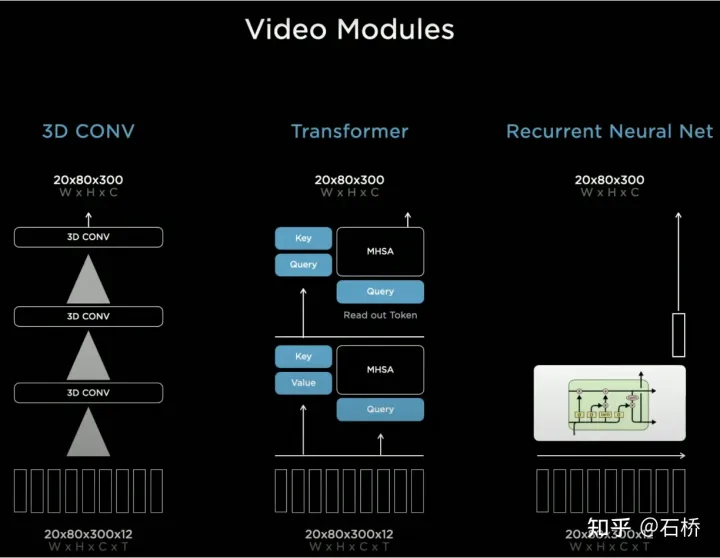
3D Conv, Transformer,RNN都能处理序列信息,三者在不同任务上各有长短,但大部分时间采用哪个方案其实区别不大,然而AI Day上Karparthy另外分享了一个简单有效,而且效果十分有趣可解释的方案叫做Spatial RNN。与上面三个方法有所不同,Spatial RNN由于RNN原本就是串行处理序列信息,帧间前后顺序得以保留,因此无需将BEV视觉特征进行位置编码就可以直接给进RNN网络,因此可以看到这里输入信息就只包括20x80x256的BEV视觉Feature Map和1x1x4的自车运动信息。
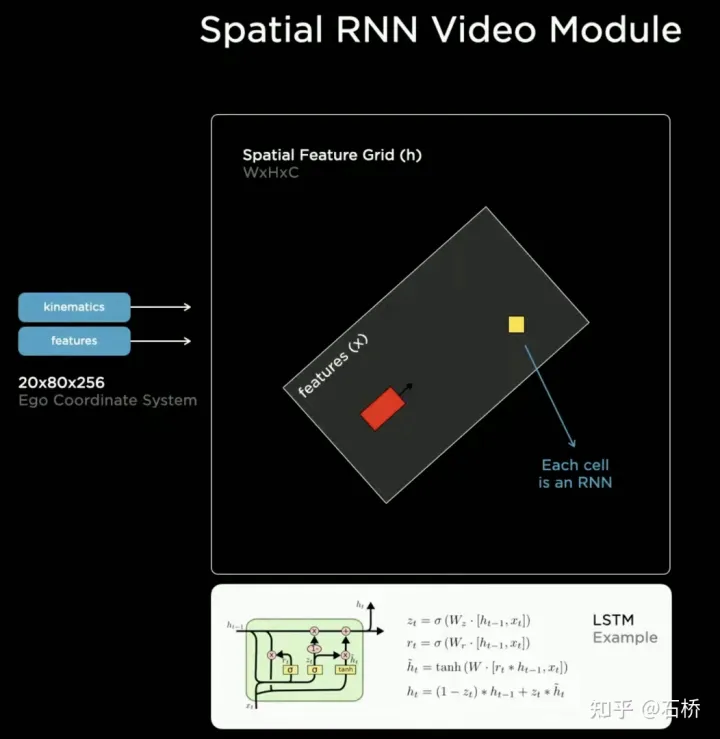
Spatial特征在CNN中常指图像平面上的宽高维度上的特征,这里Spatial RNN中的Spatial则指的是类似以某时刻的BEV坐标为基准的一个局部坐标系里的两个维度。这里为了进行说明使用了LSTM的RNN层,LSTM的优势在于其可解释性强,这里作为例子进行理解再合适不过了。
LSTM特点在于Hidden State里面可以保留前面长度可变的N个时刻的状态的编码(也即短时记忆),然后当前时刻可以通过输入和Hidden State决定哪一部分记忆的状态需要被使用,哪一部分需要被遗忘等等。在Spatial RNN中,Hidden State是一个比BEV栅格空间更大的矩形栅格区域,尺寸为(WxHxC)(见上图,WxH大于20x80的BEV尺寸),自车运动学信息决定前后BEV特征分别影响的是Hidden State的哪一部分栅格,这样连续的BEV数据就会不断对Hidden State的大矩形区域进行更新,且每次更新的位置与自车运动相符合。经过连续的更新后,就形成了一个类似局部地图一样的Hidden State Feature Map如下图所示。
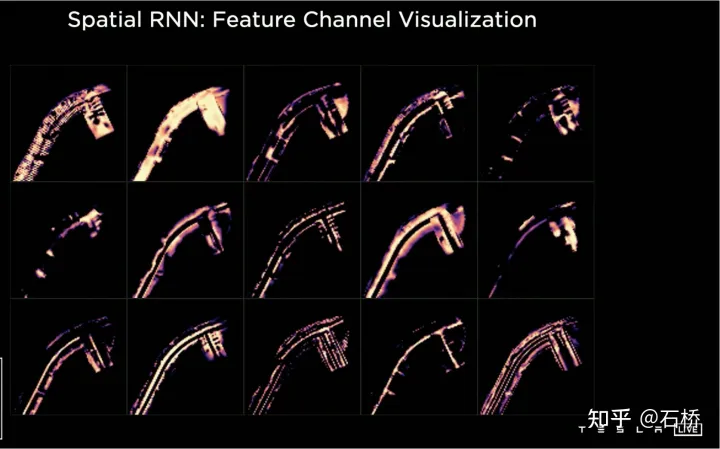
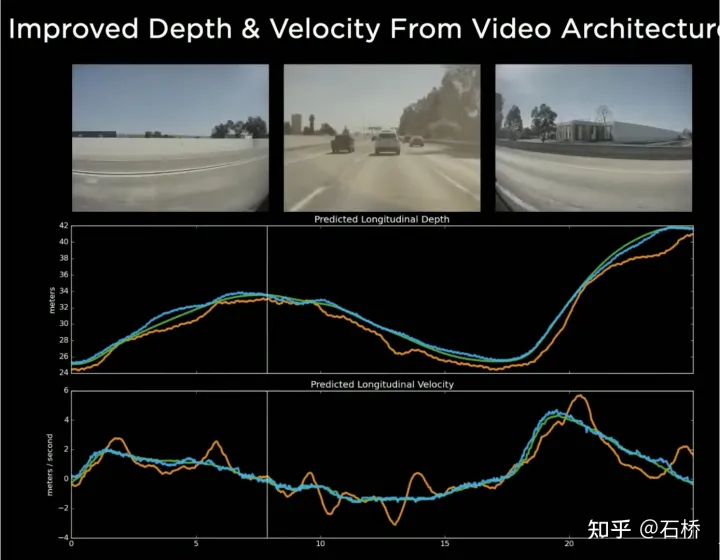
时序队列的使用赋予了神经网络获得帧间连续的感知结果的能力,与BEV结合后则使FSD获得了应对视野盲区和遮挡,选择性地对局部地图进行读写的能力,正因为有了这样的实时的局部地图构建的能力,FSD才能不依赖高精地图进行城市中的自动驾驶。这里具备不只是3D的地图能力,其实是局部4D场景构建能力,可用于预测等。在Occupancy出来后,普遍认为基于Spatial RNN改为了上述中的transformer方案。
7.Occupancy Network:BEV从2D走向3D
BEV的2D鸟瞰图很显然与真实自动驾驶面临的3D场景还有差距,所以必然存在某些场景下BEV2D感知失效的情况。在2021年特斯拉就具备了深度构建的能力,所以从2D走向3D只是时间问题,2022年就带来了Occupancy Network,它是BEV网络在高度方向进行了进一步的扩展,将BEV坐标系下2D栅格位置编码生成的Query升级为3D栅格位置编码生成的Query,用Occupancy Feature替代了BEV Feature。
在CVPR2022上,Ashork给出了使用Occupancy Feature而不使用基于图像深度估计的原因:
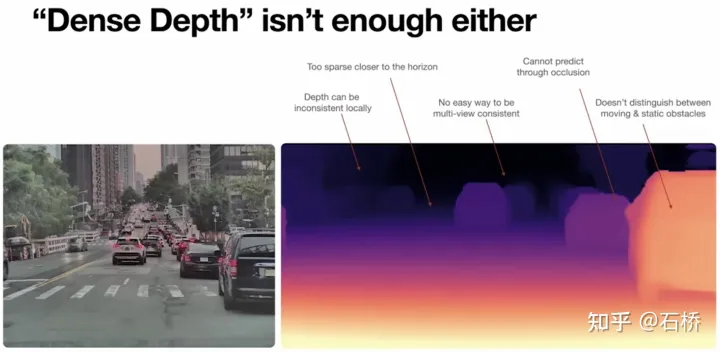
1)深度估计近处是OK的,但是远处深度就不一致,远处越靠近地面的地方深度值点越少(这是受限于图像的成像原理导致的,在20m外一个像素代表的纵向距离可能超过了30cm),而且数据难以被后续规划流程所使用。
2)深度网络基于回归构建,很难通过遮挡来进行预测,所以边界上难以进行预测,可能平滑的从车辆过渡到背景。
使用Occupancy的优势如下:
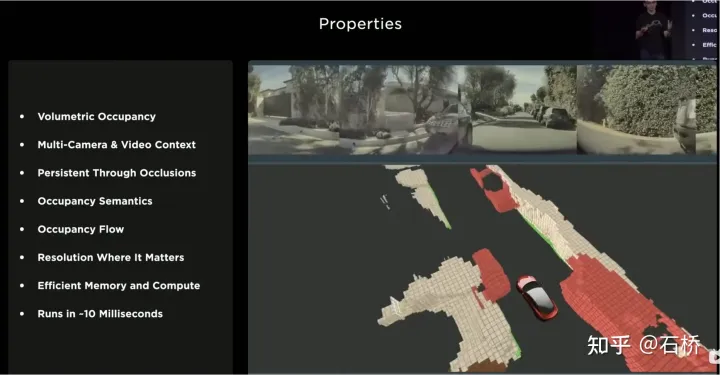
Occupancy优点
1)在BEV空间生成了统一的体素,可以预测任意一个体素的占用概率
2)获取了所有相机的视频流,并且是统一的(没有lidar-camera融合的问题,信息的维度比lidar也要高)
3)能够实时预测被遮挡物体的状态(Occupancy的动态描述能力是从3D向4D过渡)
4)可以为每个体素生成对应的语义类别(图像的识别能力是远强于lidar)
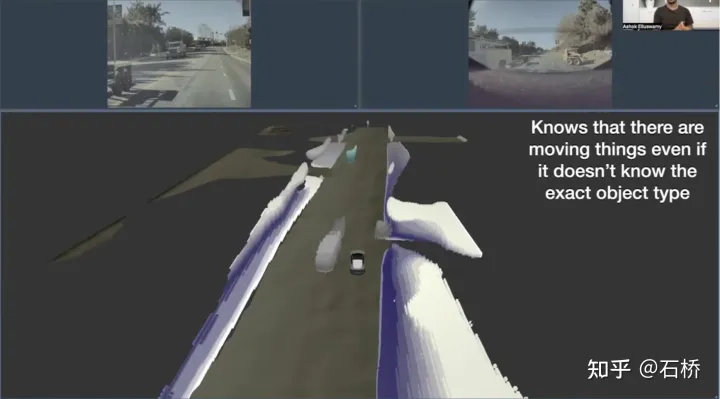
即使不识别类别也能处理运动物体
5)可以为每个体素预测其运动状态,对随机运动进行建模
6)各个位置的分别率是可以调整的(也就是具备BEV空间变焦能力)
7)得益于特斯拉的硬件,Occupancy具有高效的存储和计算优势
8)10ms内可以完成计算,处理频率可以很高(36Hz的图像输出能力已经强于10Hz的lidar频率)
Occupancy的方案相比于bounding box的感知方案优点在于:
可以描述不具有固定bounding box,可以随意变换形态,任意移动的未知类别物体,将障碍物的描述粒度从box提升到了voxel粒度,可以解决感知中很多的长尾问题。
来看下Occupancy整体方案:
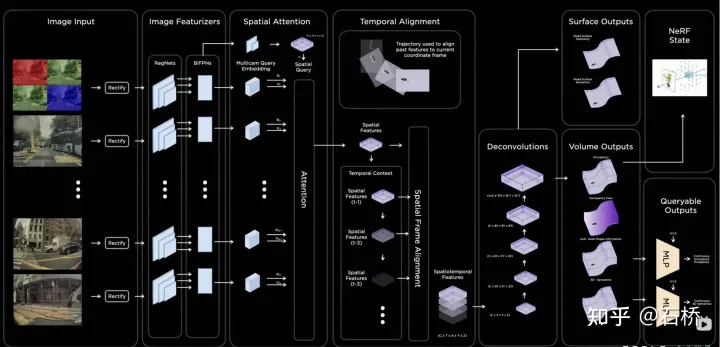
Occupancy Network
1)Image Input:输入原始图像信息,扩大了数据维度和动态范围
2)Image Featurers:RegNet+BiFPN提取多尺度的图像特征
3)Spatial Atention:通过带3D空间位置的spatial query对2D图像特征进行基于attention的多相机融合
实现方案1:根据每个相机的内外参将3D spatial query投影到2D特征图上,提取对应位置的特征。
实现方案2:利用positional embedding来进行隐式的映射,即将2D特征图的每个位置加上合理的positional embedding,如相机内外参、像素坐标等,然后让模型自己学习2D到3D特征的对应关系
4)Temporal Alignment:利用轨迹信息对每个frame的3D Occupancy Features按照时序进行空间上Channel维度的拼接,随着时间远近有一个权重的衰减,组合特征会进入Deconvolutions的模块来提高分辨率
5)Volume Outputs:输出固定大小栅格的占用率和占用流
6)Queryable Outputs:设计了一个隐式queryable MLP decoder,输入任意坐标值(x,y,z),用于获取更高分辨率的连续体素语义、占用率、占用流信息,打破了模型分辨率的限制
7)生成具有三维几何和语义的可行驶区域路面,有利于坡度、弯曲道路上的控制。
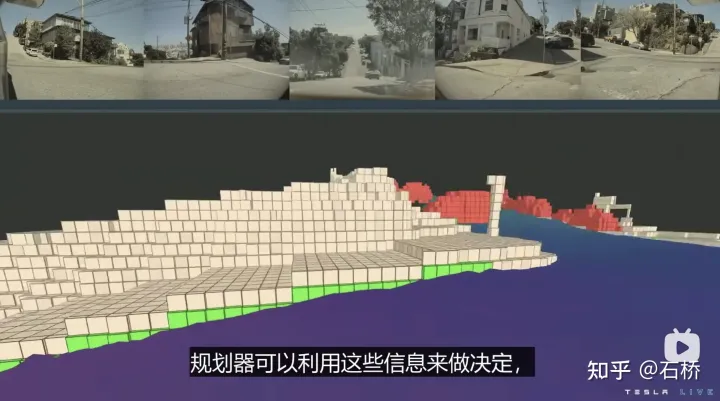
地面与Occupancy是一致的
8)NeRF state:nerf构建的是场景的几何结构,可以生成任意视角的图像,可以恢复高分辨率的真实场景。
如果能够用Nerf进行升级或替换,那么将具备还原真实场景的能力,而且这个场景还原能力将是过去-现在-未来的。对于特斯拉技术方案追求的4D场景自动驾驶应该是极大的补充和完善。
8.FSD Lanes Neural Network:预测车道的拓扑连接关系
只分割、识别出车道线是不够的,还需要推理获取车道之间的拓扑连接关系,这样才能用于轨迹规划。
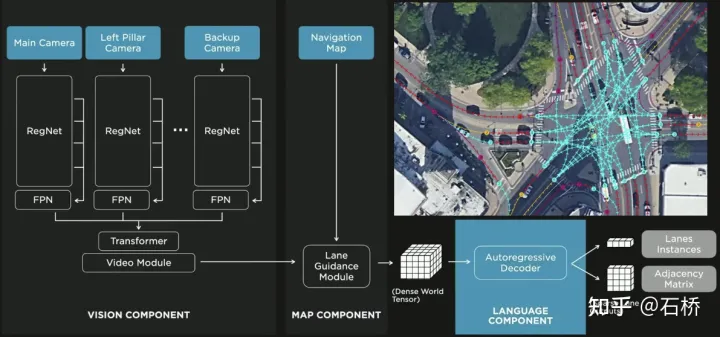
FSD车道线拓扑关系感知
1)Lane Guidance Module:使用了导航图中的道路的几何&拓扑关系,车道等级、数量、宽度、属性信息,将这些信息与Occupancy特征整合起来进行编码生成Dense World Tensor给到拓扑关系建立的模块,将视频流稠密的特征通序列生成范式解析出 稀疏的道路拓扑信息(车道节点lane segment和连接关系adjacent)。
2)Language Component:把车道相关信息包括车道节点位置、属性(起点,中间点,终点等)、分叉点、汇合点,以及车道样条曲线几何参数进行编码,做成类似语言模型中单词token的编码,然后利用时序处理办法进行处理。具体流程如下:
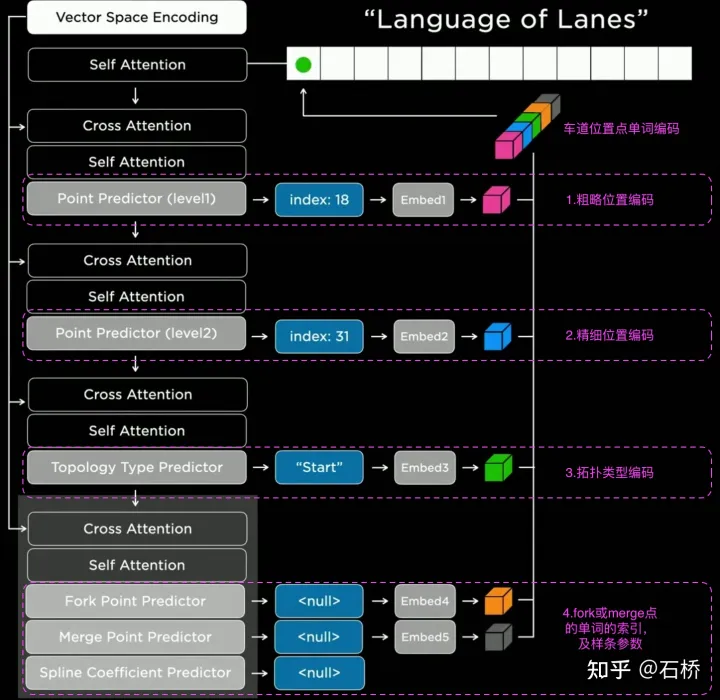
language of lanes 流程
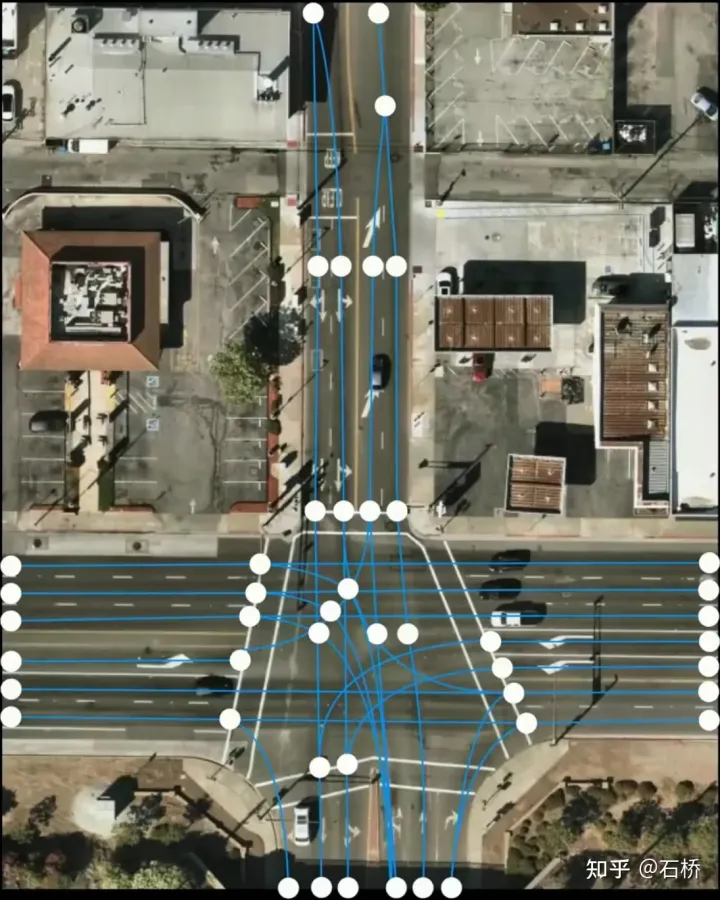
language of lanes
最终language of lanes表征的就是图中的拓扑连接关系。
9. Object Perception:感知预测其他交通参与者
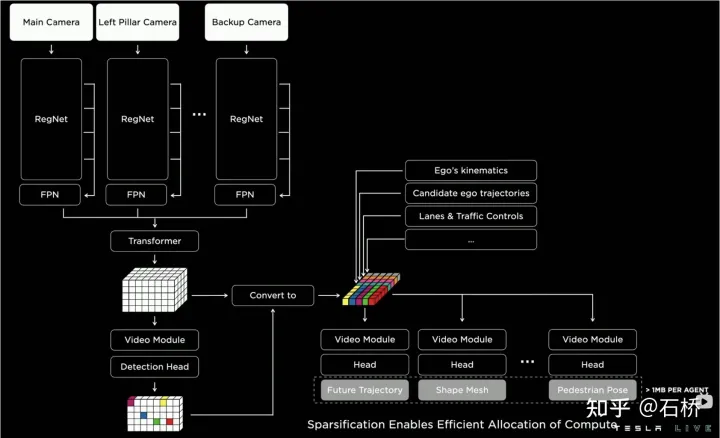
障碍物感知与预测
FSD的Object Perception是一个2-Step的方法,第1阶段先从Occupancy中识别出障碍物在3D空间中的位置,第2阶段将这些3D物体的张量concat一些运动学信息的编码(如自车运动,目标行驶车道线,交通灯交通信号等)然后在接入轨迹预测、物体建模、行人位姿预测等head。将复杂的感知Heads聚焦于有限的ROI区域,减少了处理延迟。从上图可以看到存在2步video module,分别服务于自车和它车的预测。
这里留下个疑问:上图中的2次video module有什么区别?效率上会不会有问题?
02 决策规划
1.复杂场景:与高频、多样交通参与者的交互规划
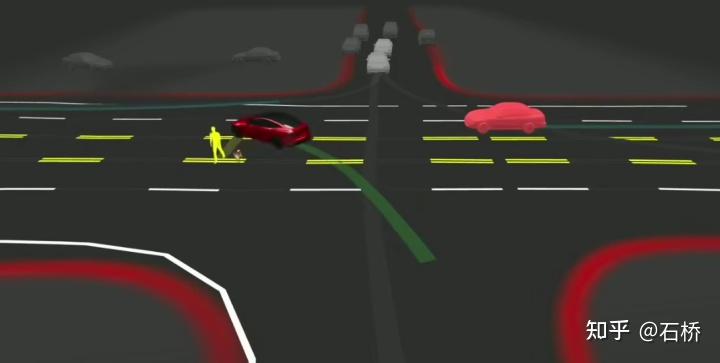
路口无保护左转的决策规划场景
上述这个场景决策规划的难点在于:
自车执行无保护左转通过路口场景过程中需要与行人、正常直行车辆交互,理解多方的相互关系。
与前者的交互决策,直接影响与后者的交互策略。这里最后选择的方案是:尽量不干扰其他交通参与者的运动。
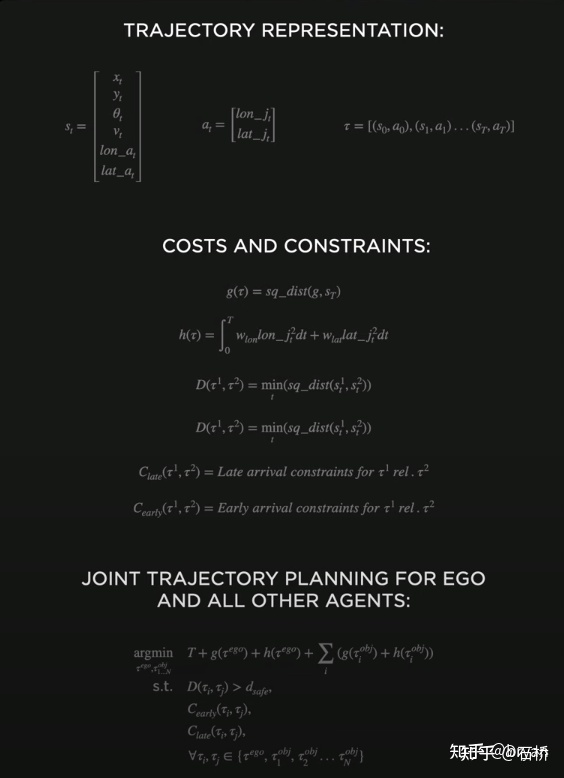
2. 传统优化方法:【联合多物体轨迹规划】:多物体MPC
- 8维度状态表征轨迹(位置,Heading,s速度,横纵向加速度,横纵向jerk)
- 优化cost: 找到自车ego和他车Obj各自的轨迹,使得所有物体都能尽可能的抵达goal,同时横纵向jerk尽可能小(舒适度)
- 约束条件:
- 物体各自的轨迹最近距离大于安全距离
- 两两物体的轨迹早到、迟到约束
- 缺点:实时性太差(每一种组合耗时10ms是Tesla能做到的极限),存在组合爆炸。目标是整体规划耗时50ms(20hz)。
3. 交互树搜索:并行的路径规划和评估修剪
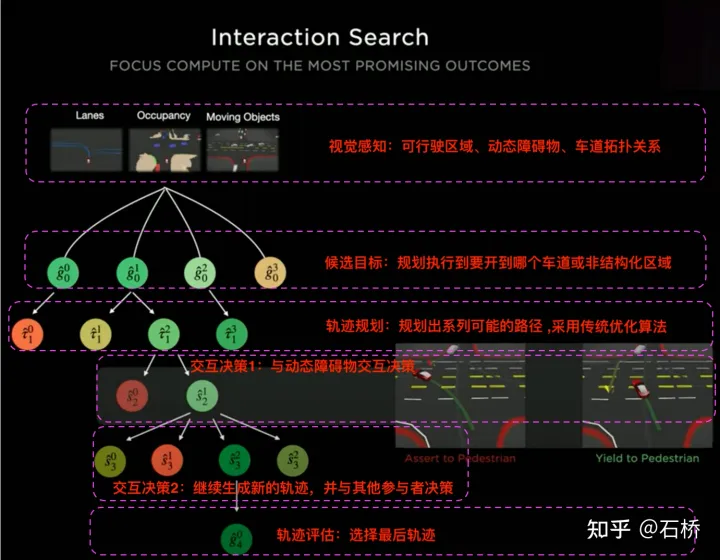
决策规划的流程
Tesla实现这个目标采用的是“交互搜索”,对一系列可能的运动轨迹进行并行搜索,对应的状态空间包含了自车、障碍物、可行驶区域、车道、交通信号灯等。解空间采用的是一组目标运动候选轨迹,在与其他交通参与互动决策后产生分支,进而递进决策规划下去,最后选出最优的轨迹,流程如上图所示:
1) 根据道路拓扑或人驾数据先验得到goal点或其概率分布(大数据轨迹)
2)根据goal点生成候选轨迹(优化算法+神经网络)
3)沿着候选轨迹rollout并交互决策,重新规划路径,评估各个路径的风险和得分,优先搜索最佳路径知道goal点
整个决策规划的优化表达式:
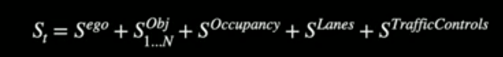
决策规划优化表达式
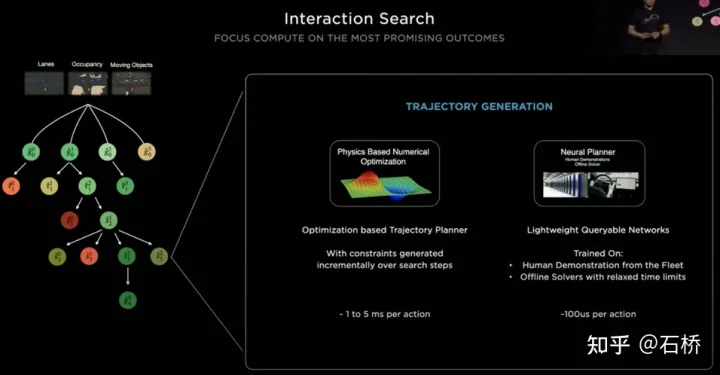
轻量级的规划轨迹查询网络
特斯拉采用递增的方式不断加入新的决策约束,用较少约束下最优方案作为初值继续求解更加复杂的优化问题,最终得到最优解。但由于存在众多的可能分支,就要整个决策规划过程要十分的高效,采用基于传统优化算法的planner每次决策规划需要耗时1~5ms,当存在高密度交通参与者时显然是不够安全的。特斯拉采用的Neural Planner是一个轻量级的网络,查询的规划轨迹使用Tesla车队中人类驾驶员驾驶数据和在无时间约束的离线条件下规划的全局最优路径最为真值进行训练出来的,每次决策规划只有100us。
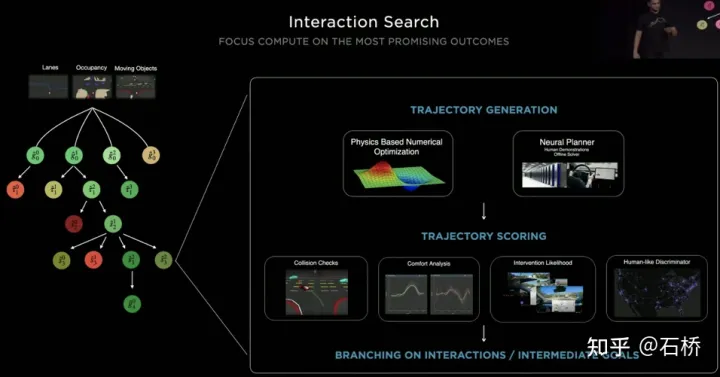
规划决策评估
每次决策后查询到的多个候选轨迹都需要进行评估,评估依据的规范有碰撞检查、舒适性分析、接管可能性、与人的相似程度等,有助于修剪搜素分支,避免整个决策树过于庞大,同时也能够将算力集中到最有可能的分支上。Tesla强调该方案同样适用于遮挡场景,在规划过程会考虑被遮挡的物体的运动状态,通过添加“鬼影”进行规划。
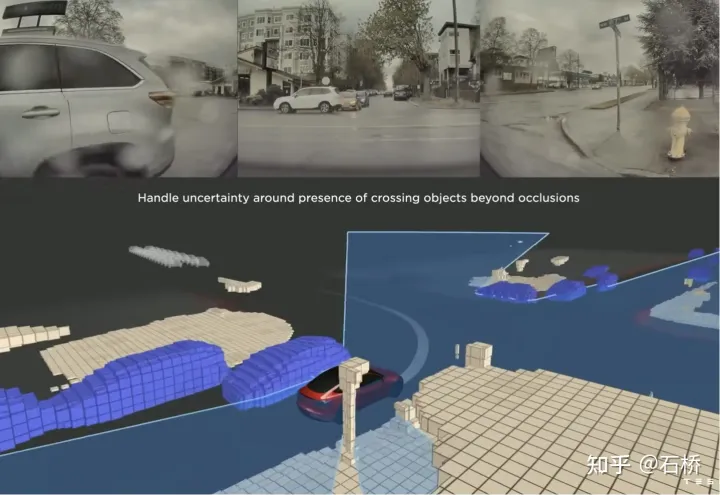
ghost遮挡场景
在CVPR还分享了碰撞规避的网络流程和对应的规划过程,不细述。
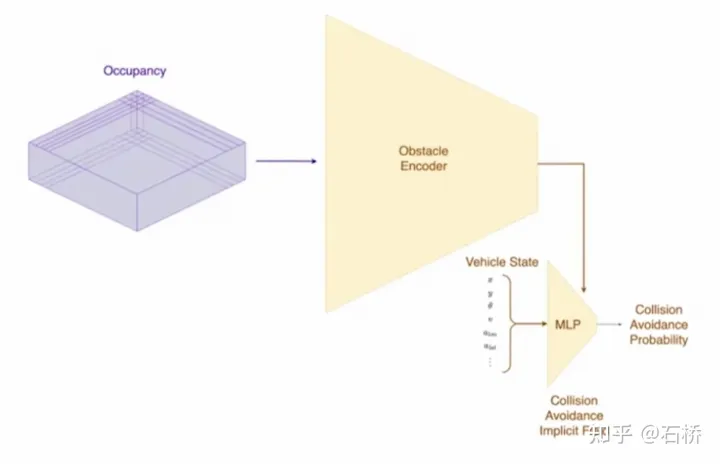
碰撞规避网络
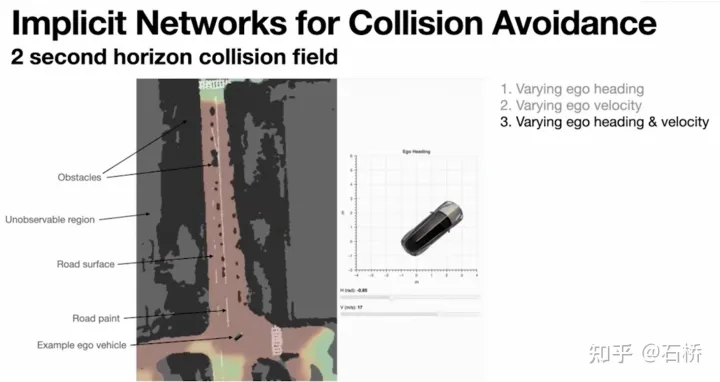
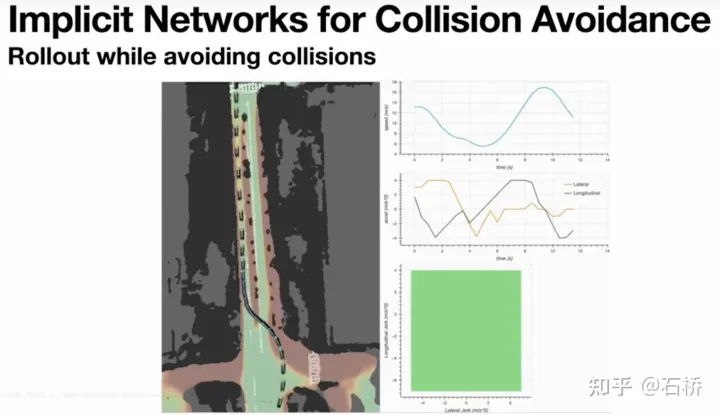
特斯拉强大的感知能力需要强大的标注能力作为支撑,从2018至今,特斯拉的标注经历了4个阶段:
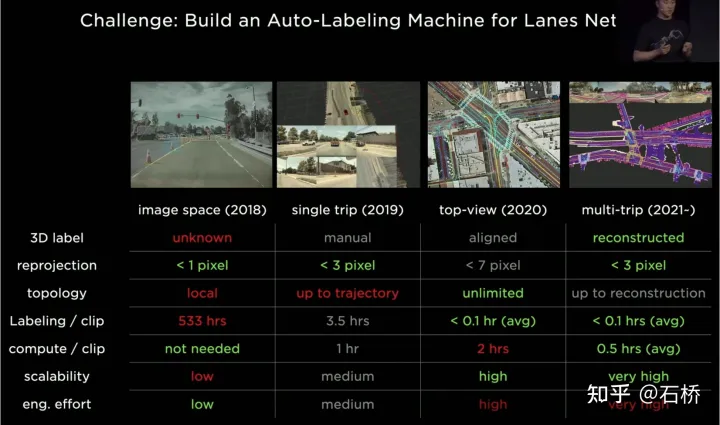
特斯拉的标注迭代
第1阶段(2018):只有纯人工的2维的图像标注,效率非常低
第2阶段(2019):开始有3D label,但是是单趟的人工的
第3阶段(2020):采用BEV空间进行标注,重投影的精度明显降低
第4阶段(2021):采用多趟重建去进行标注,精度、效率、拓扑关系都达到了极高的水准
特斯拉的这套自动标注系统可以取代500万小时的人工作业量,人工只需要检查、补漏极小的部分(<0.1hrs).
这套多趟轨迹重建方案过程如下:(类似于一套离线的语义slam系统)
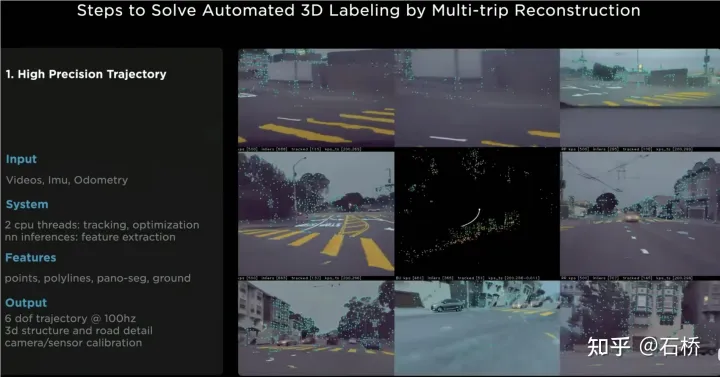
自动标注系统
第1步:VIO生成高精轨迹。将视频流、IMU、里程计给到神经网络,推理提取点、线、地面、分割特征,然后在BEV空间用multi-camera VIO进行tracking和optimization,输出100Hz的6dof的轨迹和3dof的结构和道路,同时还可以输出camera的标定值。重建轨迹的精度是1.3cm/m、0.45弧度/m,不算很高。所有的FSD都可以运行这套流程获取某趟预处理的轨迹和结构信息。(看视频感觉vio只显式用了点特征,可能隐式使用了用线、面特征。)
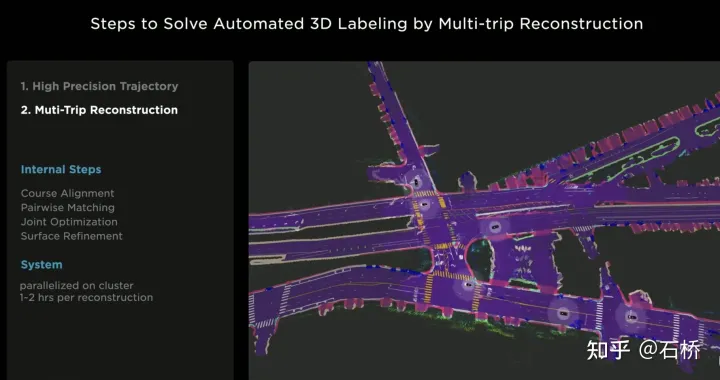
多趟轨迹重建
第2步:多趟轨迹重建。将多趟来自不同车辆的重建数据进行轨迹分组粗对齐->特征匹配->联合优化->路面精修,然后人工参与进来最终核实确认标注结果。这里联合优化后还进行了一个路面优化,猜测是视觉重建的误差比较大,全局优化后在局部道路存在分层重叠问题,为了消除这部分全局优化错误分配的误差,增加了路面优化。从算法逻辑上来讲,全局优化后接局部优化是一个必须项,因为自动驾驶的要求是处处能可行驶。整个过程在集群上并行的。
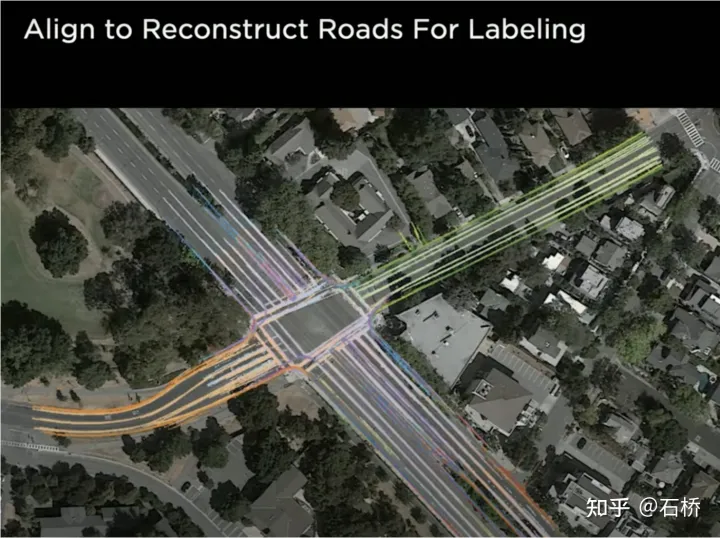
粗对齐
第3步:自动标注新轨迹数据。在预先构建的地图上,对新行驶轨迹数据执行多趟轨迹重建一样的重建流程,这样对齐后的新轨迹数据就可以自动的从预构建地图上获取语义标注。这其实就是一个重定位获取语义标签的过程。这个自动标注其实是只能自动标注静态的物体,比如:车道线、道路边界等。通过感知模型,其实已经能够获取到车道线等的语义类别,但是在恶劣场景下会存在完整性和误识别问题,通过这个自动标注可以解决这些问题。但缺陷在于对于动态障碍物可能就不太适用了,比如:行驶中的车辆、行人等。下面是使用场景:
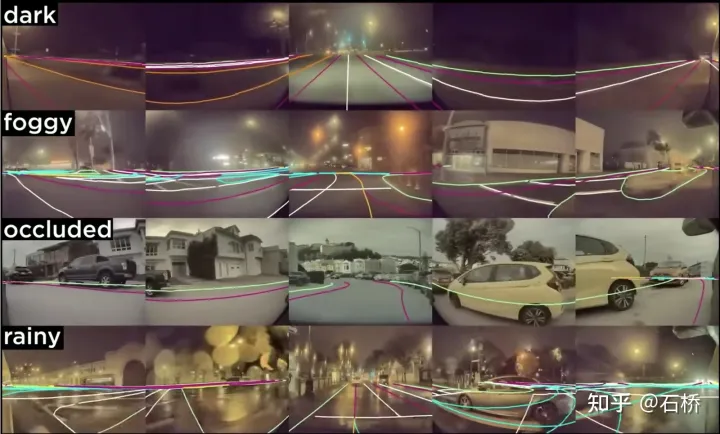
自动标注使用场景
特斯拉所展示的很多图像都有一个特点:存在模糊或污渍遮挡,但是不严重影响其感知结果。在正常的使用中,车辆的相机镜头很容易被弄脏,但是有了这个自动标注,特斯拉的感知鲁棒性会非常强,也降低了相机的维护成本。
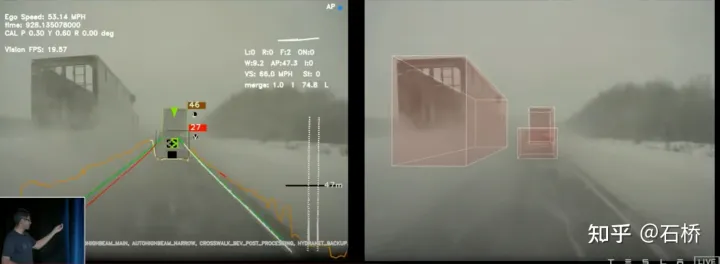
自动标注不适用于动态车辆
回顾2021年的ai day可知上述重建构建的是static world,而是不只是车道线车道线,还有车辆和建筑。
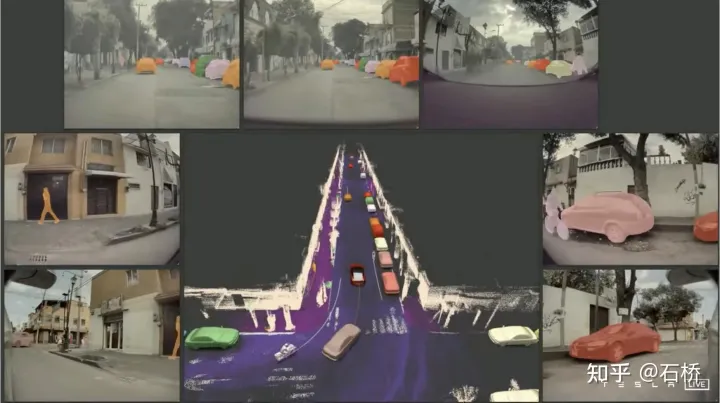
3D重建
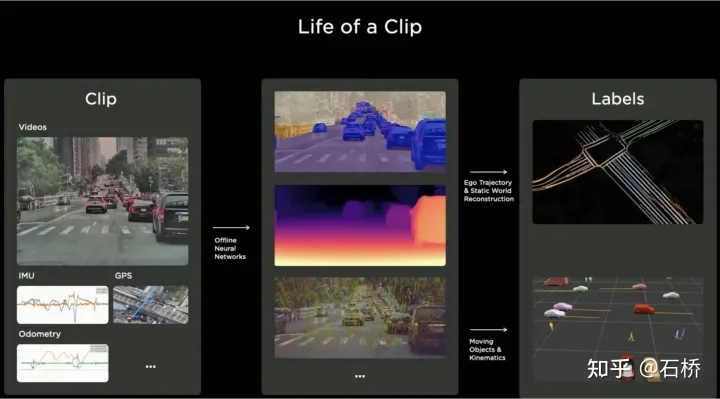
重建静态世界并标注
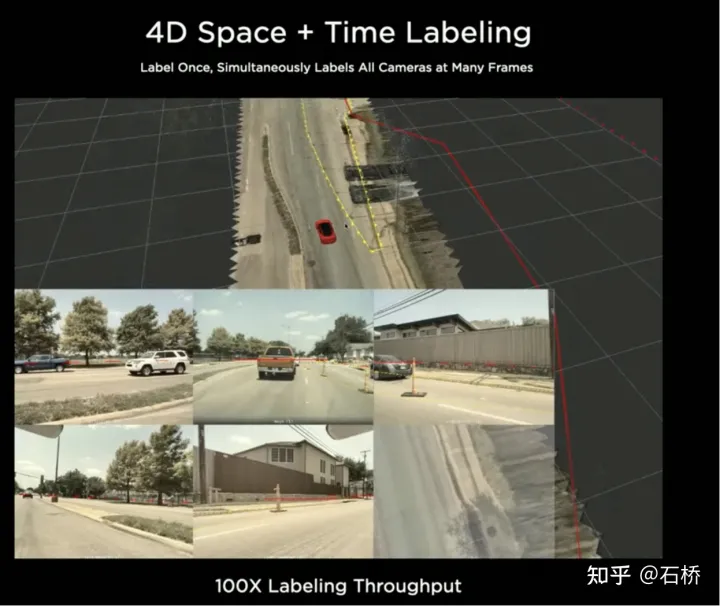
4D空间标注
在BEV空间标注完后,会将标注再映射会多个相机的图像中,从而实现4D空间一次标注可以2D多帧应用。
关于场景重建,当前的重建能力和精度可能还是没有达到特斯拉工程师的期望,他们最终的目标是真实还原重建出所有特斯拉汽车行驶过的场景,而且可以真实的改变这些场景的条件生成新的真实场景,这才是终局目标。
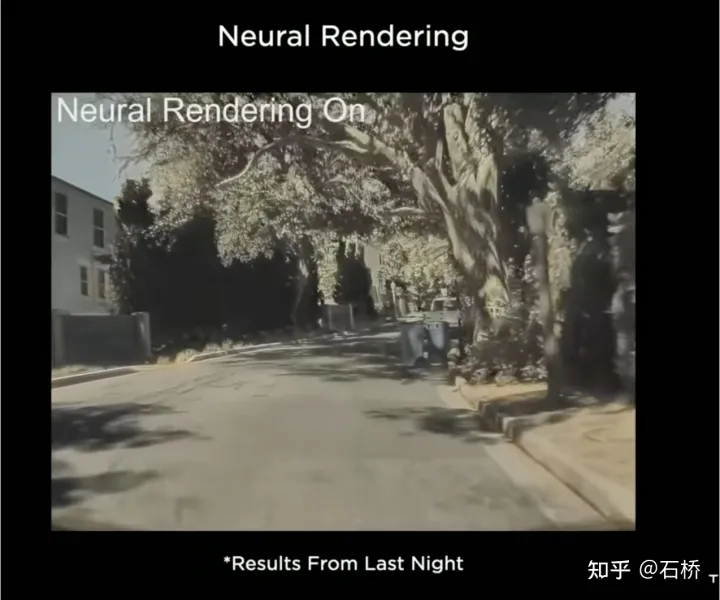
还原真实世界
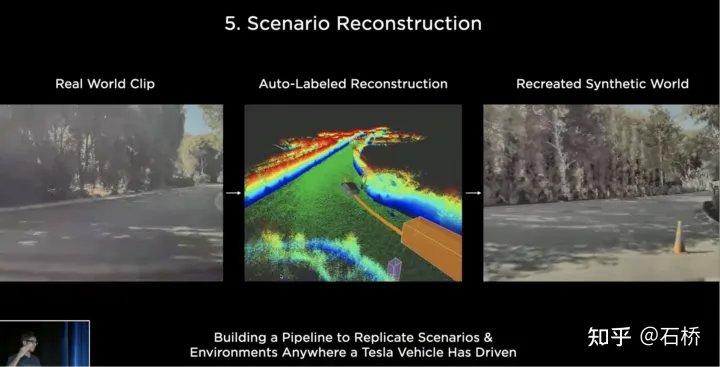
重建真实世界
04 场景仿真:基于真实道路信息,创造自动驾驶场景
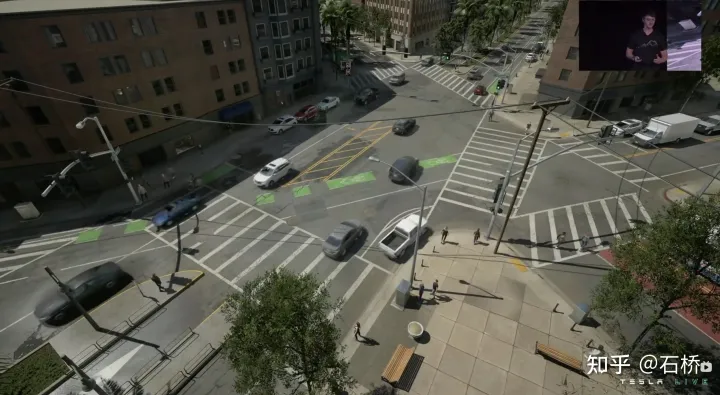
场景仿真
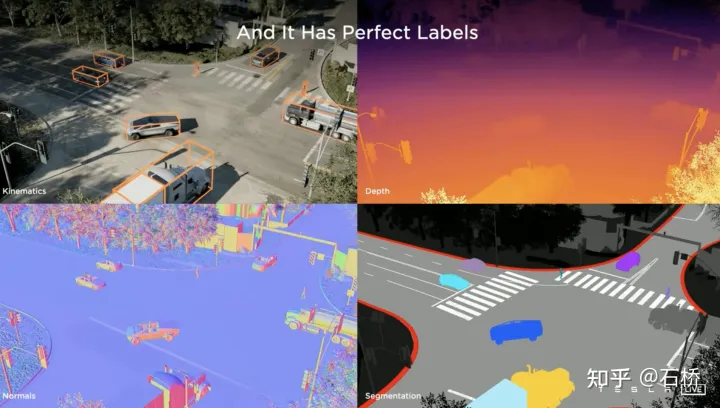
仿真可以获取绝对正确的label
基于重建去构建的真实场景受限于数据、算法等,当前还难以大规模实现,而且耗时还比较长,例如:上图一个真实路口的仿真需要花费2周时间。但是自动驾驶的落地又依赖于在不同场景中的训练和测试,所以特斯拉就构建了一套仿真系统,用于模拟自动驾驶场景。这套系统并不能真实模拟现实场景,但好处是比上述真实常见重建方案快1000倍,可以提供现实中难以获得或难以标记的数据,对于自动驾驶的训练仍然非常有意义。
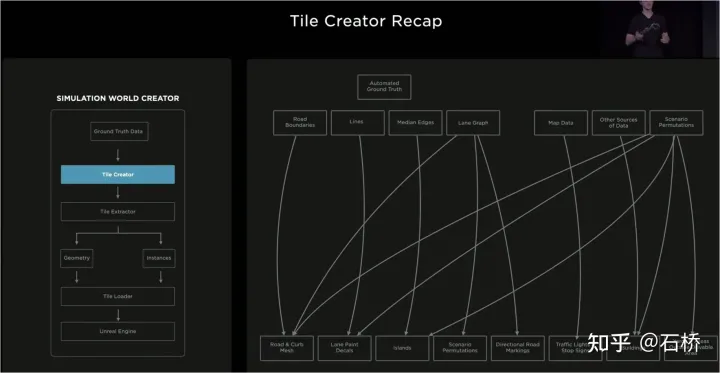
仿真构建的架构
这套仿真器的架构如上图,在场景创建过程中需要经过以下步骤:
第1步:在仿真世界中铺开道路,利用边界label生成实体路面mesh,用道路拓扑关系重新关联.
第2步:将路面上的车道线和几何描述要素投影到车道路段上,构建车道细节
第3步:在道路中间边界区域内生成中心分道区,随机生成植物、交通标识填补;道路边界外采用随机启发的方式生成一系列的建筑、树木、交通标识物等
第4步:从地图中获取红绿灯或停止标志的位置,还可以获取车道数、道路名称等
第5步:使用车道地图获取车道的拓扑关系,生成行驶方向(左右转标线)和辅助标记
第6步:利用车道地图本身确定车道相邻关系和其他有用的信息
第7步:根据车道关系生成随机车流组合
在上述过程中,基于一套车道导航地图真值可以修改仿真参数生成变化,产生多种组合场景。而且甚至可以根据训练的需要,修改真值的某些属性,创造新的场景,从而实现训练目的。
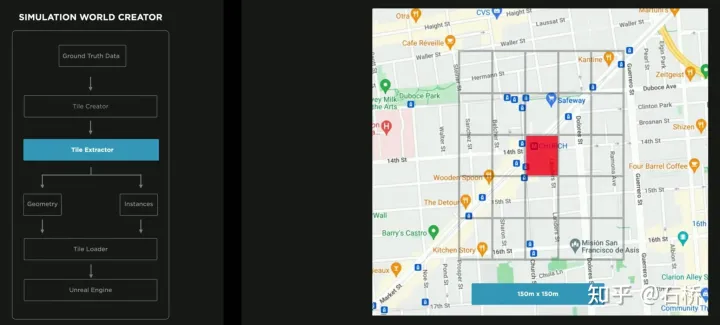
数据划分为Tile存储
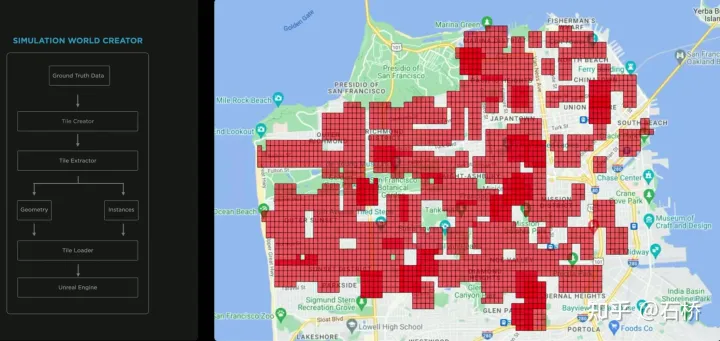
基于Tile粒度构建的世界
上述构建的仿真是基于真实的道路信息,所以很多现实性的问题就可以借助仿真来解决。例如:可以在仿真的洛杉矶道路环境中测试自动驾驶功能。(上述的存储方式就是在仿真建图、存储、加载使用)
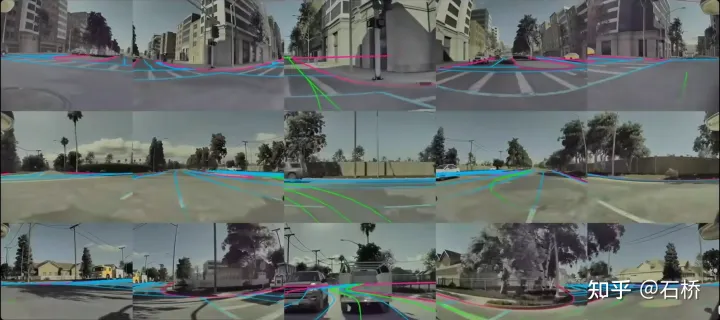
仿真场景下的自动驾驶
感受:对于自动驾驶来说什么样的地图信息是不可被取代的可以从这个仿真构建过程中找到一些答案。
05 数据引擎:挖掘corner case数据
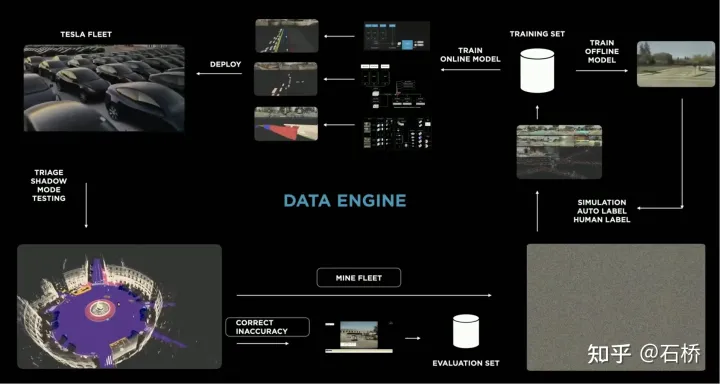
数据闭环流程
数据引擎从影子模式中挖掘模型误判的数据,将之召回并采用自动标注工具进行标签修正,然后加入到训练和测试集中,可以不断的优化网络。这个过程是数据闭环的关键节点,会持续生成corner case样本数据。
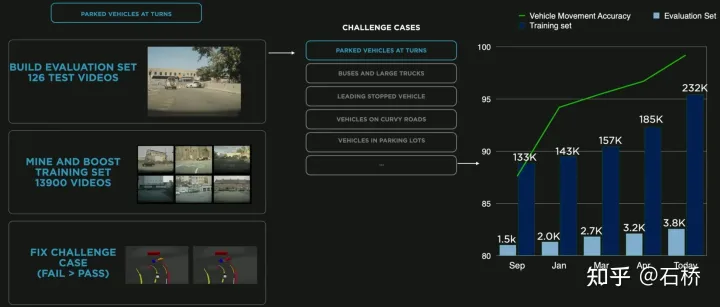
弯道停车的数据挖掘
上图是弯道停车数据挖掘对模型提升的案例,随着数据源源不断的加入到训练中,准确率指标持续提升。
特斯拉车主发现充电站价格低至0.21元/度(含服务费),比家用超充更便宜,引发车友热议。该现象折射出各地充电价格差异巨大,从三毛到一块五不等,成为车主们交流用车生活的真实切面。
瑞典交通管理局建议欧盟投票反对特斯拉FSD推广,因其允许车辆在人工监督下超出法定限速行驶,可能动摇法律框架。相关意见已提交欧盟机动车辆技术委员会,该委员会计划于6月30日投票决定是否在欧盟范围内放行该技术。
瑞典交通管理局致信欧盟,建议除非特斯拉取消FSD超速功能,否则不应批准其在欧盟全面推广。欧盟机动车技术委员会将于6月30日讨论表决。目前荷兰等国已批准FSD,但瑞典等北欧国家表示担忧。全面推广需至少15国支持且人口达欧盟65%以上。
LG新能源南京圆柱电池工厂已恢复满负荷运转状态,主要得益于特斯拉销量回暖以及中国市场需求增长。此外,中国市场政策调整亦推动电池订单增加,充分反映出行业景气度回升及增长前景乐观。
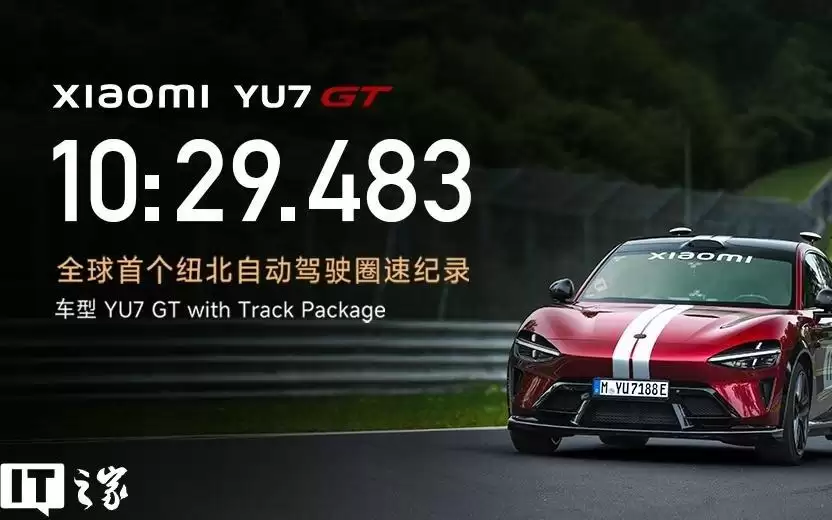
小米YU7GT在纽博格林北环以自动驾驶模式跑出10分29秒483,创全球量产车自动驾驶圈速纪录。胡峥楠表示,这体现小米入局汽车的梦想:电能替代化学能,智能替代人工。纽北因此将小米列为三大顶级合作伙伴之一。该成绩相当于老司机水平,但仅是起点。
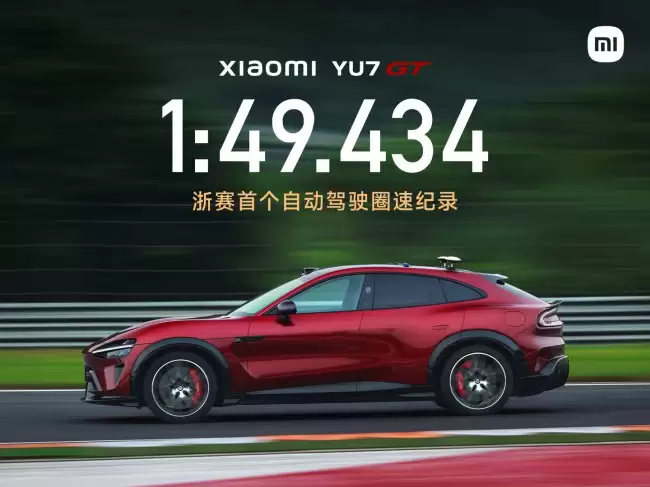
小米YU7GT在浙江国际赛车场以1分49秒434创下自动驾驶圈速纪录,此前于纽博格林北环也取得全球首个自动驾驶圈速成绩。该车最大马力1003匹,零百加速2.92秒,CLTC续航705km,基于897V碳化硅高压平台,全程无人干预。
曹操出行与自动驾驶企业MayMobility达成战略合作,在欧洲探索Robotaxi商业化。双方将联合开展可行性研究,优先在欧洲试点,由曹操出行负责运营,MayMobility提供自动驾驶技术支撑,共同推进无人驾驶出租车服务落地。
特斯拉企业使命升级为“打造一个富足非凡的世界”,从聚焦可持续能源转向借助人工智能等前沿技术赋能每个人活出理想生活,标志着其正从电动汽车制造商向人工智能+机器人生态型科技巨头跨越。
由中、欧、英、美、加、日六方牵头的联合国自动驾驶系统全球技术法规获批发布,首次从产品全生命周期明确核心技术指标,将安全管理、试验验证及持续监控纳入制造商义务,提供完整评估方法,使各国自动驾驶车辆拥有统一标准,推动产业化从碎片化走向体系化。
特斯拉新专利融合主动与被动悬架,通过主动执行器、空气弹簧等组件按需介入颠簸处理,并基于共享道路粗糙度地图实现预测式调节,在保障舒适性的同时优化能耗,提升行驶品质与效率。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



