

Prompt一键抠图!Meta发布史上首个图像分割基础模型,开创CV新范式

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
就在刚刚,MetaAI发布了SegmentAnythingModel(SAM)——第一个图像分割基础模型。SAM能从照片或视频中对任意对象实现一键分割,并且能够零样本迁移到其他任务。整体而言,SAM遵循了基础模型的思路:1.一种非常简单但可扩展的架构,可以处理多模态提示:文本、关键点、边界框。2.直观的标注流程,与模型设计紧密相连。3.一个数据飞轮,允许模型自举到大量未标记的图像。而且,毫不夸张地说,SAM已经学会了「物体」的一般概念,甚至对于未知物体、不熟悉的场景(例如水下和显微镜下)以及模
就在刚刚,Meta AI发布了Segment Anything Model(SAM)——第一个图像分割基础模型。
SAM能从照片或视频中对任意对象实现一键分割,并且能够零样本迁移到其他任务。
整体而言,SAM遵循了基础模型的思路:
1. 一种非常简单但可扩展的架构,可以处理多模态提示:文本、关键点、边界框。
2. 直观的标注流程,与模型设计紧密相连。
3. 一个数据飞轮,允许模型自举到大量未标记的图像。
而且,毫不夸张地说,SAM已经学会了「物体」的一般概念,甚至对于未知物体、不熟悉的场景(例如水下和显微镜下)以及模糊的案例也是如此。
此外,SAM还能够泛化到新任务和新领域,从业者并不需要自己微调模型了。
论文地址:https://ai.facebook.com/research/publications/segment-anything/
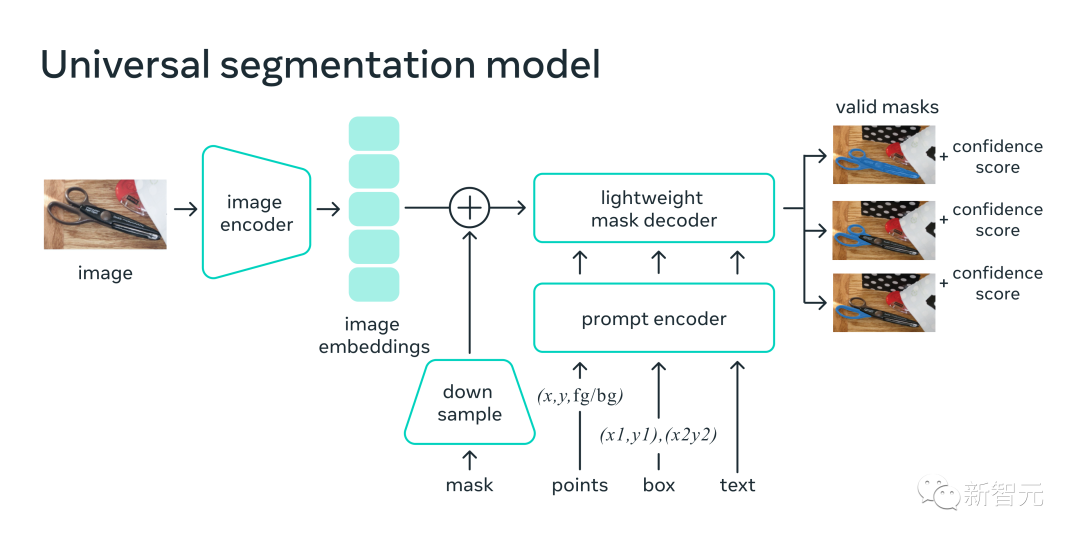
最强大的是,Meta实现了一个完全不同的CV范式,你可以在一个统一框架prompt encoder内,指定一个点、一个边界框、一句话,直接一键分割出物体。
对此,腾讯AI算法专家金天表示,「NLP领域的prompt范式,已经开始延展到CV领域了。而这一次,可能彻底改变CV传统的预测思路。这一下你可以真的可以用一个模型,来分割任意物体,并且是动态的!」
英伟达AI科学家Jim Fan对此更是赞叹道:我们已经来到了计算机视觉领域的「GPT-3时刻」!
所以,CV真的不存在了?
SAM:一键「切出」任何图像中的所有对象
Segment Anything是致力于图像分割的第一个基础模型。
分割(Segmentation)是指识别哪些图像像素属于一个对象,一直是计算机视觉的核心任务。
但是,如果想为特定任务创建准确的分割模型,通常需要专家进行高度专业化的工作,这个过程需要训练AI的基础设施,和大量仔细标注的域内数据,因此门槛极高。
为了解决这个问题,Meta提出了一个图像分割的基础模型——SAM。这个接受了多样化数据训练的可提示模型,不仅能适应各种任务,而且操作起来也类似于在NLP模型中使用提示的方式。
SAM模型掌握了「什么是对象」这个概念,可以为任何图像或视频中的任何对象生成掩码,即使是它在训练中没有见过的对象。
SAM具有如此广泛的通用性,足以涵盖各种用例,不需要额外训练,就可以开箱即用地用于新的图像领域,无论是水下照片,还是细胞显微镜。也即是说,SAM已经具有了零样本迁移的能力。
Meta在博客中兴奋地表示:可以预计,在未来,在任何需要在图像中查找和分割对象的应用中,都有SAM的用武之地。
SAM可以成为更大的AI系统的一部分,对世界进行更通用的多模态理解,比如,理解网页的视觉和文本内容。
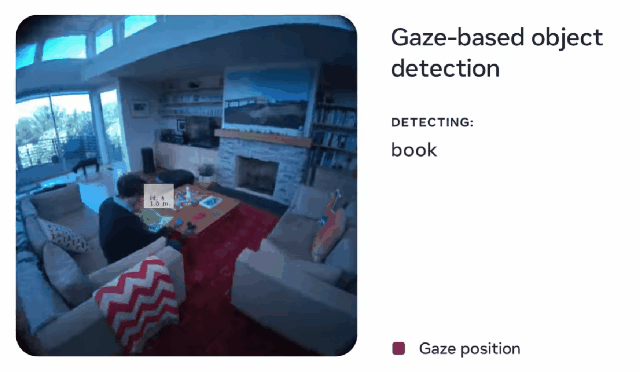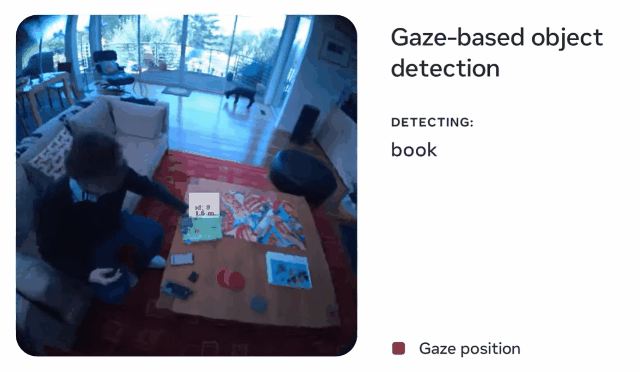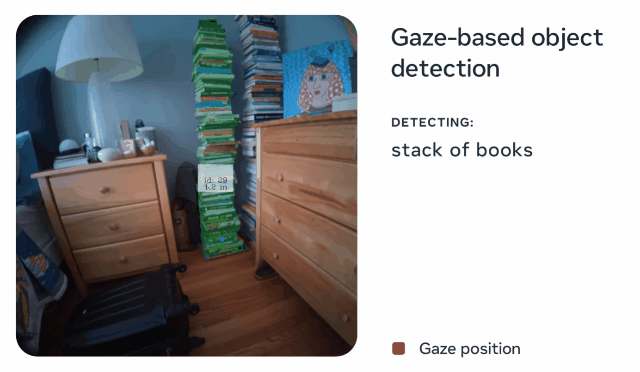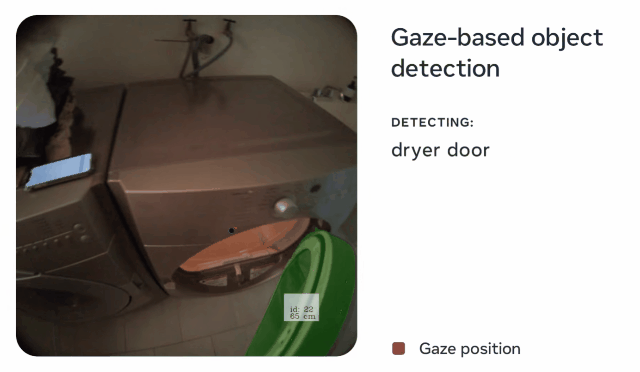
在AR/VR领域,SAM可以根据用户的视线选择对象,然后把对象「提升」为 3D。
对于内容创作者,SAM可以提取图像区域进行拼贴,或者视频编辑。
SAM还可以在视频中定位、跟踪动物或物体,有助于自然科学和天文学研究。
通用的分割方法
在以前,解决分割问题有两种方法。
一种是交互式分割,可以分割任何类别的对象,但需要一个人通过迭代微调掩码。
第二种是自动分割,可以分割提前定义的特定对象,但训练过程需要大量的手动标注对象(比如要分割出猫,就需要成千上万个例子)。
总之,这两种方式都无法提供通用、全自动的分割方法。
而SAM可以看作这两种方法的概括,它可以轻松地执行交互式分割和自动分割。
在模型的可提示界面上,只要为模型设计正确的提示(点击、框、文本等),就可以完成广泛的分割任务。
另外,SAM在包含超过10亿个掩码的多样化、高质量数据集上进行训练,使得模型能够泛化到新的对象和图像,超出其在训练期间观察到的内容。因此,从业者不再需要收集自己的细分数据,为用例微调模型了。
这种能够泛化到新任务和新领域的灵活性,在图像分割领域尚属首次。
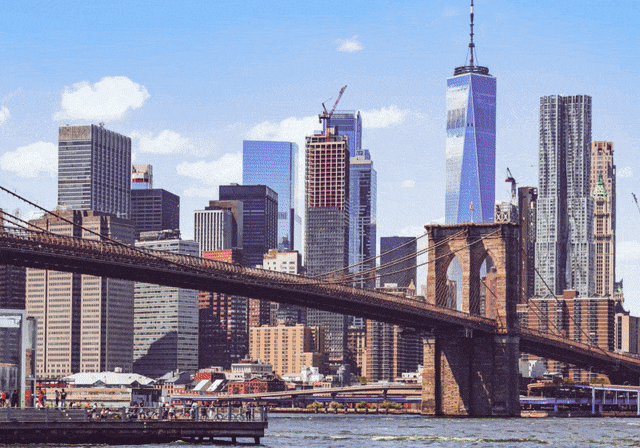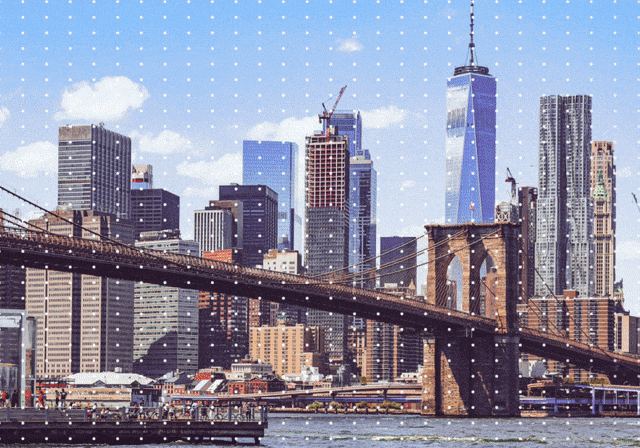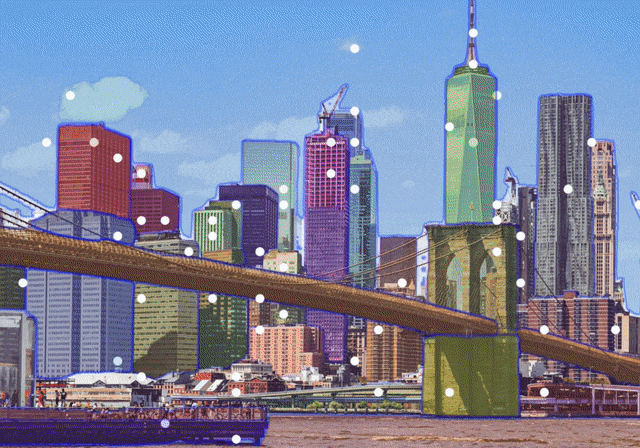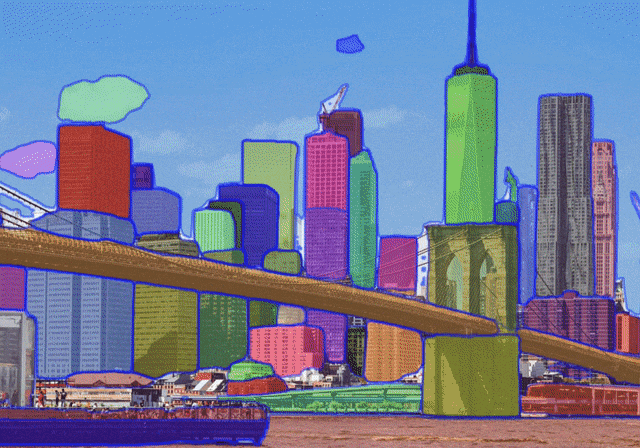
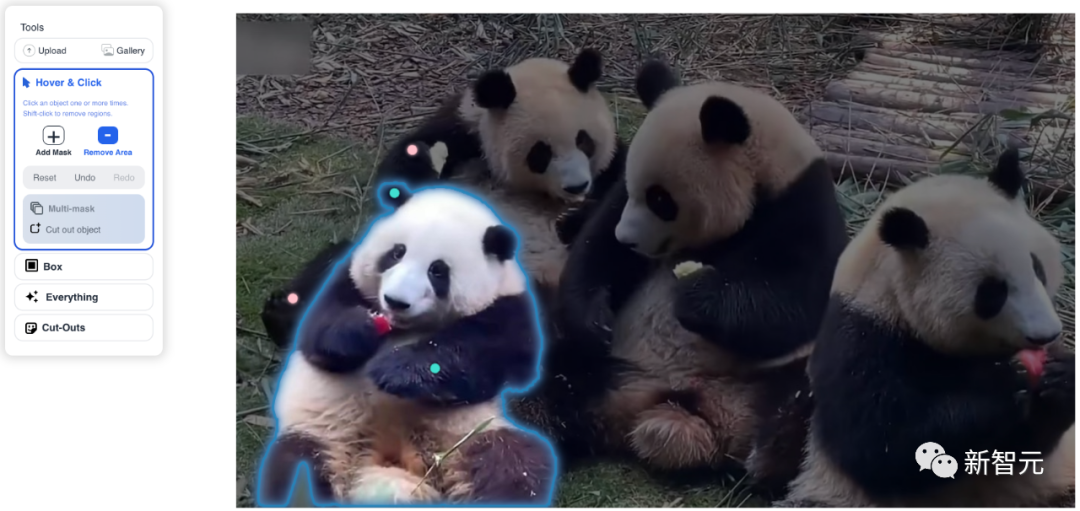
(1) SAM 允许用户通过单击一下,或交互式单击许多点,来分割对象,还可以使用边界框提示模型。
(2) 在面对被分割对象的歧义时,SAM可以输出多个有效掩码,这是解决现实世界中分割问题的必备能力。
(3) SAM 可以自动发现、屏蔽图像中的所有对象。(4) 在预计算图像嵌入后,SAM可以实时为任何提示生成分割掩码,允许用户与模型进行实时交互。
工作原理
研究人员训练的SAM可以针对任何提示返回有效的分割掩码。提示可以是前景/背景点、粗略的框或掩码、自由形式的文本,或者总体上任何指示图像中需要分割的信息。
有效掩码的要求仅仅意味着即使在提示模糊且可能指代多个对象的情况下(例如,衬衫上的一个点可能表示衬衫或者穿衬衫的人) ,输出应该是其中一个对象的合理掩码。
研究人员观察到,预训练任务和交互式数据收集对模型设计施加了特定的约束。
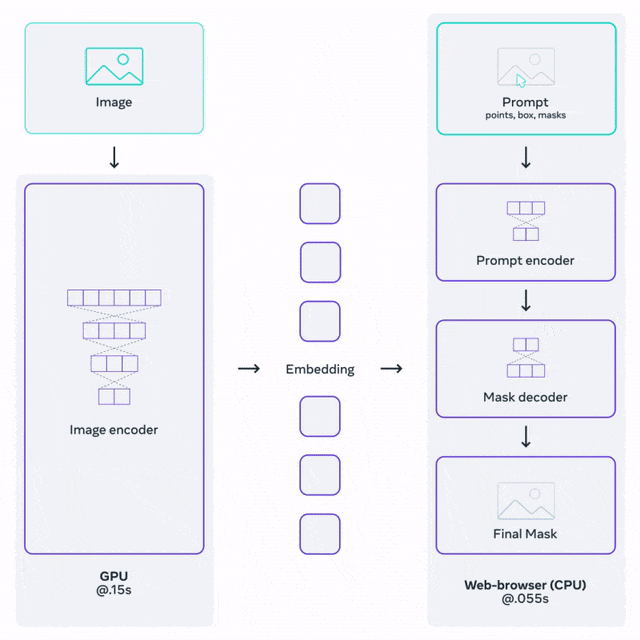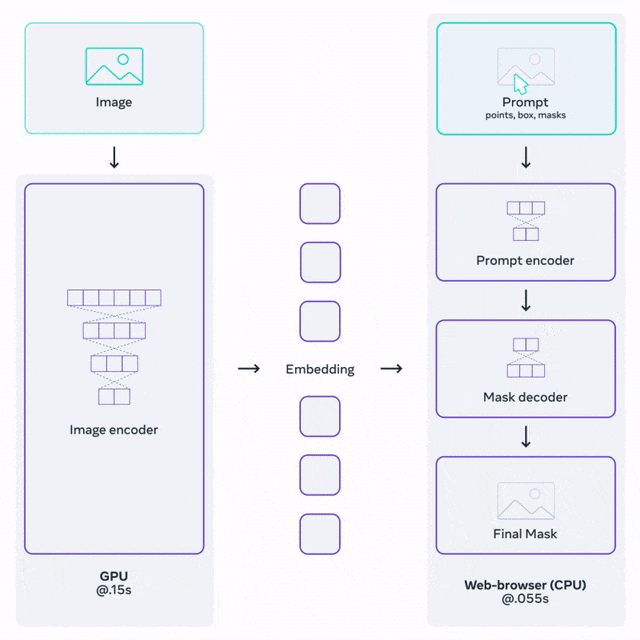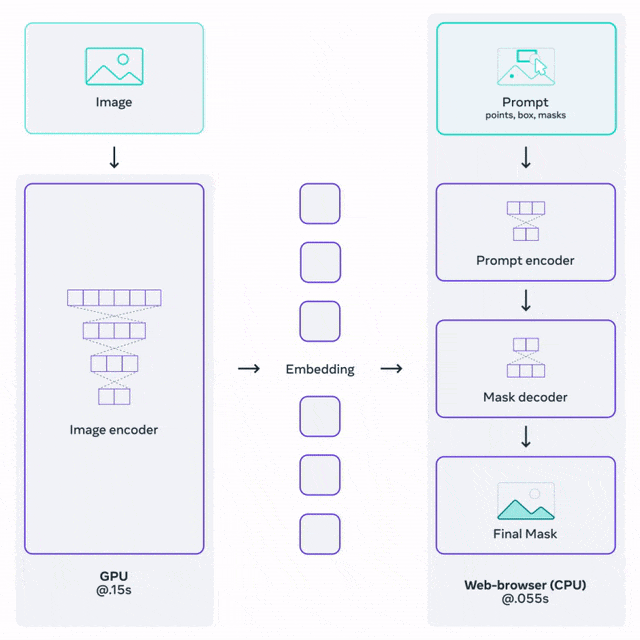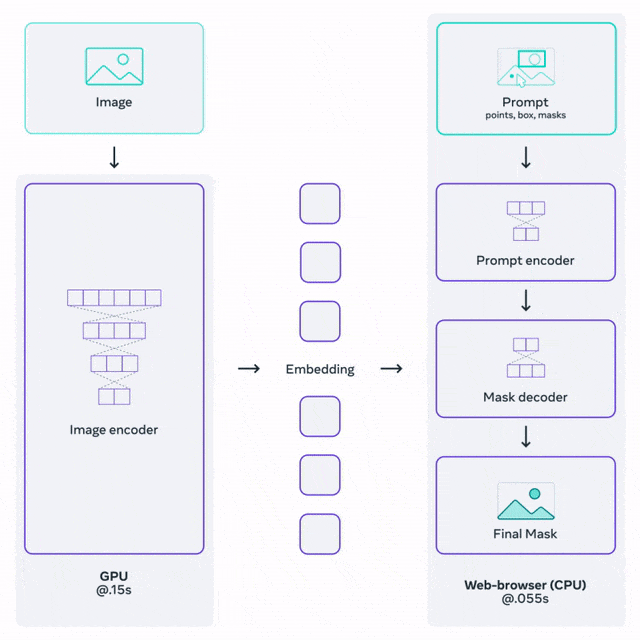
特别是,该模型需要在网络浏览器中CPU上实时运行,以便让标准人员能够高效实时与SAM互动进行标注。
虽然运行时间的约束,意味着质量与运行时间之间需要权衡,但研究人员发现,在实践中,简单的设计可以取得良好的效果。
SAM的图像编码器为图像产生一次性嵌入,而轻量级解码器将任何提示实时转换为矢量嵌入。然后将这两个信息源在一个预测分割掩码的轻量级解码器中结合起来。
在计算出图像嵌入之后,SAM可以在短短50毫秒内生成一段图像,并在网络浏览器中给出任何提示。
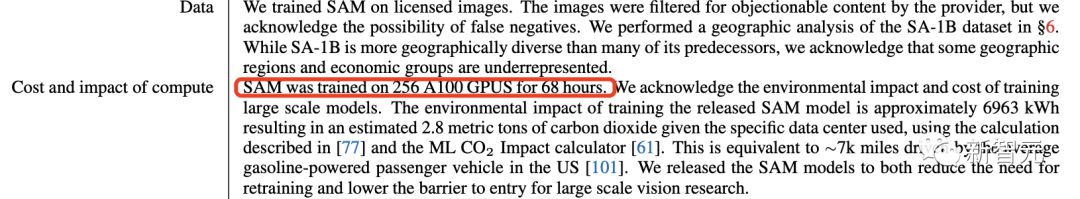
最新SAM模型在256张A100上训练了68小时(近5天)完成。
项目演示
多种输入提示
在图像中指定要分割的内容的提示,可以实现各种分割任务,而无需额外的训练。
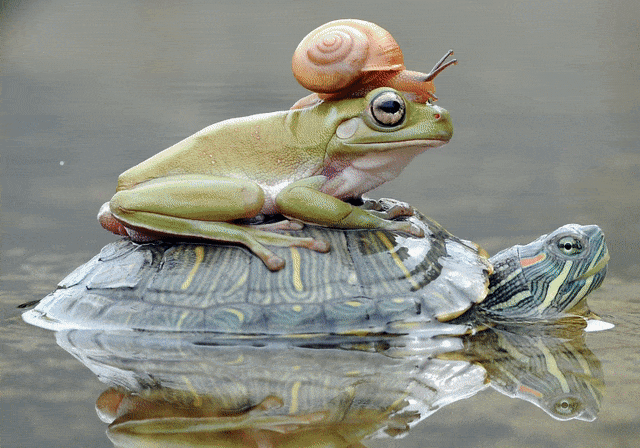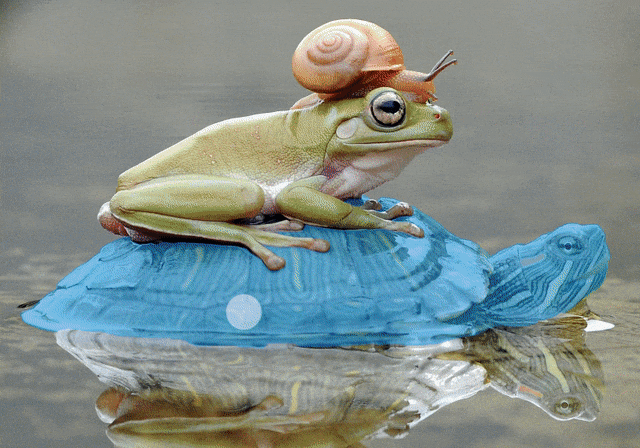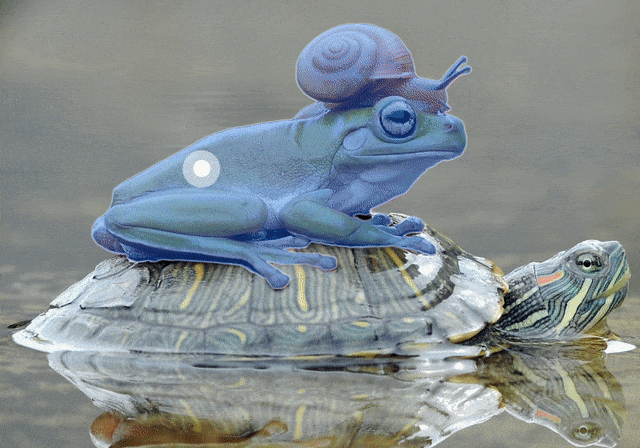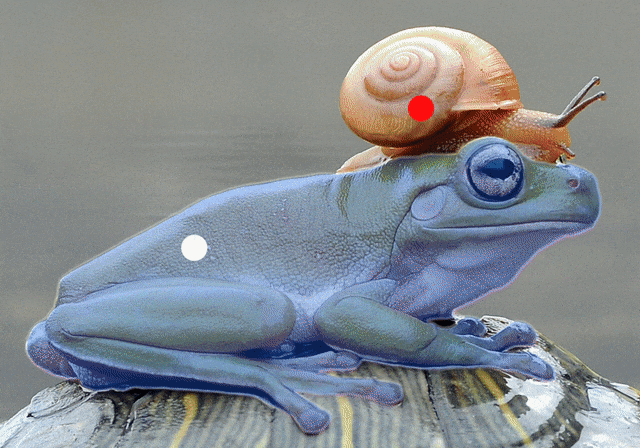
用互动点和方框作为提示
自动分割图像中的所有元素
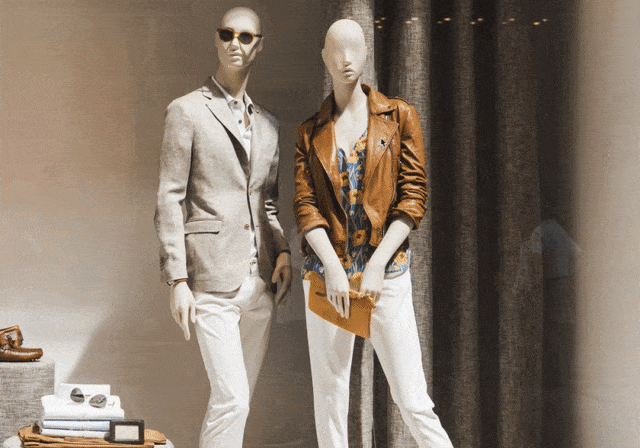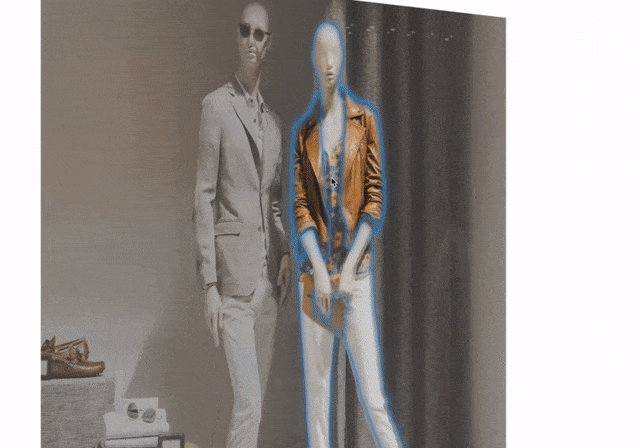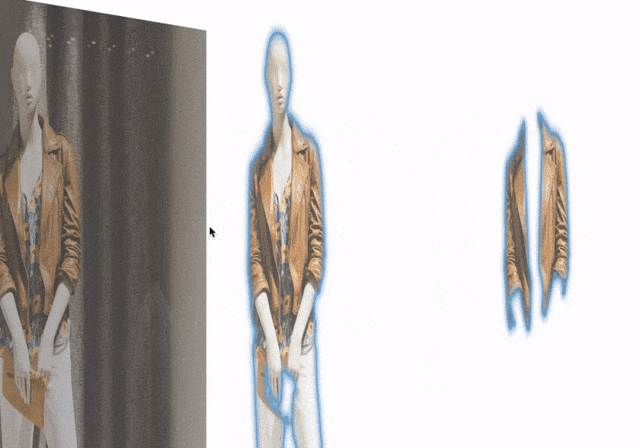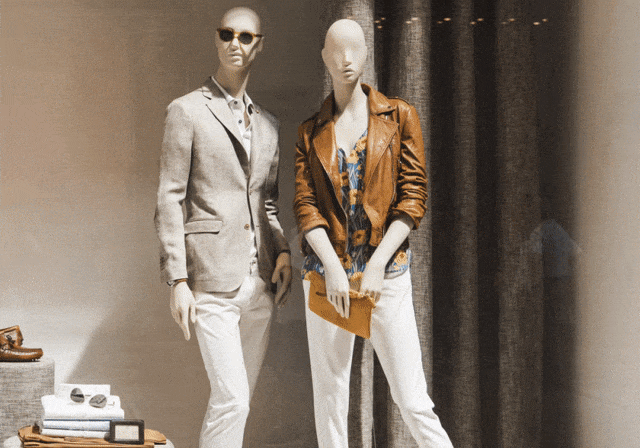
为模棱两可的提示生成多个有效的掩码
可提示的设计
SAM可以接受来自其他系统的输入提示。
例如,根据AR/VR头显传来的用户视觉焦点信息,来选择对应的物体。Meta通过发展可以理解现实世界的AI,恰恰为它未来元宇宙之路铺平道路。
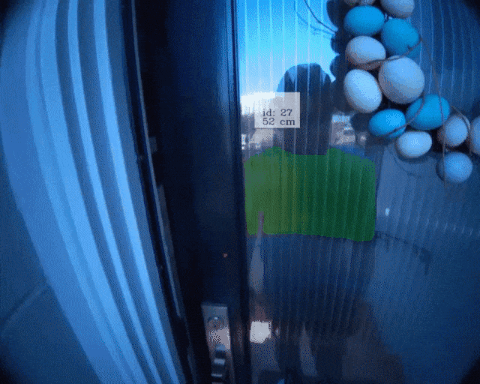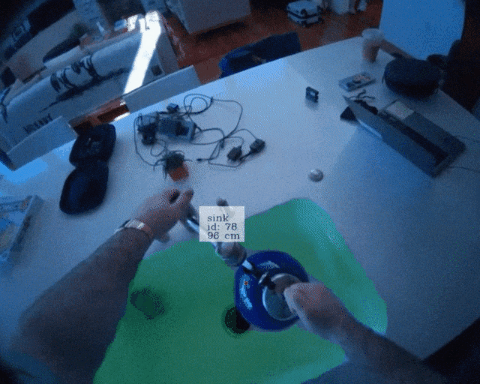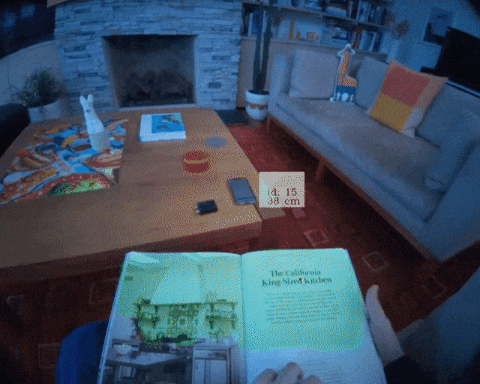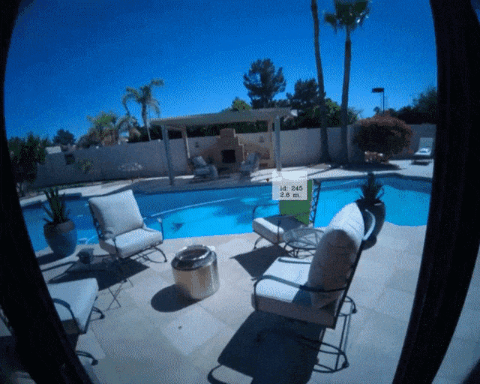
或者,利用来自物体检测器的边界框提示,实现文本到物体的分割。
可扩展的输出
输出掩码可以作为其他AI系统的输入。
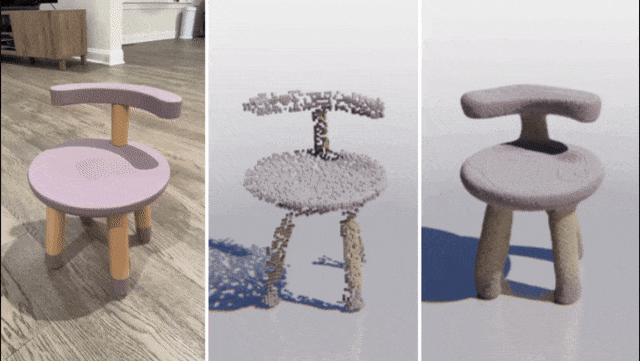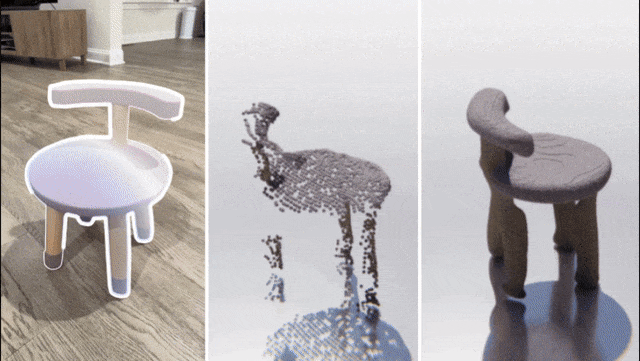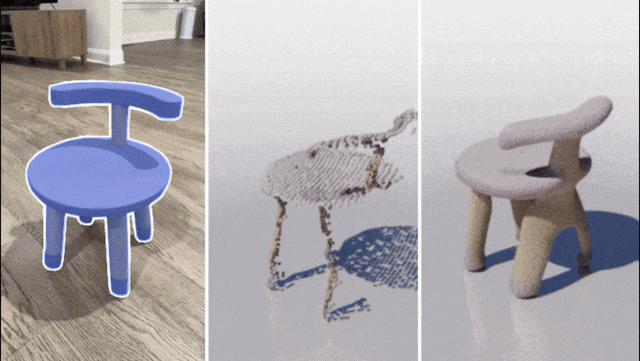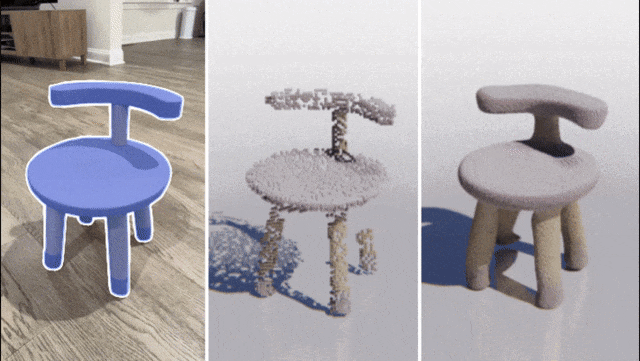
例如,物体的mask可以在视频中被跟踪,通过成像编辑应用程序,变成3D,或用于拼贴等创造性任务。
零样本的泛化
SAM学会了关于物体是什么的一般概念——这种理解使其能够对不熟悉的物体和图像进行零样本概括,而不需要额外训练。
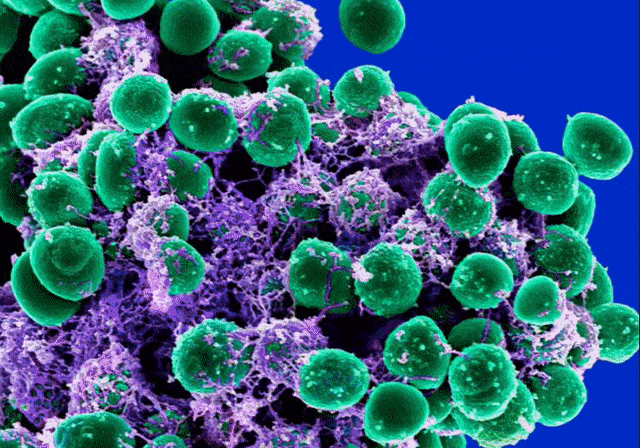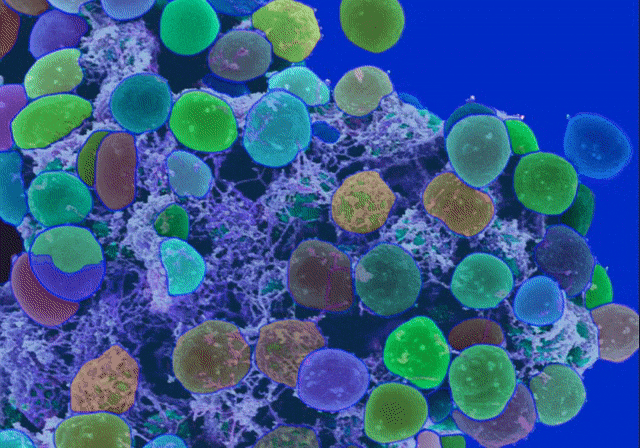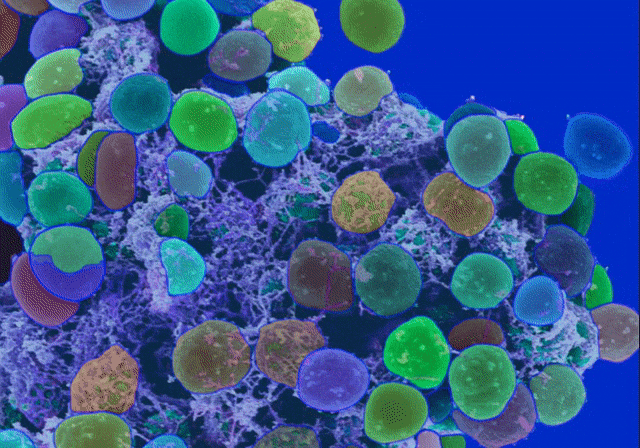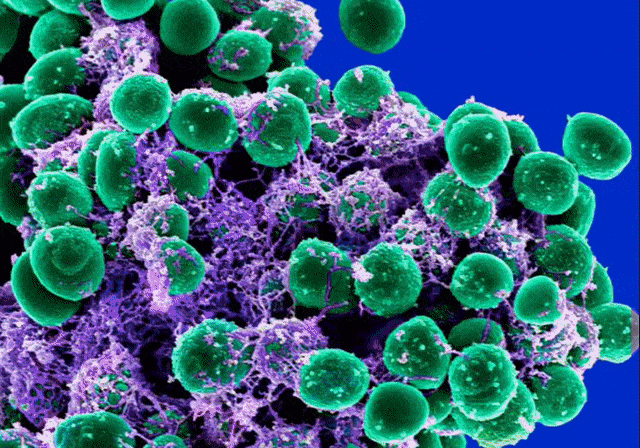
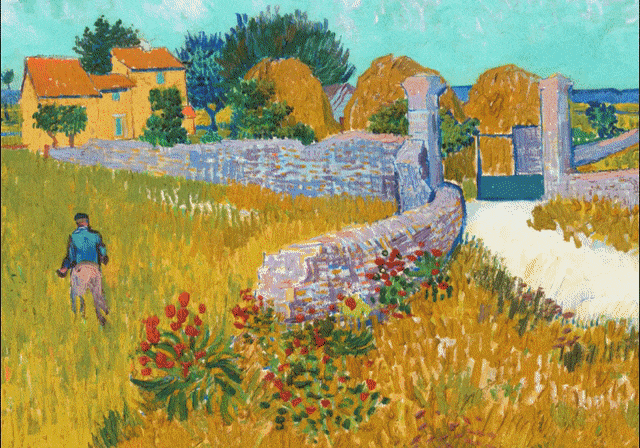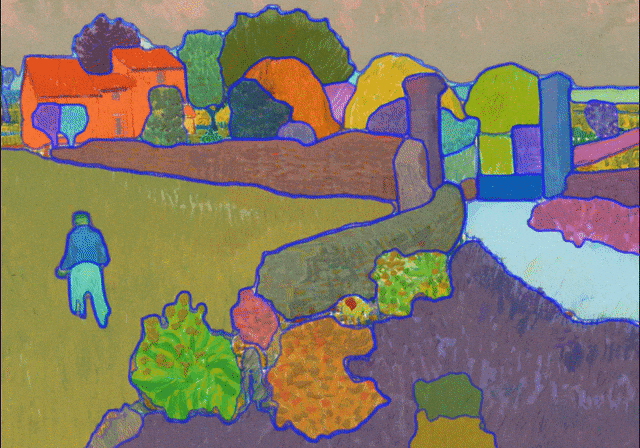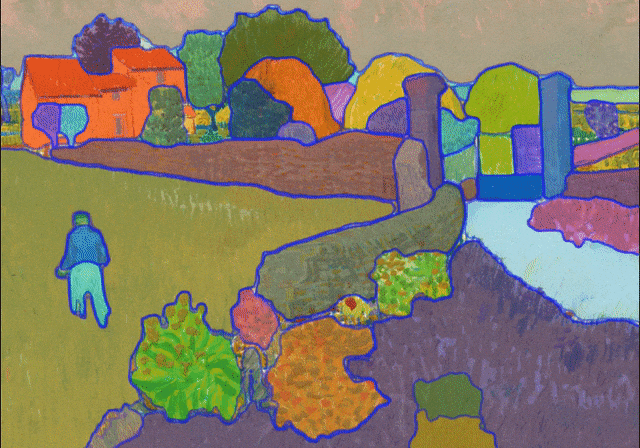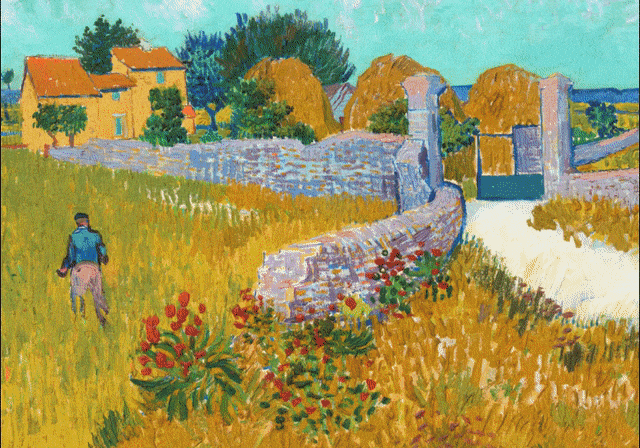
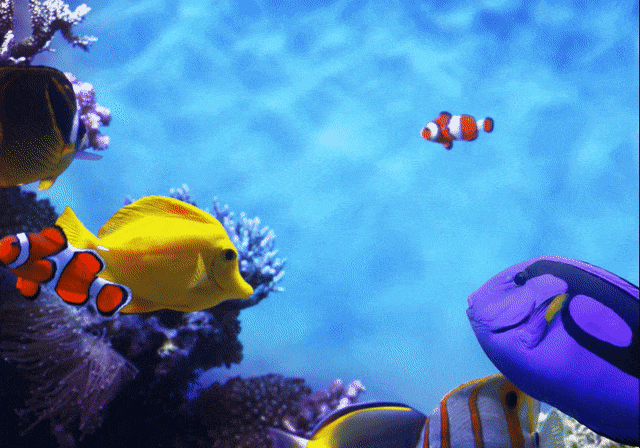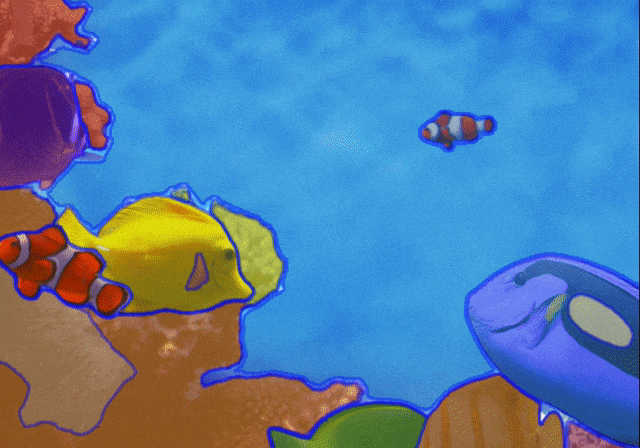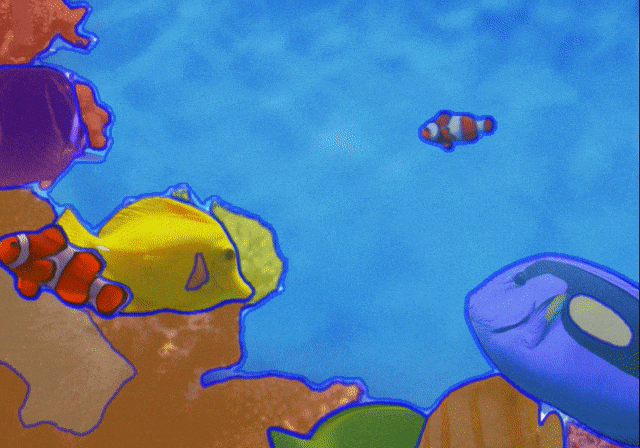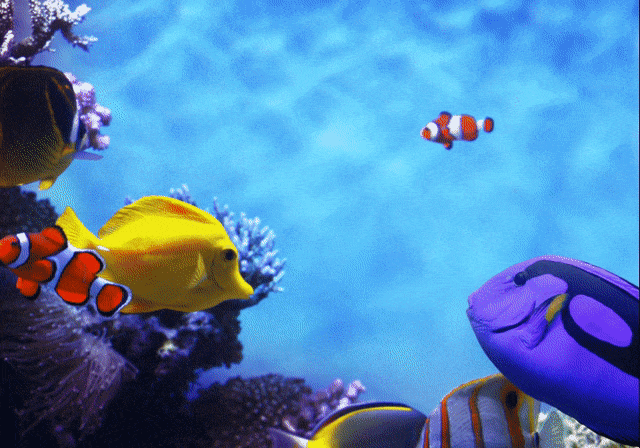
各种评测
选择Hover&Click,点Add Mask后就出现绿点,点Remove Area后出现红点,吃苹果的花花立刻就被圈出来了。
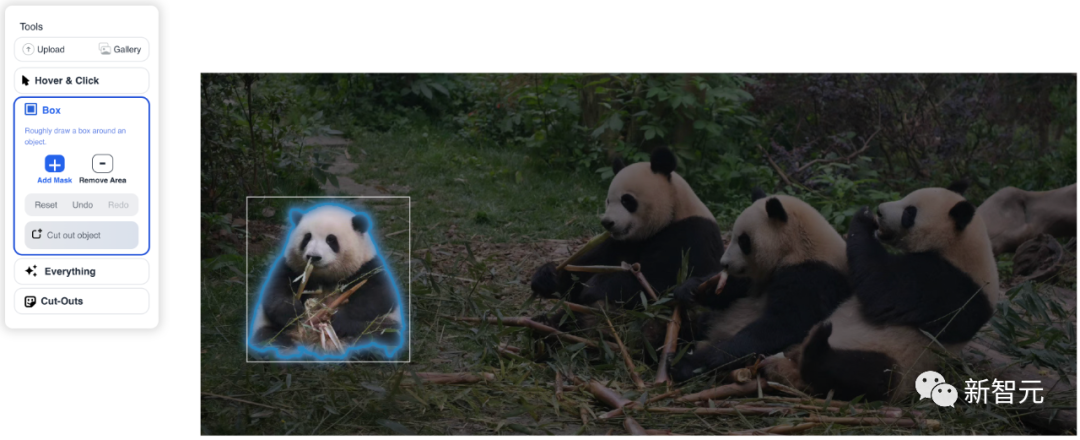
而在Box功能中,简单框选一下,就立马完成识别。
点Everything后,所有系统识别出的对象立刻全部被提取出来。
选Cut-Outs后,秒得一个三角团子。
SA-1B数据集:1100万张图像,11亿个掩码
除了发布的新模型,Meta还发布了迄今为止最大的分割数据集SA-1B。
这个数据集由1100万张多样化、高分辨率、保护隐私的图像,以及11亿个高质量分割掩码组成。
数据集的整体特性如下:
· 图像总数: 1100万
· 掩码总数: 11亿
· 每张图像的平均掩码: 100
· 平均图像分辨率: 1500 × 2250 pixels
注意:图像或掩码标注没有类标签
Meta特别强调,这些数据是通过我们的数据引擎收集的,所有掩码均由SAM完全自动生成。
有了SAM模型,收集新的分割掩码的速度比以往任何时候都快,交互式标注一个掩码只需要大约14秒。
每个掩码标注过程只比标注边界框慢2倍,使用最快的标注界面,标注边界框大约需要7秒。
与以前的大规模分割数据收集工作相比,SAM模型COCO完全手动的基于多边形的掩码标注快6.5倍,比以前最大的数据标注工作(也是模型辅助)快2倍。
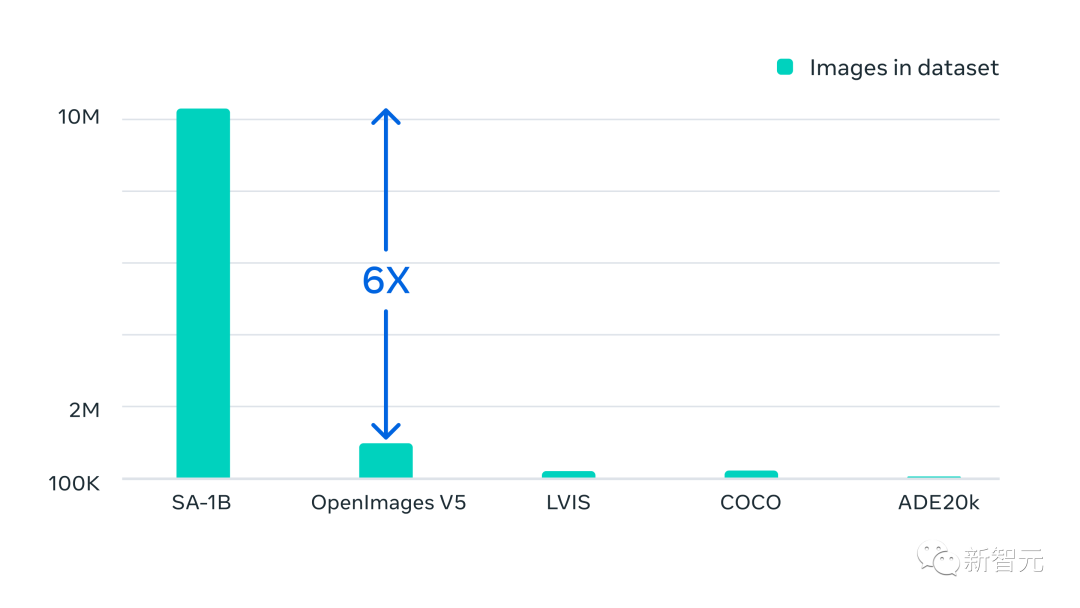
然而,依赖于交互式标注掩码并不足以创建10亿多个掩码数据集。因此,Meta构建了一个用于创建SA-1B数据集的数据引擎。
这个数据引擎有三个「齿轮」:
1. 模型辅助标注
2. 全自动标注与辅助标注的混合,有助于增加收集到的掩码的多样性
3. 全自动掩码创建,使数据集能够扩展
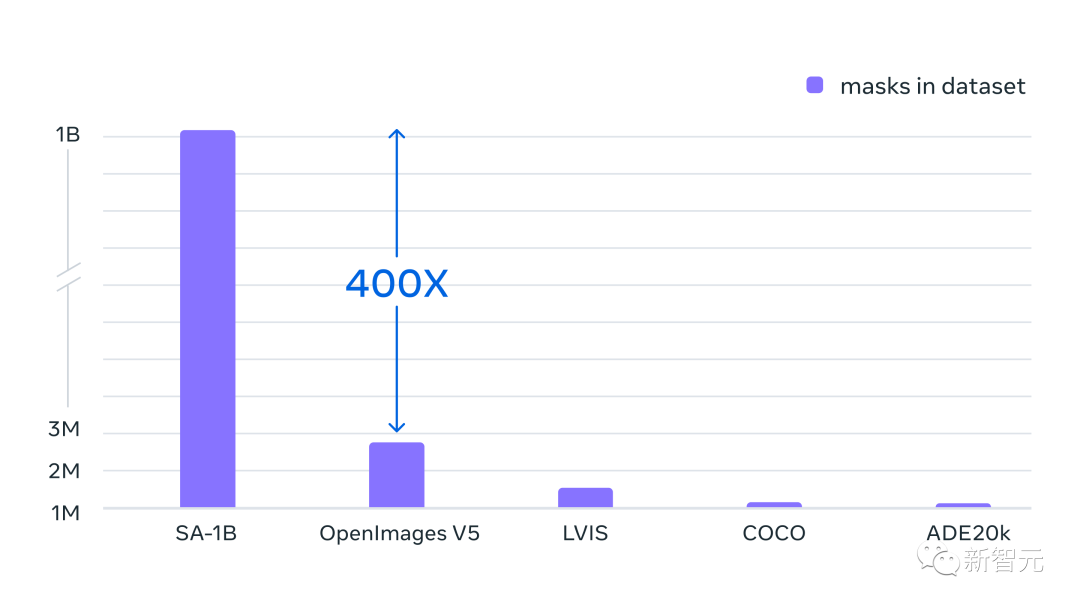
我们的最终数据集包括超过11亿个分割掩码,这些掩码收集在大约1100万张授权和保护隐私的图像上。
SA-1B比任何现有的分割数据集多出400倍的掩码。并且通过人类评估研究证实,掩码具有高质量和多样性,在某些情况下,甚至在质量上可与之前规模更小、完全手动标注数据集的掩码相媲美。
SA-1B的图片是通过来自多个国家/地区的照片提供商获取的,这些国家/地区跨越不同的地理区域和收入水平。
虽然某些地理区域仍然代表性不足,但SA-1B比以前的分割数据集在所有地区都有更多的图像和更好的整体代表性。
最后,Meta称希望这些数据可以成为新数据集的基础,这些数据集包含额外的标注,例如与每个掩模相关联的文本描述。
RBG大神带队
Ross Girshick
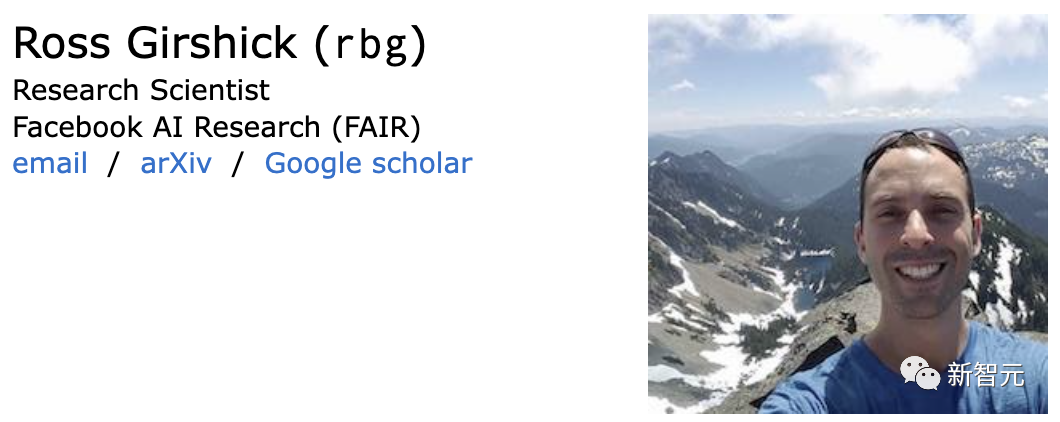
Ross Girshick(常被称为RBG大神)是Facebook人工智能研究院(FAIR)的一名研究科学家,他致力于计算机视觉和机器学习的研究。
2012年,Ross Girshick在Pedro Felzenszwalb的指导下获得了芝加哥大学的计算机科学博士学位。
在加入FAIR之前,Ross是微软研究院的研究员,也是加州大学伯克利分校的博士后,在那里他的导师是Jitendra Malik和Trevor Darrell。
他获得了2017年的PAMI青年研究员奖,2017年和2021年的PAMI Mark Everingham奖,以表彰他对开源软件的贡献。
众所周知,Ross和何恺明大神一起开发了R-CNN方法的目标检测算法。2017年,Ross和何恺明大神的Mask R-CNN论文获得了ICCV 2017最佳论文。
网友:CV真不存在了
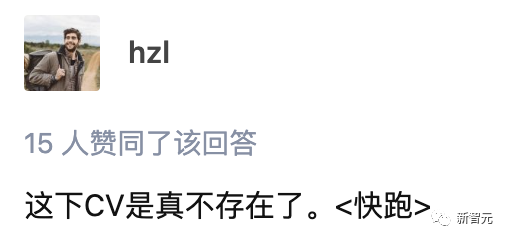
Meta打造的这款CV领域的分割基础模型,让许多网友高呼「这下,CV是真不存在了。」
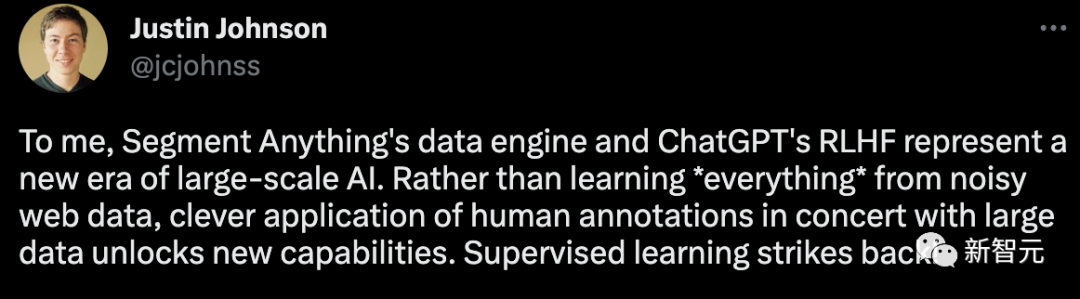
Meta科学家Justin Johnson表示:「对我来说,Segment Anything的数据引擎和ChatGPT的RLHF代表了大规模人工智能的新时代。与其从嘈杂的网络数据中学习一切,不如巧妙地应用人类标注与大数据相结合,以释放新的能力。监督学习强势回归!」
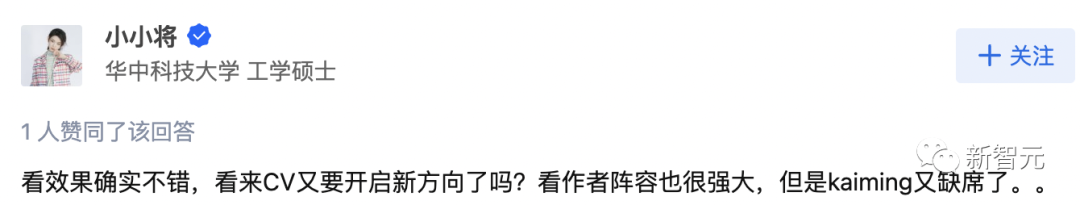
唯一遗憾的是,SAM模型发布主要是由Ross Girshick带队,何恺明却缺席了。
知友「matrix明仔」表示,这篇文章进一步证明多模态才是CV的未来,纯CV是没有明天的。

本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。


从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
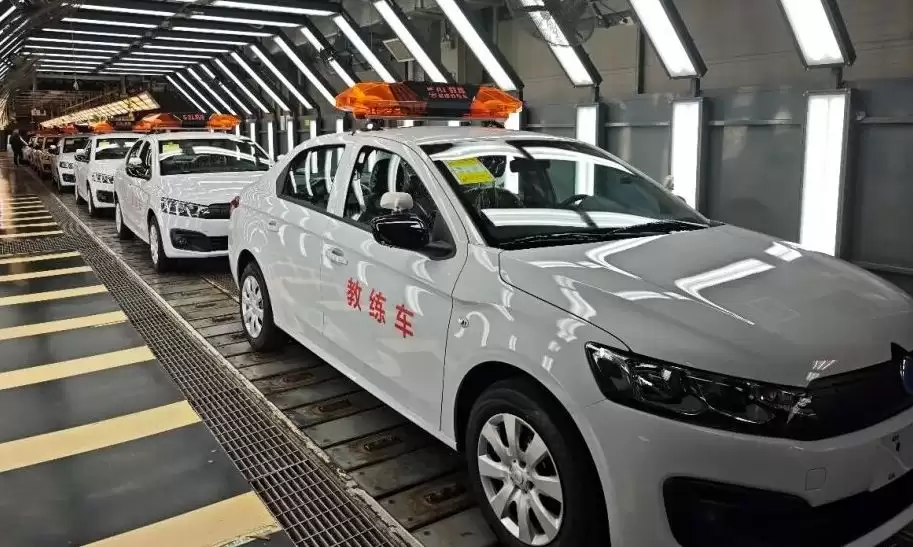
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。
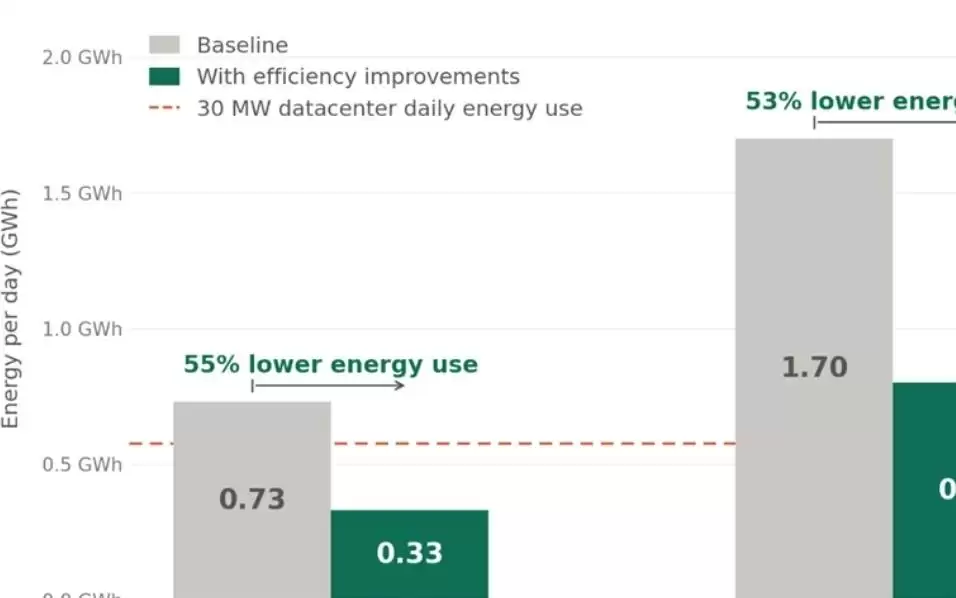
据微软引用《Joule》期刊的一项研究指出,每一次典型人工智能查询耗电量零点一六至零点六零瓦时,其冷却用水量中位数不足一滴水。大规模部署下,单位查询的效率会更高,总能耗可以降低一半以上。
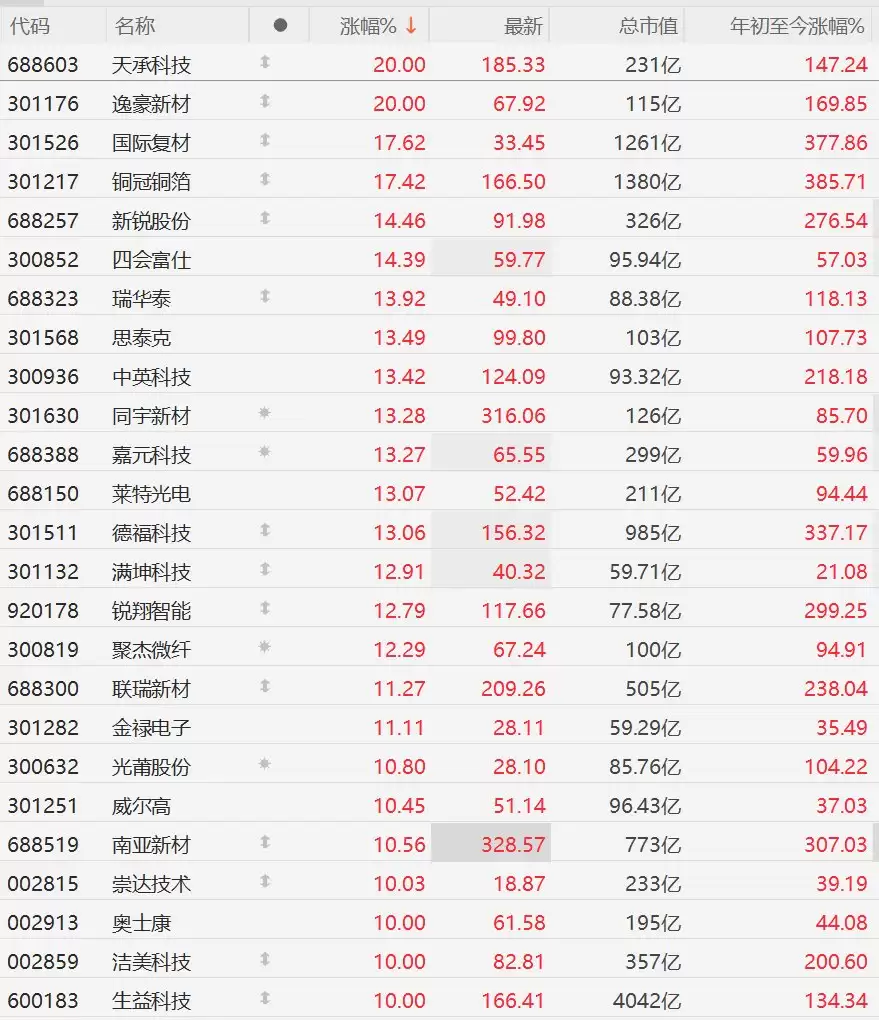
A股PCB概念板块掀起涨停潮,因摩根士丹利报告预测AI光模块PCB市场三年增长超5倍,2025至2028年规模从6.2亿美元增至37.7亿美元,年复合增速高达83%,远超光模块整体增速。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



