

Python for NLP:如何处理包含多个章节的PDF文件?
PythonforNLP:如何处理包含多个章节的PDF文件?在自然语言处理(NLP)任务中,我们常常需要处理包含多个章节的PDF文件。这些文件往往是学术论文、小说、技术手册等,每个章节都有其特定的格式和内容。本文将介绍如何使用Python处理这类PDF文件,并提供具体的代码示例。首先,我们需要安装一些Python库来帮助我们处理PDF文件。其中最常用的是
Python for NLP:如何处理包含多个章节的PDF文件?
在自然语言处理(NLP)任务中,我们常常需要处理包含多个章节的PDF文件。这些文件往往是学术论文、小说、技术手册等,每个章节都有其特定的格式和内容。本文将介绍如何使用Python处理这类PDF文件,并提供具体的代码示例。
首先,我们需要安装一些Python库来帮助我们处理PDF文件。其中最常用的是PyPDF2和pdfminer.six。我们可以使用pip命令来安装它们:
pip install PyPDF2
pip install pdfminer.six
接下来,我们可以使用PyPDF2库来读取PDF文件并获取其中的章节信息。下面是一个读取PDF文件并打印每个章节标题的代码示例:
import PyPDF2

def extract_chapter_titles(file_path):
    pdf_file = open(file_path, 'rb')
    pdf_reader = PyPDF2.PdfFileReader(pdf_file)

    for page_num in range(pdf_reader.numPages):
        page = pdf_reader.getPage(page_num)
        content = page.extract_text()

        # 根据具体情况提取章节标题
        # 例如,可以通过正则表达式来匹配章节标题
        chapter_title = extract_title_using_regex(content)

        print("章节标题:", chapter_title)

    pdf_file.close()

file_path = "path/to/pdf/file.pdf"
extract_chapter_titles(file_path)
在这个示例中,我们使用PyPDF2库来打开PDF文件并创建一个PdfFileReader对象。通过循环遍历每个页面并使用extract_text()方法来提取页面内容,我们可以得到一个包含所有文本内容的字符串。接着,我们可以使用正则表达式等方法来匹配并提取章节标题。
除了提取章节标题,有时我们还需要将PDF文件按照章节划分成多个子文件。这可以帮助我们更方便地处理每个章节的内容。下面是一个将PDF文件按照章节划分并保存为多个子文件的代码示例:
import PyPDF2

def split_pdf_by_chapter(file_path):
    pdf_file = open(file_path, 'rb')
    pdf_reader = PyPDF2.PdfFileReader(pdf_file)

    for page_num in range(pdf_reader.numPages):
        page = pdf_reader.getPage(page_num)
        content = page.extract_text()

        # 根据具体情况提取章节标题
        # 例如,可以通过正则表达式来匹配章节标题
        chapter_title = extract_title_using_regex(content)

        new_pdf = PyPDF2.PdfFileWriter()
        new_pdf.addPage(page)

        new_file_name = chapter_title + ".pdf"
        new_file_path = "path/to/output/folder/" + new_file_name

        with open(new_file_path, "wb") as new_file:
            new_pdf.write(new_file)

    pdf_file.close()

file_path = "path/to/pdf/file.pdf"
split_pdf_by_chapter(file_path)
在这个示例中,我们首先创建一个PdfFileWriter对象,并向其中添加每个章节的页面。然后,我们根据章节标题创建一个新的PDF文件,并将添加的页面写入其中。
需要注意的是,上述示例只是一个简单的示例,实际中你可能需要根据具体的PDF文件结构及其特点进行修改。不同的PDF文件可能会有不同的结构和格式,你可能需要进行一些预处理或使用更复杂的方法来提取章节标题并划分PDF文件。
总结起来,使用Python处理包含多个章节的PDF文件是一个常见的NLP任务。通过使用PyPDF2等库,我们可以方便地读取PDF文件,并从中提取章节标题和内容,或者将PDF文件按照章节划分为多个子文件。希望本文所提供的代码示例能对你的工作有所帮助。
本文详细介绍使用在线工具压缩PDF文件的完整流程。从文件检查、上传、处理到下载,逐步指导用户如何高效减小PDF体积,确保文件清晰且符合平台要求。
本文介绍使用极轻PDF(pdf.cn)在线工具拆分PDF文件的操作流程。核心步骤包括:进入工具列表、上传文件、确认范围、开始处理及下载结果。重点强调操作前需复制源文件以防覆盖,拆分后需核对页码、数量、顺序及文件名。若遇上传失败或处理超时,需整理文件大小、截图及浏览器信息联系market@pdf.cn处理。
文本摘要可通过Python实现,主要方法包括:1.使用现成库如Sumy和PyTextRank进行抽取式摘要;2.结合jieba分词与TextRank算法处理中文文本;3.利用HuggingFaceTransformers实现生成式摘要。Sumy支持多种算法,适合通用场景,PyTextRank更适合英文但也可用于中文预处理后的内容。中文需先分词再构建共现图并计算句子重要性,或使用Gensim的summarize方法。深度学习方法推荐Transformers库中的BART、T5等模型,可理解原文并生成摘要,其
本文早在揭开语言模型的神秘面纱,阐明其处理原始文本数据的基本概念和机制。它涵盖了几种类型的语言模型和大型语言模型,重点关注基于神经网络的模型。语言模型定义语言模型专注于生成类似人类类的文本的能力。通用语言模型本质上是单词序列的统计模型或概率分布,用于解释单词在每个序列中出现的可能性。这有助于根据句子中的前一个单词预测下一个单词或单词。简化的概率语言模型可用于机器翻译、自动纠错、语音识别和自动完成等各种应用,为用户填写以下单词或建议可能的单词序列。该类型模型已经发展成为更先进的模型,包括变换器模型,通过考虑
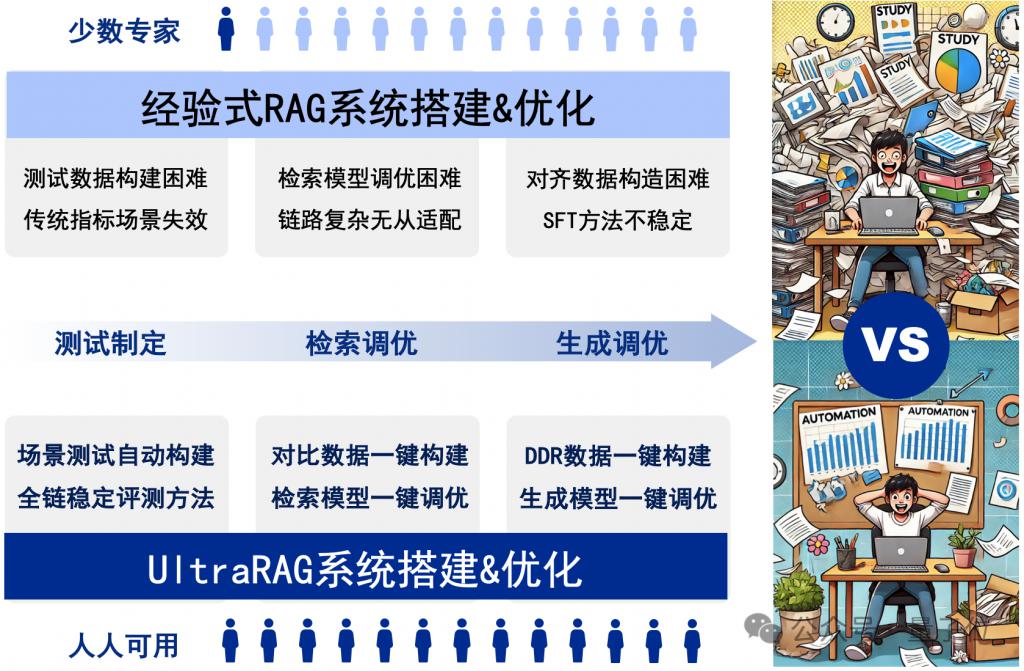
清华大学THUNLP团队联合多家机构推出UltraRAG框架,简化RAG系统搭建流程。传统RAG系统搭建复杂,UltraRAG框架提供“单反相机”级精细化配置和“卡片机”级一键式操作,显著降低学习成本和开发周期。UltraRAG框架的核心优势在于其对模型与知识库的适配,避免了反复的模型选型。其模块化设计也方便科研人员快速迭代。用户可轻松完成数据到模型的全流程管理。零代码WebUI,一键式数据构建UltraRAG的零代码WebUI是其一大亮点,即使没有编程经验的用户也能轻松构建、训练和评估模型。框架
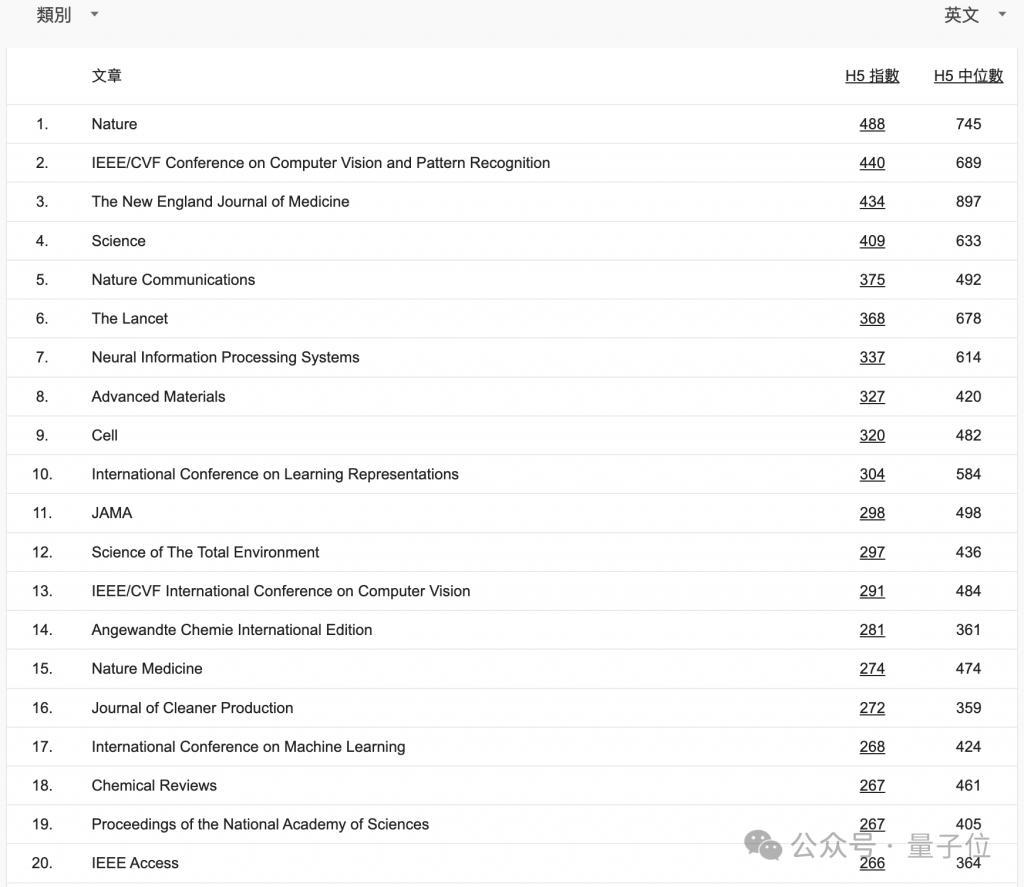
2024谷歌学术指标(GoogleScholarMetrics)出炉,AI顶会掀起狂欢——CVPR成为第二大学术出版物,超越Science,仅次于Nature。除此之外,NeurIPS排名第7;ICLR第10、ICCV第13、ICML第17…前20名中,四分之一被AI会议占据。网友纷纷表示今年这榜单有点"crazy":各领域学者教授也纷纷表示惊讶:CVPR成为第二大出版物谷歌学术指标评价体系主要基于h5指数(h5-index),h5指数指的过去整5年,即2019-2023年"发表的h篇文章中,每篇至少都被

Python是一种流行的编程语言,也是自然语言处理(NLP)中广泛使用的工具之一。NLP是计算机科学和人工智能的交叉领域,旨在使计算机系统能够理解、解释和生成人类语言。Python中的NLP主要涉及以下几个方面:1.文本处理文本处理是NLP的基础,这包括读取、分词、清理和转换文本数据。Python提供了许多工具和库来处理文本数据,例如字符串操作、正则表达式、
PythonforNLP:如何处理包含封面和目录的PDF文件?概述:在自然语言处理(NLP)的领域中,处理PDF文件是一项常见的任务。但是,当PDF文件包含封面和目录等非文本内容时,提取和处理文本变得更加困难。本文将介绍如何使用Python处理包含封面和目录的PDF文件,并提供具体的代码示例。步骤一:安装依赖在开始之前,我们首先需要安装一些依赖库。我们将
如何利用PythonforNLP将PDF文本转换为可分析的数据?引言:自然语言处理(NaturalLanguageProcessing,NLP)是人工智能领域中的一个重要分支,它致力于研究和开发使计算机能够理解、处理、生成自然语言的方法和技术。在NLP的应用中,将PDF文本转换为可分析的数据是一个常见的任务。本文将介绍如何利用Python及其相关库
如何使用PythonforNLP处理包含多个段落的PDF文本?摘要:自然语言处理(NLP)是一门专门处理和分析人类语言的领域。Python是一种功能强大的编程语言,广泛用于数据处理和分析。本文将介绍如何使用Python和一些流行的库来处理包含多个段落的PDF文本,以便进行自然语言处理。导入库:首先,我们需要导入一些库来帮助我们处理PDF文件和进行自然语言





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



