

Python for NLP:如何处理包含多列数据的PDF文本?
PythonforNLP:如何处理包含多列数据的PDF文本?概述:随着自然语言处理(NLP)的发展,对于处理PDF文本已经成为一个非常重要的任务。然而,当PDF文本包含多列数据时,它们的处理就变得更加复杂。在本文中,我们将介绍如何使用Python处理包含多列数据的PDF文本,提取有用的信息,并进行适当的数据处理。步骤一:安装必要的库首先,我们需要安装一
Python for NLP: 如何处理包含多列数据的PDF文本?
概述:
随着自然语言处理(NLP)的发展,对于处理PDF文本已经成为一个非常重要的任务。然而,当PDF文本包含多列数据时,它们的处理就变得更加复杂。在本文中,我们将介绍如何使用Python处理包含多列数据的PDF文本,提取有用的信息,并进行适当的数据处理。
步骤一:安装必要的库
首先,我们需要安装一些必要的Python库,以便于处理PDF文本。这些库包括pdfplumber和pandas。可以使用以下命令来安装它们:
pip install pdfplumber pandas
步骤二:导入所需的库
在开始实际的代码编写之前,我们需要导入所需的库。通过运行以下命令,我们可以导入pdfplumber和pandas库:
import pdfplumber
import pandas as pd
步骤三:读取PDF文件并提取文本
接下来,我们需要读取PDF文件并提取文本。使用pdfplumber库中的pdfplumber.open()函数可以打开PDF文件,并使用extract_text()方法提取所有文本。以下是一个简单的示例:
with pdfplumber.open('multi_column_data.pdf') as pdf:
    text = ""
    for page in pdf.pages:
        text += page.extract_text()
步骤四:将文本转换为DataFrame
在提取了文本后,我们需要将其转换为适合处理的数据结构。由于我们的PDF文本包含多列数据,我们可以使用pandas库的DataFrame来处理这些数据。以下是将文本转换为DataFrame的示例:
data = pd.DataFrame([row.split('
') for row in text.split('

') if row.strip() != ''])
在上面的代码中,我们使用split()方法按行分割文本,并使用split('
')将每行进一步分割为列。我们还使用split('
')分割不同行之间的数据,并使用判断条件去掉空白行。
步骤五:处理和清洗数据
现在,我们已经将文本转换为DataFrame,我们可以开始对数据进行处理和清洗了。在处理多列数据时,可以使用pandas提供的各种方法和函数进行处理。以下是一些常见的数据处理操作的示例:
选择特定的列:
selected_data = data[[0, 1]]
重命名列:
data.columns = ['Column1', 'Column2']
删除带有缺失值的行:
data.dropna(inplace=True)
转换数据类型:
data['Column1'] = data['Column1'].astype(int)
步骤六:保存数据
最后一步是保存处理后的数据。可以使用pandas库提供的to_csv()方法将数据保存为CSV文件,也可以使用to_excel()方法将数据保存为Excel文件。以下是保存数据为CSV文件的示例:
data.to_csv('processed_data.csv', index=False)总结:
通过使用Python中的pdfplumber和pandas库,我们可以轻松地处理包含多列数据的PDF文本。首先,我们使用pdfplumber库提取文本并将其转换为适宜处理的数据结构。然后,使用pandas库进行数据处理和清洗。最后,我们可以将处理后的数据保存为CSV或Excel文件。希望本文提供了一种简单而有效的方法来处理包含多列数据的PDF文本。
文本摘要可通过Python实现,主要方法包括:1.使用现成库如Sumy和PyTextRank进行抽取式摘要;2.结合jieba分词与TextRank算法处理中文文本;3.利用HuggingFaceTransformers实现生成式摘要。Sumy支持多种算法,适合通用场景,PyTextRank更适合英文但也可用于中文预处理后的内容。中文需先分词再构建共现图并计算句子重要性,或使用Gensim的summarize方法。深度学习方法推荐Transformers库中的BART、T5等模型,可理解原文并生成摘要,其
本文早在揭开语言模型的神秘面纱,阐明其处理原始文本数据的基本概念和机制。它涵盖了几种类型的语言模型和大型语言模型,重点关注基于神经网络的模型。语言模型定义语言模型专注于生成类似人类类的文本的能力。通用语言模型本质上是单词序列的统计模型或概率分布,用于解释单词在每个序列中出现的可能性。这有助于根据句子中的前一个单词预测下一个单词或单词。简化的概率语言模型可用于机器翻译、自动纠错、语音识别和自动完成等各种应用,为用户填写以下单词或建议可能的单词序列。该类型模型已经发展成为更先进的模型,包括变换器模型,通过考虑
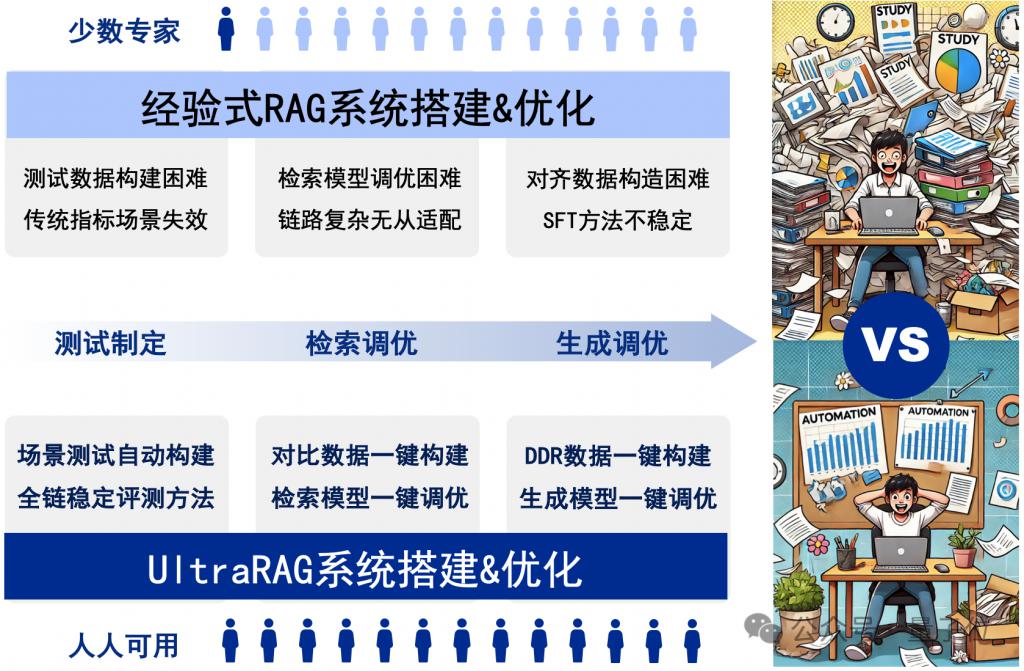
清华大学THUNLP团队联合多家机构推出UltraRAG框架,简化RAG系统搭建流程。传统RAG系统搭建复杂,UltraRAG框架提供“单反相机”级精细化配置和“卡片机”级一键式操作,显著降低学习成本和开发周期。UltraRAG框架的核心优势在于其对模型与知识库的适配,避免了反复的模型选型。其模块化设计也方便科研人员快速迭代。用户可轻松完成数据到模型的全流程管理。零代码WebUI,一键式数据构建UltraRAG的零代码WebUI是其一大亮点,即使没有编程经验的用户也能轻松构建、训练和评估模型。框架

Oracle中常见的索引类型及最佳实践分享在Oracle数据库中,索引是提高查询性能的重要机制之一。合理地设计和使用索引可以加快查询速度,优化数据库性能。本文将介绍Oracle中常见的索引类型,以及使用这些索引的最佳实践,并附上具体的代码示例。一、常见的索引类型B树索引(B-treeIndex):默认的索引类型,适用于等值查询和范围查询。唯一索引(Uniq
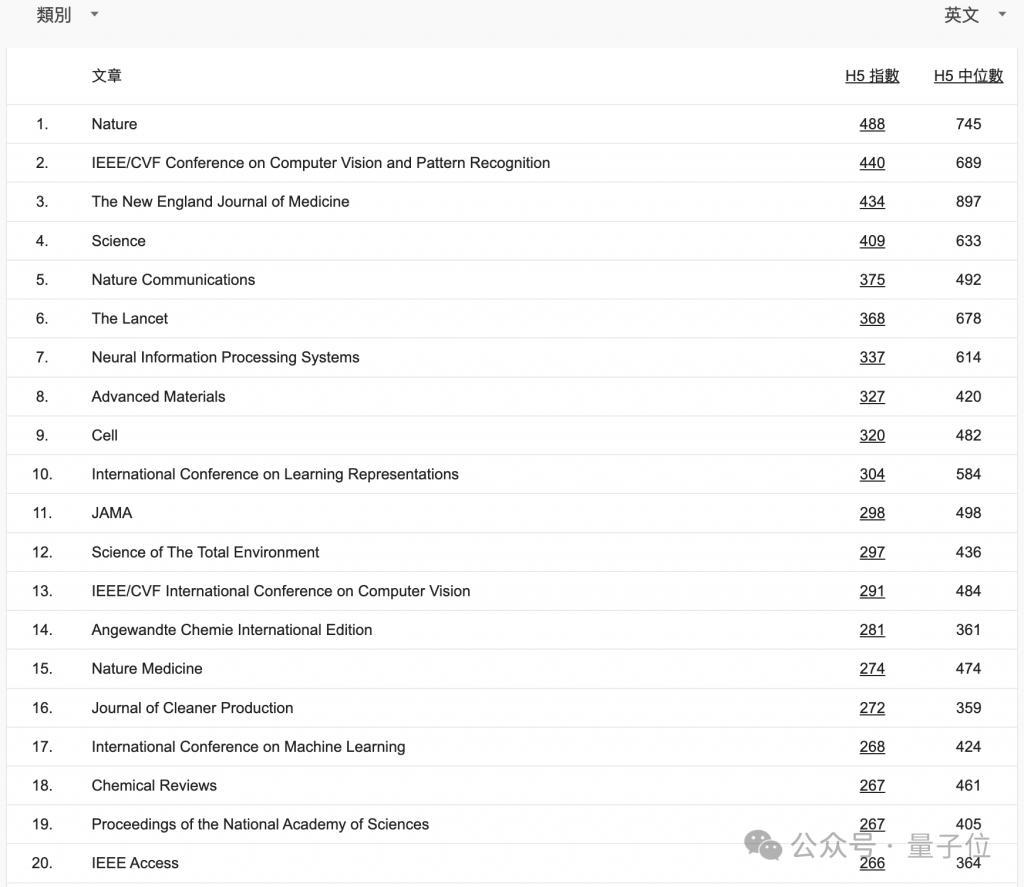
2024谷歌学术指标(GoogleScholarMetrics)出炉,AI顶会掀起狂欢——CVPR成为第二大学术出版物,超越Science,仅次于Nature。除此之外,NeurIPS排名第7;ICLR第10、ICCV第13、ICML第17…前20名中,四分之一被AI会议占据。网友纷纷表示今年这榜单有点"crazy":各领域学者教授也纷纷表示惊讶:CVPR成为第二大出版物谷歌学术指标评价体系主要基于h5指数(h5-index),h5指数指的过去整5年,即2019-2023年"发表的h篇文章中,每篇至少都被
Python是一种流行的编程语言,也是自然语言处理(NLP)中广泛使用的工具之一。NLP是计算机科学和人工智能的交叉领域,旨在使计算机系统能够理解、解释和生成人类语言。Python中的NLP主要涉及以下几个方面:1.文本处理文本处理是NLP的基础,这包括读取、分词、清理和转换文本数据。Python提供了许多工具和库来处理文本数据,例如字符串操作、正则表达式、
如何利用PythonforNLP将PDF文本转换为可分析的数据?引言:自然语言处理(NaturalLanguageProcessing,NLP)是人工智能领域中的一个重要分支,它致力于研究和开发使计算机能够理解、处理、生成自然语言的方法和技术。在NLP的应用中,将PDF文本转换为可分析的数据是一个常见的任务。本文将介绍如何利用Python及其相关库
如何使用PythonforNLP处理包含多个段落的PDF文本?摘要:自然语言处理(NLP)是一门专门处理和分析人类语言的领域。Python是一种功能强大的编程语言,广泛用于数据处理和分析。本文将介绍如何使用Python和一些流行的库来处理包含多个段落的PDF文本,以便进行自然语言处理。导入库:首先,我们需要导入一些库来帮助我们处理PDF文件和进行自然语言
如何用PythonforNLP提取文本PDF文件中的元数据?随着大数据时代的到来,信息的处理变得越来越重要。在自然语言处理(NLP)中,提取文本数据中的元数据是一个关键的任务。本文将介绍如何使用PythonforNLP技术提取PDF文件中的元数据,并提供具体的代码示例。Python是一种流行的编程语言,具有简洁、易读和强大的特点。Python有许多强
如何使用PythonforNLP处理含有缩写词的PDF文件在自然语言处理(NLP)中,处理包含缩写词的PDF文件是一个常见的挑战。缩写词在文本中经常出现,而且很容易给文本的理解和分析带来困难。本文将介绍如何使用Python进行NLP处理,解决这个问题,并附上具体的代码示例。安装所需的Python库首先,我们需要安装一些常用的Python库,包括PyPDF





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



