

popcnt指令的前世今生探索
最近群聊里传了一个面试题实现统计1的个数(汉明权重hammingWeight),使用popcnt的算法对硬件不友好,有无绕过的思路显然这个哥们的第一个实现是代码语言:javascript代码运行次数:0运行复制inthammingWeight_popcnt(uint64_tn){return__builtin_popcountll(n);}当然c++20也支持https://en.cppreference.com/w/cpp/numeric/popcount一行,觉得自己很帅,当然面试官不
最近群聊里传了一个面试题
实现统计1的个数(汉明权重 hammingWeight),使用popcnt的算法对硬件不友好,有无绕过的思路
显然这个哥们的第一个实现是
代码语言:javascript代码运行次数:0运行复制int hammingWeight_popcnt(uint64_t n) { return __builtin_popcountll(n);}当然c++20也支持 https://en.cppreference.com/w/cpp/numeric/popcount
一行,觉得自己很帅,当然面试官不喜欢,提示不要用popcnt,所谓的对硬件不友好指的应该是部分硬件没有这个指令
又或者性能原因?难道GPU上的popcnt性能很差?按下不表
直接贴实现
代码语言:javascript代码运行次数:0运行复制int hammingWeight(uint64_t n) { int ret = 0; while (n) { n &= n - 1; ret++; } return ret;}其实开启 O2 加上 -march=native,大家都会生成相同的popcnt, 早在2016年Lemire大哥就发现了
https://lemire.me/blog/2016/05/23/the-surprising-cleverness-of-modern-compilers/
附上llvm检测的代码 https://github.com/llvm-mirror/llvm/blob/f36485f7ac2a8d72ad0e0f2134c17fd365272285/lib/Transforms/Scalar/LoopIdiomRecognize.cpp#L960
只开O2可能保守场景不会生成popcnt
如果不用popcnt,代码的性能和popcnt差距大吗?或者说,popcnt有危害吗?比如延迟高?
直接上llvm-mca分析 https://godbolt.org/z/odox8Wdr5
首先插入一个简单粗暴的教程,如何看懂llvm-mca https://llvm.org/docs/CommandGuide/llvm-mca.html
就是机器码分析器,模拟机器码执行效果,我们不用装llvm-mca,直接用godbolt内置的工具。代码已经生成好了
直接贴popcnt代码的结果吧
代码语言:javascript代码运行次数:0运行复制Iterations: 100Instructions: 200Total Cycles: 57Total uOps: 200Dispatch Width: 6uOps Per Cycle: 3.51IPC: 3.51Block RThroughput: 0.5Instruction Info:[1]: #uOps[2]: Latency[3]: RThroughput[4]: MayLoad[5]: MayStore[6]: HasSideEffects (U)[1] [2] [3] [4] [5] [6] Instructions: 1 1 0.25 popcnt rax, rdi 1 5 0.50 U retResources:[0] - Zn3AGU0[1] - Zn3AGU1[2] - Zn3AGU2[3] - Zn3ALU0[4] - Zn3ALU1[5] - Zn3ALU2[6] - Zn3ALU3[7] - Zn3BRU1[8] - Zn3FPP0[9] - Zn3FPP1[10] - Zn3FPP2[11] - Zn3FPP3[12.0] - Zn3FPP45[12.1] - Zn3FPP45[13] - Zn3FPSt[14.0] - Zn3LSU[14.1] - Zn3LSU[14.2] - Zn3LSU[15.0] - Zn3Load[15.1] - Zn3Load[15.2] - Zn3Load[16.0] - Zn3Store[16.1] - Zn3StoreResource pressure per iteration:[0] [1] [2] [3] [4] [5] [6] [7] [8] [9] [10] [11] [12.0] [12.1] [13] [14.0] [14.1] [14.2] [15.0] [15.1] [15.2] [16.0] [16.1] 0.33 0.33 0.34 0.50 0.33 0.33 0.34 0.50 - - - - - - - 0.33 0.33 0.34 0.33 0.33 0.34 - - Resource pressure by instruction:[0] [1] [2] [3] [4] [5] [6] [7] [8] [9] [10] [11] [12.0] [12.1] [13] [14.0] [14.1] [14.2] [15.0] [15.1] [15.2] [16.0] [16.1] Instructions: - - - - 0.33 0.33 0.34 - - - - - - - - - - - - - - - - popcnt rax, rdi0.33 0.33 0.34 0.50 - - - 0.50 - - - - - - - 0.33 0.33 0.34 0.33 0.33 0.34 - - retwarning: found a return instruction in the input assembly sequence.note: program counter updates are ignored.先记下这几个数字
代码语言:javascript代码运行次数:0运行复制Iterations: 100Instructions: 200Total Cycles: 57Total uOps: 200Dispatch Width: 6uOps Per Cycle: 3.51IPC: 3.51Block RThroughput: 0.5重点参数 是IPC, uOps Per Cycle, 和 Block RThroughput (Block Reciprocal Throughput).
• IPC就是模拟的总指令数字除以总cycle数 一般这个就表示吞吐了 Instructions / Total Cycles 显然这个值越高越好• Block RThroughput (Block Reciprocal Throughput) 就是Block Throughput(每个cycle能运行几次block)的倒数 就是 Total Cycles / Iterations 每次运行能用几个cycle的意思,显然,这个值越低越好• Instructions / Iterations 代表每次迭代能执行几次指令 显然 Instructions / Iterations / Block RThroughput = IPC 这个数比直接算IPC大点(有误差。。。。)你就当他是无影响的最大IPC吧• (循环数据引用问题可能导致影响。假设循环展开无影响)• uOps Per Cycle,就是模拟的微指令数总和除以总cycle数字 Total uOps/ Total Cycles ,这个和IPC含义差不多,显然这个值越高越好,但是要关注Dispatch Width - uOps Per Cycle 差值, Dispatch Width 表示最大发射指令的并行带宽,相当于资源限制了,uOps Per Cycle表示实际模拟使用的带宽,显然越接近Dispatch Width越说明资源受限制,利用率太高了,相当于CPU高了,需要找到瓶颈来源• 剩下的是执行模拟以及在哪里卡了,具体分析可以用-bottleneck-analysis,得本地搞了godbolt貌似不能玩好了,根据上面的godbolt结果,直接把数据差异对比一下
另外 网上搜到了google的两个实现,把数据补充上 https://godbolt.org/z/9nsczeT5c
代码语言:javascript代码运行次数:0运行复制int hammingWeightV2(uint64_t n) { n -= (n >> 1) & 0x5555555555555555ULL; n = ((n >> 2) & 0x3333333333333333ULL) + (n & 0x3333333333333333ULL); return (((n + (n >> 4)) & 0xF0F0F0F0F0F0F0FULL) * 0x101010101010101ULL) >> 56;}这个实现在一些cpu上有问题 type mismatch。不过一般来说和buildin popcnt一样效果
代码语言:javascript代码运行次数:0运行复制int hammingWeight_popcntV2(uint64_t n) { int64_t count = 0; asm("popcnt %1,%0" : "=r"(count) : "rm"(n) : "cc"); return count;}实现
编译器版本
Dispatch Width
uOps/Cycle
IPC
Block RThroughput
popcnt
gcc 13.2
6
3.67
1.83
1.0
普通实现
gcc 13.2
4
3.94
3.54
2.5
popcnt
clang 17.0.1
6
4.59
2.75
1.0
普通实现
clang 17.0.1
6
4.78
3.83
1.7
popcnt v2
gcc 13.2
6
2.14
2.14
1.3
手写SWAR
gcc 13.2
6
4.09
3.72
3.8
popcnt v2
clang 17.0.1
6
3.67
1.83
1.0
手写SWAR
clang 17.0.1
6
4.09
3.72
3.8
能看出popcnt的Block RThroughput 低,这显然说明性能更好
然后看IPC和uOps/Cycle clang的明显比gcc的要高,但汇编说实话一个两行一个一行,这个没啥比较的意义了
重点和普通实现比,clang生成的汇编要比gcc好一点,Block RThroughput 低 IPC高,且没有特别接近Dispatch Width瓶颈
但说实话就差一个汇编这点差距根本比不出什么。只能大概说一下popcnt的汇编更少,性能更好而已
感觉SWAR这种看起来很屌, 但看mca分析感觉不太行 我跑了个qb压测,但是网站挂了,还需要本地跑一下
https://github.com/wanghenshui/little_bm/blob/dev/hamming_weight/hamming_weight.cc
我的测试结果来看,SWAR性能反而比popcnt要好,即使Block RThroughput 很高,但IPC也很高,性能反而非常好
代码语言:javascript代码运行次数:0运行复制taskset -c 0 ./hamming_weight2024-02-03T22:39:35+08:00Running ./hamming_weightRun on (16 X 3392.38 MHz CPU s)CPU Caches: L1 Data 32 KiB (x8) L1 Instruction 32 KiB (x8) L2 Unified 512 KiB (x8) L3 Unified 16384 KiB (x1)Load Average: 0.01, 0.02, 0.00-----------------------------------------------------------------------Benchmark Time CPU Iterations-----------------------------------------------------------------------BM_hammingWeight_popcnt/0 26.6 ns 26.6 ns 26281110BM_hammingWeight_popcnt/128 265 ns 265 ns 2622989BM_hammingWeight_popcnt/256 526 ns 526 ns 1332695BM_hammingWeight_popcnt/512 1048 ns 1048 ns 666562BM_hammingWeight_popcnt/1024 2096 ns 2095 ns 334434BM_hammingWeight/0 80.7 ns 80.7 ns 8689750BM_hammingWeight/128 1643 ns 1642 ns 447638BM_hammingWeight/256 3646 ns 3646 ns 195882BM_hammingWeight/512 8099 ns 8097 ns 85508BM_hammingWeight/1024 17193 ns 17190 ns 41208BM_hammingWeightV2/0/0 11.8 ns 11.8 ns 58402778BM_hammingWeightV2/128 118 ns 118 ns 5951445BM_hammingWeightV2/256 233 ns 233 ns 3001257BM_hammingWeightV2/512 463 ns 463 ns 1510925BM_hammingWeightV2/1024 927 ns 927 ns 758631不过还需要其他机器测试,我的nuc是r9 6950hx zen3+,性能不错
github CI机器,SWAR和popcnt就差不多了。
代码语言:javascript代码运行次数:0运行复制Running ./bm_hamming_weightRun on (4 X 2868.73 MHz CPU s)CPU Caches: L1 Data 32 KiB (x2) L1 Instruction 32 KiB (x2) L2 Unified 512 KiB (x2) L3 Unified 32768 KiB (x1)Load Average: 1.98, 0.54, 0.19-----------------------------------------------------------------------Benchmark Time CPU Iterations-----------------------------------------------------------------------BM_hammingWeight_popcnt/0 17.5 ns 17.5 ns 39446954BM_hammingWeight_popcnt/128 173 ns 173 ns 4056917BM_hammingWeight_popcnt/256 342 ns 342 ns 2051152BM_hammingWeight_popcnt/512 679 ns 679 ns 1032384BM_hammingWeight_popcnt/1024 1354 ns 1354 ns 517551BM_hammingWeight/0 124 ns 124 ns 5638895BM_hammingWeight/128 2394 ns 2394 ns 280377BM_hammingWeight/256 5511 ns 5511 ns 123293BM_hammingWeight/512 12036 ns 12036 ns 58336BM_hammingWeight/1024 25711 ns 25710 ns 27149BM_hammingWeightV2/0/0 17.8 ns 17.8 ns 39494382BM_hammingWeightV2/128 182 ns 182 ns 3848768BM_hammingWeightV2/256 360 ns 360 ns 1943778BM_hammingWeightV2/512 709 ns 709 ns 988825BM_hammingWeightV2/1024 1418 ns 1418 ns 493319家人们,需要你们的补充测试,各种机器, 复现代码https://github.com/wanghenshui/little_bm 运行build.sh即可
话说回来,数1到底能干嘛?这里要引入汉明距离 编辑距离相关的概念
简单理解就是查diff 纠错码之类的效果
popcnt的来源 http://www.talkchess.com/forum3/viewtopic.php?t=38521
上个世纪60年代,计算机还属于大型机百花齐放的年代,Control Data Corporation公司的CDC 机器卖的不错,国际象棋也在用这个软件。他们的场景就是棋盘格确认位置,所以实现了popcnt类似的能力,算位置坐标,美国国家安全局(NSA)发现了他们有这个能力,他们的新机器CDC 6000,政府采购并要求加上这个功能,主要是为了类似汉明距离之类的信息统计,相当于变相hash,用来实现校对diff之类的能力,所以也被叫做NSA Instruction (NSA指令)
这个指令也是那个时代的特殊产物把,算力不行并没有高级的hash能力,只能通过数1模拟,后来CPU性能提升渐渐的都不支持了,然后后来部分CPU支持部分CPU不支持,到现代全都捡回来
现在的CPU也有很多不支持popcnt指令,以至于游戏客户端领域会有popcnt patch之类的玩意,给玩家打patch绕过popcnt https://github.com/ogurets/popcnt_emulator
还有什么能用到数1?
指纹?安全领域,这种更多是汉明距离场景的推广
能用到bitmap的地方,不过使用bitmap不一定非得算总数
比如 Hash Array Mapped Tries 结合tries的压缩优点 + bitmap定位槽,
bitmap浪费所以要压缩一下,位运算躲不了数1场景
再比如 Succinct Data Structures terarkdb的memtable用的就这玩意,压缩率高
关于popcnt的信息我就收集到这么多的,大家有其他见解/批评还可以补充一下
另外,跑一下压测代码!看看你的CPU结果是什么样子的
参考• https://vaibhavsagar.com/blog/2019/09/08/popcount/ 一些资料汇总在这里搜到的。我一开始是根据群友聊的和关键字搜到hackernews上这篇文章的分享,介绍了背景和部分应用• https://abseil.io/fast/9 这里说的话我很赞同,性能测试是个周期性的工作,可能旧的代码有时候快,后面时代/硬件进步,又慢了 还是要具体机器具体分析• https://github.com/google/supersonic/blob/master/supersonic/utils/bits.h• https://stackoverflow.com/questions/28802692/how-is-popcnt-implemented-in-hardware 这个没看,但感觉现代CPU popcnt代价已经很低了
剑桥大学联合MetaRealityLabs的科研团队深入探究了人类视觉系统对不同尺寸与分辨率显示屏的感知极限。研究发现,在特定观看条件下,盲目追求更高分辨率可能并无实际视觉收益。实验中,科学家系统测试了人眼对各类颜色组合的分辨上限:黑白对比下最高可达94像素每度视角,红绿通道为89像素/度,而黄紫波段则下降至53像素/度。这一分辨能力由人眼生理结构决定,与显示设备的物理尺寸或观看距离无关。对于主机游戏玩家而言,结果颇具警示意义:当观看距离为3米时,50英寸电视的视觉清晰度上限约为1440P。此时即便内
2025年独显市场:繁荣背后的冰火两重天 最新行业数据带来一个令人振奋的消息:2025年全球台式机独立显卡出货量达到4428万张,相比2024年的3470万张实现了近千万张的增长。然而,这份繁荣背后隐藏着一个不容忽视的现实——市场竞争格局正在走向极度分化。 垄断加剧:NVIDIA的绝对统治 仔细分析
Intel 计划上调处理器价格,AI热潮引发连锁反应 电脑硬件市场近期传来重要动向:英特尔(Intel)正计划调整其消费级处理器的定价策略。根据韩国媒体 ETNews 的报道,英特尔已向其主要合作伙伴发出通知,预计将旗下消费级 CPU 的价格上调约 10%。这项变动并非停留在纸面,业界预计最快在今年
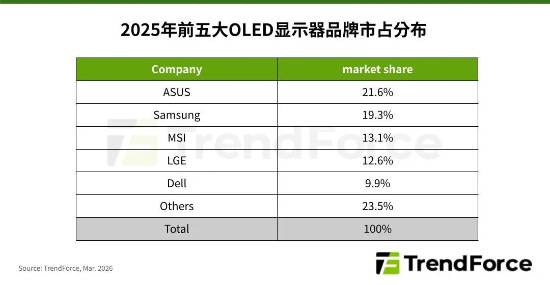
OLED显示器的爆发与新秩序:2025市场复盘与前瞻 TrendForce集邦咨询的最新数据揭示了一个令人振奋的信号:2025年,全球OLED显示器市场迎来了一次真正意义上的“起飞”。出货量达到273.5万台,同比增长高达92%——这几乎意味着市场规模在一年内翻了一番。 你也许会问,引爆市场的关键是

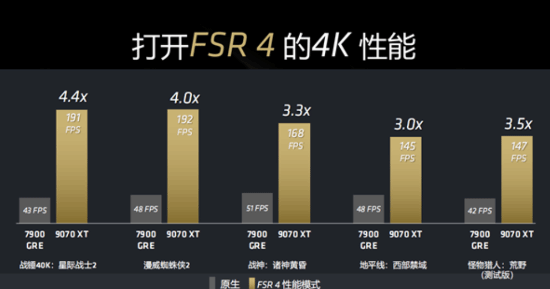
AMD在RX9000系列显卡上推出了FSR4技术,性能可轻松提升3倍多,整体表现足以对标DLSS4。但是FSR4是绑定RDNA4架构的,此前AMD在发布FSRSDK2.0之时意外发布了FSR的库文件,让大家以为会下放给RDNA3架构的RX7000系列显卡。后面AMD又澄清这些意外泄露是个错误,意味着FSR4又跟旧卡无缘了。不过根据知名爆料人MLID的最新消息,AMD正在积极推进将FSR4适配至RDNA3及RDNA3.5架构的多个平台,涵盖RX7000系列显卡、ROGAlly掌机、Strix
此前我们曾报道,微软在8月推送的Windows11更新KB5063878引发了一些用户的设备问题。部分Windows11用户反映,在进行大文件传输期间,其固态硬盘(SSD)会“无故消失”,即便重启电脑也无法识别,导致重要数据可能丢失。针对这一情况,微软近期作出回应表示,经过深入调查,并未发现2025年8月发布的Windows11安全更新与用户报告的SSD或机械硬盘(HDD)故障及数据损坏之间存在直接关联。“每次发布更新后,我们都会持续监控用户反馈和系统表现,以确保稳定性。”官方声明中提到。据部分用户
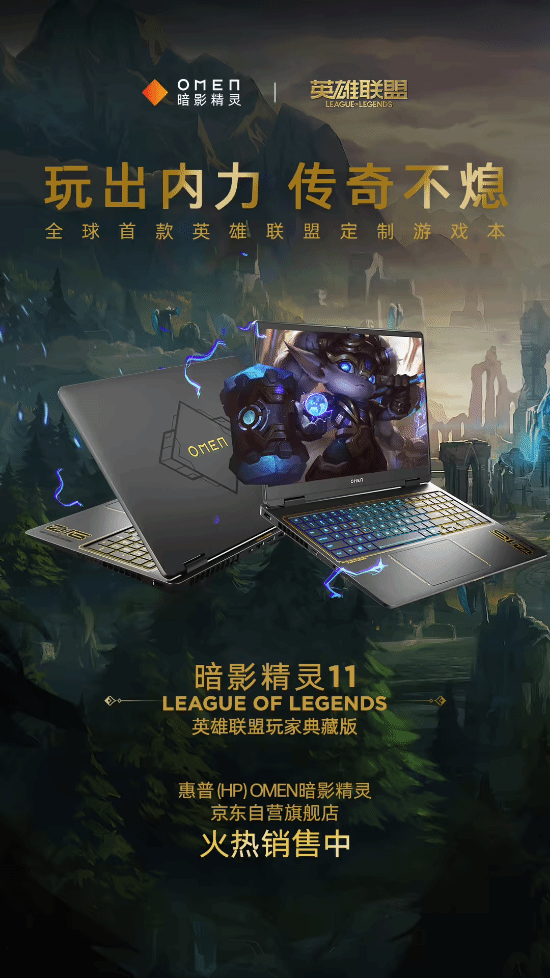
IT之家10月31日消息,作为拳头电竞的官方合作品牌,惠普正式推出暗影精灵11英雄联盟玩家专属典藏版,该版本已于今晚开启发售。京东平台上线了两款配置:搭载酷睿i7-14650HX处理器、RTX5060显卡、32GB内存以及1TB固态硬盘的版本,售价为8999元;另一款则配备酷睿i7-14650HX、RTX5070显卡、32GB内存和1TBSSD,定价9999元。据悉,这款定制游戏本以深邃黑为主色调,机身多处融入海克斯科技风格的金色装饰线条,极具辨识度。前端及左
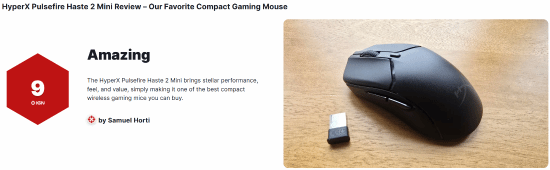
HyperXPulsefireHaste2Mini获得了IGN9分的高分评价,被赞誉为当前最出色的紧凑型无线游戏鼠标之一。这款鼠标凭借卓越的性能、舒适的手感以及极高的性价比,赢得了评测团队的高度认可。在综合表现方面,HyperXPulsefireHaste2Mini成为了评测编辑心目中的新宠小型游戏鼠标。其精心打磨的外形设计、扎实的做工品质以及灵敏精准的游戏响应能力,均使其在同类产品中脱颖而出。尽管配套软件功能较为基础,且DPI切换按钮手感偏硬,但这些小瑕疵并未影响整体出色的
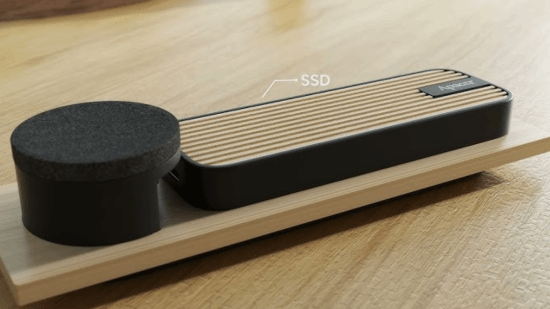
宇瞻(Apacer)最新发布了一款别具一格的移动固态硬盘——AS712,开创性地将高效能存储与香氛体验融合,成为全球首款内置精油扩香功能的便携式SSD。这款AS712在设计上充分体现了可持续理念,机身以天然竹材与铝合金精心打造,不仅触感温润,更赋予每一块产品独特的木纹与色泽,真正做到独一无二。其专属底座则融合了铝合金、回收塑料、天然竹材以及水库清淤出的环保材料,进一步强化绿色属性。使用时,用户仅需在SSD表面的竹材区域或配套的扩香石上滴入1至2滴喜爱的精油,即可在工作或休闲中沉浸于宜人香气之中。性能方面,





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



