

如何在Java中实现分布式缓存的高可用和数据一致性
如何在Java中实现分布式缓存的高可用和数据一致性在分布式系统中,缓存是提高性能和减少数据库压力的常用手段之一。然而,单点故障和数据一致性问题是使用分布式缓存时需要解决的两个主要挑战。本文将介绍如何在Java中实现分布式缓存的高可用和数据一致性,并提供具体的代码示例。一、高可用的实现使用一致性哈希算法在分布式缓存系统中,使用一致性哈希算法可以使数据在多个节点
如何在Java中实现分布式缓存的高可用和数据一致性
在分布式系统中,缓存是提高性能和减少数据库压力的常用手段之一。然而,单点故障和数据一致性问题是使用分布式缓存时需要解决的两个主要挑战。本文将介绍如何在Java中实现分布式缓存的高可用和数据一致性,并提供具体的代码示例。
一、高可用的实现
- 使用一致性哈希算法
在分布式缓存系统中,使用一致性哈希算法可以使数据在多个节点上均匀分布,从而提高系统的可用性。一致性哈希算法的基本原理是将节点和数据都映射到一个环上,当需要缓存或获取数据时,根据数据的哈希值在环上找到对应的节点。
以下是一致性哈希算法的Java实现示例:
public class ConsistentHashing {
    private final TreeMap nodes = new TreeMap<>();
    private final int replicaNum; // 虚拟节点的数量
    private final HashFunction hashFunction; // 哈希函数

    public ConsistentHashing(HashFunction hashFunction, int replicaNum, Collection nodes) {
        this.hashFunction = hashFunction;
        this.replicaNum = replicaNum;

        // 添加实际的节点
        for (String node : nodes) {
            addNode(node);
        }
    }

    public void addNode(String node) {
        // 添加虚拟节点
        for (int i = 0; i < replicaNum; i++) {
            long hash = hashFunction.hash(node + i);
            nodes.put(hash, node);
        }
    }

    public void removeNode(String node) {
        // 移除虚拟节点
        for (int i = 0; i < replicaNum; i++) {
            long hash = hashFunction.hash(node + i);
            nodes.remove(hash);
        }
    }

    public String getNode(String key) {
        if (nodes.isEmpty()) {
            return null;
        }
        // 计算数据的哈希值
        long hash = hashFunction.hash(key);
        // 在环上找到第一个大于等于该哈希值的节点
        Map.Entry entry = nodes.ceilingEntry(hash);
        // 如果不存在,则返回环上第一个节点
        if (entry == null) {
            entry = nodes.firstEntry();
        }
        return entry.getValue();
    }
}

public interface HashFunction {
    long hash(String key);
} - 使用心跳机制
为了实现缓存系统的高可用性,可以使用心跳机制监测缓存节点的状态。每个节点以一定的时间间隔发送心跳信号给其他节点,如果某个节点一段时间内没有接收到心跳信号,就认为该节点宕机,可以将其从缓存节点列表中移除。
以下是使用心跳机制实现高可用的Java代码示例:
public class Heartbeat {
    private final List nodes; // 缓存节点列表
    private final long interval; // 心跳间隔

    public Heartbeat(List nodes, long interval) {
        this.nodes = nodes;
        this.interval = interval;
    }

    public void startHeartbeat() {
        ScheduledExecutorService executor = Executors.newSingleThreadScheduledExecutor();
        executor.scheduleAtFixedRate(() -> {
            for (String node : nodes) {
                // 发送心跳信号
                boolean result = sendHeartbeat(node);
                if (!result) {
                    // 节点宕机,从节点列表中移除
                    removeNode(node);
                }
            }
        }, 0, interval, TimeUnit.MILLISECONDS);
    }

    private boolean sendHeartbeat(String node) {
        // 发送心跳信号的具体逻辑
        // 返回是否成功接收到心跳信号
        return true;
    }

    private void removeNode(String node) {
        // 从节点列表中移除宕机的节点
    }
}
以上代码示例演示了如何使用一致性哈希算法和心跳机制实现分布式缓存的高可用性。
二、数据一致性的实现
- 使用缓存更新策略
在分布式缓存系统中,缓存更新策略是实现数据一致性的一种重要方法。在写入数据时,可以通过同时更新缓存和数据库来确保数据的一致性。
以下是使用缓存更新策略实现数据一致性的Java示例代码:
public class Cache {
    public void put(String key, Object value) {
        // 写入缓存
        // 更新数据库
    }

    public Object get(String key) {
        Object value = null;
        // 从缓存读取数据
        if (value == null) {
            // 从数据库读取数据
            // 写入缓存
        }
        return value;
    }

    public void delete(String key) {
        // 从缓存删除数据
        // 更新数据库
    }
}- 使用版本控制机制
另一种实现数据一致性的方法是使用版本控制机制。每次更新数据时,都将版本号加一,并将版本号和数据一起存储到缓存中。读取数据时,比较缓存中的版本号和数据库中的版本号,如果不一致,则重新从数据库中读取数据。
以下是使用版本控制机制实现数据一致性的Java示例代码:
public class Cache {
    private final Map data = new HashMap<>();

    public void put(String key, Object value) {
        VersionedValue versionedValue = data.get(key);
        if (versionedValue == null) {
            versionedValue = new VersionedValue(1, value);
        } else {
            versionedValue.setValue(value);
            versionedValue.incrementVersion();
        }
        data.put(key, versionedValue);
        // 更新数据库
    }

    public Object get(String key) {
        VersionedValue versionedValue = data.get(key);
        if (versionedValue == null) {
            // 从数据库读取数据
            // 更新缓存
        } else {
            // 比较版本号
            // 从缓存读取数据
        }
        return versionedValue.getValue();
    }

    public void delete(String key) {
        data.remove(key);
        // 更新数据库
    }
}

public class VersionedValue {
    private int version;
    private Object value;

    public VersionedValue(int version, Object value) {
        this.version = version;
        this.value = value;
    }

    public int getVersion() {
        return version;
    }

    public void incrementVersion() {
        this.version++;
    }

    public Object getValue() {
        return value;
    }

    public void setValue(Object value) {
        this.value = value;
    }
}
以上代码示例演示了如何使用缓存更新策略和版本控制机制实现分布式缓存的数据一致性。
综上所述,实现分布式缓存的高可用性和数据一致性是比较复杂的,需要综合使用一致性哈希算法、心跳机制、缓存更新策略和版本控制机制等技术。通过合理的设计和实现,可以提高分布式缓存系统的性能和可靠性。
这篇文章我们继续聊分布式相关的内容。提到分布式系统,就一定绕不开“一致性”,这次我们说说:最终一致性。最终一致性是现在大部分高可用的分布式系统的核心思路。估计有人对最终一致性不太熟,先来个简单介绍:最终一致性指的是系统中的所有分散在不同节点的数据,经过一定时间后,最终能够达到符合业务定义的一致的状态
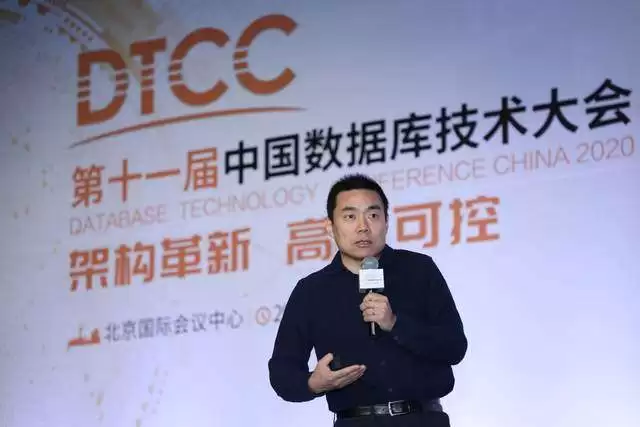
云计算时代,云原生分布式数据库和数据仓库开始崛起,提供弹性扩展、高可用、分布式等特性。数据库将面临怎样的变革?云原生数据库与数据仓库有哪些独特优势?在日前的DTCC 2020大会上,阿里巴巴集团副总裁、阿里云数据库产品事业部总裁、ACM杰出科学家李飞飞就《云原生分布式数据库与数据仓库系统点亮数据上云
FastCFS 是一款基于块存储的通用分布式文件系统,可以作为MySQL、PostgresSQL、Oracle等数据库和云平台的后端存储。 FastDFS已经很受欢迎了,为何还要研发FastCFS呢?FastDFS是轻量级的对象存储,只能通过专有API访问,专为互联网应用设计,适合存放图片、视频、文
随着微服务架构的流行,客户端发起的一次请求可能需要涉及到多个或 N 个服务,致使我们对服务之间的监控和排查变得更加复杂。举个例子:某条业务线的某个接口调用服务端时快时慢,这时就需要排查各个服务的日志进行分析,调动各个服务的开发人员联动排查,这种排查费时又费力。对于 ToB 的业务有时候还拿不到日志,
SpringCloud ConfigSpringCloud整合了微服务中的整体解决方案:分布式配置中心,分布式锁,分布式任务调度平台,分布式事务,分布式日志收集产生背景:在微服务场景下,若继续采用传统方式管理配置文件,配置文件管理器将变得极为复杂。而且在生产环境中,一旦配置文件发生改变,就需要重新配

1 前言 在现在工作中,为保障服务的高可用,应对单点故障、负载量过大等单机部署带来的问题,生产环境常用多机部署。为解决多机房部署导致的数据不一致问题,我们常会选择用分布式锁。目前其他比较常见的实现方案我列举在下面:基于缓存实现分布式锁(本文主要使用redis实现)基于数据库实现分布式锁基于zooke

简介 Hadoop作为被广泛运用的大数据框架,依靠Hadoop分布式文件系统(HDFS)来存储和管理海量数据。但有时会出现HDFS权限问题,影响数据的访问和处理。本教程将带你了解识别和解决HDFS权限问题的流程,助你维护一个强健且安全的Hadoop生态系统。 HDFS 权限概述 HDFS(Hadoo

ionet25.3版本发布,基于Aeron构建,实现纳秒级延迟与真零拷贝,无需第三方中间件即可搭建分布式服务器。框架轻量级,15MB启动,支持游戏、物联网、高频交易等场景。采用对外服与逻辑服架构,动态扩缩,类MVC编码,自动生成多前端交互代码。

命名空间的基本概念与常见引入问题在C++等编程语言中,命名空间(namespace)是一种将代码标识符(如变量、函数、类名)封装在特定名称下的机制,其主要目的是避免命名冲突,尤其是在大型项目或使用多个第三方库时。使用“using namespace”指令可以将指定命名空间中的所有名称引入当前作用域,

理解递归的基本原理在C语言中,递归是一种函数调用自身的编程技术。要掌握它,首先需要理解其核心思想:将一个复杂的大问题,分解为一个或几个与原问题相似但规模更小的子问题,直到子问题足够简单,可以直接求解。这个过程通常包含两个关键部分:递归出口和递归体。递归出口定义了问题何时不再继续分解,即最简单、可直接






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
