【AdvisKV】#01: 关于我从零写一个 C++ 分布式 KV 存储系统原型
日期: 2026.7.6 写在开头的开头 AdvisKV 是我用 C++17 从零写的一个分布式 KV 存储系统原型,包含 Meta、SDM、Storage、SDK 四个主要模块,覆盖建库建表、路由查询、KV 读写、副本数扩缩容、坏副本替换、Raft、WAL/snapshot 恢复,跑了gtest
日期: 2026.7.6
写在开头的开头
AdvisKV 是我用 C++17 从零写的一个分布式 KV 存储系统原型,包含 Meta、SDM、Storage、SDK 四个主要模块,覆盖建库建表、路由查询、KV 读写、副本数扩缩容、坏副本替换、Raft、WAL/snapshot 恢复,跑了gtest + E2E 测试和 benchmark。(但是控制面高可用、自动 rebalance、接入rocksdb这些还没实现)
写在开头
算算日子,又是大半年没更新博客了。上次动笔还是 OB 复赛结束后,写的一篇凄凄惨惨的总结文,一晃半年就这么过去了。简单交代下背景吧。比赛结束后,开始准备找实习。本来以为会很难,结果面了五六家,从字节基架到 OB 数据库内核,再到一些游戏引擎、自动驾驶的小厂,主要为了刷刷经验值。最初想投字节给 OB 的面试攒点底气,没想到字节效率高得离谱,没几天就发了 offer。最后纠结了一下,害怕一头扎进数据库内核把路走窄了,想了想,还是去基础架构试试。
实习差不多一个月,发现自己能学到的东西有限,实际代码开发少得可怜,每天基本就是排查问题、改点简单的代码、跑跑性能测试。心里开始犯嘀咕:照这个节奏下去,到秋招怕不是要废了。组内核心项目又不可能让我上手写代码,总得自己找点事干。巧的是,组里的项目恰好是分布式 KV,于是就想:不如把这套逻辑搞明白,自己从头写一个分布式 KV 出来。至少以后面试被问到实习做了什么,还能理直气壮地说自己私下撸了个分布式 KV,也不算白来一趟。
有点尴尬的是,自己设定的场景和组内项目差异太大,加上 V1 版本功能上没法实现得很全面,最后魔改一通,除了模块名字,几乎和组内的项目没什么关系了。
以上就是写出 AdvisKV 的初衷。说白了,多少也抱着想做出一个自己代表作的心态。毕竟之前写的那些 rmdb、miniob、seekdb 的代码,严格来说都不算是我自己的项目。
开始写这篇文档的时候,项目已经基本上完成得差不多了——至少 benchmark 能完整跑通(笑)。当时想着架构应该不会再大改了,顶多后期优化下性能,删掉那些乱七八糟的注释,可以动笔了。当然,后来的事实证明我又重构了很多次。
AdvisKV 是什么
简单说,AdvisKV 是我用 C++17 写的一个分布式 KV 存储系统原型,一个学习向的系统原型。说白了,就是给自己的秋招简历加点料。同时也希望完成第一个从头干到尾的项目。期望别太高,定位就是一个学习原型。
如果概括这个项目的主线,大概是:Meta/SDM 作为控制面维护表、副本和路由的期望状态,Storage 作为数据面负责 KV 读写和 Raft 复制,控制面和数据面通过心跳和 reconciler 不断把系统状态收敛到预期。
整个项目分成四个模块:
Meta负责 DB、Table 这些元数据和 DDL。SDM负责 Storage 节点注册、心跳、ReplicaGroup 编排、期望副本下发和 Route 维护。Storage负责 KV 数据读写、Raft 和本地持久化。SDK对外提供基于db + table + key的 put/get/delete 接口。
目前可以跑通建库建表、路由查询、KV 读写、副本数调整、自动替换坏副本、Raft、WAL、snapshot、recover 等功能。有两百多个 gtest 单测,一批 E2E 测试(比如最基础的端到端 KV 链路、leader 崩溃后切主、follower 追日志和追 snapshot、Meta/SDM 重启恢复等),还有 benchmark 和 metrics。
详细的实现数据和 benchmark 就不在这里展开了。关于这个项目,我更想写的是自己做下来的感受——也一直都是这个风格,所以就不搞太官方的味道了。
Show
这个分布式 KV 的数据模型和正常的数据库差不多,有 db、table 的概念。
用户可以创建自己的 DB,然后在 DB 里面创建 table。每个 table 在创建时可以指定 shard 数和 replica 数。一个 table 会被拆成多个 shard,每个 shard 又会有多个 replica。需要说明一下,V1 版本里 shard 数是在创建 table 时确定的,后续暂时不能动态修改;replica 数现在可以通过 alter_table 调整,也支持缩到 0 再扩回来。也就是说,目前不是完全没有扩缩容,只是支持了副本数这条链路,自动 rebalance 和 shard 数变更还没做——以后大概率也不会做了,这个项目应该到此为止了。
# 项目里提供了一个交互式 CLI adviskvctl,方便演示
# 建库建表
adviskv> create_db demo_db dc1
OK db_id=1
# create_table
adviskv> create_table demo_db demo_table 4 3 default
OK table_id=1
# wait_table [timeout_ms]
adviskv> wait_table demo_db demo_table
OK table_state=NORMAL
# put
adviskv> put demo_db demo_table hello world
OK
# get
adviskv> get demo_db demo_table hello
OK value="world"
adviskv> delete demo_db demo_table hello
OK
# route
adviskv> route demo_db demo_table hello
Route
table: demo_db.demo_table
key: hello
shard: table_id=1 shard_id=2
replicas:
- replica_id=1:2:0 endpoint=127.0.0.1:50051 role=LEADER
- replica_id=1:2:1 endpoint=127.0.0.1:50052 role=FOLLOWER
- replica_id=1:2:2 endpoint=127.0.0.1:50053 role=FOLLOWER
# key hello 会先定位到 table 某个 shard,然后 SDK 再通过 SDM 查询该 shard 对应的 route,通过 endpoint 把请求发送到对应的 leader 的 Storage 节点
# 副本的扩缩容
# alter_table
adviskv> alter_table demo_db demo_table 2
OK table_id=1 replica_count=2
目前支持的操作是最基本的同步 put、get、delete。这些操作交给 SDK 模块处理。可以创建一个 KVClient 进行 put、get 等操作。顺带一提,CLI 里面命令可以写 delete,SDK 里对应的方法名叫 del。
SDK 的使用方式:
#include
#include "sdk/client.h"
int main() {
adviskv::sdk::KVClientConf conf;
conf.db_name = "demo_db";
conf.table_name = "demo_table";
conf.sdm_host = "127.0.0.1";
conf.sdm_port = 50049;
conf.sdm_timeout_ms = 3000;
conf.storage_timeout_ms = 3000;
adviskv::sdk::KVClient client(conf);
adviskv::Status put_status = client.put("hello", "world");
if (put_status.fail()) {
std::cerr << put_status.to_string() << std::endl;
return 1;
}
adviskv::Value value;
adviskv::Status get_status = client.get("hello", &value);
if (get_status.ok()) {
std::cout << value << std::endl; // value:"world"
}
return 0;
}
Minimal Overview
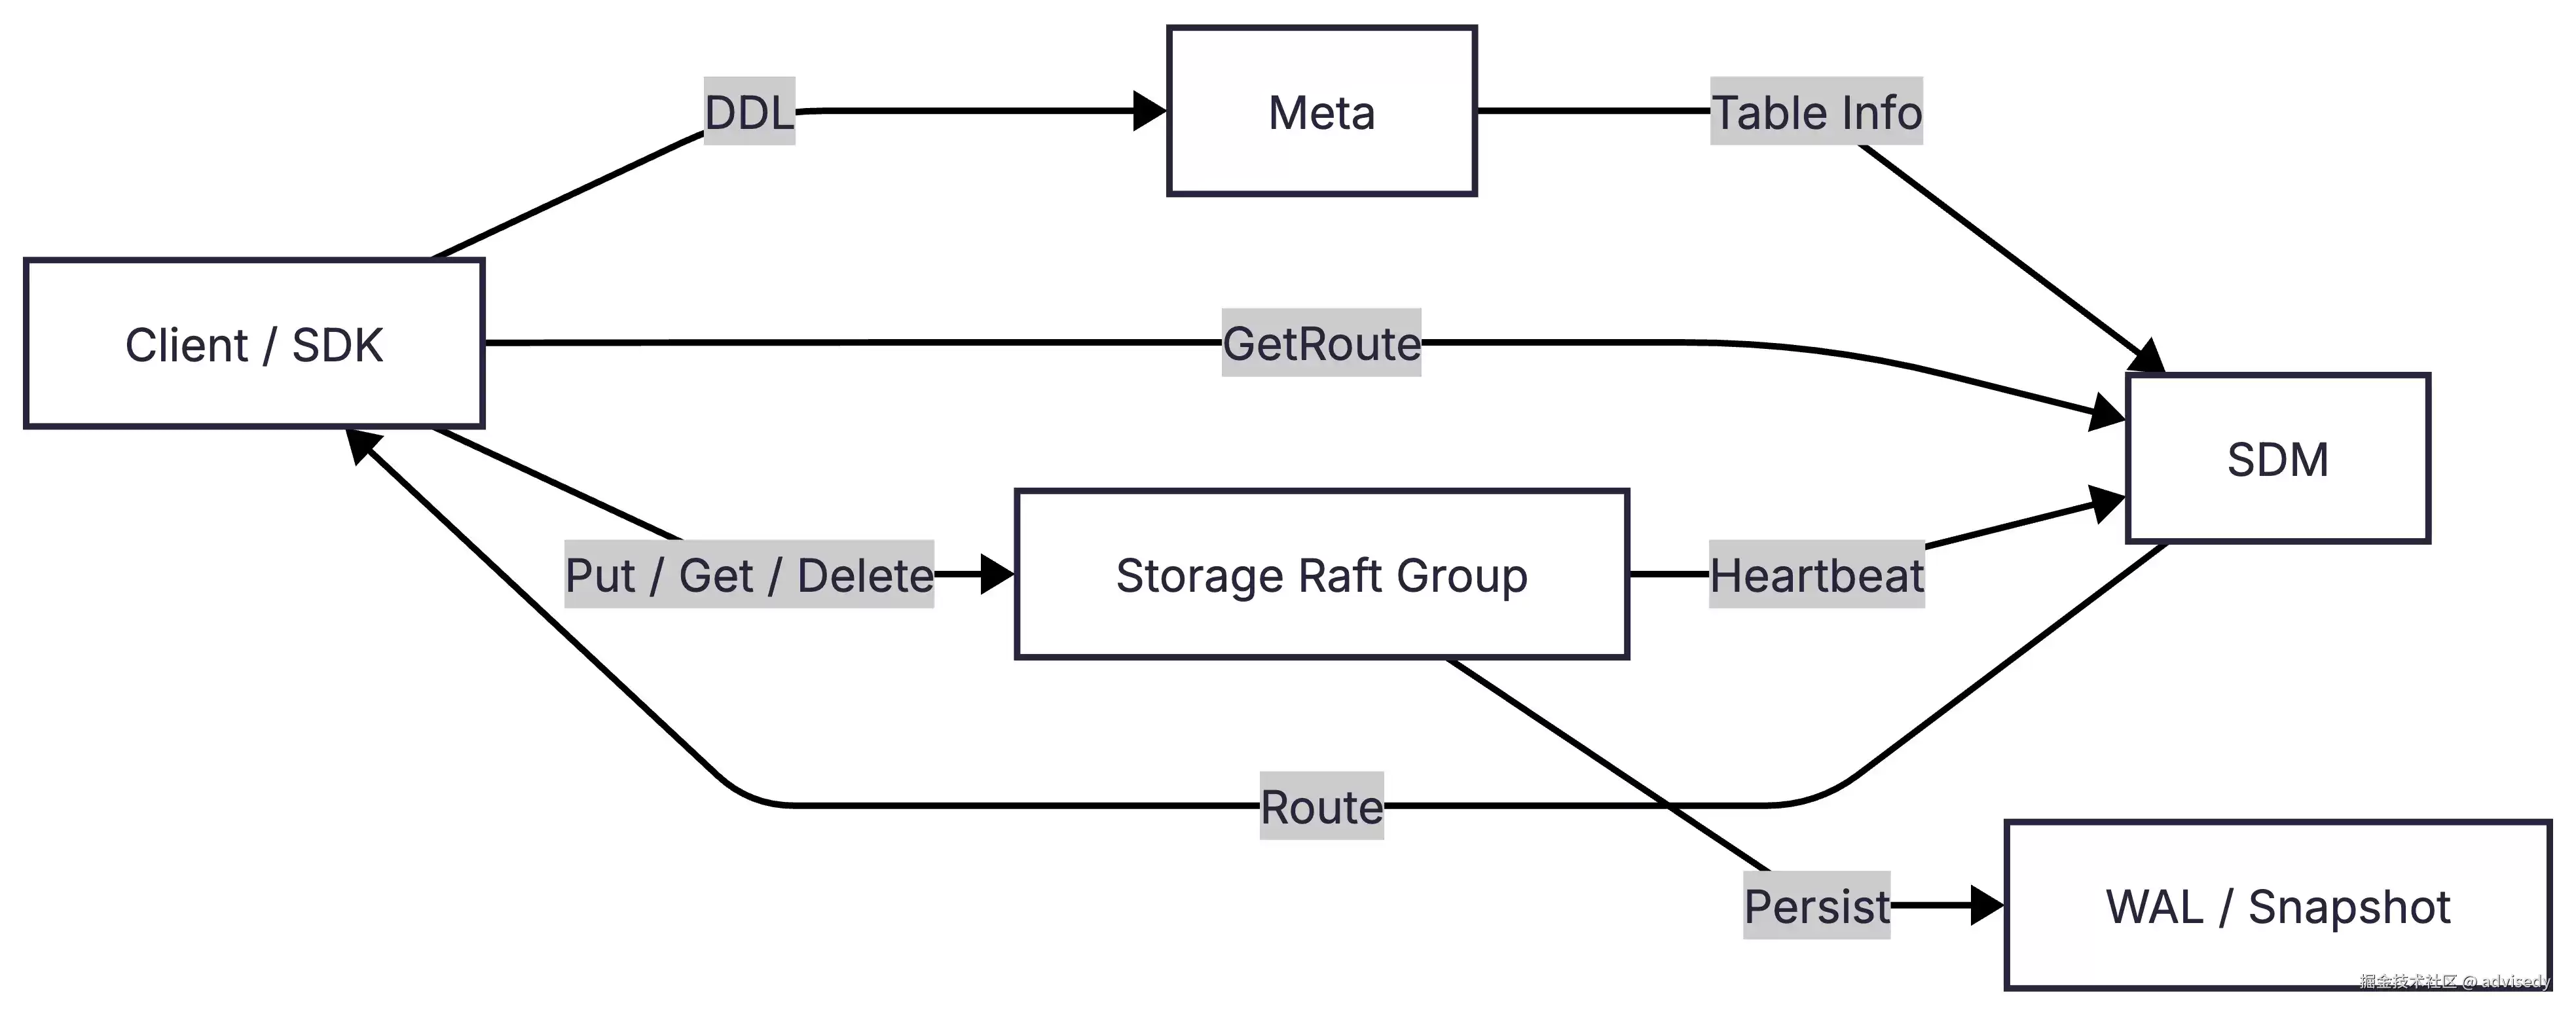
整体架构的粗略介绍
项目分为四个模块:meta、sdm、storage、sdk。
SDK
先聊聊最外层的 SDK。SDK 本身并不算分布式 KV 的服务端模块,就是一个客户端库,给使用者执行 put、get 这类操作。
拿 put 操作来说,在当前版本里,SDK 会先向 SDM 查询 route,也就是路由表。这个 route 包含当前 db/table 对应的 shard 信息,以及每个 shard 下面的 replica 节点信息。SDK 根据 key 算出它落在哪个 shard 上,然后从这个 shard 的 replica 列表中找到 leader 节点,直接给这个节点发送 put 操作。删除操作也是这个流程。V1 版本里,get 操作也只有 leader 才能执行,后续版本可能会优化这块。
Meta
Minimal architecture diagram:
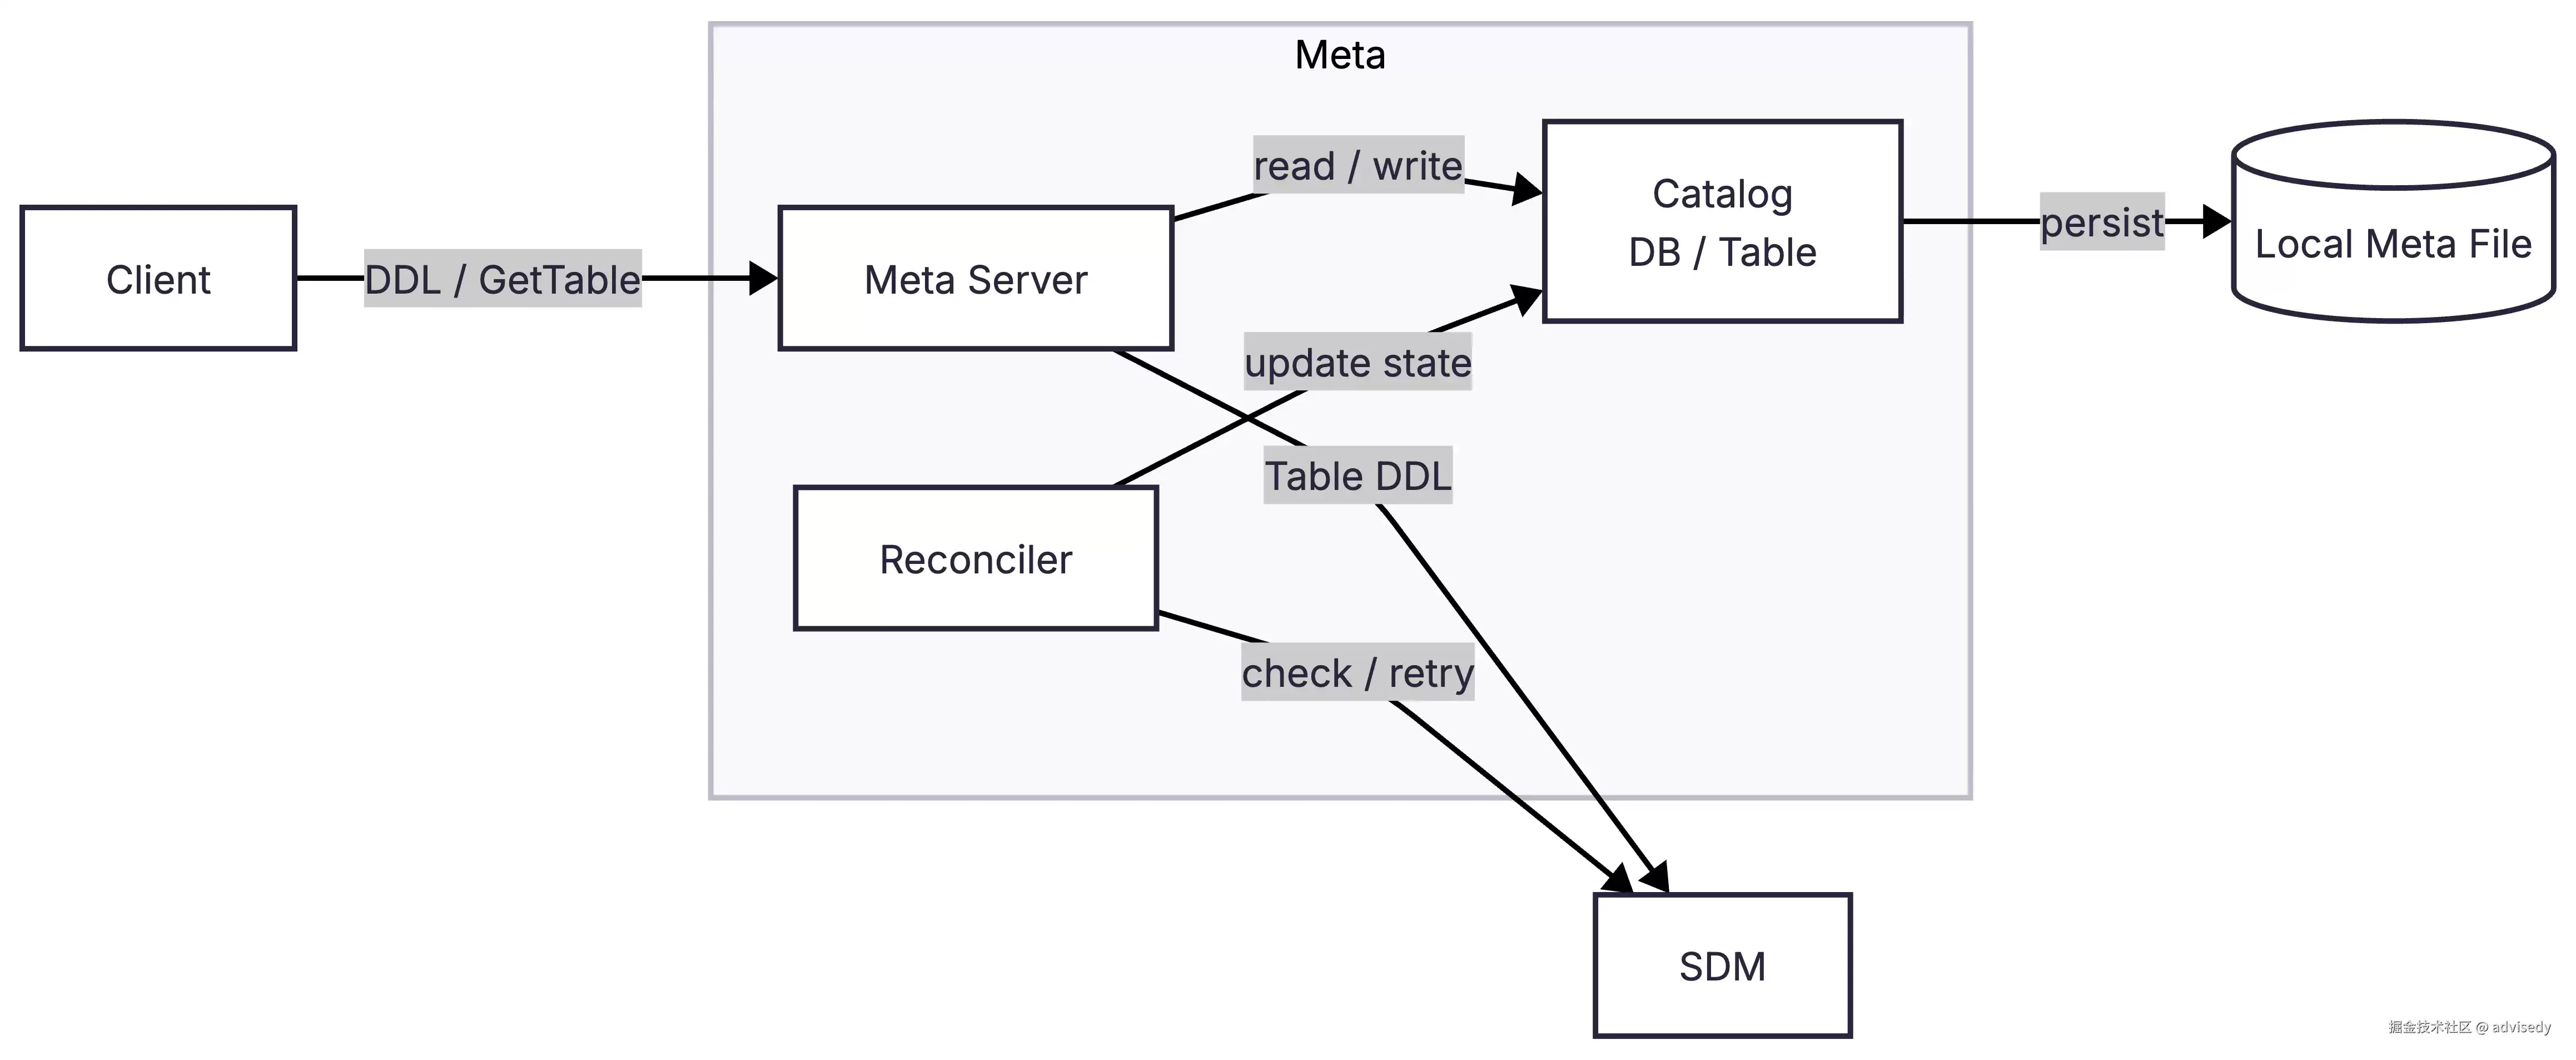
Meta 模块负责 DDL 和 DB/Table 这些元信息。
创建 table 时,请求先打到 Meta。Meta 收到 CreateTable 之后,先在自己的 catalog 里记录这个 table,并把状态标记成“创建中”。然后 Meta 向 SDM 发送 PlaceTable 请求,让 SDM 负责后续的 replica 放置和 route 生成。
注意一点:CreateTable 返回成功并不代表 table 立刻就可以读写。这个接口本身是异步的,返回 OK 只代表 Meta 接受了这个 DDL,不保证 DDL 最终成功。table 是否真正 ready,取决于 Meta 和 SDM 里的后台 reconciler 能否把状态推进到最终状态。
后面加上了副本数调整功能,这里多了 AlterTableReplicaCount。用户发起 alter_table 时,Meta 先把 catalog 里的 replica_count 和状态改掉,然后通知 SDM 去把每个 shard 的目标副本数调到新值。这个过程也不是同步等所有 replica 调整完,最终还是靠后台 reconciler 推回来。
创建 DB 这类操作就不会发送给 SDM,因为 DB 是只有 Meta 才会知道的概念,SDM 不会在乎 DB,也不会持久化它。SDM 只关心 table,以及对应的 shard_count 和 replica_count 来进行编排。虽然 SDK 通过传递 db_name、table_name 和 hash(key) 找到路由表,但 db_name 实际上是附在 table 上的,所以不需要 SDM 知道 DB 的存在,它只需要了解 table 的内容就够了。
SDM
Minimal architecture diagram:
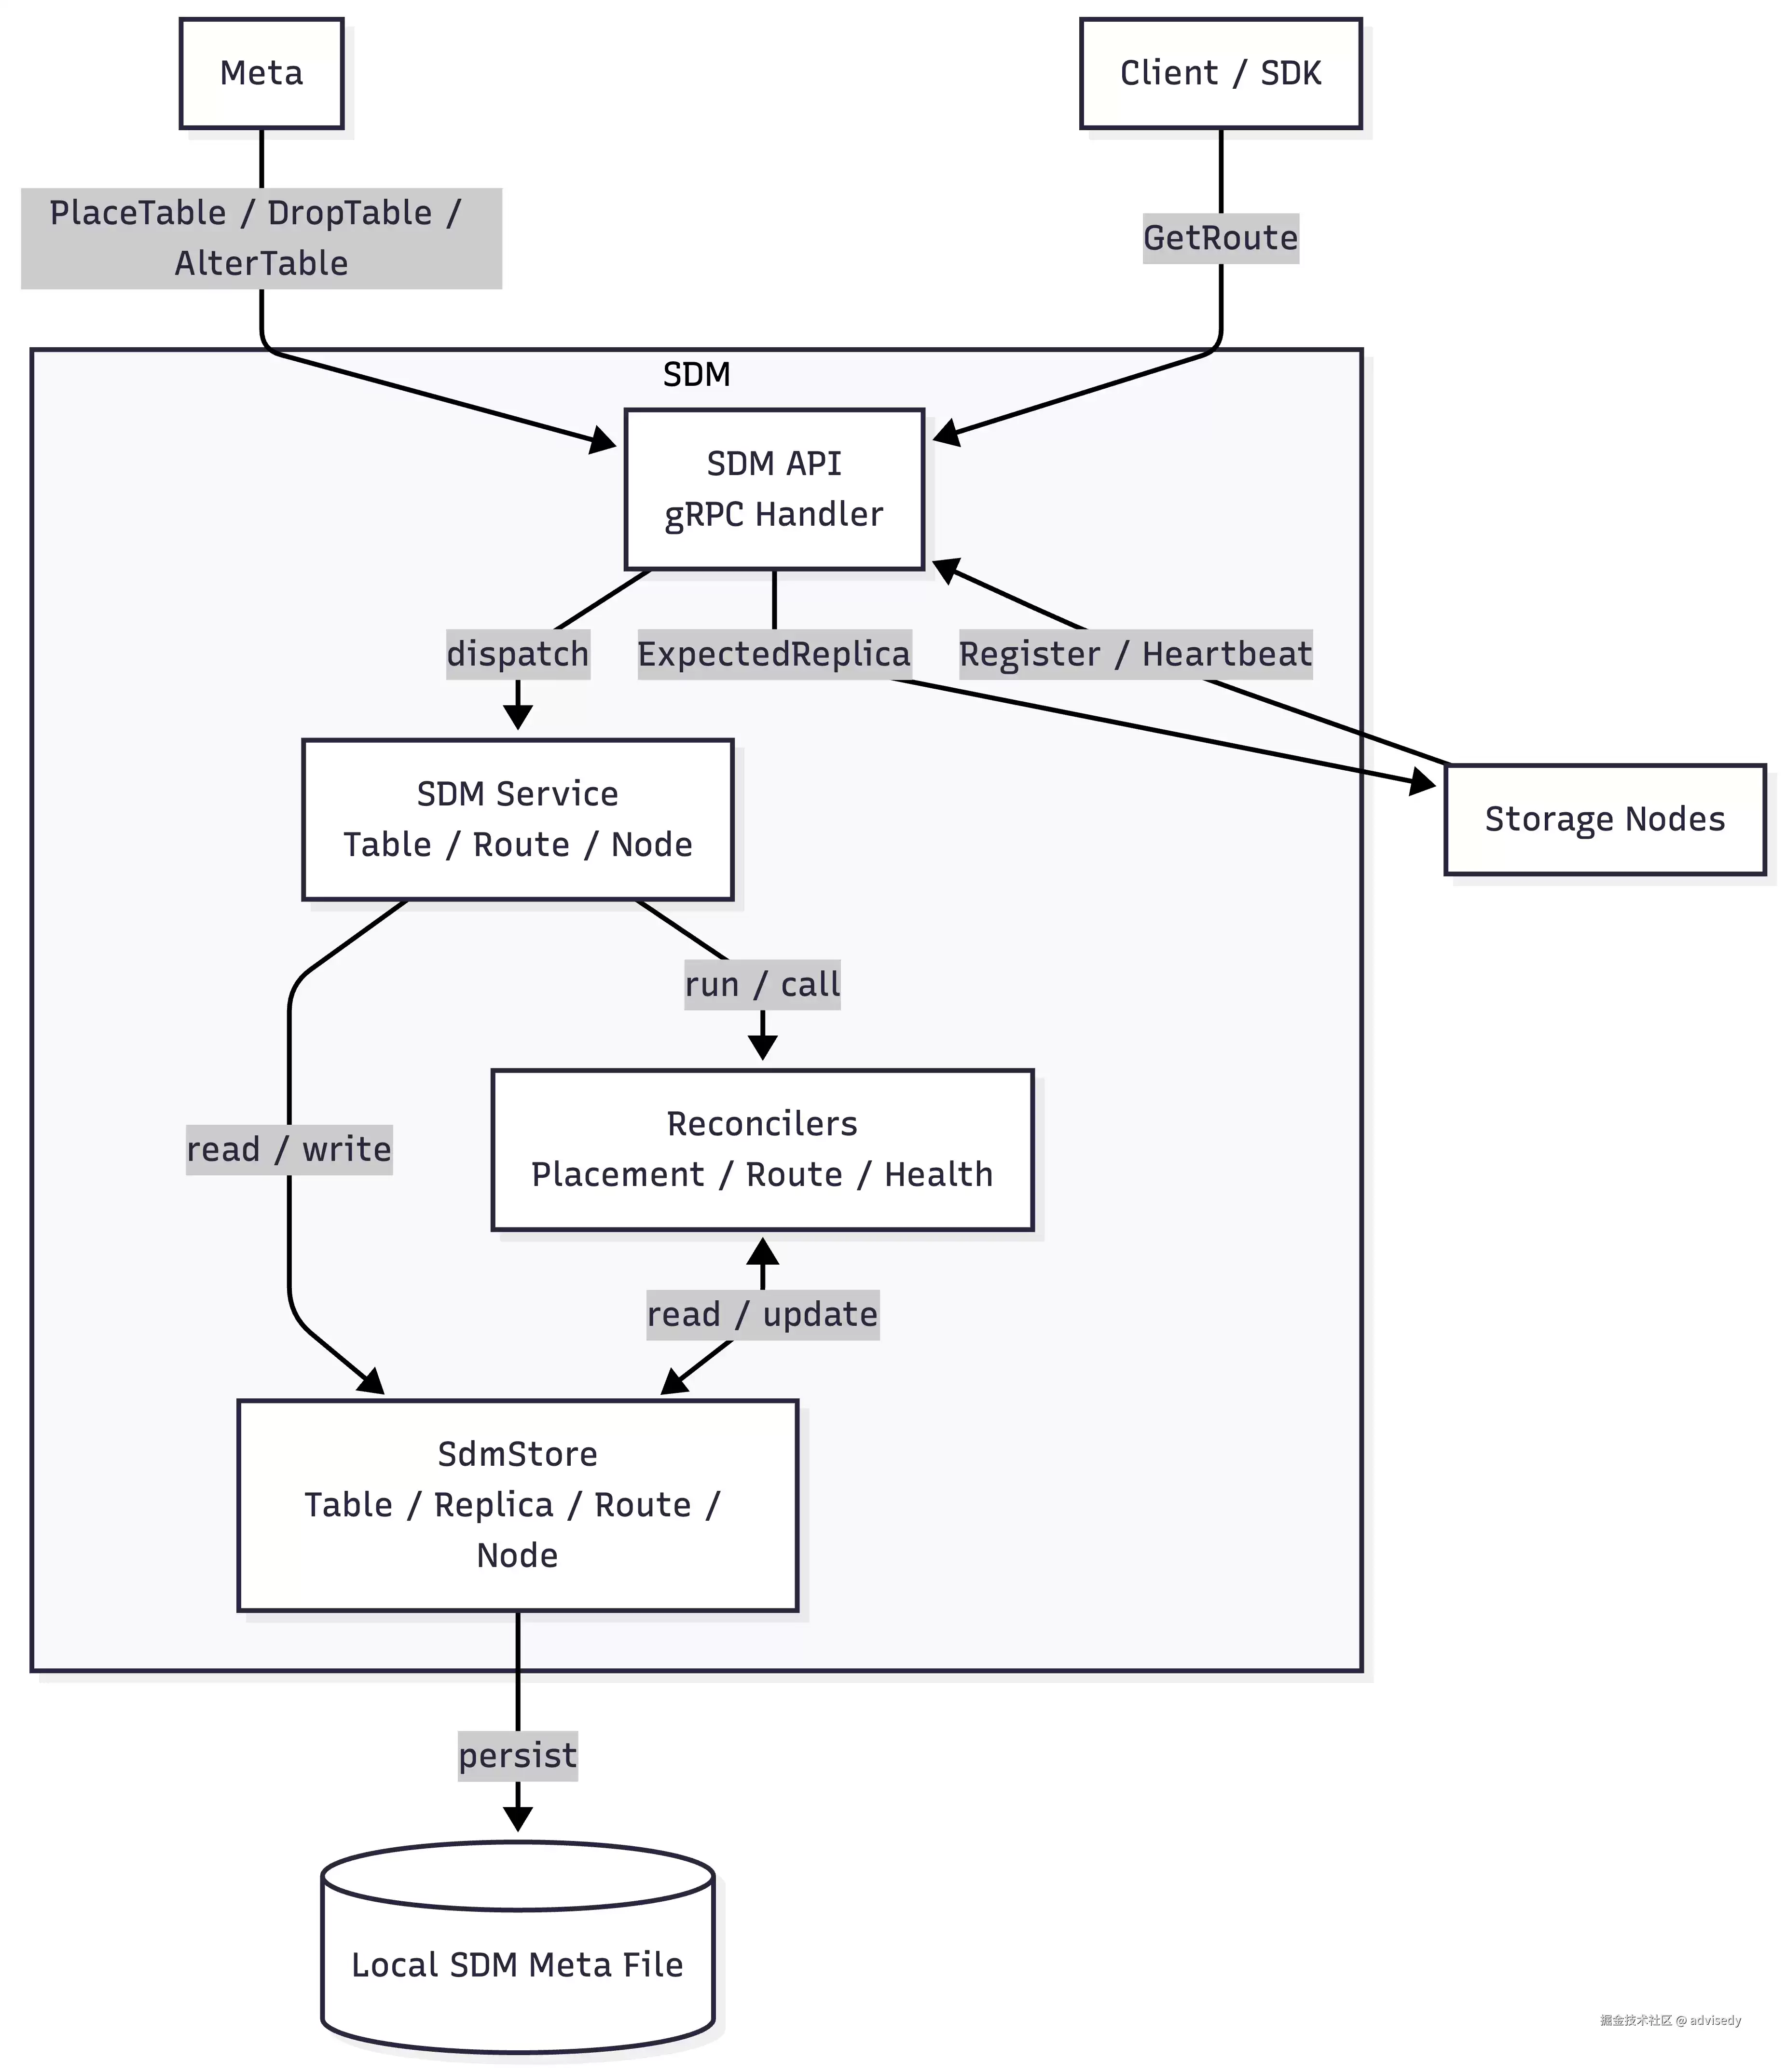
SDM 维护了一个非常重要的东西:route。route 以 shard 为单位,每个 shard 都有一个对应的 route。SDK 每次做 put/get/delete 时,先拿 db_name 和 table_name 去 SDM 查询路由表,然后根据 key 算出对应的 shard,再从 shard 的 replica 列表中找到 leader 节点,最后把真正的 KV 请求发给 storage。
另外,SDM 还负责 storage 节点的注册和心跳。Storage 启动后,向 SDM 注册自己,然后周期性发送 heartbeat。Heartbeat 不只是告诉 SDM 节点还没掉线,还会把本机 replica 的状态、raft role、成员信息(leader 会传)等发过去;SDM 也在 heartbeat response 里下发期望的 Replica,让 storage 的 NodeAgent 在本机创建、删除 replica,或者做成员变更。SDM 和 storage 这边用的是经典的“观测-期望”模式:SDM 维护期望状态,让 NodeAgent 去收敛。自动 rebalance 的话就没再做了——再搞也赶不上秋招了。
另外,SDM 需要提供 route,SDK 的链路是通过 db_name + table_name + key 向 SDM 查询路由表。所以 SDM 需要了解 table 的概念,也需要知道每个 table 下面有多少个 shard。Table 里面还有 ReplicaGroup 这一层,每个 shard 对应一个 group,用来维护这个 shard 希望有几个副本、哪些 replica 是当前还想保留的成员。Shard 作为逻辑数据,并没有在 SDM 里专门出现,而是通过 ReplicaGroup + Route 的方式在代码层面实现。
由于用了经典的“观测-期望”,后台任务目前主要靠几类后台 reconcile 去推动状态:TableReconciler 负责判断 table 是否 ready/deleting,ReplicaGroupReconciler 负责根据 target_replica_count 去补副本、删副本、替换坏副本,Route 负责在 replica ready 之后发布可用路由。说起来有点绕,但核心想法就是不断对齐“应该是什么样子”和“现在实际是什么样子”。后面讲到 SDM 的时候再细说。
Storage
Minimal architecture diagram:
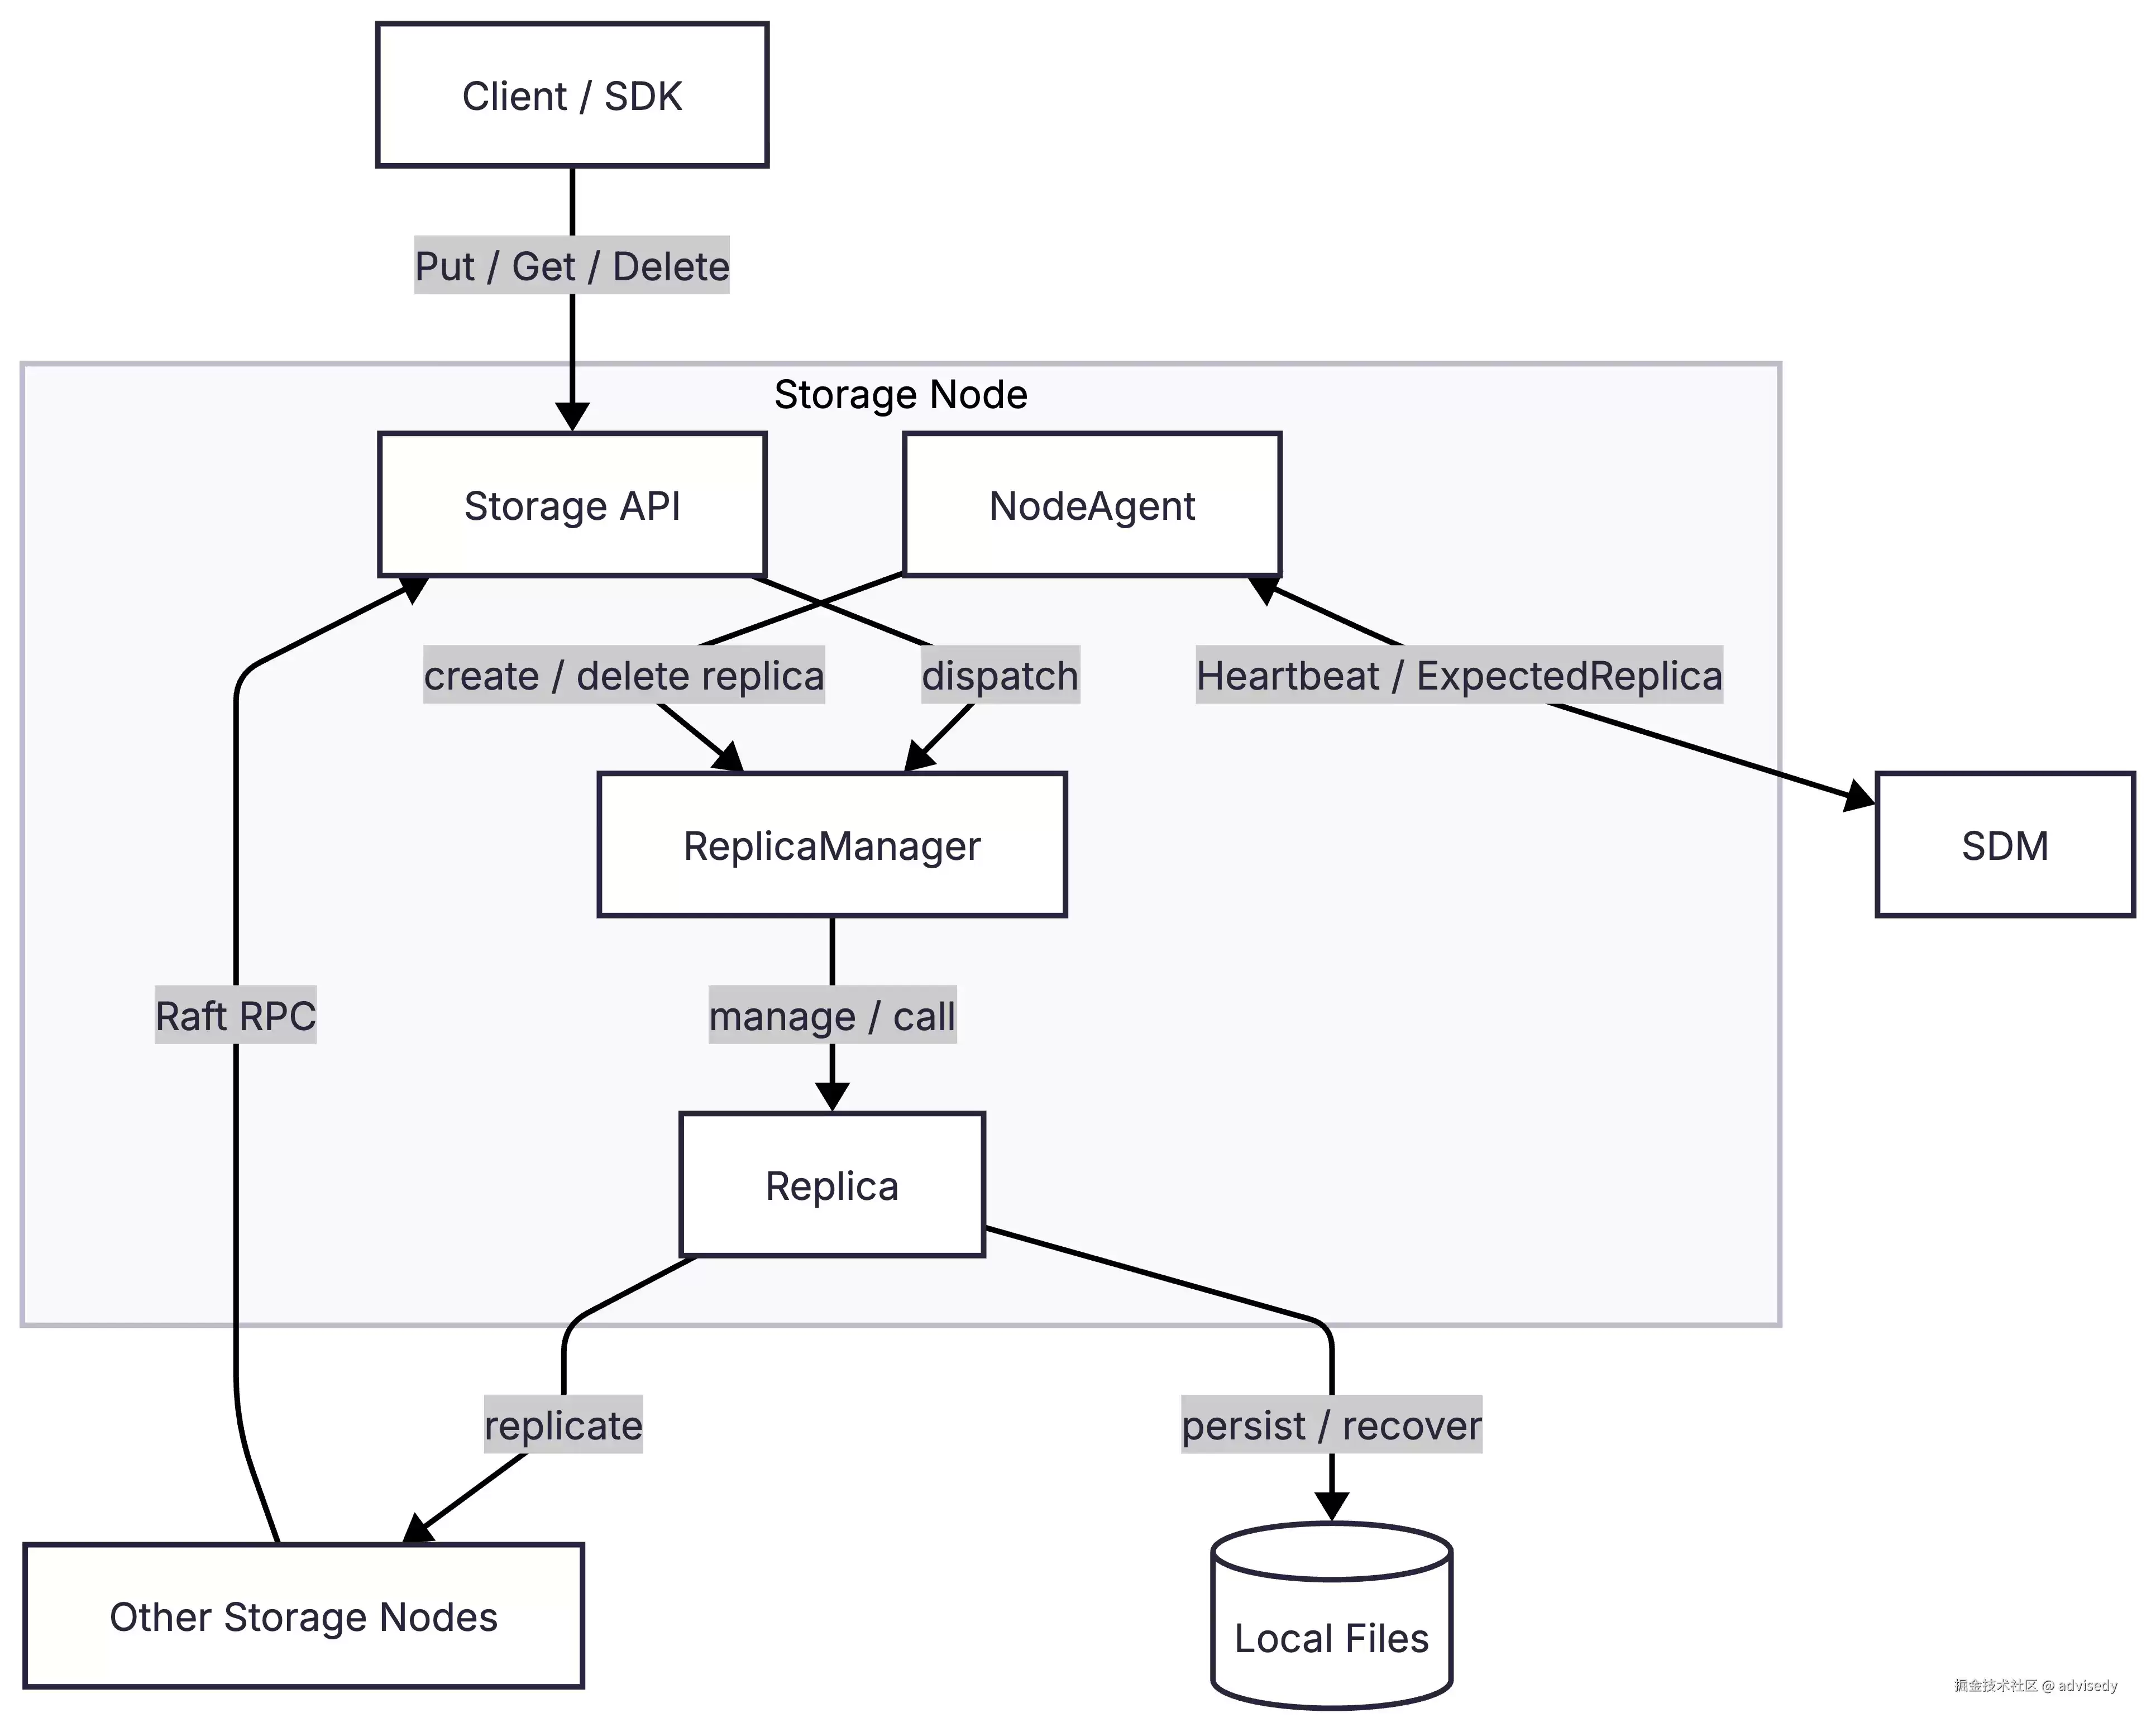
Storage 负责数据的读写。前面的 Meta 和 SDM 更偏控制面,一个管元信息,一个管路由和节点状态;Storage 这边是真正处理 put/get/delete 请求,以及维护数据副本的地方。
拿 put/delete 操作来说,SDK 直接把请求打到对应 shard 的 leader 所在的 storage 节点上。写请求打到 storage 后,进入 replica 内部,交给 Raft 做复制。首先本地写一条 Raft log,然后发送给其他 follower,等待这条 log 被多数派确认并提交之后,会 apply 到 KV engine。当前版本的 KV engine 还是简单的 map engine,主要是先把分布式链路跑通。后续有考虑接 rocksdb,不过还只是“maybe”。
get 操作目前也是 leader-only 的状态,最终读请求只会打到 leader 上。不过加了一个读一致性机制,读之前会确认自己仍然是合法 leader,并确保本地状态机至少 apply 到对应的 read index,避免读到旧 leader 或者还没 apply 完的状态。
此外,Storage 还做了 WAL 和 snapshot 相关的持久化逻辑。当前实现里,WAL 主要承载 Raft log,用来记录每个 replica 的写入日志;snapshot 则保存已经 apply 之后的 KV 状态。服务重启时,可以通过 snapshot 加上后续 WAL 恢复 replica 状态。
V1的局限
还有很多没完成的内容,包括:
- Meta 和 SDM 在 V1 版本里只跑单进程,没有高可用。
- Storage 侧的 KV engine 直接用了 map,还没接 rocksdb。
- Shard 不支持 split,也没有实现自动 rebalance。
- 目前只支持 leader 的 put 和 read,不支持 follower read。
写在最后
最早写完这篇博客是在 6 月 12 号,但后来又做了大规模的重构,并且加上了扩缩容功能——为了这个功能重构了好多东西,拖到现在已经一个月了。为什么非要支持扩缩容?当时想着把项目收尾,了解到了 tinykv 这个项目,发现它的完全体几乎是全方面吊打我的项目,悲痛欲绝之下,想着怎么也得再多实现一个功能吧,不然也太小丑了。(如果再给我一次机会,可能不会写这个项目了,直接去实现 tinykv 不香吗……)
总的来说,大体上把项目介绍了一下。这个项目完成得不算好,应该有很多设计不太合理的地方。毕竟没有系统学习过分布式,很多内容都是边看、边查、边问、边写出来的。很多设计甚至一开始并没有想清楚,经常写到一半发现不对,再慢慢修修补补出来。
如果有同学抱着学习分布式 KV 的目的来看这个项目,发现某些设计看起来很别扭,那大概率不是你理解错了,很可能就是这里还没设计好。后面的文章里,我也会尽量把这些地方讲清楚,包括哪些是当前版本的取舍,哪些是后续应该继续改进的地方。
这篇就作为 AdvisKV 文档系列的开坑文,暂且写到这里吧。to be continue。
本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
作者最新文章
漫蛙动漫APP最新版本下载
2026-10-13 13:46
漫蛙如何下载最新版本
2026-10-13 13:43
漫蛙漫画APP最新版本下载
2026-10-13 13:43
漫蛙漫画正版官网
2026-10-13 13:19
漫蛙漫画下载app最新版本
2026-10-13 13:17
上一篇:
如何在Linux上编译Java程序
下一篇:
数据结构的理论与工程实现之间的鸿沟
相关文章
更多
 图解分布式之:最终一致性,一致只会迟到,但绝不缺席
这篇文章我们继续聊分布式相关的内容。提到分布式系统,就一定绕不开“一致性”,这次我们说说:最终一致性。最终一致性是现在大部分高可用的分布式系统的核心思路。估计有人对最终一致性不太熟,先来个简单介绍:最终一致性指的是系统中的所有分散在不同节点的数据,经过一定时间后,最终能够达到符合业务定义的一致的状态
2026-08-20
4
DTCC2020|阿里云李飞飞:云原生分布式数据库与数据仓库系统点亮数据上云之路
云计算时代,云原生分布式数据库和数据仓库开始崛起,提供弹性扩展、高可用、分布式等特性。数据库将面临怎样的变革?云原生数据库与数据仓库有哪些独特优势?在日前的DTCC 2020大会上,阿里巴巴集团副总裁、阿里云数据库产品事业部总裁、ACM杰出科学家李飞飞就《云原生分布式数据库与数据仓库系统点亮数据上云
2026-08-20
3
可以跑数据库的分布式文件系统FastCFS
FastCFS 是一款基于块存储的通用分布式文件系统,可以作为MySQL、PostgresSQL、Oracle等数据库和云平台的后端存储。 FastDFS已经很受欢迎了,为何还要研发FastCFS呢?FastDFS是轻量级的对象存储,只能通过专有API访问,专为互联网应用设计,适合存放图片、视频、文
2026-08-20
3
分布式链路追踪Jaeger+微服务Pig在Rainbond上的实践分享
随着微服务架构的流行,客户端发起的一次请求可能需要涉及到多个或 N 个服务,致使我们对服务之间的监控和排查变得更加复杂。举个例子:某条业务线的某个接口调用服务端时快时慢,这时就需要排查各个服务的日志进行分析,调动各个服务的开发人员联动排查,这种排查费时又费力。对于 ToB 的业务有时候还拿不到日志,
2026-08-20
4
微服务架构Day21-SpringCloud之分布式配置中心
SpringCloud ConfigSpringCloud整合了微服务中的整体解决方案:分布式配置中心,分布式锁,分布式任务调度平台,分布式事务,分布式日志收集产生背景:在微服务场景下,若继续采用传统方式管理配置文件,配置文件管理器将变得极为复杂。而且在生产环境中,一旦配置文件发生改变,就需要重新配
2026-08-20
3
redis分布式锁,setnx+lua脚本的java实现|京东物流技术团队
1 前言 在现在工作中,为保障服务的高可用,应对单点故障、负载量过大等单机部署带来的问题,生产环境常用多机部署。为解决多机房部署导致的数据不一致问题,我们常会选择用分布式锁。目前其他比较常见的实现方案我列举在下面:基于缓存实现分布式锁(本文主要使用redis实现)基于数据库实现分布式锁基于zooke
2026-08-19
5
如何排查 Hadoop 分布式文件系统权限问题
简介 Hadoop作为被广泛运用的大数据框架,依靠Hadoop分布式文件系统(HDFS)来存储和管理海量数据。但有时会出现HDFS权限问题,影响数据的访问和处理。本教程将带你了解识别和解决HDFS权限问题的流程,助你维护一个强健且安全的Hadoop生态系统。 HDFS 权限概述 HDFS(Hadoo
2026-08-19
4
ionet 25.3 发布,纳秒级延迟的分布式 java netty 轻量级网络通信框架
ionet25.3版本发布,基于Aeron构建,实现纳秒级延迟与真零拷贝,无需第三方中间件即可搭建分布式服务器。框架轻量级,15MB启动,支持游戏、物联网、高频交易等场景。采用对外服与逻辑服架构,动态扩缩,类MVC编码,自动生成多前端交互代码。
2026-08-14
3
如何利用 Redis 的 Lua 脚本配合 Java 业务逻辑实现强一致性的分布式限流
Redis配合Lua脚本通过原子性执行实现分布式限流的强一致性,Java仅负责安全调用,不可参与状态判断。生产环境推荐EVALSHA并提前预热脚本。令牌桶限流时,客户端传入时间戳等参数。Java层需正确配置序列化、返回值类型和连接池,否则易破坏一致性。
2026-07-11
0
Java 中 ReentrantLock 在分布式锁设计中的实现局限
先得明确一点:ReentrantLock 本质上只活在单个 JVM 进程内部,它天生不具备跨进程、跨机器的协调能力。所以,用它来实现分布式锁,从一开始就走错了方向。 那么,它到底卡在哪里? 无法跨越 JVM 边界 ReentrantLock 基于 AQS(AbstractQueuedSynchron
2026-07-09
0
查看更多
热门文章
更多
精品专题
更多
Mac软件
更多
Adobe Acrobat Pro macOS版
Mac
Adobe Acrobat Pro 是面向办公、法务、财务、教育及出版用户的专业PDF处理软件,可在Mac上创建、编辑、转换、合并和保护文档,并提供OCR文字识别、表单、批注、内容比较、敏感信息遮盖及电子签名功能。
Blender
Windows、macOS 和 Linux
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。
Shapr3D macOS版
Mac
Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。
WINDOWS
更多
AutoCAD Windows版
Windows
AutoCAD 是 Autodesk 推出的专业计算机辅助设计软件,Windows 版支持精确二维绘图、三维实体与曲面建模、图纸标注、布局发布和任务自动化,并包含多套行业专业化工具组合,适用于建筑、机械、电气、工程建设及制造设计人员。
Adobe Acrobat Pro Windows版
Windows
Adobe Acrobat Pro 是面向专业 PDF 工作的综合解决方案,可在 Windows 中创建、编辑、转换、比较、整理和保护文档,并支持表单、电子签名、扫描件文字识别及敏感信息永久遮盖。订阅还包含网页、移动服务和云端协作能力,
Blender
Windows、macOS 和 Linux
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。