

数据结构的理论与工程实现之间的鸿沟
从 Redis 的奇妙选择到 C++ 标准库的保守哲学 教科书里讲的数据结构,说实话,挺“干净”的。红黑树永远平衡,哈希表永远优雅,跳表永远概率完美。但你要是真在工程里写过代码,就知道事情远没那么简单。Redis 用跳表而不是红黑树来实现有序集合,用 listpack 这种紧凑结构替代传统链表,甚至
从 Redis 的奇妙选择到 C++ 标准库的保守哲学
教科书里讲的数据结构,说实话,挺“干净”的。红黑树永远平衡,哈希表永远优雅,跳表永远概率完美。但你要是真在工程里写过代码,就知道事情远没那么简单。Redis 用跳表而不是红黑树来实现有序集合,用 listpack 这种紧凑结构替代传统链表,甚至还会根据数据量在运行的时候悄悄切换底层的数据结构。而 C++ 标准库呢?它走向了另一个极端——宁可什么都不提供,也不愿把一个“凑合用”的实现写进标准里。
这两种截然不同的态度,指向的其实是同一个核心问题:数据结构的实现,远比它的定义要复杂得多。
一、教科书之外的世界
大多数人学数据结构的路径都差不多:从数组、链表开始,然后栈和队列,再到树、图、哈希表。每一种结构都有清晰的定义,漂亮的时间复杂度分析,以及配套的伪代码。
但这一套体系其实藏着一个前提假设:它假定内存是均匀的,操作是孤立的,数据量是固定的。
现实世界呢?这三个假设全都不成立。
CPU 有缓存层级,连续的内存访问比随机跳跃快了不是一星半点;操作不可能是孤立的,并发读写就会带来锁竞争;数据量更是动态的,一个只存了 3 个元素的集合,和存了 300 万个元素的集合,最优的底层结构压根不是同一种东西。
于是,工程师们开始在理论骨架的基础上,生长出各种各样的“变异体”。这些变异体有时候看起来面目全非,但每一处改动的背后,都有充分、扎实的工程理由。
二、基础数据结构的标准形态
在深入工程案例之前,先花几分钟回顾一下几种核心数据结构的“教科书版本”,这能帮你更好地理解后面的变形都是为了解决什么具体问题。
树族的演化谱系
最朴素的二叉搜索树,在极端情况下会退化成一个链表,查询复杂度从 O(log n) 直接跌到 O(n)。为了解决这个问题,A VL 树引入了严格的高度平衡约束,但代价是频繁的旋转操作,实现起来比较麻烦。后来红黑树放宽了这个平衡条件,用“近似平衡”换来了更少的旋转次数,成了工程中应用最广泛的平衡树。
B 树和 B+ 树则是专门为磁盘 I/O 设计的——通过增大每个节点的“扇出”(也就是子节点数量),来降低树的高度,减少磁盘访问次数。数据库索引清一色使用 B+ 树,原因就在这里。
跳表:链表的概率性升维
跳表是 William Pugh 在 1990 年提出的一种概率性数据结构。它的核心思路其实很简单:在普通链表的基础上,建立多层“快速通道”,每一层都是下一层的稀疏索引。
查找的时候从最高层开始,快速跳过大量节点,平均时间复杂度也是 O(log n),但比红黑树实现起来要简单得多。
哈希表的两种冲突解决策略
哈希表的核心挑战,永远都是哈希冲突。主流的解决方案主要是这两种:
- 链地址法:每个桶维护一个链表,冲突的元素就挂在同一个桶里。Redis 和 Ja va 的 HashMap 都用的这种方式。
- 开放寻址法:冲突的时候在表内探测下一个空位。Python 的 dict 和 C++ 的某些实现会采用这种,它的缓存友好性更好。
三、Redis 的实现选择:工程智慧的集中展示
Redis 可以说是理解“理论与工程之间鸿沟”的最佳教材了。它的每一个设计决策,都是在内存效率、操作性能和实现复杂度之间,反复掂量的结果。
3.1 跳表而非红黑树:ZSet 的核心选择
Redis 的有序集合,在数据量比较大的时候,底层用的是跳表加哈希表的组合,而不是红黑树。这个选择,确实让不少人感到意外。
antirez 本人解释过,原因其实就三条:
第一,范围查询更自然。 红黑树做范围查询需要中序遍历,实现起来有点麻烦;而跳表的底层就是个有序链表,范围查询只需要找到起点然后顺序遍历,代码极其简洁。
第二,实现更简单,调试起来也更容易。 红黑树的旋转和变色逻辑是出了名的让人头大,一旦出 bug 很难排查。跳表的逻辑相对直观,代码量也更少。
第三,在这个场景下,两者在内存局部性上的差异其实不大。 对于 Redis 这种纯内存数据库,跳表的内存访问模式已经足够好了。
3.2 listpack:极致的内存压缩
Redis 7.0 用 listpack 替代了旧版的 ziplist,作为小数据量场景下的紧凑编码格式。
listpack 的设计思路很纯粹:把所有元素连续地存储在一块内存里,彻底消灭指针开销。 每个元素由三部分组成:编码类型、数据内容、以及当前元素的总长度(用于反向遍历)。
传统链表每个节点需要两个指针,在 64 位系统上就是 16 字节的纯开销。如果存储的是小整数或者短字符串,指针的开销甚至比数据本身还大。listpack 直接消灭了这种浪费。
代价也是有的:插入和删除需要移动内存,时间复杂度是 O(n)。但对于小数据量(通常阈值是 128 个元素),这个代价完全在可接受的范围内。
3.3 渐进式 rehash:不阻塞服务器的扩容
Redis 是单线程的,这意味着任何耗时操作都会阻塞所有客户端请求。传统的哈希表扩容,需要一次性重新计算所有键的哈希值并迁移,数据量大的时候这个操作可能耗时好几秒——这对 Redis 来说是不可接受的。
Redis 的解决方案是渐进式 rehash:
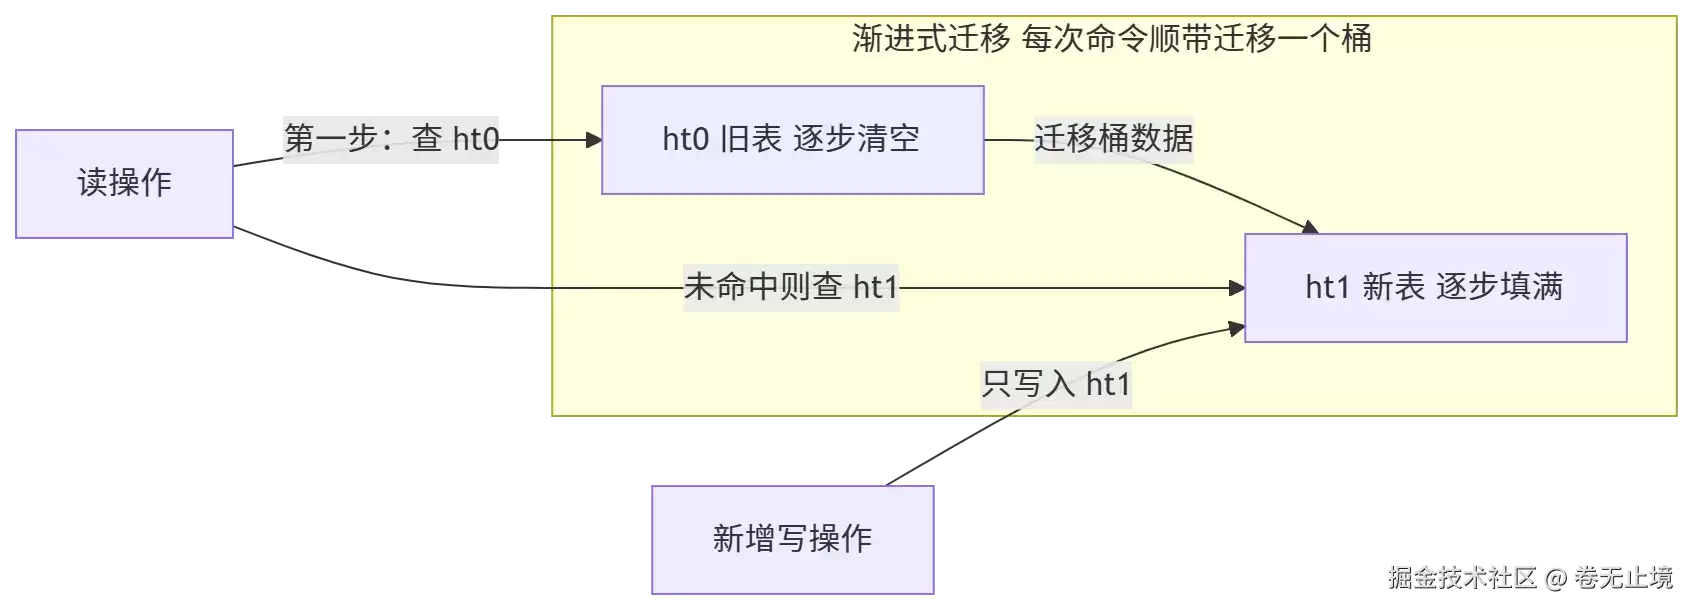
扩容的时候,Redis 同时维护两张哈希表。每次对字典进行增删改查操作时,顺带将旧表中的一个桶迁移到新表。这样一来,扩容的开销就被均匀地分摊到了每一次操作上,单次操作的延迟增加变得微乎其微。
3.4 quicklist:链表与压缩的混合体
Redis 的 List 类型底层用的是 quicklist,这是一个很有意思的“链表套 listpack”的混合结构:
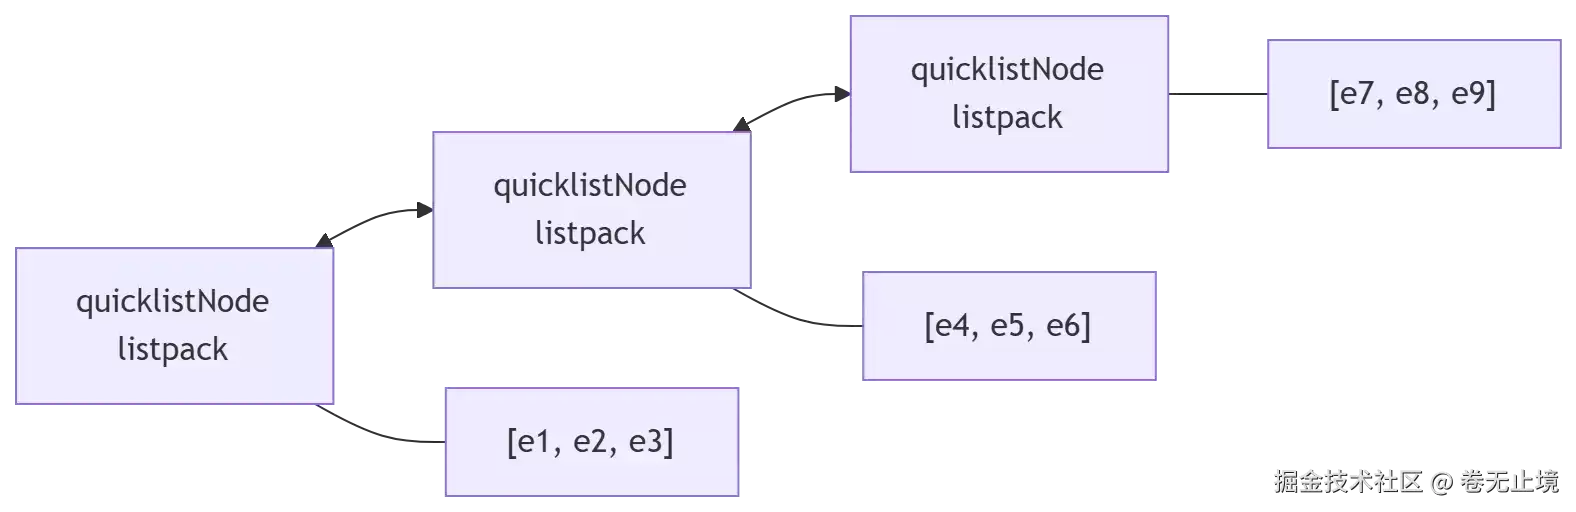
每个 quicklist 节点是一个 listpack,节点之间用双向链表连接。这样一来,既保留了链表两端 O(1) 插入删除的特性,又通过 listpack 的紧凑存储,大幅降低了内存占用。
3.5 intset:整数集合的极简实现
当 Set 里全是整数,而且数量不多的时候,Redis 不会用哈希表,而是用 intset——说白了就是一个有序的整数数组。
查找直接用二分搜索,时间复杂度是 O(log n);但内存极其紧凑,CPU 缓存命中率极高。对于小整数集合,实际性能往往比哈希表还好。
3.6 小结:Redis 的核心哲学
Redis 的所有这些设计,都遵循着同一个原则:
| 数据类型 | 小数据量编码 | 大数据量编码 |
|---|---|---|
| String | int / embstr | raw (SDS) |
| List | listpack | quicklist |
| Hash | listpack | hashtable |
| Set | listpack / intset | hashtable |
| ZSet | listpack | skiplist + hashtable |
这张表背后的逻辑其实很清晰:小数据量的时候,紧凑存储带来的缓存友好性,远比渐进复杂度更重要;数据量上去了,才需要真正的 O(log n) 或 O(1) 结构。
四、C++ 标准库的取舍哲学:宁缺毋滥
如果说 Redis 是“什么好用就用什么”的实用主义者,那么 C++ 标准库就代表了另一种极端——极度保守的标准化哲学。
4.1 进了标准库的数据结构
C++ 标准库提供的容器,其实相当有限:
| 容器 | 底层结构 | 复杂度保证 |
|---|---|---|
std::map / std::set | 红黑树 | O(log n) 查找/插入/删除 |
std::unordered_map | 哈希表(链地址法) | 平均 O(1) |
std::priority_queue | 二叉堆 | O(log n) push/pop |
std::deque | 分段数组 | O(1) 两端操作 |
std::vector | 动态数组 | O(1) 随机访问 |
4.2 没有进标准库的数据结构
下面这些在工程里极为常用的结构,至今都没能进入 C++ 标准库:
- 跳表
- B 树 / B+ 树
- Trie(前缀树)
- 布隆过滤器
- 并查集
- 线段树
这是为什么呢?
4.3 标准化的困境:实现细节无法统一
C++ 标准库的设计原则之一,是标准只规定接口和复杂度,不规定具体实现。 但问题就在于,很多数据结构的“最优实现”高度依赖具体场景,根本没法给出一个放之四海而皆准的版本。
就拿跳表来说:层数应该设多少?概率参数 p 取 1/4 还是 1/2?节点的内存怎么分配?这些参数的不同选择,会导致性能在不同场景下出现巨大差异。如果标准委员会随便选了一组参数写进标准,那在某些场景下,这个“标准跳表”的表现,可能还不如用户自己手搓的版本。
更糟的是:一旦进了标准库,实现就被“冻结”了。 所有依赖标准库的代码,都假设它的行为不会变,这让后续的优化变得极其困难。
4.4 std::regex 的前车之鉴
std::regex 就是个活生生的教训。它在 C++11 被纳入标准,但各大编译器的实现性能简直不堪入目——在某些测试里,std::regex 比 PCRE 慢 10 倍到 100 倍。
原因是标准委员会在没有充分参考实现的情况下,急匆匆地把接口标准化了,导致各家实现都选了次优的算法。这个问题到现在都没彻底解决,因为一旦修改实现,就可能会破坏现有代码的行为。
4.5 std::map 的隐藏代价
就算是已经进了标准库的 std::map,也有不少工程师对它不满意。
std::map 基于红黑树,每个节点都是独立分配在堆上的,节点之间靠指针连接。这意味着遍历 std::map 的时候,CPU 需要不停地追逐指针,缓存命中率非常低。对于需要频繁遍历的场景,一个简单的有序 std::vector 加上二分搜索,往往比 std::map 快得多。
这也是为什么 Google 的 Abseil 库提供了 absl::btree_map——用 B 树替代红黑树,大大提升了缓存友好性,同时保持了相同的接口。
五、数据结构实现的隐藏复杂度
教科书只告诉你时间复杂度,但真正决定性能的,往往是这些“隐藏变量”。
5.1 内存分配策略
标准的 new/delete 操作会涉及系统调用,开销不容忽视。高性能系统通常都用专用的内存分配器:
- Arena 分配器:预先申请一大块内存,然后线性分配,释放的时候整块归还。适合生命周期一致的对象。
- 内存池:为固定大小的对象预分配内存块,完全消除分配开销。Redis 的
zmalloc就是一种定制分配器。 - Slab 分配器:Linux 内核用的分配策略,按对象大小分类管理内存块。
同一种数据结构,配上不同的内存分配策略,性能可以相差好几倍。
5.2 缓存友好性:现代性能的第一要素
现代 CPU 的内存访问速度,跟缓存命中率关系密切:
| 存储层级 | 访问延迟 |
|---|---|
| L1 缓存 | ~4 个时钟周期 |
| L2 缓存 | ~12 个时钟周期 |
| L3 缓存 | ~40 个时钟周期 |
| 主内存(RAM) | ~200 个时钟周期 |
这意味着,一个“缓存不友好”的数据结构,每次访问都可能要付出 50 倍的延迟代价。
这也解释了为什么:
- 数组比链表快(连续内存 vs 指针跳跃)
- B 树比红黑树更适合大数据集(更少的指针追逐)
- Redis 的 listpack 在小数据量下性能出色(所有数据挤在一块连续内存里)
5.3 并发安全与锁粒度
单线程环境下的最优数据结构,到了多线程环境里可能完全不适用。
以哈希表为例:
- 全局锁:实现简单,但并发度极低
- 分段锁:Ja va 的
ConcurrentHashMap早期版本就用这个,把哈希表分成多个段,每段一把锁 - 无锁:用 CAS 原子操作,实现复杂但并发性能最佳
Redis 通过单线程模型,完全规避了并发问题,这也是它能用这么多“非线程安全”数据结构的根本原因。
5.4 平台差异与 SIMD 指令
现代 CPU 提供了 SIMD 指令集,可以一次操作 128 位、256 位甚至 512 位的数据。针对 SIMD 优化的数据结构,在字符串匹配、数组搜索这些场景里,性能可以提升 4 到 16 倍。
但这种优化高度依赖平台——x86 的 A VX2 指令在 ARM 上就没法用。这也是标准库很难把这些优化写进规范的原因之一。
六、工程选型的决策框架
面对这么多选择,工程师该怎么做决定呢?下面是一个比较实用的决策框架。
6.1 数据规模决定结构形态
Redis 的动态编码切换,本质上就是在自动执行这个决策树。
6.2 读写比例决定优化方向
| 场景 | 推荐结构 | 理由 |
|---|---|---|
| 读多写少 | 有序数组 + 二分搜索 | 读性能极佳,写入可以批量处理 |
| 写多读少 | LSM Tree | 写入顺序化,读取时合并 |
| 读写均衡 | 红黑树 / 跳表 | 均衡的 O(log n) 保证 |
| 点查为主 | 哈希表 | O(1) 平均查找 |
| 范围查询为主 | B+ 树 / 跳表 | 有序结构天然支持范围扫描 |
6.3 内存 vs 速度的永恒权衡
- 空间换时间:哈希表、缓存、预计算索引
- 时间换空间:压缩编码(listpack)、流式处理
- 两者兼顾:往往需要混合结构,像 Redis 的 quicklist 那样
七、结语:数据结构是活的
回到最开始的问题:为什么 Redis 的实现和教科书差那么远?为什么 C++ 不把跳表和 B 树放进标准库?
答案其实是一回事:数据结构从来不是静态的数学对象,而是一个活在特定约束条件下的工程产物。
Redis 的每一个“奇怪”选择,都是在内存、速度、单线程模型、实际数据分布这些约束下,做出的最合理决策。C++ 标准库的保守,则是对“一旦标准化就难以回头”这一现实的清醒认知——std::regex 的教训已经说明,仓促的标准化比没有标准化更糟糕。
对我们程序员来说,这意味着:理解数据结构的原理是基本功,但真正的功力在于理解约束——知道在什么条件下,哪种实现是最合适的。教科书给你的是地图,而工程给你的是地形。地图永远比地形简单,但没有地图,你也看不清地形。
跳表不比红黑树“更好”,listpack 也不比链表“更先进”——它们只是在各自的约束条件下,正好是正确的答案。
参考来源:
- How Redis Dict (Hash Table) Implementation Works, OneUptime Blog, 2026
- Why Does Redis Use Skip Lists To Implement Sorted Sets? , Level Up Gitconnected
- Redis Deep Dive Part 2 - The Building Blocks, thuva4.com
- Redis underlying data structure: Everything you need to know, DevOps.dev Blog
漫蛙漫画官方入口与核心功能解析 寻找一个稳定、资源丰富的漫画在线阅读平台,是许多漫画爱好者的共同需求。其中,漫蛙漫画官方入口及其免费全集服务,受到了不少关注。那么,这个平台究竟如何?下面,我们就来深入了解一下它的具体信息与特色功能。 平台的官方访问地址是:https://www.manwa123.c
对于动漫爱好者而言,找到一个资源全、体验佳的追番平台,常常是件头疼事。漫蛙动漫APP的定位很明确:就是要打造一个聚合全球正版动漫资源的专属乐园。无论是当季火爆的日漫新番、值得回味的经典国创,还是那些小众却精彩的优质动画,在这里基本都能一网打尽。平台底层采用了智能缓冲技术,最大程度保证了播放的流畅度,
想要获取正版manwa漫蛙APP?官方指定下载渠道就是漫蛙官网入口。 对于漫画迷而言,找到一款心仪的阅读神器至关重要。漫蛙APP正是这样一款专为全球漫画爱好者打造的平台,它汇聚了从日韩人气连载到本土原创精品的海量资源。说它“应有尽有”毫不为过。更重要的是,其界面设计清爽直观,搭配智能检索功能,能让用
想要畅享海量正版漫画资源?漫蛙漫画平台不容错过 对于漫画迷来说,找到一个资源丰富、体验流畅的正版平台实属幸事。漫蛙漫画凭借其优质的在线阅读服务,已经成为了许多资深读者的心头好。今天,我们就来详细拆解一下平台的访问方法与实用技巧,助你轻松开启漫画之旅。 漫蛙漫画网页入口页面指南 想立刻体验?官方在线观
漫蛙漫画网APP官方下载方法全解析 对于资深漫画迷来说,找到一个资源全、更新快、体验佳的阅读平台,就像淘到了宝藏。漫蛙漫画网APP,正是这样一个专为爱好者打造的精品集散地。它汇聚了全球优质的正版漫画,从火爆的日漫连载到崛起的国创佳作,平台都能做到实时同步更新。当然,第一步得先把它装到设备上。接下来,
漫蛙漫画APP:专业漫画阅读工具的全面革新 作为一款专业的漫画阅读工具,漫蛙漫画APP整合了全球优质漫画资源,其升级版漫蛙2在功能与体验上可谓全面革新。这款应用不仅囊括日漫经典与国漫新作,更通过简洁直观的界面设计和流畅操作,为用户打造沉浸式阅读环境,充分满足各类漫画爱好者的多样化需求。 漫蛙漫画特色
当下动漫圈热议的卖茶叶妈妈3d漫蛙下载,凭借其突破性的3D视觉技术成为焦点 最近动漫爱好者们都在讨论一个现象级产品——卖茶叶妈妈3d漫蛙下载。这款由漫蛙漫画平台倾力打造的3D作品专区,用立体建模与动态分镜彻底颠覆了传统二维漫画的阅读模式。你猜怎么着?现在只需通过专区提供的便捷下载通道,无论是热血冒险
漫蛙APP:资深漫画迷的移动图书馆与阅读利器 对于漫画爱好者来说,找到一个资源全、体验好的阅读平台,从来都不是件容易的事。而漫蛙APP,恰恰就是为这个需求而生的。它凭借海量的正版漫画库和极其便捷的离线下载功能,在圈内积累了相当不错的口碑。更重要的是,从经典的日本热血漫到新兴的国产原创作品,它几乎一网
专为漫画爱好者打造的漫蛙app:一款完全免费的阅读神器 对于漫画迷来说,找到一款资源全、体验好的阅读应用,常常不是件容易事。漫蛙app的出现,或许能打消这个顾虑。它主打完全免费,却汇集了海量国内外优质漫画资源。无论是追日韩的热门连载,还是淘本土的原创佳作,你都能在这里找到丰富的选择。应用的核心功夫下
漫蛙漫画APP:一款如何征服漫画爱好者的阅读利器 在众多漫画阅读平台中,漫蛙漫画APP免费版一直是许多深度爱好者的心头好。原因无他:它真正做到了将海内外精品漫画资源一网打尽。无论是历久弥新的日系经典,还是势头正劲的本土原创,在这里都能轻松找到。当然,光有海量内容还不够,应用的智能排版技术保证了画面的




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,