

MySQL快速统计行数方法与COUNT优化技巧
统计MySQL表行数需根据场景选择精确或估算方法。1.精确计数推荐使用COUNT(*),并结合索引覆盖、分区表统计、查询缓存优化性能;2.快速估算可通过EXPLAIN、information_schema.TABLES、定期统计、专用工具实现,但可能牺牲精度;3.大型表处理建议采用分批查询、物化视图、选择性索引等手段提升效率;4.维护统计信息应定期执行ANALYZETABLE、OPTIMIZETABLE,或借助自动化任务与监控工具;5.使用information_schema.TABLES估算存在不准确、
统计MySQL表行数需根据场景选择精确或估算方法。1. 精确计数推荐使用COUNT(*),并结合索引覆盖、分区表统计、查询缓存优化性能;2. 快速估算可通过EXPLAIN、information_schema.TABLES、定期统计、专用工具实现,但可能牺牲精度;3. 大型表处理建议采用分批查询、物化视图、选择性索引等手段提升效率;4. 维护统计信息应定期执行ANALYZE TABLE、OPTIMIZE TABLE,或借助自动化任务与监控工具;5. 使用information_schema.TABLES估算存在不准确、依赖存储引擎等局限;6. 分批处理通过LIMIT/OFFSET或自增ID分段减少单次查询压力;7. 物化视图可加速COUNT查询,但需权衡存储、维护成本与数据一致性。
统计MySQL表中的行数,核心在于选择合适的方法,兼顾速度和准确性。直接使用COUNT(*)在大型表上可能会非常慢,而一些估算方法虽然快,但牺牲了精确度。
解决方案:
*精确计数:`COUNT()` 及其优化**
最直接的方法是
SELECT COUNT(*) FROM your_table;。 但对于大型表,这会扫描整个表,效率很低。
优化方案:
- 索引覆盖: 如果只需要统计行数,可以尝试创建一个包含所有列的覆盖索引。 这样查询可以直接从索引中获取,避免访问数据行。
CREATE INDEX index_name ON your_table (column1, column2, ...); - 分区表: 如果表是分区表,可以分别统计每个分区的行数,然后加总。 这可以利用并行处理,加快速度。
- 查询缓存: 启用MySQL的查询缓存(如果适用,MySQL 8.0已移除查询缓存),对于重复查询,可以直接返回结果。
- 避免使用
COUNT(column_name):COUNT(column_name)只统计非NULL值的行数,而COUNT(*)统计所有行数,后者通常更快。
- 索引覆盖: 如果只需要统计行数,可以尝试创建一个包含所有列的覆盖索引。 这样查询可以直接从索引中获取,避免访问数据行。
快速估算:牺牲精度换取速度
*`EXPLAIN SELECT COUNT() FROM your_table;
**EXPLAIN命令会显示MySQL的查询执行计划,其中rows` 列通常会给出一个估计的行数。 这个值不一定准确,但速度很快。information_schema.TABLES: 可以从information_schema.TABLES表中获取表的TABLE_ROWS列,这个值是MySQL上次分析表时记录的行数。 同样,这个值可能不准确,需要定期更新。 可以使用ANALYZE TABLE your_table;命令来更新统计信息。自定义估算: 如果业务允许一定误差,可以定期(例如每天或每周)使用
COUNT(*)统计行数,并将其存储在另一个表中。 在需要快速获取行数时,直接从这个表中读取。
使用专用工具:
- pt-table-checksum: Percona Toolkit 提供的
pt-table-checksum工具可以用于数据一致性检查,但它也会计算表的行数。 虽然主要用于校验,但可以作为一种获取行数的手段。 - 其他监控工具: 一些数据库监控工具会自动收集表的统计信息,可以直接从这些工具中获取行数。
- pt-table-checksum: Percona Toolkit 提供的
MySQL如何处理大型表的COUNT查询?
大型表的 COUNT(*) 查询之所以慢,是因为MySQL需要扫描整个表或者索引来确定行数。 如果没有合适的索引,这将是一个全表扫描,非常耗时。 MySQL优化器会尝试选择最佳的执行计划,但如果表太大,即使是索引扫描也可能很慢。
处理方案:
- 选择性索引: 如果查询中包含
WHERE子句,可以创建一个针对WHERE子句中列的索引。 这样MySQL可以利用索引快速定位到满足条件的行,然后进行计数。 - 分批处理: 将大型表分成多个小块,分别统计每个小块的行数,然后加总。 可以使用
LIMIT和OFFSET子句来实现分批处理。 例如,先统计前10000行,然后统计10001到20000行,以此类推。 - 物化视图: 创建一个物化视图,定期刷新,其中包含表的行数。 这样可以避免每次查询都扫描整个表。 但需要注意物化视图的维护成本。
- 总结: 核心思路是将大的
COUNT(*)查询分解成小的查询,或者利用预先计算好的统计信息。
如何定期维护MySQL表的统计信息?
定期维护表的统计信息对于MySQL优化器选择最佳执行计划至关重要。 过时的统计信息可能导致优化器做出错误的决策,从而降低查询性能。
维护方法:
ANALYZE TABLE命令: 这是最常用的维护统计信息的命令。 它会分析表中的数据,并更新表的统计信息,包括行数、索引的基数等。 建议在表的变更量较大时执行此命令。ANALYZE TABLE your_table;
OPTIMIZE TABLE命令: 除了分析表,OPTIMIZE TABLE还会对表进行碎片整理,并回收未使用的空间。 但这个命令会锁定表,影响并发性能,所以应该谨慎使用。OPTIMIZE TABLE your_table;
mysqlcheck工具: 可以使用mysqlcheck工具来检查和修复表,并更新统计信息。mysqlcheck -u root -p --analyze --all-databases
自动化维护: 可以使用 cron 任务或者MySQL的事件调度器来定期执行
ANALYZE TABLE命令。 例如,每天凌晨执行一次:CREATE EVENT analyze_tables ON SCHEDULE EVERY 1 DAY STARTS CURRENT_DATE + INTERVAL 1 DAY DO ANALYZE TABLE your_table;
监控统计信息: 监控表的统计信息,例如行数、索引的基数等。 当这些值发生显著变化时,及时执行
ANALYZE TABLE命令。Percona Toolkit: Percona Toolkit 提供了
pt-table-sync工具,可以用于同步表的统计信息。 这在主从复制环境中非常有用。注意事项:
ANALYZE TABLE命令会锁定表,影响并发性能。 应该在业务低峰期执行此命令。- 对于非常大的表,
ANALYZE TABLE命令可能需要很长时间才能完成。 可以考虑使用ANALYZE TABLE PARTITION命令来分析单个分区。 - 定期维护统计信息是一个持续的过程,需要根据表的变更情况进行调整。
使用information_schema.TABLES估算行数有哪些局限性?
虽然从 information_schema.TABLES 表中获取 TABLE_ROWS 列可以快速估算行数,但它存在一些局限性:
不准确:
TABLE_ROWS的值不是实时更新的。它是在MySQL上次分析表时记录的行数。如果表的数据发生了变化,这个值可能就不准确了。依赖于存储引擎:
TABLE_ROWS的值的计算方式取决于存储引擎。对于MyISAM存储引擎,这个值是精确的。但对于InnoDB存储引擎,这个值只是一个估计值。需要权限: 需要具有
SELECT权限才能访问information_schema.TABLES表。不适用于所有场景: 如果需要精确的行数,或者表的数据经常发生变化,就不应该使用
information_schema.TABLES来估算行数。更新频率:
TABLE_ROWS的更新频率取决于MySQL的配置和表的变更情况。 可以使用ANALYZE TABLE命令来手动更新这个值。总结:
information_schema.TABLES提供的TABLE_ROWS列可以作为一种快速估算行数的手段,但需要注意其局限性。 在需要精确行数的情况下,应该使用COUNT(*)命令。
如何通过分批处理优化COUNT查询?
分批处理的核心思想是将一个大的 COUNT(*) 查询分解成多个小的查询,分别统计每个小块的行数,然后加总。
实现方法:
使用
LIMIT和OFFSET子句: 这是最常用的分批处理方法。LIMIT子句指定要返回的行数,OFFSET子句指定要跳过的行数。-- 统计前10000行 SELECT COUNT(*) FROM your_table LIMIT 10000; -- 统计10001到20000行 SELECT COUNT(*) FROM your_table LIMIT 10000 OFFSET 10000; -- 统计20001到30000行 SELECT COUNT(*) FROM your_table LIMIT 10000 OFFSET 20000;
可以使用循环或者存储过程来自动执行这些查询,并加总结果。
使用自增ID或者时间戳: 如果表有一个自增ID或者时间戳列,可以使用
WHERE子句来分批处理。-- 假设表有一个自增ID列 id -- 统计id在1到10000之间的行数 SELECT COUNT(*) FROM your_table WHERE id BETWEEN 1 AND 10000; -- 统计id在10001到20000之间的行数 SELECT COUNT(*) FROM your_table WHERE id BETWEEN 10001 AND 20000;
同样,可以使用循环或者存储过程来自动执行这些查询,并加总结果。
存储过程示例:
DELIMITER //
CREATE PROCEDURE count_table(IN table_name VARCHAR(255), IN batch_size INT)
BEGIN
  DECLARE total_rows INT DEFAULT 0;
  DECLARE offset_val INT DEFAULT 0;
  DECLARE batch_rows INT DEFAULT 0;

  SET @sql_text = CONCAT('SELECT COUNT(*) FROM ', table_name, ' LIMIT ', batch_size, ' OFFSET ', offset_val);

  loop_label: LOOP
    SET @sql_text = CONCAT('SELECT COUNT(*) INTO @batch_rows FROM ', table_name, ' LIMIT ', batch_size, ' OFFSET ', offset_val);
    PREPARE stmt FROM @sql_text;
    EXECUTE stmt;
    DEALLOCATE PREPARE stmt;

    SET batch_rows = @batch_rows;

    IF batch_rows = 0 THEN
      LEAVE loop_label;
    END IF;

    SET total_rows = total_rows + batch_rows;
    SET offset_val = offset_val + batch_size;
  END LOOP loop_label;

  SELECT total_rows;
END //
DELIMITER ;

-- 调用存储过程
CALL count_table('your_table', 10000);
注意事项:
- 分批处理可以减少单个查询的压力,但会增加查询的次数。
batch_size的选择需要根据表的实际情况进行调整。 太小会导致查询次数过多,太大则可能仍然很慢。- 如果表的数据在查询过程中发生变化,可能会导致结果不准确。
如何利用物化视图加速COUNT查询?
物化视图是一种预先计算并存储结果的视图。 可以利用物化视图来加速 COUNT(*) 查询,避免每次查询都扫描整个表。
实现方法:
创建物化视图:
CREATE MATERIALIZED VIEW your_table_count AS
SELECT COUNT(*) AS total_rows FROM your_table;
这个物化视图会存储
your_table表的行数。定期刷新物化视图:
物化视图的数据不是实时更新的,需要定期刷新。 可以使用 MySQL 的事件调度器来自动刷新物化视图。
CREATE EVENT refresh_your_table_count
ON SCHEDULE EVERY 1 DAY
STARTS CURRENT_DATE + INTERVAL 1 DAY
DO
  REFRESH MATERIALIZED VIEW your_table_count;
查询物化视图:
在需要获取行数时,直接查询物化视图即可。
SELECT total_rows FROM your_table_count;
注意事项:
- 存储空间: 物化视图需要额外的存储空间来存储预先计算的结果。
- 维护成本: 需要定期刷新物化视图,这会增加维护成本。
- 数据一致性: 物化视图的数据不是实时更新的,可能存在一定延迟。
- 适用场景: 物化视图适用于数据变化不频繁,且需要频繁查询行数的场景。
- MySQL版本限制: MySQL 8.0 及更高版本才支持物化视图。 在较低版本中,可以使用普通视图结合触发器来模拟物化视图的功能。
模拟物化视图(适用于MySQL 8.0以下版本):
创建普通视图:
CREATE VIEW your_table_count AS
SELECT COUNT(*) AS total_rows FROM your_table;
创建触发器:
-- 创建插入触发器
CREATE TRIGGER your_table_insert AFTER INSERT ON your_table
FOR EACH ROW
BEGIN
  UPDATE summary_table SET total_rows = (SELECT COUNT(*) FROM your_table) WHERE table_name = 'your_table';
END;

-- 创建删除触发器
CREATE TRIGGER your_table_delete AFTER DELETE ON your_table
FOR EACH ROW
BEGIN
  UPDATE summary_table SET total_rows = (SELECT COUNT(*) FROM your_table) WHERE table_name = 'your_table';
END;

-- 创建更新触发器
CREATE TRIGGER your_table_update AFTER UPDATE ON your_table
FOR EACH ROW
BEGIN
  UPDATE summary_table SET total_rows = (SELECT COUNT(*) FROM your_table) WHERE table_name = 'your_table';
END;
创建汇总表:
CREATE TABLE summary_table (
  table_name VARCHAR(255) PRIMARY KEY,
  total_rows INT
);

-- 初始化汇总表
INSERT INTO summary_table (table_name, total_rows)
VALUES ('your_table', (SELECT COUNT(*) FROM your_table));
查询汇总表:
SELECT total_rows FROM summary_table WHERE table_name = 'your_table';
这种方法可以模拟物化视图的功能,但需要更多的维护工作,并且可能会影响表的写入性能。

详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。

后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。

针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。

本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
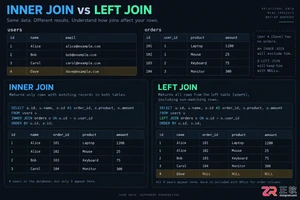
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
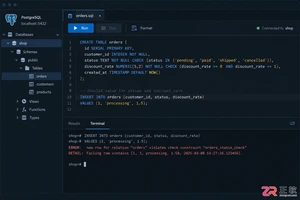
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
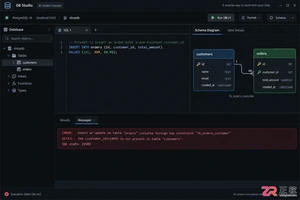
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



