

声音语音性别识别中的说话人变异问题
声音语音性别识别中的说话人变异问题,需要具体代码示例随着语音技术的快速发展,声音语音性别识别成为了一个日益重要的领域。它在很多应用场景中都有广泛的应用,例如电话客服、语音助手等。然而,在声音语音性别识别中,我们经常会遇到一个挑战,即说话人的变异问题。说话人变异是指不同个体的声音在语音特征上存在差异。由于个人的声音特征受到多种因素的影响,例如性别、年龄、嗓音等
声音语音性别识别中的说话人变异问题,需要具体代码示例
随着语音技术的快速发展,声音语音性别识别成为了一个日益重要的领域。它在很多应用场景中都有广泛的应用,例如电话客服、语音助手等。然而,在声音语音性别识别中,我们经常会遇到一个挑战,即说话人的变异问题。
说话人变异是指不同个体的声音在语音特征上存在差异。由于个人的声音特征受到多种因素的影响,例如性别、年龄、嗓音等,因此即使性别相同的人也可能有不同的声音特征。这对于声音语音性别识别来说是一个挑战,因为识别模型需要能够准确地识别不同个体的声音,并判断其性别。
为了解决说话人变异问题,我们可以采用深度学习的方法,并结合一些特征处理方法。以下是一个示例代码,演示如何进行声音语音性别识别,并处理说话人变异问题。
首先,我们需要准备训练数据。我们可以收集不同个体的声音样本,并标注其性别。训练数据应尽可能包含更多的声音变异,以提高模型的鲁棒性。
接下来,我们可以使用Python编写代码来构建声音语音性别识别模型。我们可以使用深度学习框架TensorFlow来实现该模型。以下是一个简化的示例代码:
import tensorflow as tf

# 构建声音语音性别识别模型
def build_model():
    model = tf.keras.Sequential([
        tf.keras.layers.Conv2D(32, (3, 3), activation='relu', input_shape=(256, 256, 1)),
        tf.keras.layers.MaxPooling2D((2, 2)),
        tf.keras.layers.Conv2D(64, (3, 3), activation='relu'),
        tf.keras.layers.MaxPooling2D((2, 2)),
        tf.keras.layers.Flatten(),
        tf.keras.layers.Dense(64, activation='relu'),
        tf.keras.layers.Dense(1, activation='sigmoid')
    ])
    return model

# 编译模型
model = build_model()
model.compile(optimizer='adam',
              loss='binary_crossentropy',
              metrics=['accuracy'])

# 加载训练数据
train_data = load_train_data()

# 训练模型
model.fit(train_data, epochs=10)

# 测试模型
test_data = load_test_data()
test_loss, test_acc = model.evaluate(test_data, verbose=2)

# 使用模型进行声音语音性别识别
def predict_gender(audio):
    # 预处理音频特征
    processed_audio = process_audio(audio)
    # 使用训练好的模型进行预测
    predictions = model.predict(processed_audio)
    # 返回预测结果
    return 'Male' if predictions[0] > 0.5 else 'Female'
在以上示例代码中,我们首先构建了一个卷积神经网络模型,并使用TensorFlow的Sequential API进行模型构建。然后,我们编译模型,设置优化器、损失函数和评估指标。接着,我们加载训练数据,并使用模型进行训练。最后,我们使用测试数据进行模型测试,并使用模型进行声音语音性别识别。
需要注意的是,在实际应用中,我们可能需要更复杂的模型和更多的数据来提高识别准确率。同时,为了更好地处理说话人变异问题,我们还可以尝试使用特征处理技术,例如声纹识别、多任务学习等。
总结而言,声音语音性别识别中的说话人变异问题是一个具有挑战性的问题。但通过采用深度学习的方法,并结合适当的特征处理技术,我们可以提高模型的鲁棒性,实现更准确的性别识别。以上示例代码仅为演示目的,实际应用中需要根据具体需求进行修改和优化。
通过设置隐私关闭语音识别开关、控制面板取消开机自启、设备管理器禁用麦克风,可彻底关闭Win10语音识别功能,防止后台监听与耗电。需注意禁用麦克风会影响视频会议等应用。
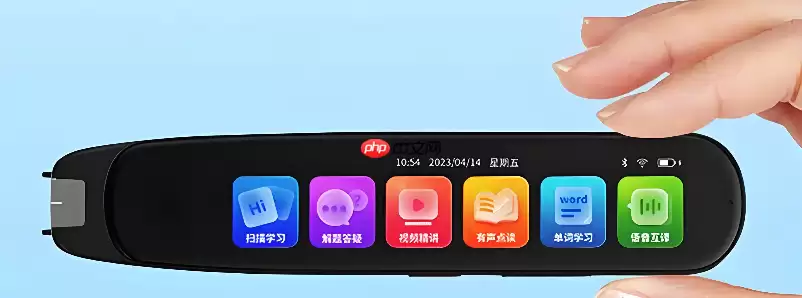
前言:语音识别突然罢工,别急着找售后 点读笔的语音识别功能忽然没反应——跟读对比启动不了、语音翻译和查词全无响应,提示音消失、麦克风形同虚设、屏幕也没有识别状态显示。很多人第一反应是笔坏了,要返厂。其实十次里有九次,问题出在系统模式错位或权限链断裂,硬件本身好得很。下面这几步排查下来,基本都能恢复。
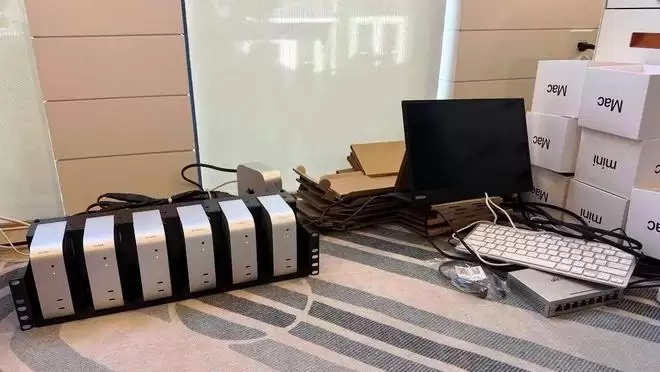
绕开云端高成本:一位开发者如何用48台Mac mini打造本地AI转录集群 对于AI模型的部署,云端API似乎是默认选择,但成本问题往往让开发者望而却步。最近,播客应用Overcast的开发者Marco Arment提供了一个截然不同的思路。他绕开了那些昂贵的云端服务,自行搭建了一个由48台苹果Ma
PHP处理语音的核心在于借助外部工具和服务,将语音转化为文本数据。具体方法包括:1.使用GoogleCloudSpeech-to-TextAPI、MicrosoftAzureSpeechServices或AmazonTranscribe等云端语音识别API进行高精度转录;2.利用本地语音识别引擎CMUSphinx保障数据隐私;3.通过SoX和getID3()等音频处理库完成格式转换与元数据读取。选择技术时需综合考虑精度、预算、隐私、网络及开发难度,同时可通过优化音频质量、格式选择、压缩文件、缓存结果、异步
Python实现语音识别需选对工具并理清流程,常用库包括SpeechRecognition、PyAudio和Whisper。使用SpeechRecognition的步骤为:安装库、录音并调用API识别;而Whisper模型则支持离线高精度识别,需安装依赖并加载模型处理音频文件。实际应用中应注意音频格式、环境噪音、多语言支持及性能问题。
微信语音通话对方听不到声音,通常是因为麦克风权限、网络问题或软件故障。首先,检查麦克风权限是否开启,iOS用户进入“设置”-“微信”确认,安卓用户进入“设置”-“应用管理”-“微信”-“权限”确认;其次,检查网络信号,切换至Wi-Fi或4G/5G,重启路由器或关闭其他占用网络的应用;第三,排查微信自身问题,尝试重启微信、更新版本或重新安装;第四,测试手机麦克风是否损坏,使用录音功能或其他通话软件验证;第五,确认是否为对方设备问题,让对方检查麦克风权限及网络;第六,排除耳机模式干扰,插拔耳机或清理耳机孔;最
电脑声音问题可按以下步骤排查:1.检查音量是否静音,确认耳机或音箱插头无松动;2.通过设备管理器查看驱动是否存在异常并更新;3.使用WindowsUpdate、官网驱动或驱动软件更新驱动;4.调整声音设置,包括输出设备、音量及禁用增强效果;5.排查软件冲突,关闭占用音频资源的程序;6.尝试重置音频服务、禁用音频增强、检查BIOS设置、卸载多余驱动、调整音频格式;7.通过更换设备测试判断是否为硬件问题;8.若声音断续,检查驱动、连接、CPU占用、电源管理、无线干扰及硬盘状态。若上述方法无效,可尝试系统还原或

使用Python与腾讯云接口对接,实现语音识别功能随着人工智能的快速发展,语音识别技术变得越来越成熟。在日常生活中,我们经常使用语音识别功能来发送语音消息、进行语音搜索、语音翻译等。腾讯云提供了一系列的语音识别API,让开发者可以轻松地实现这些功能。本文将介绍如何使用Python与腾讯云接口对接,实现语音识别功能。首先,我们需要在腾讯云上创建一个项目并获取A
随着人工智能技术的不断发展,自动化学习技术得到越来越广泛的应用。语音识别是其中一个受欢迎的应用领域,Java编程语言也因其跨平台性和易于使用的特点成为了开发语音识别应用程序的首选语言。在本文中,将介绍Java如何实现一个基于自动化学习的语音识别应用程序的逻辑过程。确定语音识别的模型语音识别的模型是识别系统的核心。目前,常用的语音识别模型有隐马尔可夫模型(HM
随着人工智能技术的飞速发展,语音识别技术也逐渐成为了各个领域的热门应用。而在基于Web的应用中,PHP作为广泛应用的编程语言,也可以通过特定的技术实现高性能语音识别。在本篇文章中,我们将会介绍PHP中的高性能语音识别技术,及其在Web应用中的应用实践。一、PHP语音识别的现状在过去,PHP中语音识别方案的实现基本上依赖于Google语音识别API,或是阿里云





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



