

高性能
麒麟系统高负载卡顿需设CPU为performance策略、绑定核心、提权进程并禁用UKUI节流:执行循环echo performance命令,用taskset绑定核心,renice或chrt提升优先级,gsettings关闭电源管理,systemctl mask ukui-power-manager
要解决统信UOS卡顿问题,就必须手动激活OpenGL合成器、禁用tracker服务,并配置VA-API硬件解码环境变量。具体而言,启用UKUI OpenGL合成器,能让桌面帧率从12fps飙升至58fps;关闭冗余特效,再切换到“高效模式”主题,可释放老硬件的资源;禁用tracker-miner-f
中昊芯英发布新一代全自研高性能TPU芯片“须臾®”,单卡算力提升3倍,功耗降低50%,配套泰则®2.0智算平台单机算力7.168P,支持2048芯片直联,有效缓解存储墙难题,已部署于多个智算中心,赋能大模型及AI智能体场景。
中昊芯英发布新一代全自研高性能TPU芯片“须臾®”及泰则®2.0智算平台。相较初代产品,新品在底层架构、算力峰值、片上存储、集群互联和能效比等关键维度实现显著提升,针对大模型训练与推理痛点优化。
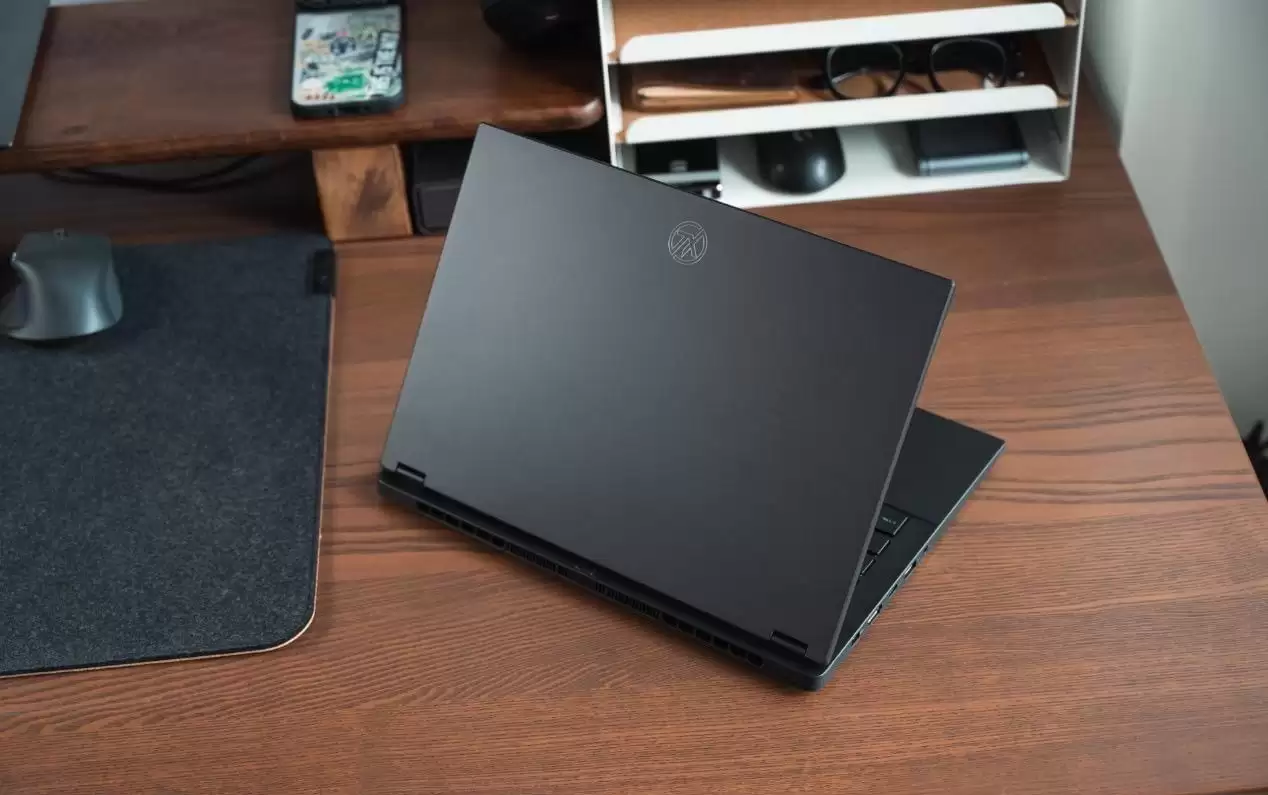
通过对比测试,AMD锐龙AIMAX+392在理论多核性能、内存带宽、采样渲染、图形游戏及AI推理生成速度上大幅领先英特尔酷睿UltraX9388H,尤其本地AI模型推理速度平均领先超50%,适合追求无短板的极致性能与全能体验的高阶用户。
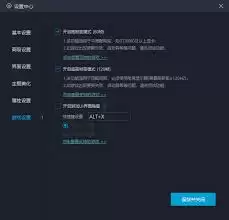
很多朋友在使用MuMu模拟器时,总觉得游戏跑起来有点卡顿,或者加载速度不够快。其实,只要把高性能模式打开,效果立竿见影——画面更流畅,操作反馈也更跟手。下面就把具体的设置步骤拆开来说,跟着走一遍就行。 首先,启动MuMu模拟器。在主界面的右上角,能看到一个三条横线的图标,点击后会弹出一个功能菜单。这
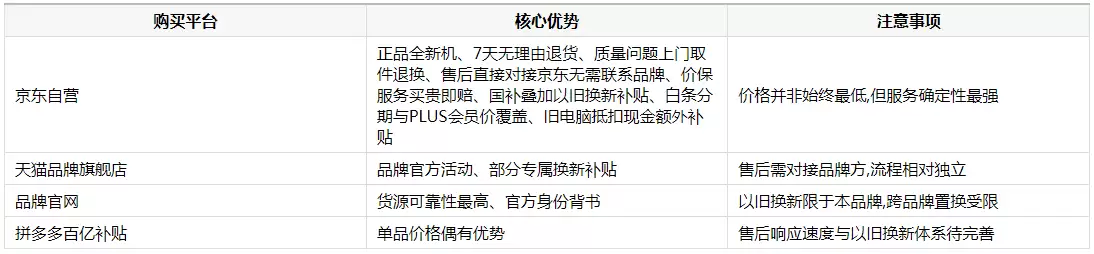
2026年轻薄本市场中,华硕无畏Pro14酷睿版搭载酷睿Ultra7处理器、50TOPSAI算力、1100尼特OLED屏及80Wh电池,国补后约6629元,覆盖办公、设计、学习场景。京东自营提供价保、以旧换新叠加优惠及售后保障,是理性购买渠道。
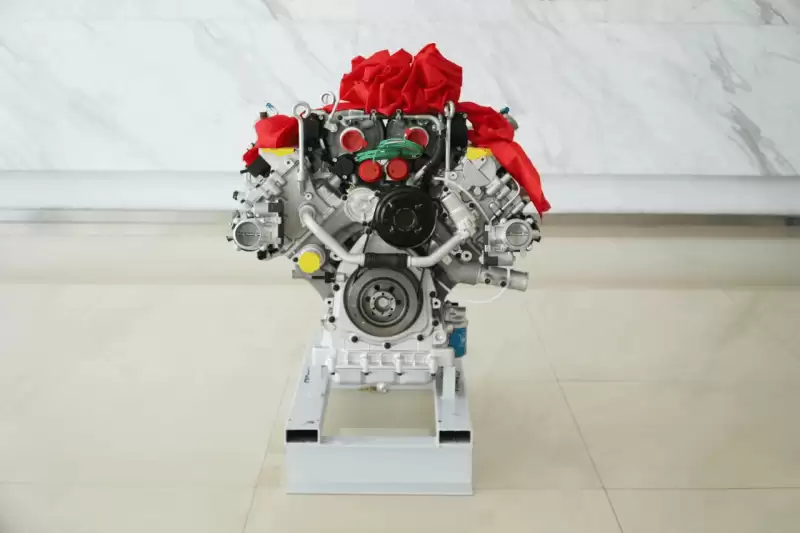
浩思动力自主研发的全域V6高性能引擎样机于宁波完成首次点火测试,进入工程验证阶段。该引擎采用轻量化设计与新型材料,功率超300kW,重量降低15%,支持混动架构,填补高端动力市场空白,预计2025年前完成认证。
华硕天选7X、天选6X及破晓7X三款全新台式机,搭载了英特尔酷睿Ultra系列处理器与RTX50系显卡,全面覆盖了AI开发、游戏娱乐与轻量创作三大场景。暑期促销活动期间可享受至高1500元国家补贴及晒单返E卡等超值福利。
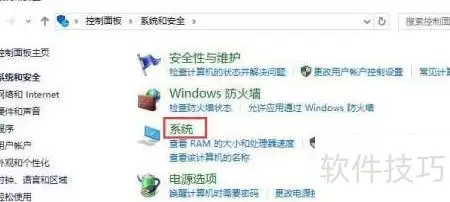
在Win10中,通过按下Win+X键进入控制面板,依次打开“系统和安全”“系统”“高级系统设置”,在性能选项中选择“调整为最佳性能”,即可切换到高性能模式,提升电脑响应速度。此方法操作简单,无需复杂设置,可有效让电脑更流畅。
在Golang微服务中配置Vector,需定义数据源和输出目标,推荐输出JSON日志以降低解析开销。性能调优需重点调整读取缓冲区、请求超时及最大读取字节等参数,防止内存溢出。日志生命周期管理应确保轮转策略与忽略旧日志时间对齐,并统一文件权限。
基于Swoole异步非阻塞IO和协程构建TCP服务器,配置worker_num等参数并启用open_tcp_nodelay防延迟,通过package_length_type或open_eof_split解决粘包,设置心跳检测与max_request保障长连接稳定,关闭调试并启用daemonize实现生产就绪。
Swoole框架采用常驻内存与协程调度机制,替代传统PHP-FPM模式,实现毫秒级响应时间。核心包括协程化HTTP服务器、路由分发、协程化数据库及Redis调用、连接池管理、静态化缓存等关键技术。优化后每秒查询率(QPS)超过12000,延迟低于零点八毫秒,性能卓越。
synchronized 从来都不是什么“性能杀手”——在锁粒度合理、竞争不激烈时,它的性能可以接近无锁。语义清晰、JVM 优化成熟,它天然就是高性能并发组件中值得信赖的基础同步工具。而性能的关键,无非就是锁对象选对、锁升级用好、临界区控好,再加上与 wait/notify 的默契配合。 很多人觉得
在Go高频调用场景中,反射实现的结构体转map性能较低(百万次约800ms),优化后可通过缓存反射结果或预生成专用函数降至120ms以内。对字段少、嵌套浅的结构体,改用JSON中转(利用json.Marshal/Unmarshal)可避免panic且性能更优。
TarsGo高性能源于连接复用、goroutine池、一致性哈希与Tars协议协同。协议文件需遵循映射规则,池大小从CPU核心数起步,超时分段控制,混合服务中禁止在Gin中间件启动匿名goroutine,以防资源泄漏。
System.arraycopy()作为JVM本地方法,通过直接调用memcpy实现高性能内存级数组拷贝,避免了for循环的边界检查开销。使用时需注意参数顺序、类型匹配及重叠拷贝问题,小数组场景可能因JNI调用开销反而更慢。优先复用已有数组以减少GC压力。
FileChannel.transferTo()实现零拷贝需满足目标为SocketChannel或同文件系统FileChannel、源为本地文件且不越界,否则回退用户态拷贝。堆外DirectBuffer避免复制但需防OOM,堆内Buffer适合小数据。Buffer读写后需正确flip()/clear()。transferTo()系统调用少、数据不经过用户空间
Composer 的 PSR-4 高性能映射(dump-autoload -o)并不是默认行为,需要显式启用;不加 -o 时每次解析类名路径,I/O 开销较大;加 -o 后会生成静态的类名→路径查找表,这其实是生产环境的硬性要求,不是可有可无的选项。 强调一下:Composer 的 PSR-4 高性
phpEnv自带的Nginx无法通过切换实现高性能,因其为Windows预编译版,模块固化且事件模型受限。需用源码编译精简版替换,注意裁剪模块、调整路径、关闭sendfile并确保权限匹配,才能获得轻量高性能。
先说一个核心判断:敏感词过滤用前缀树(Trie),它的核心优势非常明确——一次扫描就能实现多词匹配。这意味着什么?它避免了传统做法里那种对每个词单独遍历文本的笨办法。配合集合变量(比如布尔标记、词级元信息),就能灵活地支持替换、拦截、分级告警等不同策略。说白了,就是速度和扩展性都有了保证。 为什么
AC自动机是C++敏感词过滤的高效方案,可单次扫描完成多模式匹配,避免暴力替换的O(n×m)复杂度。掩码替换需倒序处理并预分配缓冲区,注意UTF-8编码边界。实际性能瓶颈多在字符串拼接和内存分配上。
C++中直接使用std::ostringstream拼接URL参数性能不佳,参数多、值长时问题更明显。原因是流式拼接多次触发内存重分配和重复拷贝,加上URL编码如std::regex_replace或临时字符串带来额外堆分配开销,关键在于避免反复的new/delete操作。


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




