

Java并行流高效使用技巧
Java并行流适合计算密集型、大数据集、无副作用、元素独立的任务。1.适用场景:计算密集型任务如数学运算、数据转换;大数据集需几万至几十万条数据;操作无共享状态;元素处理相互独立。2.使用方式:通过Collection.parallelStream()或Stream.parallel()创建。3.陷阱:共享可变状态引发并发问题;I/O密集型任务性能下降;默认ForkJoinPool资源竞争;调试难度增加。4.优化方法:用JMH进行基准测试;选用合适的数据结构如ArrayList;避免线程不安全操作;自定义
Java并行流适合计算密集型、大数据集、无副作用、元素独立的任务。1.适用场景:计算密集型任务如数学运算、数据转换;大数据集需几万至几十万条数据;操作无共享状态;元素处理相互独立。2.使用方式:通过Collection.parallelStream()或Stream.parallel()创建。3.陷阱:共享可变状态引发并发问题;I/O密集型任务性能下降;默认ForkJoinPool资源竞争;调试难度增加。4.优化方法:用JMH进行基准测试;选用合适的数据结构如ArrayList;避免线程不安全操作;自定义ForkJoinPool隔离任务;合理使用短路操作如findAny。

Java Stream并行流,这东西用好了确实能让你的代码跑得飞快,尤其是在处理大量数据时,那种CPU核心被充分压榨的感觉,很爽。但如果用不对,它就是个坑,轻则性能不升反降,重则引发难以追踪的并发问题。核心观点是:并行流并非万能药,它最适合的是那些计算密集型、且任务间相对独立的大数据集操作。
解决方案
在使用Java Stream并行流时,我们首先要明确它的适用场景和潜在风险。它基于ForkJoinPool,将任务递归地拆分,然后并行执行,最后再将结果合并。这个过程本身就有开销,所以,不是所有流操作都适合并行化。
何时考虑使用:
- 计算密集型任务: 你的操作主要是CPU在忙活,比如复杂的数学计算、数据转换、加密解密等。如果是I/O密集型(读写文件、网络请求),并行流的优势就不明显了,因为瓶颈在I/O,而不是CPU。
- 大数据集: 如果你的数据集很小,并行化的启动、任务拆分、结果合并这些开销可能比顺序执行还要大。通常,数据量达到几万甚至几十万以上,并行流的优势才可能体现出来。
- 无副作用的操作: 你的流操作(
map,filter,reduce等)最好是无状态的,或者至少是线程安全的。避免在lambda表达式中修改共享的外部变量,这几乎是所有并发问题的根源。 - 元素处理独立性高: 每个元素的处理不依赖于其他元素的处理结果,或者依赖关系可以通过聚合操作(如
collect)安全地处理。
如何使用:
Collection.parallelStream(): 最直接的方式,从集合直接获取并行流。Stream.parallel(): 如果你已经有了一个顺序流,可以调用parallel()方法将其转换为并行流。Stream.sequential(): 反之,你也可以将并行流转回顺序流。
需要警惕的陷阱:
- 共享可变状态: 这是最大的雷区。如果你在并行流中对一个非线程安全的共享变量进行读写操作,比如一个普通的
ArrayList或者HashMap,几乎必然会遇到数据不一致或并发修改异常。 - I/O密集型操作: 别指望并行流能加速数据库查询或者文件读写。线程多了,反而可能因为资源竞争(比如连接池耗尽、磁盘I/O争抢)导致性能下降。
- 默认的ForkJoinPool: 所有的并行流都共享JVM内部的公共ForkJoinPool。如果你在一个应用中大量使用并行流,可能会导致这个共享池被耗尽,从而影响其他并行任务的执行。
- 调试难度: 并行流中的bug,尤其是涉及并发问题的,比顺序代码更难复现和调试。
何时应该考虑使用Java并行流?
我个人觉得,决定是否用并行流,就像决定是否要买一台多核服务器一样,得看你的“活儿”是不是真的需要那么多核来一起干。如果你的任务主要是“想”,也就是CPU在做大量的逻辑判断、数值计算、复杂的数据转换,比如你有一堆原始日志,需要解析、清洗、聚合,每个日志条目的处理相对独立,而且量非常大,这时候并行流就能大显身手。它能把这些独立的“解析-清洗-聚合”任务分发给不同的CPU核心,同时进行。
想象一下,你有一张巨大的图片,需要对每个像素点进行某种复杂的滤镜处理。每个像素的处理都是独立的,而且计算量不小。这时候,如果用一个线程一个像素地处理,那得等到猴年马月。但如果用并行流,它可以把图片分成很多小块,每个线程处理一块,效率就上来了。
反之,如果你的任务主要是“等”,比如等数据库返回数据,等网络请求响应,那并行流就没啥用了。再多的线程也改变不了数据库响应慢的事实,反而可能因为频繁的线程上下文切换,以及对网络资源、数据库连接池的争抢,让整个系统变得更慢、更不稳定。所以,当你看到代码里有大量的Thread.sleep()、网络请求、文件读写,或者涉及到频繁的锁竞争时,就得好好掂量一下,并行流可能不是你的最佳选择。
Java并行流有哪些常见的陷阱与误区?
说实话,并行流的坑,我踩过不少。最要命的,就是那个“共享可变状态”的问题。很多人觉得,我把集合变成并行流了,里面的操作就都是线程安全的了,这是大错特错。比如,你可能想在并行流里统计一个总数,然后写出这样的代码:
Listnumbers = Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 10); int sum = 0; numbers.parallelStream().forEach(n -> sum += n); // 错误! System.out.println(sum); // 结果可能不准确
这段代码,sum 是一个共享的可变变量,sum += n 不是原子操作,在并行环境下会发生竞态条件,导致最终的 sum 值不正确。正确的做法是使用 reduce 或 collect 这样的聚合操作,或者使用线程安全的原子类,比如 AtomicInteger。
另一个误区是“并行流一定比顺序流快”。我见过不少人,代码跑得慢了,就想当然地把 stream() 改成 parallelStream(),结果发现性能反而更差了。这通常发生在数据集比较小,或者操作本身计算量不大,而并行化的开销(任务拆分、线程调度、结果合并)占了主导地位的时候。就像你要搬十块砖,你一个人搬很快就完了,但如果你非要叫上十个朋友,每个人搬一块,然后大家还要开个会讨论怎么分工,最后再一起把砖堆起来,这效率肯定不如你自己一个人。
还有就是对默认ForkJoinPool的滥用。所有的并行流都共用一个全局的ForkJoinPool。如果你的应用中有多个模块都在大量使用并行流,它们会互相竞争线程资源。这就像一个公共泳池,如果大家都在里面撒欢,池子里的水就容易浑浊,甚至池子都可能被挤爆。如果你有特别的需求,或者担心资源冲突,可以考虑自定义一个ForkJoinPool,但这又增加了管理的复杂性。
如何评估并优化Java并行流的性能?
评估并行流的性能,光靠感觉是不行的,必须用数据说话。最直接的方法就是进行基准测试(Benchmarking)。简单的 System.nanoTime() 计时可以快速给你一个大概的印象,但更专业的做法是使用 JMH (Java Microbenchmark Harness)。JMH 能够处理JVM的预热、死代码消除等复杂问题,给出更准确的性能数据。通过对比顺序流和并行流在不同数据集大小、不同操作复杂度下的执行时间,你就能清楚地知道并行流是否真的带来了提升。
优化方面,首先要避免那些常见的陷阱:确保你的操作是计算密集型的,数据集足够大,并且没有不安全的共享可变状态。如果发现有共享状态,考虑使用reduce、collect等函数式操作,或者使用ConcurrentHashMap、AtomicLong等并发数据结构。
其次,选择合适的数据源。某些数据结构比其他结构更适合并行流的拆分(Spliterator)。例如,ArrayList和数组由于其底层连续的内存布局,可以非常高效地被均等拆分。而LinkedList则不然,它需要遍历才能找到中间点,这使得并行化效率大打折扣。
再者,如果默认的ForkJoinPool无法满足你的需求,或者你希望隔离不同任务的并行执行,可以自定义ForkJoinPool。
// 创建一个自定义的ForkJoinPool
ForkJoinPool customThreadPool = new ForkJoinPool(Runtime.getRuntime().availableProcessors() * 2); // 示例:两倍核心数

try {
    // 在自定义线程池中执行并行流任务
    long sum = customThreadPool.submit(() ->
        IntStream.range(0, 1_000_000)
                 .parallel()
                 .mapToLong(i -> i)
                 .sum()
    ).get(); // get()会阻塞直到任务完成
    System.out.println("Custom pool sum: " + sum);
} catch (Exception e) {
    e.printStackTrace();
} finally {
    customThreadPool.shutdown(); // 关闭线程池
}最后,利用好并行流的短路操作。像anyMatch、allMatch、findFirst、findAny这些操作,一旦找到符合条件的结果,就可以立即停止处理后续元素,即使是在并行流中,这也能带来显著的性能提升。但要注意,findFirst在并行流中可能比findAny慢,因为它需要保证返回的是第一个匹配的元素,这会引入额外的同步开销。如果顺序不重要,findAny通常是更好的选择。
Cursor新增实时语音对话,支持在Agent运行任务时交流并听取进度,覆盖Agents Window、IDE、网页端与iOS,语音通话需登录账号并开启麦克风权限。
VS Code 1.145新增本地Cron调度,扩展远程Agent预览能力;后续1.145.1与1.145.2修正遥测归属和事件路由。文中区分正式、预览及实验性功能。
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
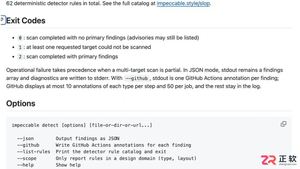
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
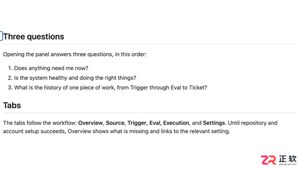
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
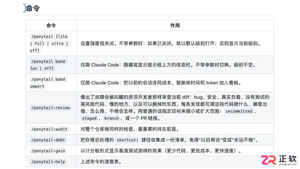
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
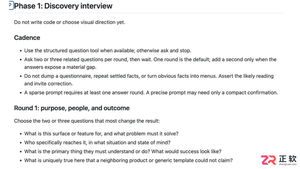
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
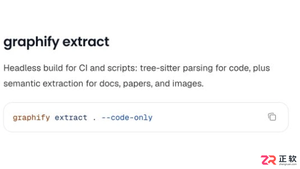
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
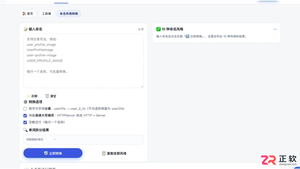
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
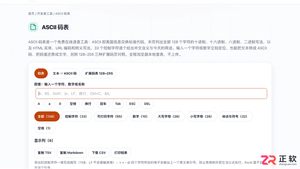
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



