

XPath提取无序列表为多维数组指南
本文档旨在指导开发者如何使用PHP的DOMDocument和DOMXPath类,将包含状态信息的HTML无序列表结构转换为结构化的多维数组。通过使用XPath查询和数据提取,可以将网页中类似物流跟踪信息的列表转换为易于处理的JSON格式数据,方便后续的数据分析和应用。

本文档旨在指导开发者如何使用 PHP 的 DOMDocument 和 DOMXPath 类,将包含状态信息的 HTML 无序列表结构转换为结构化的多维数组。通过使用 XPath 查询和数据提取,可以将网页中类似物流跟踪信息的列表转换为易于处理的 JSON 格式数据,方便后续的数据分析和应用。
准备工作
首先,确保你的 PHP 环境已经安装并启用了 DOMDocument 和 DOMXPath 扩展。这两个扩展通常是 PHP 默认安装的一部分,但如果遇到问题,可能需要手动启用。
代码实现
以下代码演示了如何将 HTML 字符串转换为多维数组,并最终输出为 JSON 格式。
preserveWhiteSpace = false;
    @$domd->loadHTML('' . $html, $flags);
    $removeAnnoyingWhitespaceTextNodes = function (\DOMNode $node) use (&$removeAnnoyingWhitespaceTextNodes): void {
        if ($node->hasChildNodes()) {
            for ($i = $node->childNodes->length - 1; $i >= 0; --$i) {
                $removeAnnoyingWhitespaceTextNodes($node->childNodes->item($i));
            }
        }
        if ($node->nodeType === XML_TEXT_NODE && !$node->hasChildNodes() && !$node->hasAttributes() && ! strlen(trim($node->textContent))) {
            $node->parentNode->removeChild($node);
        }
    };
    $removeAnnoyingWhitespaceTextNodes($domd);
    return $domd;
}

$html = <<
- Status: Objeto em trânsito - por favor aguarde
- Data : 24/10/2021 | Hora: 12:04
- Origem: Unidade de Tratamento - Jaboatao Dos Guararapes / PE
- Destino: Agência dos Correios - Cuitegi / PB
- Status: Objeto em trânsito - por favor aguarde
- Data : 19/10/2021 | Hora: 00:03
- Origem: Unidade de Logística Integrada - Curitiba / PR
- Destino: Unidade de Tratamento - Recife / PE
- Status: Fiscalização aduaneira finalizada
- Data : 18/10/2021 | Hora: 23:35
- Local: Unidade Operacional - Curitiba / PR
- Status: Objeto recebido pelos Correios do Brasil
- Data : 16/10/2021 | Hora: 11:45
- Local: Unidade de Logística Integrada - Curitiba / PR
- Status: Objeto postado
- Data : 14/10/2021 | Hora: 20:30
- Local: País - /
代码解释:
- 加载 HTML 并创建 DOMXPath 对象:
- 使用 DOMDocument 加载 HTML 字符串。
- 创建 DOMXPath 对象,用于执行 XPath 查询。
- 使用 loadHTML_noemptywhitespace 函数加载HTML,该函数可以移除HTML中的空白节点,避免干扰XPath查询结果。
- 使用 XPath 查询 ul 元素:
- $xp->query("//div[contains(@class,'singlepost')]/ul") 使用 XPath 表达式选择所有 class 包含 singlepost 的 div 元素下的所有 ul 元素。
- 循环遍历 ul 元素,提取数据:
- 外层 foreach 循环遍历每个 ul 元素。
- 内层 foreach 循环遍历每个 li 元素。
- explode(":",$li->nodeValue, 2) 使用冒号分割 li 元素的文本内容,得到键值对。
- trim() 函数用于去除键和值两端的空格。
- 格式化 JSON 输出:
- json_encode_pretty() 函数用于格式化 JSON 输出,使其更易读。
输出结果:
[
    {
        "Status": "Objeto em trânsito - por favor aguarde",
        "Data": "24/10/2021 | Hora: 12:04",
        "Origem": "Unidade de Tratamento - Jaboatao Dos Guararapes / PE",
        "Destino": "Agência dos Correios - Cuitegi / PB"
    },
    {
        "Status": "Objeto em trânsito - por favor aguarde",
        "Data": "19/10/2021 | Hora: 00:03",
        "Origem": "Unidade de Logística Integrada - Curitiba / PR",
        "Destino": "Unidade de Tratamento - Recife / PE"
    },
    {
        "Status": "Fiscalização aduaneira finalizada",
        "Data": "18/10/2021 | Hora: 23:35",
        "Local": "Unidade Operacional - Curitiba / PR"
    },
    {
        "Status": "Objeto recebido pelos Correios do Brasil",
        "Data": "16/10/2021 | Hora: 11:45",
        "Local": "Unidade de Logística Integrada - Curitiba / PR"
    },
    {
        "Status": "Objeto postado",
        "Data": "14/10/2021 | Hora: 20:30",
        "Local": "País -  /"
    }
]
注意事项
- HTML 结构: 此代码依赖于特定的 HTML 结构。如果 HTML 结构发生变化,XPath 表达式可能需要进行调整。
- 错误处理: 在实际应用中,应该添加适当的错误处理机制,例如检查 DOMDocument::loadHTML() 是否成功加载 HTML,以及 DOMXPath::query() 是否返回了预期的结果。
- 编码问题: 确保 HTML 字符串的编码与 PHP 脚本的编码一致,以避免出现乱码问题。通常建议使用 UTF-8 编码。
- XPath 表达式: 编写正确的 XPath 表达式是至关重要的。可以使用浏览器开发者工具或在线 XPath 测试工具来验证 XPath 表达式的正确性。
- 数据清洗: 在提取数据后,可能需要进行进一步的数据清洗,例如去除多余的空格、转换日期格式等。
总结
本文档提供了一个使用 PHP 的 DOMDocument 和 DOMXPath 类将 HTML 无序列表转换为多维数组的示例。通过使用 XPath 查询和数据提取,可以将网页中的结构化数据转换为易于处理的格式。在实际应用中,需要根据具体的 HTML 结构和需求进行适当的调整和优化。
遇到Git合并冲突别慌张,本文详解冲突产生的原因及标准处理流程,涵盖查看冲突文件、理解标记含义、手动修改代码及完成合并提交的完整步骤,助你高效解决协作开发中的代码冲突问题。
深入对比Java中获取当前时间戳的两种主流方式:System.currentTimeMillis与java.time.Instant。分析二者的精度差异、API设计、时钟回拨影响与实际选型建议。
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
深入解析Java常量命名标准、大写下划线语义规则,剖析接口常量反模式的危害与本质原因,并提供枚举、不可实例化常量工具类等工业级最佳替代方案。
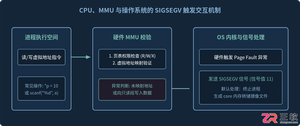
针对C语言常见的段错误(Segmentation fault)问题,详细剖析内存非法访问根因,提供结合GDB、Core Dump与AddressSanitizer的标准化排查解决步骤与预防方法。
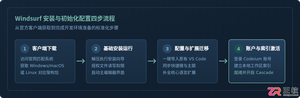
本文提供全面的Windsurf开发工具安装与使用详细教程,覆盖客户端下载安装、环境配置与VS Code插件迁移、Cascade核心协作中枢使用技巧、Chat与Write双模式实战及高效开发规范。

全面盘点Flutter主流状态管理框架,深度解析Provider、Riverpod、Bloc与GetX的核心机制、优缺点及适用场景,提供系统化的状态管理选型指南。
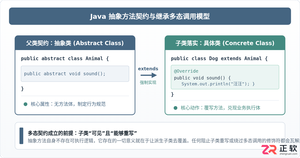
深入剖析Java中抽象方法为何严禁使用private和static修饰符。从面向对象契约规范、方法继承重写、JVM动态绑定(invokevirtual)与静态解析(invokestatic)等底层机制展开详细推导,结合编译报错示例与全景对比,彻底理清修饰符限制背后的设计逻辑。
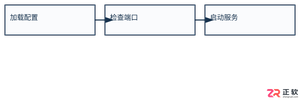
详细讲解uni-app中网络请求拦截的配置方法与实现路径,包含uni.addInterceptor原生API拦截与Promise二次封装方案、Token注入、全局错误处理及踩坑提醒。




IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


