

Python函数中如何使用for循环?入门教程
在Python函数中使用for循环是实现数据处理和逻辑封装的核心方式,1.可将for循环直接嵌入函数体内部以遍历传入的可迭代对象,如列表、元组、字典等;2.结合条件语句可实现筛选与累加等逻辑,提升代码复用性;3.需注意return语句位置,避免过早退出循环;4.循环内定义的变量为局部变量,函数外无法访问;5.避免在迭代过程中修改原列表,应使用副本或新建列表;6.嵌套循环需谨慎使用以防性能下降;7.可结合列表推导式、生成器表达式、enumerate、zip等高级特性使代码更简洁高效;8.在循环中应使用try
在Python函数中使用for循环是实现数据处理和逻辑封装的核心方式,1. 可将for循环直接嵌入函数体内部以遍历传入的可迭代对象,如列表、元组、字典等;2. 结合条件语句可实现筛选与累加等逻辑,提升代码复用性;3. 需注意return语句位置,避免过早退出循环;4. 循环内定义的变量为局部变量,函数外无法访问;5. 避免在迭代过程中修改原列表,应使用副本或新建列表;6. 嵌套循环需谨慎使用以防性能下降;7. 可结合列表推导式、生成器表达式、enumerate、zip等高级特性使代码更简洁高效;8. 在循环中应使用try-except处理可能的异常以增强健壮性。通过合理运用这些方法,可显著提升代码的模块化、可读性和可维护性,最终实现高效且优雅的程序设计。
在Python里,函数中使用for循环是再自然不过的事情了,它几乎是数据处理和逻辑封装的核心模式之一。简单来说,你可以在任何需要迭代的地方——无论是处理传入的列表、元组,还是生成一系列数字,甚至是遍历字典的键值对——把for循环放在函数体内部。这不仅让你的代码更模块化,也更容易复用和理解。
解决方案
要在Python函数中使用for循环,你只需像在函数外部使用它一样,将循环结构放置在函数定义体内部即可。函数会按照其执行流程遇到for循环时,开始迭代操作。
一个最基础的例子,假设我们想写一个函数来打印一个列表中所有的元素:
def print_list_items(items):
    """
    遍历并打印传入列表中每个元素的函数。
    """
    print("开始打印列表内容:")
    for item in items:
        print(item)
    print("列表打印完毕。")

# 调用函数
my_data = [1, 2, 3, "hello", "world"]
print_list_items(my_data)

another_data = ["apple", "banana", "cherry"]
print_list_items(another_data)这个例子展示了最直接的应用。for item in items: 这行代码就在print_list_items函数的内部,它会遍历items这个参数(一个列表),并对每个item执行print(item)操作。你可以把任何可迭代的对象传给items,比如字符串、元组、集合,甚至生成器。
再比如,我们想计算一个数字列表中所有偶数的和:
def sum_even_numbers(numbers):
    """
    计算并返回列表中所有偶数的和。
    """
    total_even = 0
    for num in numbers:
        if num % 2 == 0:  # 检查是否为偶数
            total_even += num
    return total_even

# 测试函数
nums1 = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
print(f"列表 {nums1} 中偶数的和是: {sum_even_numbers(nums1)}") # 输出:30

nums2 = [1, 3, 5, 7]
print(f"列表 {nums2} 中偶数的和是: {sum_even_numbers(nums2)}") # 输出:0这里,for循环和if条件判断结合,在函数内部实现了一个筛选和累加的逻辑。函数的好处在于,这个sum_even_numbers的逻辑可以被反复调用,而不需要每次都重新写一遍循环代码。
函数内部使用 for 循环:提升代码复用与模块化
我们为什么偏偏要把for循环塞到函数里呢?从我个人的经验来看,这不光是代码规范的问题,更是提升开发效率和代码质量的关键。想象一下,如果你有十个地方需要对列表进行相同的处理,每次都复制粘贴一段for循环代码,那简直是灾难。一旦逻辑需要调整,你得改十次,还容易漏掉。
把循环封装进函数,最直观的好处就是复用性。你写好一个函数,比如上面那个sum_even_numbers,它就像一个黑箱子,你扔进去一个数字列表,它就吐出偶数的和。以后不管哪个模块、哪个场景需要这个功能,直接调用就行,不需要关心内部是怎么实现的。这大大减少了重复代码,让你的项目变得“干爽”许多。
其次是模块化。函数把一段特定的功能逻辑打包起来,每个函数负责一小块工作。这让代码结构更清晰,每个部分各司其职。当你的程序变得庞大时,这种模块化的设计能让你更容易理解代码的结构,也更容易定位问题。比如,如果计算偶数和出了错,我直接去看sum_even_numbers这个函数就行,不用在整个代码库里大海捞针。
再有就是抽象。用户调用函数时,只需要知道函数的功能和参数,而不需要知道其内部的具体实现细节,比如它用了for循环还是while循环,或者用了什么奇特的算法。这让代码更易于维护和升级,你可以随时优化函数内部的实现,只要不改变函数的输入输出,外部调用者就无感知。
所以,把for循环放在函数里,不仅仅是语法上的可行,更是工程实践中一种深思熟虑的选择,它让我们的代码更有生命力,更容易被管理和扩展。
在函数内使用 for 循环的注意事项与常见陷阱
虽然在函数里用for循环是基本操作,但有些小细节,如果不注意,可能会让你头疼一阵。
一个常见的点是return语句的位置。如果在for循环内部遇到return,函数会立即终止,并返回指定的值。这在某些情况下非常有用,比如你要在一个列表中查找第一个符合条件的元素,一旦找到就没必要继续遍历了:
def find_first_even(numbers):
    for num in numbers:
        if num % 2 == 0:
            return num # 找到第一个偶数就立即返回
    return None # 如果循环结束都没找到,就返回 None

print(f"第一个偶数是: {find_first_even([1, 3, 5, 2, 4])}") # 输出:2
print(f"第一个偶数是: {find_first_even([1, 3, 5])}")     # 输出:None
但如果你不小心把一个本应在循环结束后才返回的值放在了循环内部,结果可能就不是你想要的了。
另一个需要留意的是变量作用域。在函数内部定义的变量,包括在for循环内部定义的变量,默认情况下是局部变量。它们只在函数执行期间存在,函数执行完毕后就会被销毁。这意味着你不能在函数外部直接访问函数内部循环定义的变量。
def process_data(data):
    processed_item = None # 这是一个局部变量
    for item in data:
        processed_item = item.upper() # 每次循环都会更新它
    # 循环结束后,processed_item 仍然在函数作用域内
    print(f"函数内部:最后处理的项是 {processed_item}")

process_data(["apple", "banana"])
# print(processed_item) # 这行会报错,因为 processed_item 不在全局作用域还有,在迭代过程中修改你正在迭代的集合,通常是个坏主意。比如,你正在遍历一个列表,同时又在循环内部删除或添加元素,这可能会导致意想不到的行为,比如跳过元素或无限循环。如果确实需要修改,通常的做法是迭代一个副本,或者创建一个新的列表来存储结果。
# 错误示范:在循环中修改列表
# def remove_long_words(words):
#     for word in words:
#         if len(word) > 5:
#             words.remove(word) # 这可能导致问题!

# 正确做法:构建新列表或迭代副本
def filter_short_words(words):
    result = []
    for word in words:
        if len(word) <= 5:
            result.append(word)
    return result

my_words = ["apple", "banana", "cat", "dog", "elephant"]
filtered = filter_short_words(my_words)
print(f"过滤后的单词: {filtered}") # 输出:['apple', 'cat', 'dog']最后,对于嵌套循环,虽然功能强大,但也要小心使用。当一个for循环嵌套在另一个for循环内部时,内部循环会对外层循环的每一次迭代都完整执行一遍。这意味着如果你的列表很大,嵌套循环的性能开销会迅速增加。在处理大量数据时,需要仔细考虑算法效率。
超越基础:函数内 for 循环的高级应用与模式
掌握了在函数里用for循环的基本姿势和注意事项,我们其实可以玩出更多花样,让代码更Pythonic,也更高效。这不仅仅是写出能跑的代码,更是写出优雅、可维护的代码。
一个非常典型的模式是结合列表推导式(List Comprehensions)或生成器表达式(Generator Expressions)。它们提供了一种更简洁、更“声明式”的方式来创建列表或生成序列,而不需要显式地写出for循环。在函数内部,这能让你的代码看起来更紧凑,也往往更高效。
def get_squares(numbers):
    # 使用列表推导式,一行代码完成循环和操作
    return [num * num for num in numbers]

print(f"平方数列表: {get_squares([1, 2, 3, 4])}") # 输出:[1, 4, 9, 16]

def generate_even_numbers(max_num):
    # 使用生成器表达式,按需生成偶数,节省内存
    return (num for num in range(max_num + 1) if num % 2 == 0)

# 调用时,它返回一个生成器对象,需要迭代才能获取值
even_gen = generate_even_numbers(10)
print(f"生成的偶数: {list(even_gen)}") # 输出:[0, 2, 4, 6, 8, 10]另一个常用的技巧是结合enumerate()函数。当你在循环中需要同时访问元素及其索引时,enumerate就显得非常方便,它让代码更清晰,避免了手动维护索引变量的麻烦。
def process_with_index(data_list):
    for index, value in enumerate(data_list):
        print(f"索引 {index}: 值为 {value}")

process_with_index(["A", "B", "C"])当你有两个或更多列表需要并行迭代时,zip()函数就派上用场了。它能把多个可迭代对象“打包”在一起,让你在for循环中同时处理它们对应的元素。
def combine_names_scores(names, scores):
    combined_data = []
    for name, score in zip(names, scores):
        combined_data.append(f"{name} 的分数是 {score}")
    return combined_data

student_names = ["Alice", "Bob", "Charlie"]
student_scores = [90, 85, 92]
print(f"组合数据: {combine_names_scores(student_names, student_scores)}")最后,别忘了错误处理。在for循环内部,你可能会遇到各种异常,比如尝试访问不存在的字典键,或者对非数字类型进行数学运算。这时,try-except块就能派上用场,它能让你的循环在遇到错误时,不是直接崩溃,而是优雅地处理异常,或者跳过有问题的项。
def safe_divide_elements(numbers, divisor):
    results = []
    for num in numbers:
        try:
            results.append(num / divisor)
        except ZeroDivisionError:
            print(f"警告:尝试除以零,跳过数字 {num}")
            results.append(float('nan')) # 或者其他标记
        except TypeError:
            print(f"警告:类型错误,无法处理 {num}")
            results.append(None)
    return results

data_to_process = [10, 5, "hello", 0, 20]
print(f"安全除法结果: {safe_divide_elements(data_to_process, 2)}")
print(f"安全除法(除以零)结果: {safe_divide_elements(data_to_process, 0)}")这些模式和技巧,都是在函数内部运用for循环时,能够让你的代码更健壮、更高效、更具可读性的实际手段。理解并灵活运用它们,能让你在Python的编程之路上走得更远。
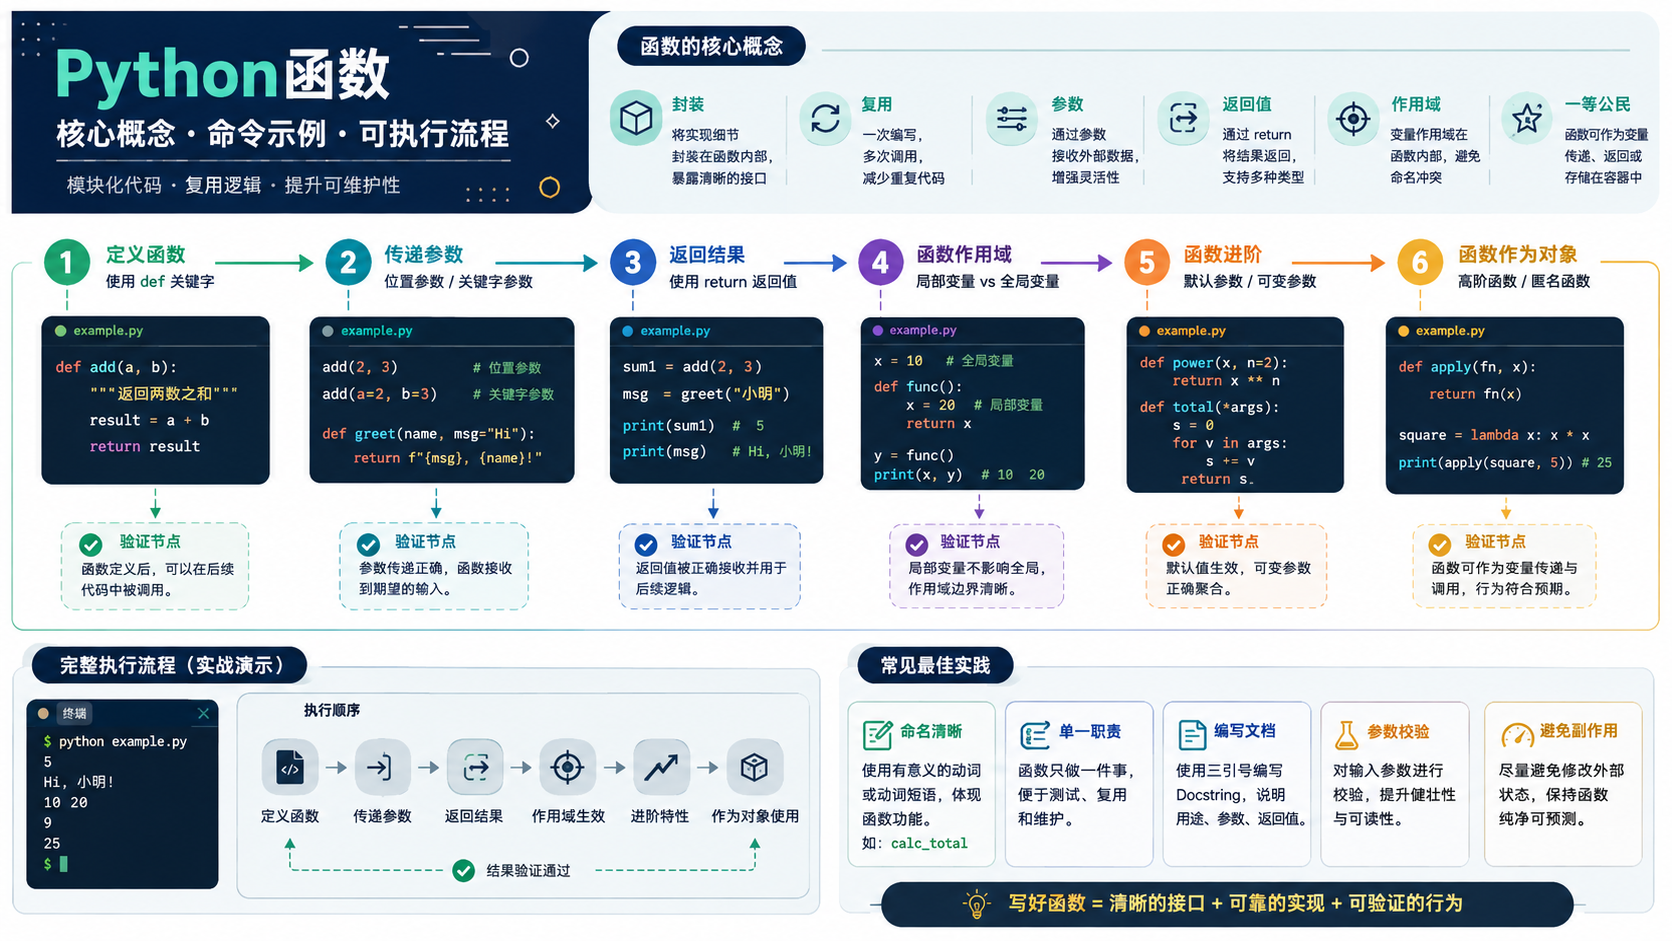
本文详解 python函数 的开发准备与实操流程,涵盖虚拟环境创建、依赖安装及系统验证,附带决策图辅助排错,帮助开发者构建稳定的Python运行环境。
是的,Python函数可以动态添加属性,1.可用于存储元数据、缓存或状态标记;2.操作方式为通过点语法直接赋值;3.常见于装饰器、框架设计中;4.需避免命名冲突、注意可读性与类型检查;5.最佳实践包括使用functools.wraps、明确用途并加强文档化,此机制体现了Python“一切皆对象”的设计哲学且应谨慎合理使用。
Python函数命名冲突的常见场景包括:导入多个模块时同名函数被覆盖、同一作用域内重复定义函数、与内置函数或标准库函数重名、以及大型项目中因缺乏统一规划导致的无意识命名重复。最典型的例子是使用frommoduleimport*或连续导入两个同名函数,后导入的会静默覆盖前者;在同一文件中定义两个同名函数也会导致后者覆盖前者而不报错;将自定义函数命名为len、sum等内置函数名会破坏原有功能;在大型项目中不同模块各自定义同名函数如parse_data,若未通过模块路径区分调用,极易引发逻辑错误。这些问题的核心
Python函数可通过闭包保存内部状态,核心在于嵌套函数引用并捕获外部函数的局部变量,即使外部函数已执行完毕,这些变量仍被保留。闭包需满足三个条件:函数嵌套、内部函数引用外部非全局变量、外部函数返回内部函数。与普通嵌套函数不同,闭包在外部函数结束后仍可访问其作用域中的变量,形成“持久化”状态。典型应用包括装饰器、工厂函数(如生成不同乘法器)、回调函数等,能实现轻量级状态封装。但需注意循环中变量延迟绑定问题(如for循环中i始终为最终值),可通过默认参数或立即调用外层函数解决;同时避免闭包捕获大对象导致内存
是的,Python函数可以通过类型提示指定返回值类型,从而提升代码可读性、可维护性,并支持静态类型检查工具如mypy进行类型验证。1.使用->符号在函数参数列表后标注返回值类型,例如defgreet(name:str)->str:returnf"Hello,{name}!";2.对于无返回值的函数,可标注为->None;3.复杂返回类型可用typing.Union[str,int,None]或Python3.10+的str|int|None表示联合类型;4.生成器函数应使用typing.
使用布尔值时应直接在if语句中判断,避免与True比较;2.采用描述性函数名提升可读性;3.利用any()和all()简化多条件判断;4.使用not增强逻辑清晰度;5.将复杂逻辑拆分为多个小函数并用逻辑运算符合并结果;6.避免嵌套过深,通过提前返回减少层级;7.编写单元测试覆盖各种输入及边界情况;8.使用mock隔离外部依赖确保测试独立性;9.保持测试用例独立且完整,确保布尔函数的可靠性与可维护性。
递归遍历嵌套列表的核心是函数调用自身处理子元素,直至遇到非列表元素并收集结果。代码通过isinstance判断元素类型,若为列表则递归遍历,否则收集数据。该方法结构清晰、逻辑直观,尤其适合深度不确定的嵌套结构。相比迭代,递归代码更简洁、易读,能自然映射树状数据结构,但存在栈溢出风险,尤其在嵌套过深时受Python默认递归深度限制。此外,递归函数调用开销较大,性能略逊于迭代,调试也较复杂。为收集特定数据,可让函数返回结果列表并逐层合并,或使用全局变量累积。迭代方案通过显式栈模拟遍历过程,虽代码稍复杂,但无深
凯撒密码通过固定位移实现加密,仅处理英文字母,非字母字符保留不变;2.XOR加密利用异或运算的可逆性,同一函数和密钥可完成加解密;3.这些方法适用于非敏感数据混淆,如配置文件或游戏存档,但不具备抗攻击能力;4.解密凯撒密码需反向位移,XOR则直接复用加密函数与密钥;5.简单加密不应用于敏感信息保护,应使用专业加密库如cryptography。
Python函数处理字符串的核心是封装常用操作,如大小写转换、去空格、替换等,通过定义函数调用内置方法(如.lower()、.strip()、.replace())实现代码复用与模块化,提升可读性和维护性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



