

高精度低成本游戏3D人脸重建方案,腾讯AI Lab ICCV 2023论文解读
3D人脸重建是一项广泛应用于游戏影视制作、数字人、AR/VR、人脸识别和编辑等领域的关键技术,其目标是从单张或多张图像中获取高质量的3D人脸模型。借助摄影棚中的复杂拍摄系统,当前业界成熟方案已可得到媲美真人的毛孔级精度的重建效果[2],但其制作成本高、周期长,一般仅用于S级影视或游戏项目。近年,基于低成本人脸重建技术的交互玩法(如游戏角色捏脸玩法、AR/VR虚拟形象生成等)受到市场欢迎。用户只需输入日常可获取的图片,如手机拍摄的单张或多张图片,即可快速得到3D模型。但现有方法成像质量不可控,重建结果精度较
3D 人脸重建是一项广泛应用于游戏影视制作、数字人、AR/VR、人脸识别和编辑等领域的关键技术,其目标是从单张或多张图像中获取高质量的 3D 人脸模型。借助摄影棚中的复杂拍摄系统,当前业界成熟方案已可得到媲美真人的毛孔级精度的重建效果 [2],但其制作成本高、周期长,一般仅用于 S 级影视或游戏项目。
近年,基于低成本人脸重建技术的交互玩法(如游戏角色捏脸玩法、AR/VR 虚拟形象生成等)受到市场欢迎。用户只需输入日常可获取的图片,如手机拍摄的单张或多张图片,即可快速得到 3D 模型。但现有方法成像质量不可控,重建结果精度较低,无法表达人脸细节 [3-4]。如何在低成本条件下得到高保真 3D 人脸,仍是一个未解的难题。
人脸重建的第一步是定义人脸表达方式,但现有主流的人脸参数化模型表达能力有限,即使有更多约束信息,如多视角图片,重建精度也难以提升。因此,腾讯 AI Lab 提出了一种改进的自适应骨骼 - 蒙皮模型(Adaptive Skinning Model,以下简称 ASM)作为参数化人脸模型使用,利用人脸先验,以高斯混合模型来表达人脸蒙皮权重,极大降低参数量使其可自动求解。
测试表明,ASM 方法在不需要训练的前提下仅使用少量的参数,即显著提升了人脸的表达能力及多视角人脸重建精度,创新了 SOTA 水平。相关论文已被 ICCV-2023 接收,以下为论文详细解读。
论文题目:ASM: Adaptive Skinning Model for High-Quality 3D Face Modeling
论文链接:https://arxiv.org/pdf/2304.09423.pdf
研究挑战:低成本、高精度的 3D 人脸重建难题
从 2D 图像得到信息量更大的 3D 模型,属于欠定问题存在无穷多解。为了使其可解,研究者将人脸先验引入重建,降低求解难度的同时能以更少的参数来表达人脸 3D 形状,即参数化人脸模型。当前大部分参数化人脸模型都是基于 3D Morphable Model (3DMM) 及其改进版,3DMM 是 Blanz 和 Vetter 在 1999 年首次提出的参数化人脸模型 [5]。文章假设一张人脸可以通过多个不同的人脸线性或非线性组合得到,通过收集数百个真实人脸的高精度 3D 模型构建人脸基底库,进而组合参数化人脸来表达新的人脸模型。后续研究通过收集更多样的真实人脸模型 [6, 7],以及改进降维方法来优化 3DMM [8, 9]。
然而,3DMM 类人脸模型的鲁棒性高但表达能力不足。尽管他能够在输入图像模糊或有遮挡的情况下稳定地生成精度一般的人脸模型,但当使用多张高质量图像作为输入时,3DMM 表达能力有限,不能利用上更多的输入信息,因此限制了重建精度。这种限制源于两方面,一是方法本身的局限性,二是该方法依赖于人脸模型数据的收集,不仅数据获取成本高,且因人脸数据的敏感性,在实际应用中也难以广泛复用。
ASM 方法:重新设计骨骼 - 蒙皮模型
为了解决现有 3DMM 人脸模型表达能力不足的问题,本文引入了游戏业界常用的 “骨骼 - 蒙皮模型” 作为基准人脸表达方式。骨骼 - 蒙皮模型是游戏与动画制作过程中表达游戏人物角色脸型与表情的一种常见的人脸建模方式。它通过虚拟的骨骼点与人脸上的 Mesh 顶点相连,由蒙皮权重决定骨骼对 Mesh 顶点的影响权重,使用时只需要控制骨骼的运动即可间接控制 Mesh 顶点的运动。
通常情况下,骨骼 - 蒙皮模型需要动画师进行精确的骨骼放置与蒙皮权重绘制,具有高制作门槛与长制作周期的特点。但是现实的人脸中不同的人骨骼与肌肉的形状具有较大差异,一套固定的骨骼 - 蒙皮系统难以表达现实中多种多样的脸型,为此,本文在现有的骨骼 - 蒙皮基础上进行进一步设计,提出了自适应骨骼 - 蒙皮模型 ASM,基于高斯混合蒙皮权重(GMM Skinning Weights)与动态骨骼绑定系统(Dynamic Bone Binding)进一步提高了骨骼 - 蒙皮的表达能力与灵活度,为每一个目标人脸自适应生成独有的骨骼 - 蒙皮模型,以表达更为丰富的人脸细节。
为了提高骨骼 - 蒙皮模型对于建模不同人脸时的表达能力,ASM 对骨骼 - 蒙皮模型的建模方式进行了全新的设计。
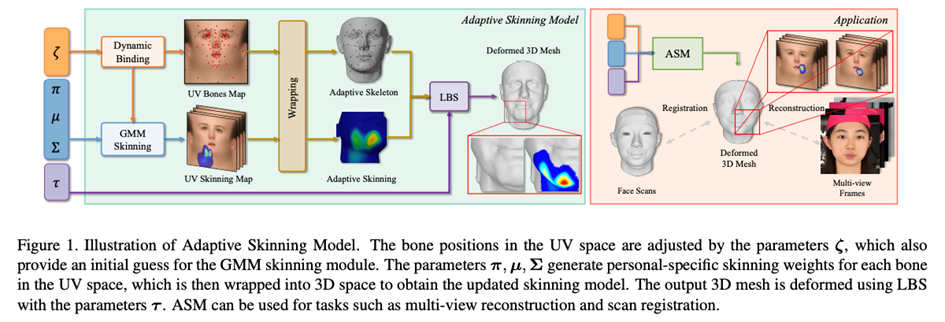
图 1:ASM 整体框架
骨骼 - 蒙皮系统通常基于线性混合蒙皮(Linear Blend Skinning, LBS)算法,通过控制骨骼的运动(旋转、平移、缩放)来控制 Mesh 顶点的变形。传统的骨骼 - 蒙皮包含两个部分,即蒙皮权重矩阵与骨骼绑定,ASM 对这两部分分别进行了参数化,以实现自适应的骨骼 - 蒙皮模型。接下来会分别介绍蒙皮权重矩阵与骨骼绑定的参数化建模方法。
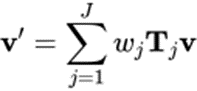
公式 1:传统骨骼 - 蒙皮模型的 LBS 公式
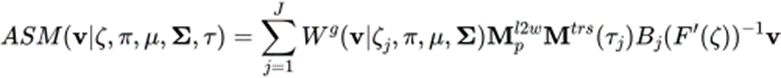
公式 2:ASM 的 LBS 公式
高斯混合蒙皮权重(GMM Skinning Weights)
蒙皮权重矩阵是一个 mxn 维的矩阵,其中 m 为骨骼数量,n 为 Mesh 上的顶点数量,该矩阵用于存放每一根骨骼对每一个 Mesh 顶点的影响系数。一般来说蒙皮权重矩阵是高度稀疏的,例如在 Unity 中,每个 Mesh 顶点只会被最多 4 根骨骼影响,除了这 4 根骨骼外,其余骨骼对该顶点的影响系数为 0。传统的骨骼 - 蒙皮模型中蒙皮权重由动画师绘制得到,并且蒙皮权重一旦得到,在使用时将不再发生改变。近年来有工作 [1] 尝试结合大量数据与神经网络学习如何自动生成蒙皮权重,但这样的方案有两个问题,一是训练神经网络需要较大量的数据,如果是 3D 人脸或者蒙皮权重的数据则更难获得;二是使用神经网络建模蒙皮权重存在较为严重的参数冗余。是否存在一种蒙皮权重的建模方式,在不需要训练的前提下使用少量的参数即可完整表达整张人脸的蒙皮权重呢?
通过观察常见的蒙皮权重可发现以下性质:1. 蒙皮权重局部光滑;2. 离当前骨骼位置越远的 Mesh 顶点,对应的蒙皮系数通常也越小;而这样的性质与高斯混合模型(GMM)非常吻合。于是本文提出了高斯混合蒙皮权重(GMM Skinning Weights)将蒙皮权重矩阵建模为基于顶点与骨骼某个距离函数的高斯混合函数,这样就能使用一组 GMM 系数表达特定骨骼的蒙皮权重分布。为了进一步压缩蒙皮权重的参数量,我们将整个人脸 Mesh 从三维空间转移到 UV 空间,从而只需要使用二维 GMM 并且使用顶点到骨骼的 UV 距离就能计算出当前骨骼对特定顶点的蒙皮权重系数。
动态骨骼绑定(Dynamic Bone Binding)
对蒙皮权重进行参数化建模不仅使我们能用少量参数表达蒙皮权重矩阵,还使我们在运行时(Run-Time)调整骨骼绑定位置成为了可能,由此,本文提出了动态骨骼绑定(Dynamic Bone Binding)的方法。与蒙皮权重相同,本文将骨骼的绑定位置建模为 UV 空间上的一个坐标点,并且能够在 UV 空间中任意移动。对于人脸 Mesh 的顶点,能够通过很简单地通过预定义好的 UV 映射关系将顶点映射为 UV 空间上的一个固定坐标。但是骨骼并没有预先定义在 UV 空间中,为此我们需要将绑定的骨骼从三维空间转移到 UV 空间上。本文中这个步骤通过对骨骼与周围顶点进行坐标插值实现,我们将计算得到的插值系数应用在顶点的 UV 坐标上,就能获得骨骼的 UV 坐标。反过来也一样,当需要将骨骼坐标从 UV 空间转移到三维空间时,我们同样计算当前骨骼的 UV 坐标与临近顶点的 UV 坐标的插值系数,并将该插值系数应用到三维空间中同样的顶点三维坐标上,即可插值出对应骨骼的三维空间坐标。
通过这种建模方式,我们将骨骼的绑定位置与蒙皮权重系数都统一为了 UV 空间中的一组系数。当使用 ASM 时,我们将人脸 Mesh 顶点的形变转变为求解 UV 空间中骨骼绑定位置的偏移系数、UV 空间中的高斯混合蒙皮系数与骨骼运动系数三者的组合,极大地提高了骨骼 - 蒙皮模型的表达能力,实现更为丰富的人脸细节的生成。
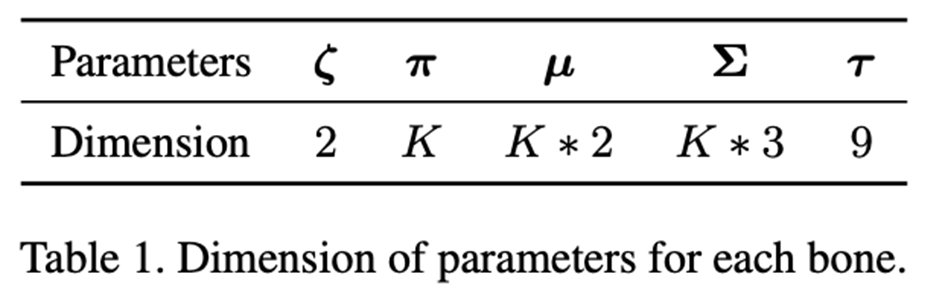
表 1:ASM 每根骨骼的参数维度
研究结果:人脸表达能力与多视角重建精度达到 SOTA 水平
对比不同参数化人脸模型的表达能力
我们使用参数化人脸模型注册高精度人脸扫描模型的方式(Registration),将 ASM 与传统的基于 PCA 方法的 3DMM(BFM [6],FLAME [7],FaceScape [10])、基于神经网络降维方法的 3DMM(CoMA [8], ImFace [9])以及业界前沿的骨骼 - 蒙皮模型(MetaHuman)进行了对比。结果指出,ASM 在 LYHM 与 FaceScape 两个数据集上的表达能力均达到了 SOTA 水平。
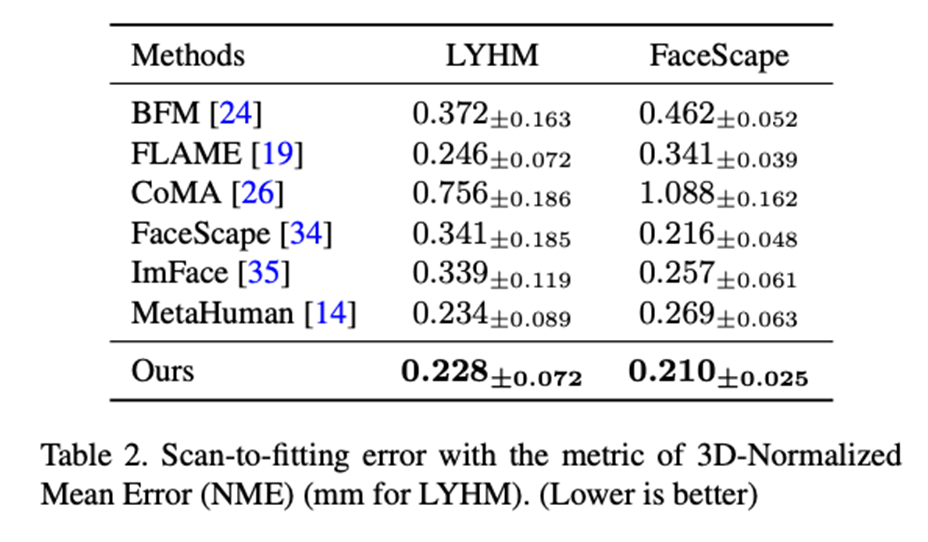
表 2:LYHM 与 FaceScape 的 registration 精度
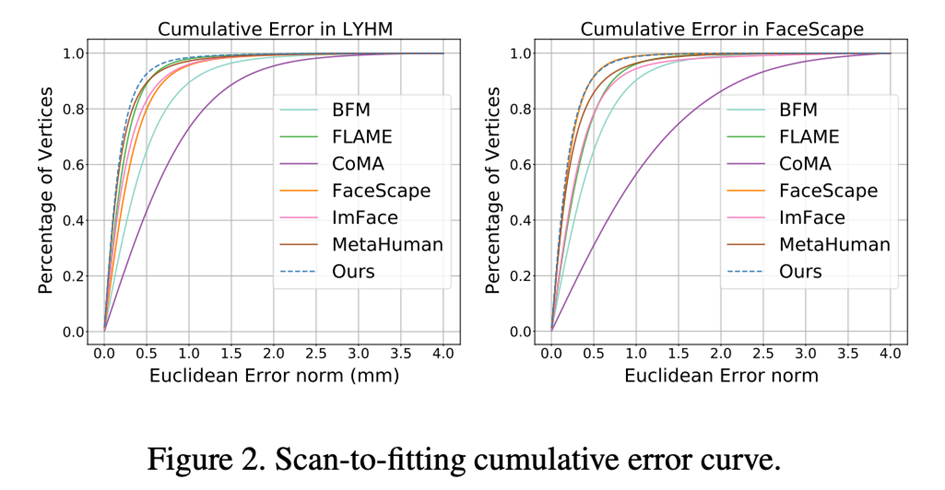
图 2:LYHM 与 FaceScape 上 registration 精度的误差分布
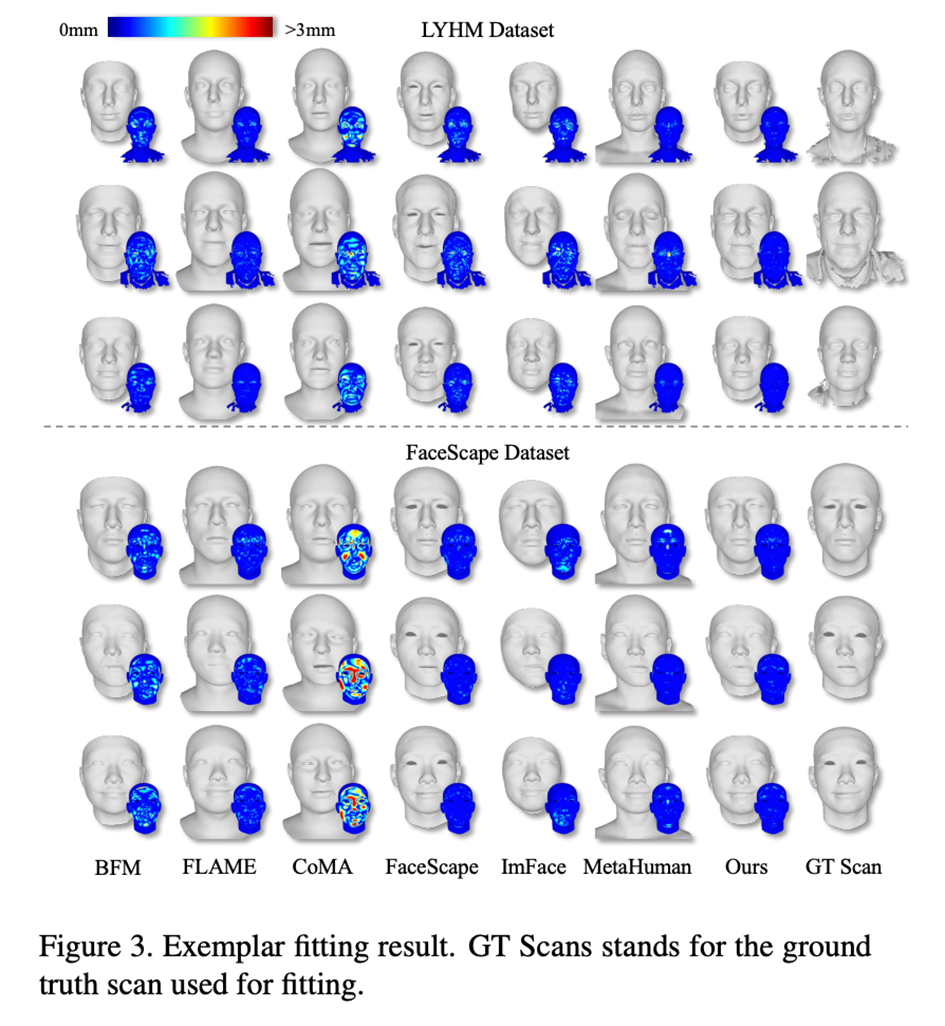
图 3:LYHM 与 FaceScape 上 registration 的可视化结果与误差热力图
多视角人脸重建中的应用
我们使用了 Florence MICC 的数据集测试了 ASM 在多视角人脸重建任务上的表现,在 Coop(室内近距离摄像头,人物无表情)测试集上的重建精度达到了 SOTA 水平。
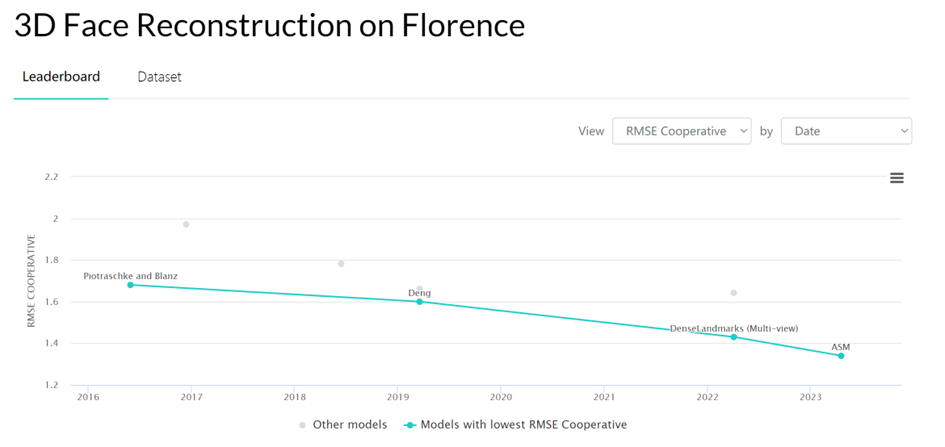
图 4:Florence MICC 数据集上的 3D 人脸重建结果
我们还在 FaceScape 数据集上测试了多视角重建任务中图片数量对重建结果的影响,结果可以看到当图片数量在 5 张左右时 ASM 相比其他的人脸表达方式能够实现最高的重建精度。
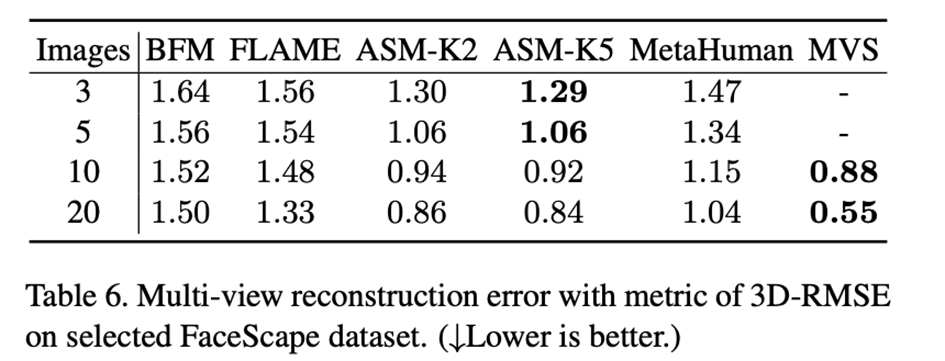
表 3:FaceScape 上不同输入数量的多视角重建结果精度
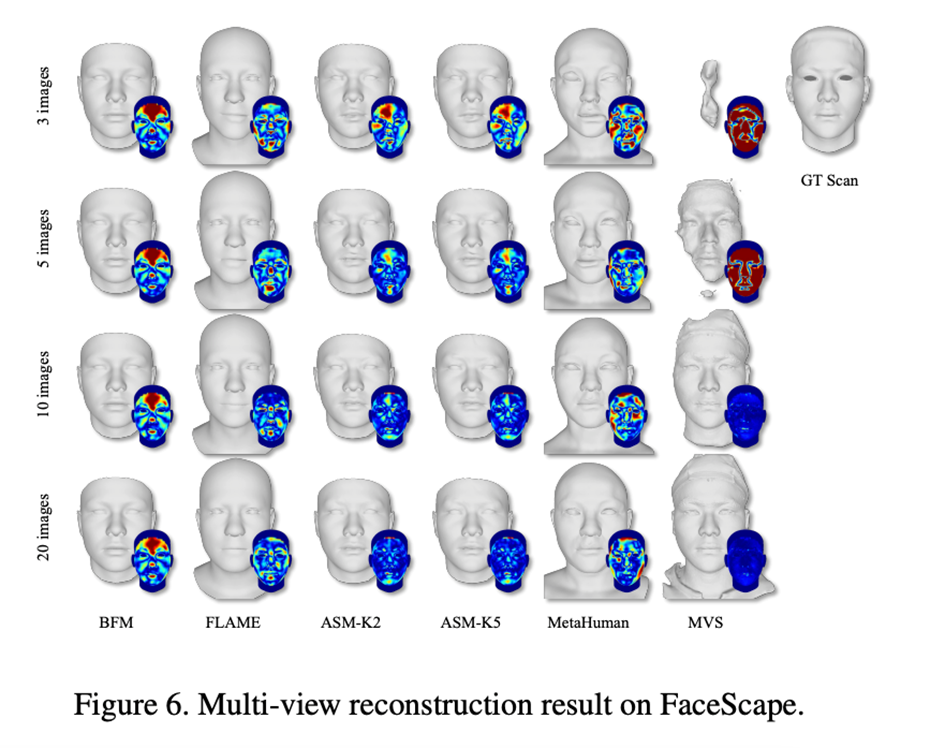
图 5:FaceScape 上不同输入数量的多视角重建可视化结果与误差热力图
总结及展望
在低成本条件下获得高保真人脸这一行业难题上,本研究迈出了重要一步。我们提出的新参数化人脸模型显著增强了人脸表达能力,将多视角人脸重建的精度上限提升到了新的高度。该方法可用于游戏制作中的 3D 角色建模、自动捏脸玩法,以及 AR/VR 中的虚拟形象生成等众多领域。
在人脸表达能力得到显著提升之后,如何从多视角图片中构建更强的一致性约束,以进一步提高重建结果的精度,成为了当前人脸重建领域的新瓶颈、新挑战。这也将是我们未来的研究方向。
参考文献
[1] Noranart Vesdapunt, Mitch Rundle, HsiangTao Wu, and Baoyuan Wang. Jnr: Joint-based neural rig representation for compact 3d face modeling. In Computer Vision–ECCV 2020: 16th European Conference, Glasgow, UK, August 23–28, 2020, Proceedings, Part XVIII 16, pages 389–405. Springer, 2020.
[2] Thabo Beeler, Bernd Bickel, Paul Beardsley, Bob Sumner, and Markus Gross. High-quality single-shot capture of facial geometry. In ACM SIGGRAPH 2010 papers, pages 1–9. 2010.
[3] Yu Deng, Jiaolong Yang, Sicheng Xu, Dong Chen, Yunde Jia, and Xin Tong. Accurate 3d face reconstruction with weakly-supervised learning: From single image to image set. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition workshops, pages 0–0, 2019.
[4] Yao Feng, Haiwen Feng, Michael J Black, and Timo Bolkart. Learning an animatable detailed 3d face model from in-the-wild images. ACM Transactions on Graphics (ToG), 40 (4):1–13, 2021.
[5] Volker Blanz and Thomas Vetter. A morphable model for the synthesis of 3d faces. In Proceedings of the 26th annual conference on Computer graphics and interactive techniques, pages 187–194, 1999.
[6] Pascal Paysan, Reinhard Knothe, Brian Amberg, Sami Romdhani, and Thomas Vetter. A 3d face model for pose and illumination invariant face recognition. In 2009 sixth IEEE international conference on advanced video and signal based surveillance, pages 296–301. Ieee, 2009.
[7] Tianye Li, Timo Bolkart, Michael J Black, Hao Li, and Javier Romero. Learning a model of facial shape and expression from 4d scans. ACM Trans. Graph., 36 (6):194–1, 2017.
[8] Anurag Ranjan, Timo Bolkart, Soubhik Sanyal, and Michael J Black. Generating 3d faces using convolutional mesh autoencoders. In Proceedings of the European conference on computer vision (ECCV), pages 704–720, 2018.
[9] Mingwu Zheng, Hongyu Yang, Di Huang, and Liming Chen. Imface: A nonlinear 3d morphable face model with implicit neural representations. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 20343–20352, 2022.
[10] Haotian Yang, Hao Zhu, Yanru Wang, Mingkai Huang, Qiu Shen, Ruigang Yang, and Xun Cao. Facescape: a large-scale high quality 3d face dataset and detailed riggable 3d face prediction. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 601–610, 2020.
伴随大模型迭代速度越来越快,训练集群规模越来越大,高频率的软硬件故障已经成为阻碍训练效率进一步提高的痛点,检查点(Checkpoint)系统在训练过程中负责状态的存储和恢复,已经成为克服训练故障、保障训练进度和提高训练效率的关键。近日,字节跳动豆包大模型团队与香港大学联合提出了ByteCheckpoint。这是一个PyTorch原生,兼容多个训练框架,支持Checkpoint的高效读写和自动重新切分的大模型Checkpointing系统,相比现有方法有显著性能提升和易用性优势。本文介绍了大模型训练提效中C

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文第一作者杜超群是清华大学自动化系2020级直博生。导师为黄高副教授。此前于清华大学物理系获理学学士学位。研究兴趣为不同数据分布上的模型泛化和鲁棒性研究,如长尾学习,半监督学习,迁移

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者是来自OpenSearch中国研发团队的机器学习负责人杨扬博士以及机器学习工程师耿志超和管聪。OpenSearch是一个由亚马逊云科技发起的纯开源搜索和实时分析引擎项目。目前软件

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com皮仁杰:香港科技大学博士三年级学生,师从张潼教授和周晓方教授。于2024年获得苹果奖学金。目前主要研究方向是多模态大语言模型和数据为中心的AI。张鉴殊:武汉大学本科三年级学生,目前在张潼
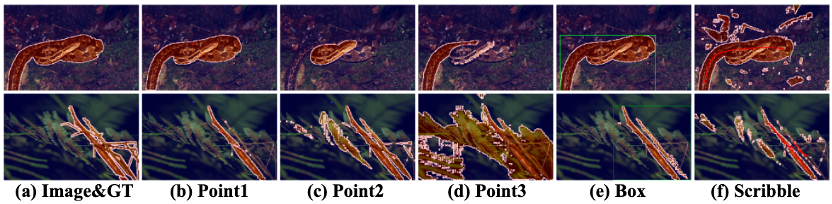
仅需一个任务描述,即可一键分割所有图片!SegmentationAnythingModel(SAM)的提出在图像分割领域引起了巨大的关注,其卓越的泛化性能引发了广泛的兴趣。然而,尽管如此,SAM仍面临一个无法回避的问题:为了使SAM能够准确地分割出目标物体的位置,每张图片都需要手动提供一个独特的视觉提示。如下图所示,即使点击的是同一物体(图(b)-(d)),微小位置变化都会导致分割结果的显著差异。这是因为视觉提示语义信息的缺乏,即使提供了想要分割的目标物体上,仍然可能引发歧义。框提示和涂鸦提示(图(e)(
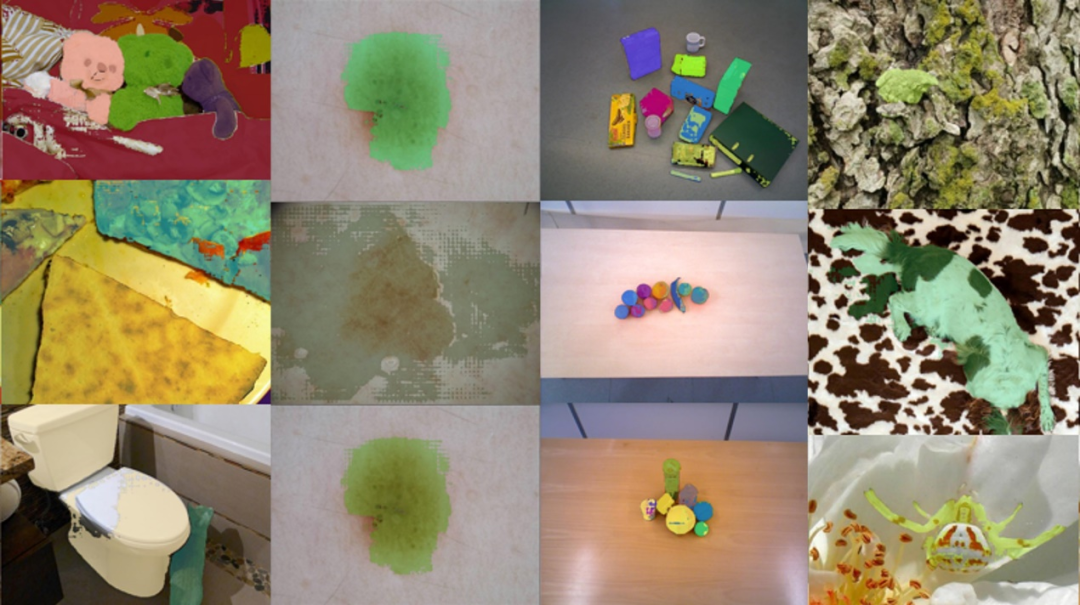
第一个针对「SegmentAnything」大模型的域适应策略来了!相关论文已被CVPR2024接收。引言大语言模型(LLMs)的成功激发了计算机视觉领域探索分割基础模型的兴趣。这些基础分割模型通常通过PromptEngineer来进行zero/few图像分割。其中,SegmentAnythingModel(SAM)是最先进的图像分割基础模型。图SAM在多个下游任务上表现不佳但是最近的研究表明,SAM在多种下游任务中并非具有很强的鲁棒性与泛化性,例如在医学图像、伪装物体、添加干扰的自然图像等领域表现较差。

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者来自浙江大学、上海人工智能实验室、香港中文大学、悉尼大学和牛津大学。作者列表:吴逸璇,王逸舟,唐诗翔,吴文灏,贺通,WanliOuyang,PhilipTorr,JianWu。其
颠覆过往大模型评测标准,最新、最全、最权威的测评数据集MR-Ben来了!这是继今年4月发布堪称GPT-4+DALL-E-3的王炸产品超强视觉语言模型Mini-Gemini后,港中文贾佳亚团队再次提出的极具代表性的作品。在MR-Ben的“监督”下,大模型不仅要像学生那样会答题,还要像老师那样会阅卷,真实的推理能力无所遁形。MR-Ben细致地评测了不少国内外一线的开源和闭源模型,如GPT4-Turbo、Cluade3.5-Sonnet、Mistral-Large、Zhipu-GLM4、

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文共同第一作者简介:张逸骅:密歇根州立大学计算机系博士三年级学生,师从SijiaLiu教授,主要研究方向是大模型的安全、隐私和效率问题。李平治:本科毕业于中国科学技术大学,将于2024

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com该文章的作者团队来自于哈工大社会计算与信息检索研究中心,作者团队构成:郑子豪、张梓涵、王泽鑫、付瑞吉、刘铭、王仲远、秦兵。多模态表示多模态命名实体识别,作为构建多模态知识图谱的一项基础而





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



