

Python正则表达式使用全攻略
<p>Python中正则表达式主要通过re模块实现,用于字符串的模式匹配与查找替换等操作。1.re.compile()可预编译正则表达式以提高效率;2.re.search()查找第一个匹配项;3.re.match()仅从字符串开头匹配;4.re.findall()返回所有匹配项列表;5.re.finditer()返回匹配迭代器;6.re.sub()用于替换匹配子串;7.re.split()按模式分割字符串。特殊字符如.^$*+?等用于定义复杂模式,分组用()捕获匹配内容,flags参数控制匹配
Python中正则表达式主要通过re模块实现,用于字符串的模式匹配与查找替换等操作。1.re.compile()可预编译正则表达式以提高效率;2.re.search()查找第一个匹配项;3.re.match()仅从字符串开头匹配;4.re.findall()返回所有匹配项列表;5.re.finditer()返回匹配迭代器;6.re.sub()用于替换匹配子串;7.re.split()按模式分割字符串。特殊字符如. ^ $ * + ?等用于定义复杂模式,分组用()捕获匹配内容,flags参数控制匹配行为(如忽略大小写、多行模式等),编写高效正则包括预编译、避免过度通配、使用非捕获分组等技巧,应用场景涵盖数据验证、提取、清洗、日志分析、代码生成及网络爬虫。
正则表达式在Python中,主要通过re模块来实现,用于进行字符串的模式匹配和查找替换等操作。简单来说,就是你给Python一个“规则”,让它帮你找符合这个规则的文本。
解决方案
Python的re模块提供了一系列函数,方便你使用正则表达式。以下是一些常用的函数及其使用方法:
re.compile(pattern, flags=0): 编译正则表达式模式,返回一个正则表达式对象。预编译可以提高效率,特别是当同一个模式需要多次使用时。
import re

pattern = re.compile(r'\d+')  # 匹配一个或多个数字
result = pattern.findall('12 drummers drumming, 11 pipers piping, 10 lords a-leaping')
print(result)  # 输出: ['12', '11', '10']
这里,
r'\d+'是一个原始字符串,表示一个或多个数字。re.compile()将这个模式编译成一个正则表达式对象,然后就可以用这个对象进行查找了。re.search(pattern, string, flags=0): 在字符串中查找匹配正则表达式模式的第一个位置,如果找到匹配,则返回一个Match对象。否则,返回None。import re result = re.search(r'hello', 'hello world') if result: print(result.group(0)) # 输出: helloresult.group(0)返回匹配的整个字符串。re.match(pattern, string, flags=0): 尝试从字符串的起始位置匹配正则表达式模式,如果匹配成功,则返回一个Match对象。否则,返回None。注意,re.match()只从字符串的开头开始匹配。import re result = re.match(r'hello', 'hello world') if result: print(result.group(0)) # 输出: hello result = re.match(r'world', 'hello world') if result: print(result.group(0)) # 这行不会执行,因为'world'不在字符串的开头 else: print("No match at the beginning") # 输出: No match at the beginningre.findall(pattern, string, flags=0): 在字符串中查找所有匹配正则表达式模式的非重叠字符串,并以列表的形式返回。import re result = re.findall(r'\d+', '12 drummers drumming, 11 pipers piping, 10 lords a-leaping') print(result) # 输出: ['12', '11', '10']
re.finditer(pattern, string, flags=0): 在字符串中查找所有匹配正则表达式模式的非重叠字符串,并以迭代器的形式返回。迭代器中的每个元素都是一个Match对象。import re result = re.finditer(r'\d+', '12 drummers drumming, 11 pipers piping, 10 lords a-leaping') for match in result: print(match.group(0)) # 依次输出: 12, 11, 10re.sub(pattern, repl, string, count=0, flags=0): 在字符串中查找匹配正则表达式模式的所有子串,并将其替换为repl。count指定最多替换的次数,默认为 0,表示替换所有匹配项。import re new_string = re.sub(r'\d+', 'X', '12 drummers drumming, 11 pipers piping, 10 lords a-leaping') print(new_string) # 输出: X drummers drumming, X pipers piping, X lords a-leaping
re.split(pattern, string, maxsplit=0, flags=0): 根据正则表达式模式分割字符串,返回一个列表。maxsplit指定最多分割的次数,默认为 0,表示分割所有匹配项。import re result = re.split(r',\s*', '12 drummers drumming, 11 pipers piping, 10 lords a-leaping') print(result) # 输出: ['12 drummers drumming', '11 pipers piping', '10 lords a-leaping']
Python正则表达式中的特殊字符有哪些?
正则表达式之所以强大,很大程度上是因为它可以使用一些特殊字符来表示复杂的模式。这些特殊字符也被称为元字符。下面是一些常见的元字符:
.(点号): 匹配除了换行符以外的任意单个字符。^(脱字符): 匹配字符串的开头。$(美元符): 匹配字符串的结尾。*(星号): 匹配前一个字符 0 次或多次。+(加号): 匹配前一个字符 1 次或多次。?(问号): 匹配前一个字符 0 次或 1 次。{m,n}: 匹配前一个字符至少 m 次,但不超过 n 次。[](字符集): 匹配方括号中的任意一个字符。例如,[abc]匹配 'a'、'b' 或 'c'。[^...](否定字符集): 匹配不在方括号中的任意一个字符。例如,[^abc]匹配除了 'a'、'b' 和 'c' 以外的任意字符。\(反斜杠): 用于转义特殊字符,使其失去特殊含义。例如,\.匹配点号本身,而不是任意字符。|(竖线): 表示“或”,匹配竖线两侧的任意一个模式。()(分组): 用于将多个字符组合成一个单元,可以对分组应用量词,也可以捕获分组匹配的文本。
如何在Python正则表达式中使用分组和捕获?
分组和捕获是正则表达式中非常强大的功能,它们允许你将模式的一部分组合在一起,并单独提取匹配的内容。
- 分组: 使用圆括号
()可以将正则表达式的一部分组合成一个分组。 - 捕获: 默认情况下,每个分组都会被捕获。你可以使用
Match对象的group()方法来访问捕获的分组。group(0)返回整个匹配的字符串,group(1)返回第一个分组匹配的字符串,group(2)返回第二个分组匹配的字符串,以此类推。
import re

pattern = re.compile(r'(\w+) (\w+)') # 匹配两个单词,并分别分组
string = 'Isaac Newton, scientist'
match = pattern.search(string)

if match:
    print("Full match:", match.group(0)) # 输出: Isaac Newton
    print("First name:", match.group(1)) # 输出: Isaac
    print("Last name:", match.group(2))  # 输出: Newton
如果你不想捕获某个分组,可以使用 (?:...)。这被称为非捕获分组。
import re

pattern = re.compile(r'(?:\w+) (\w+)') # 只捕获第二个单词
string = 'Isaac Newton, scientist'
match = pattern.search(string)

if match:
    print("Full match:", match.group(0)) # 输出: Isaac Newton
    print("Last name:", match.group(1))  # 输出: Newton
    # print("First name:", match.group(2))  # 报错,因为只有1个捕获组
Python正则表达式的flags参数有什么作用?
re 模块中的许多函数都接受一个 flags 参数,用于修改正则表达式的匹配行为。以下是一些常用的 flags:
re.IGNORECASE或re.I: 忽略大小写。re.MULTILINE或re.M: 多行模式。在这种模式下,^和$匹配字符串的开头和结尾,以及每一行的开头和结尾。re.DOTALL或re.S: 点号匹配所有字符,包括换行符。re.VERBOSE或re.X: 允许在正则表达式中使用空白字符和注释,以提高可读性。
import re

# 忽略大小写
pattern = re.compile(r'hello', re.IGNORECASE)
result = pattern.search('Hello World')
if result:
    print(result.group(0)) # 输出: Hello

# 多行模式
pattern = re.compile(r'^world', re.MULTILINE)
result = pattern.search('hello\nworld')
if result:
    print(result.group(0)) # 输出: world

# 点号匹配所有字符
pattern = re.compile(r'hello.*world', re.DOTALL)
result = pattern.search('hello\nworld')
if result:
    print(result.group(0)) # 输出: hello\nworld

# 允许使用空白字符和注释
pattern = re.compile(r"""
    hello   # 匹配 hello
    \s+     # 匹配一个或多个空白字符
    world   # 匹配 world
""", re.VERBOSE)
result = pattern.search('hello   world')
if result:
    print(result.group(0)) # 输出: hello   world
如何编写高效的Python正则表达式?
编写高效的正则表达式对于处理大量文本数据至关重要。以下是一些提高正则表达式效率的技巧:
预编译正则表达式: 使用
re.compile()预编译正则表达式,特别是当同一个模式需要多次使用时。使用原始字符串: 使用原始字符串
r'...'来定义正则表达式,可以避免反斜杠转义的问题,并提高可读性。避免过度使用通配符: 尽量使用具体的字符或字符集,而不是过度依赖通配符,例如
.。使用非捕获分组: 如果不需要捕获分组,可以使用
(?:...)来避免不必要的捕获。从字符串开头匹配: 如果可能,使用
re.match()从字符串的开头开始匹配,而不是使用re.search()在整个字符串中搜索。限制回溯: 避免编写可能导致大量回溯的正则表达式。例如,避免嵌套的量词,如
(a+)*。使用字符集: 使用字符集
[...]来匹配一组字符,而不是使用多个|运算符。例如,使用[abc]匹配 'a'、'b' 或 'c',而不是使用a|b|c。利用锚点: 使用锚点
^和$来限制匹配的位置,可以提高效率。
正则表达式在实际项目中的应用场景有哪些?
正则表达式在实际项目中有着广泛的应用,以下是一些常见的场景:
数据验证: 验证用户输入的数据是否符合特定的格式,例如邮箱地址、电话号码、身份证号等。
数据提取: 从文本中提取特定的信息,例如从网页中提取标题、链接、正文等。
数据清洗: 清洗和转换文本数据,例如去除 HTML 标签、删除重复的空格、转换日期格式等。
日志分析: 分析日志文件,提取关键信息,例如错误信息、访问量、用户行为等。
代码生成: 根据模板和规则生成代码,例如根据数据库表结构生成 ORM 代码。
网络爬虫: 编写网络爬虫,抓取网页内容。
总而言之,re模块是Python处理字符串的利器。掌握它,能让你在文本处理方面事半功倍。
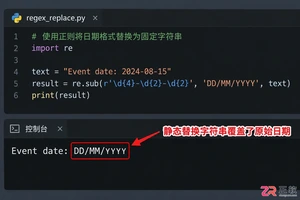
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
处理if()括号内由逻辑连接符(如AND、OR)分隔的条件表达式,应分两步:先用正则提取括号内全部内容,再用preg_split按-AND-或-OR-分割,从而稳定获取任意数量的条件项。此方法可避免嵌套干扰,确保分割准确,提升代码健壮性。
Notepad++正则使用需注意:手动勾选Regularexpression模式,开启.matchesnewline以跨行匹配;Boost引擎不支持高级特性,捕获组引用用\1而非$1;\b在含下划线时易误匹配,可用环视替代;复杂表达式应锚定并限制回溯,避免大文件卡死。
String.matches()配合正则表达式可校验控制台输入日期的格式,但仅做格式匹配,无法验证日期真实性,如2023-02-30仍可通过。增强正则可限制月日范围(如01-12、01-31),但仍不能识别逻辑错误。真正有效校验需结合LocalDate.parse()或SimpleDateFormat(需关闭宽松模式),并建议预处理输入(去除空格、替换变体字
20道正则表达式练习题涵盖邮箱、IP地址、日期、电话、URL、邮编、信用卡号、大小写单词、数字、HTML标签、空白字符、十六进制颜色、浮点数、时间等常见匹配场景,从基础到进阶,每道题附有表达式和示例。
正则默认采用贪婪模式,量词尽可能多匹配;量词后加问号切换为非贪婪模式,匹配最短。两种模式影响准确性与性能,非贪婪可避免过度匹配,如HTML标签提取、日志解析。合理选择模式并组合分组与回溯优化,可显著提升正则精度与效率。
C#中提取字符串数字应使用Regex.Matches方法获取所有匹配项。需注意全角数字兼容、小数格式转义、正则实例缓存提升性能,用TryParse转换数值防异常。避免误用Regex.Split导致空串或缺失位置信息。实际应用需结合业务规则筛选。
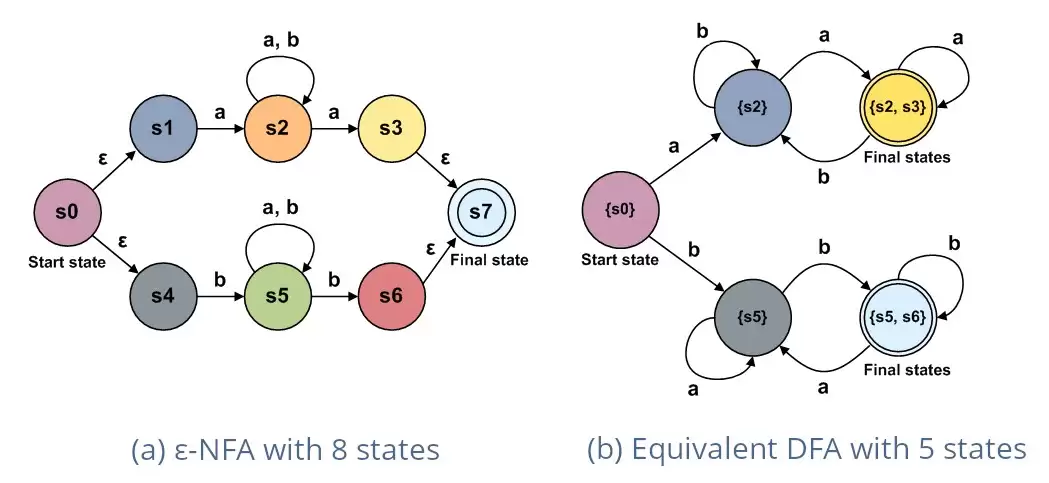
正则表达式是描述字符串模式的强大工具,广泛应用于文本处理。其背后原理涉及非确定有限自动机和确定有限自动机。正则表达式可转换为NFA,再通过子集构造法转为DFA。NFA构造直观灵活,DFA则运行高效确定。理解这一转换机制有助于编写高效正则表达式,并深入理解编译原理等底层实现。
C#中正则匹配依赖System.Text.RegularExpressions.Regex类,常用方法包括IsMatch判断匹配、Match/Matches提取结果、Replace替换、Split分割,支持选项设置与常见格式验证。
Ja va 中使用正则表达式替换子字符串的正确方法 在Ja va里处理字符串替换,有个细节经常把人绊倒:String.replace()这个方法,其实只认字面量。如果你想玩点“花样”,比如基于正则表达式来匹配和替换——典型场景就是只替换第一个点号前面的部分——那你就得换“家伙”了。正确的方法是转向r





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



