

错误率降低44%!纽约大学最新「人脸生成」可让年龄随意变化:从少年到老年全覆盖
当下的「人脸识别系统」抗衰老能力非常弱,人物面部老化会显著降低识别性能,隔一段时间就需要更换人脸数据。提升人脸识别系统的鲁棒性需要收集个体老化的高质量数据,不过近几年发布的数据集规模通常较小,年限也不够长(如5年左右),或是在姿态、照明、背景等方面有较大变化,没有专注于人脸数据。最近,纽约大学的研究人员提出了一种通过隐扩散模型保留不同年龄身份特征的方法,并且只需要少样本训练,即可直观地用「文本提示」来控制模型输出。论文链接:https://arxiv.org/pdf/2307.08585.pdf研究人员引
当下的「人脸识别系统」抗衰老能力非常弱,人物面部老化会显著降低识别性能,隔一段时间就需要更换人脸数据。
提升人脸识别系统的鲁棒性需要收集个体老化的高质量数据,不过近几年发布的数据集规模通常较小,年限也不够长(如5年左右),或是在姿态、照明、背景等方面有较大变化,没有专注于人脸数据。
最近,纽约大学的研究人员提出了一种通过隐扩散模型保留不同年龄身份特征的方法,并且只需要少样本训练,即可直观地用「文本提示」来控制模型输出。
论文链接:https://arxiv.org/pdf/2307.08585.pdf
研究人员引入了两个关键的组件:一个身份保持损失,以及一个小的(图像,描述)正则化集合来解决现有的基于GAN的方法所带来的限制。
在两个基准数据集CeleA和AgeDB的评估中,在常用的生物特征忠诚度(biometric fidelity)指标上,该方法比最先进的基线模型在错误不匹配率上降低了约44%
追踪人脸的年龄变化
DreamBooth
文中提出的方法基于潜扩散模型DreamBooth,其可以通过对文生图扩散模型微调的方式将单个主体放置在其他上下文(re-contextualization)中。
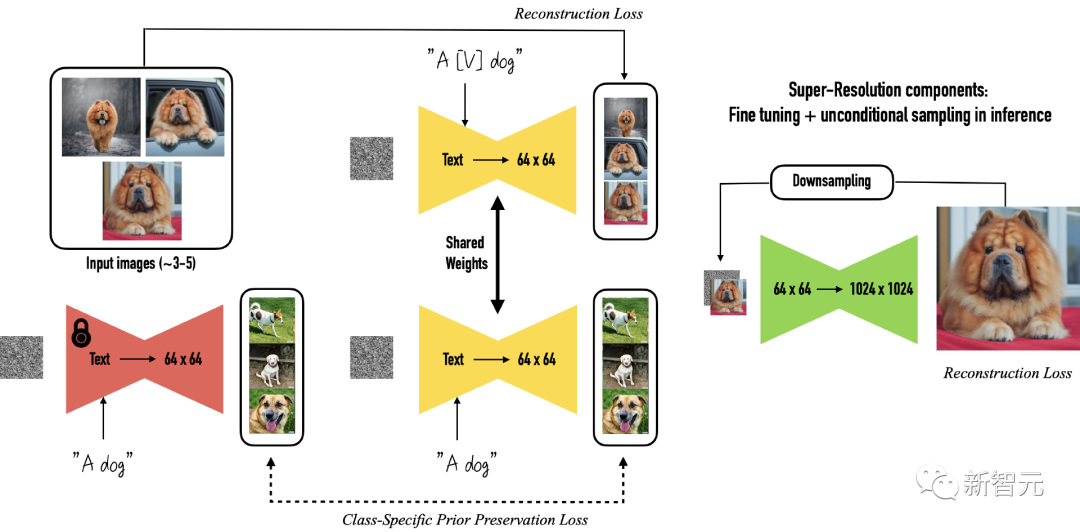
Dreambooth的输入要求为目标主体多张图像,以及包含主体的唯一标识符和类标签(class label)的文本提示,其中类标签是多个实例的集合表示,主体对应于属于该类的特定示例。
Dreambooth的目标是将唯一标识符与每个主体(类的特定实例)相关联,然后在文本提示的指导下,在不同的上下文中重新创建同一主体的图像。
类标签需要利用指定类别预训练扩散框架的先验知识,如果类别标签不正确或丢失可能会导致输出质量下降,唯一token充当对特定主题的引用,并且需要足够少见以避免与其他常用概念冲突。
原文作者使用了一组少于3个Unicode字符序列作为token,并用T5-XXL作为分词器。
DreamBooth使用类别先验保存损失(class-specific prior preservation loss)来增加生成图像的可变性,同时确保目标对象和输出图像之间的偏差最小,原始训练损失如下:
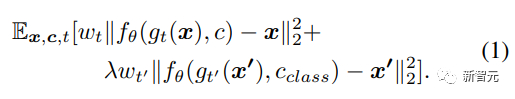
DreamBooth在先验保存的帮助下可以有效地合成狗、猫、卡通等主体图像,不过这篇论文中主要关注的是结构更复杂、纹理也偏细节的人脸图像。
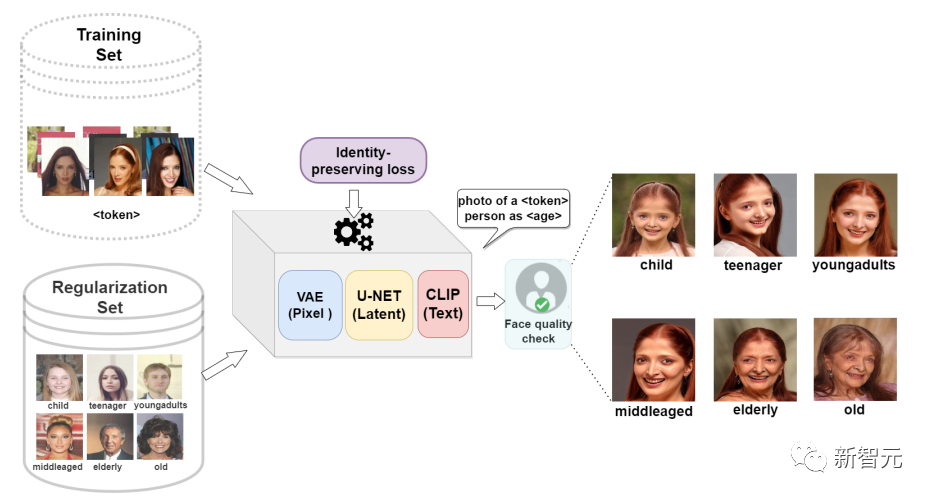
虽然类标签「person」可以捕获类似人类的特征,但这可能不足以捕获因个体差异而形成的身份特征。
所以研究人员在损失函数中引入了一个身份保存(identity-preserving)项,可以最小化原始图像和生成图像生物特征之间的距离,并用新的损失函数微调VAE。
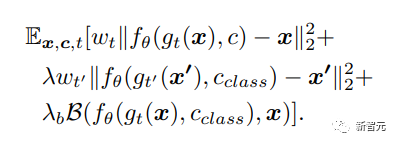
公式中的第三项代表被拍摄物体的真实图像和生成图像之间生物特征距离,其中B代表两张图像的L1距离,相同的图像距离接近0,值越大代表两个主体的差异越大,使用预训练VGGFace作为特征抽取器。
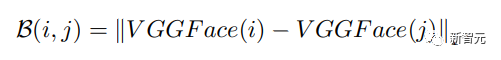
下一步是针对特定目标进行微调,使用冻结的VAE和文本编码器,同时保持U-Net模型解冻。
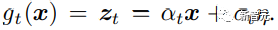
UNet对VAE的编码器产生的潜在表征进行去噪,使用身份保持对比损失进行训练。
研究人员采用SimCLR框架,使用正负样本对之间的归一化温标交叉熵损失(temperature-scaled cross-entropy loss)来增强潜在表征,即下式中的S函数。
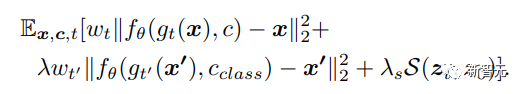
在加权项λs=0.1且温度值=0.5的情况下,计算无噪声输入(z0)和去噪声输出(zt)的潜在表征之间的对比损失。
U-Net架构中潜在表征之间的对比损失使得模型能够微调不同主体的扩散模型。
除了定制损失外,研究人员还使用正则化集将面部年龄发展(progression)和回归(regression)的概念赋给潜在扩散模型,其中正则化集合包括一个类别中所有代表性的图像,在本例中为person.
如果目标是生成真实的人脸图像,那从互联网上选择人脸图像的正则化集就足够了。
不过本文中的任务是让模型学习衰老和返老还童的概念,并且还要应用到不同的个体上,所以研究人员选择使用不同年龄组的人脸图像,然后将其与一个单词描述(one-word caption)进行配对。
图像描述对应于六个年龄组 :儿童(child)、青少年(tennager)、年轻人(youngadults)、中年人(middleaged)、中老年人(elderly)、老年人(old )。
相比数字提示(20岁、40岁),年龄描述的性能更好,并且可以在推理中用文本来提示扩散模型((photo of a ⟨ token ⟩ ⟨ class label ⟩ as ⟨ age group ⟩)
实验结果
实验设置
研究人员使用Stable Diffusion v1.4实现的DreamBooth进行实验,使用CLIP文本编码器(在laion-aesthetics v2 5+上训练)和矢量量化VAE来完成年龄变化,在训练扩散模型时,文本编码器保持冻结状态。
研究人员使用来自CelebA数据集100名受试者的2258张人脸图像和来自AgeDB数据集100名受试者的659张图像构成训练集。
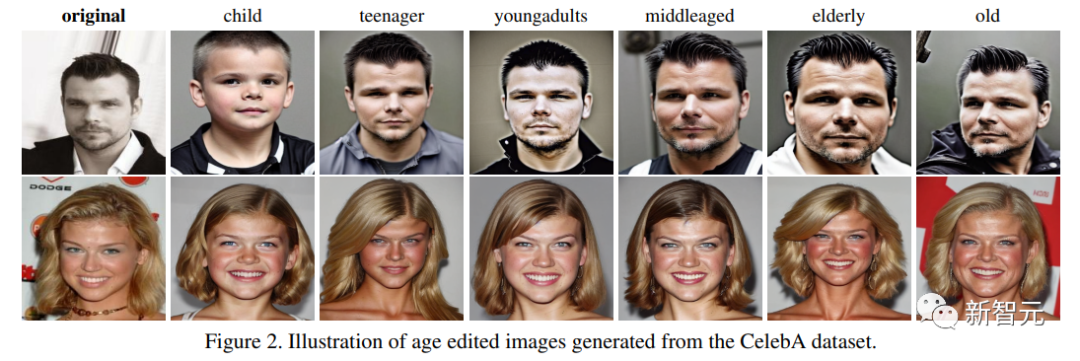
除了二元属性「Young」之外,CelebA数据集没有受试者的年龄信息;AgeDB数据集包含精确年龄值,研究人员选择图像数量最多的年龄组,并将其用作训练集,其余图像则用于测试集(共2369幅图像)。
研究人员使用(图像,描述)数据对作为正则化集,其中每个人脸图像与指示其相应年龄标签的标题相关联,具体儿童<15岁、青少年15-30岁、年轻人30-40岁、中年人40-50岁、中老年人50-65岁、老年人>65岁,使用四个稀少token作为标记:wzx, sks, ams, ukj
对比结果
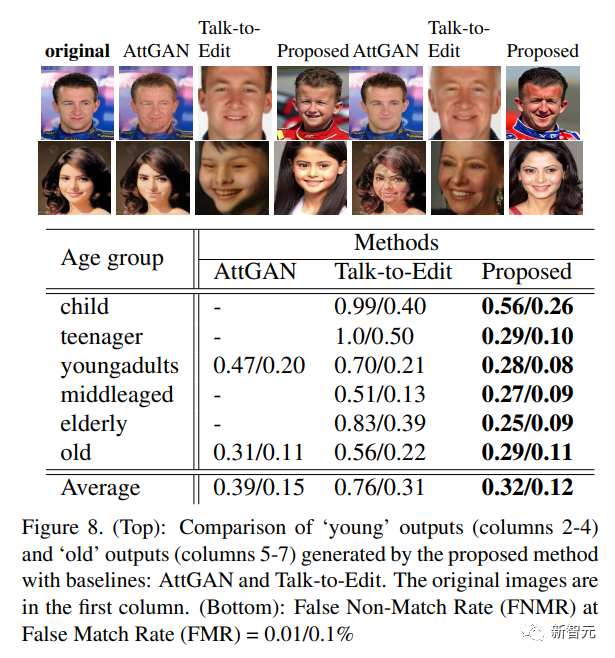
研究人员使用IPCGAN、AttGAN和Talk-toEdit作为评估对比基线模型。
由于IPCGAN是在CACD数据集上训练的,所以研究人员对来自CACD数据集的62名受试者进行了微调,可以观察到FNMR=2%,而文中提出的方法FNMR( False NonMatch Rate)=11%
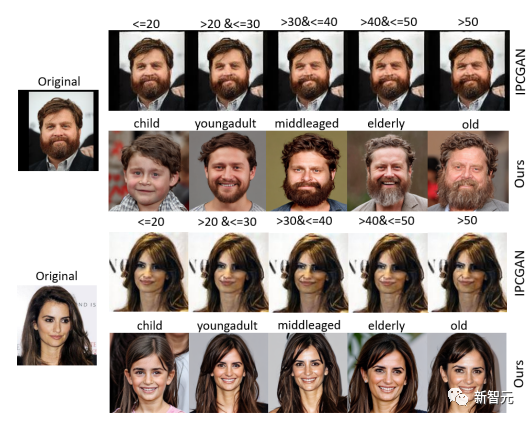
可以看到IPCGAN默认情况无法执行老化或变年轻的操作,导致FNMR值很低。
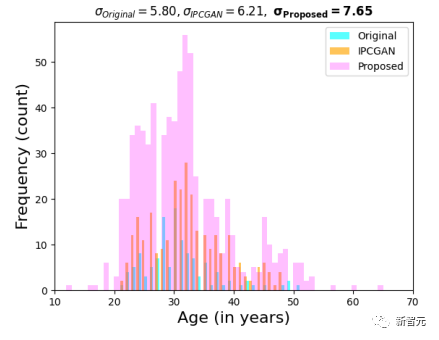
研究人员使用DeepFace年龄预测器进行自动年龄预测,可以观察到,与原始图像和IPCGAN生成的图像相比,文中方法合成的图像会让年龄预测得更分散,表明年龄编辑操作已经成功。
在CelebA数据集上应用AttGAN和对话编辑时,在图像对比和生物特征匹配性能上,可以观察到,在FMR=0.01时,文中方法在「young」类别的图像上优于AttGAN 19%,在「old」类别图像上优于AttGAN 7%
用户研究
研究人员收集了26份用户反馈,rank-1生物特征识别准确率(响应总数的平均值)达到了78.8%,各年龄组的正确识别准确率分别为:儿童=99.6%、青少年=72.7%、青少年=68.1%、中年=70.7%、老年人=93.8%
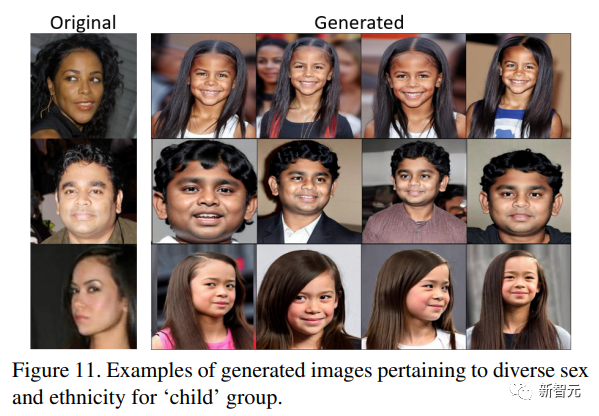
也就是说,用户能够以相当高的准确度成功地区分来自不同年龄组的生成图像。
在开始之前,先确认硬件已经就位:关机,把新硬盘装上,再重新开机。开机后第一件事,就是检查系统是否识别到了新设备。用 dmesg | grep ad2 看一眼,如果输出类似 ad2: 9765MB [19841/16/63] at ata1-master UDMA33 这样的信息,说明新硬盘已经被成功
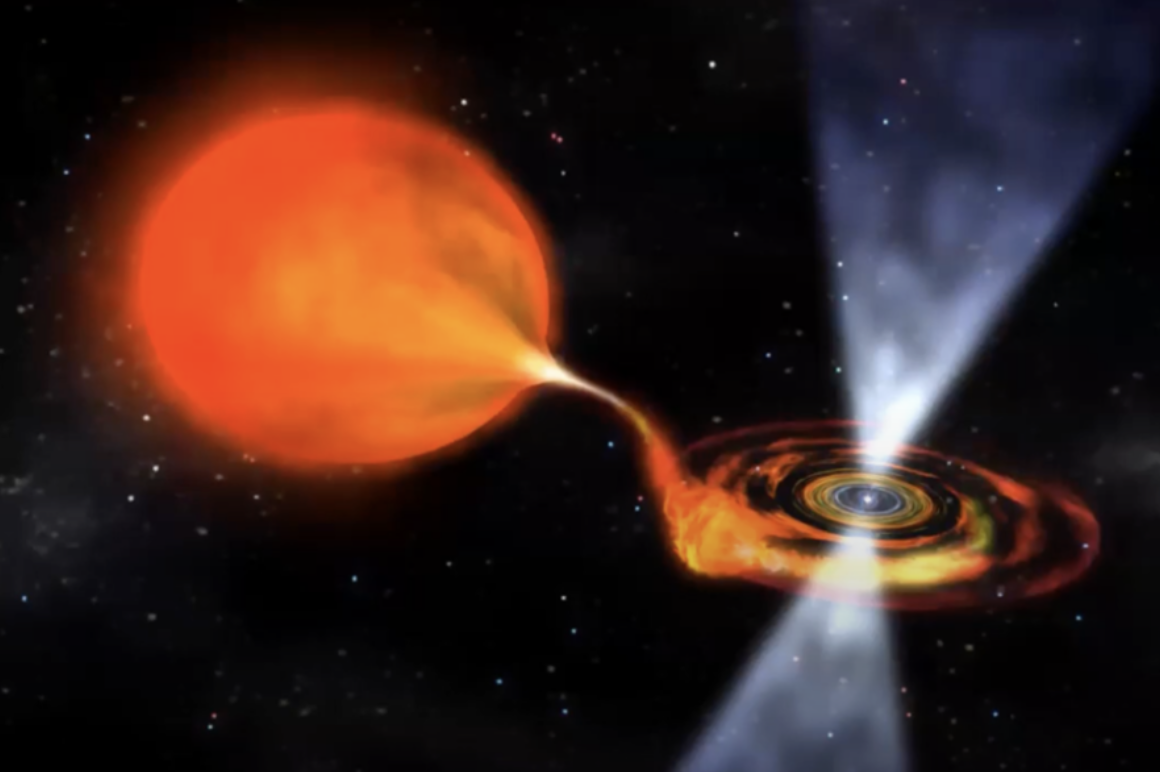
7月25日消息 天文学界最近有一项挺有意思的发现。根据中国科学院发布的信息,由南京天文光学技术研究所研究员王靓团队,联合国家天文台研究员罗阿理等人,利用LAMOST望远镜第十次公开的海量光谱数据,再结合多种测光数据,成功揪出了两颗全新的共生星,同时还锁定了12颗“仅吸积共生星”的候选体。这成果可不只


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
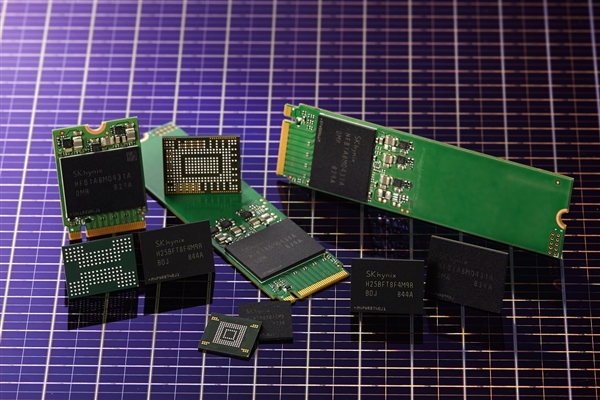
在千兆宽带、5G通信与云服务深度普及的2026年,大众普遍以为超大文件传输已步入“秒级时代”,但现实远未达到这般畅快。当面对数TB乃至数十TB级别的庞大数据集时,当下最可靠、最迅捷且兼顾安全性的传输方案,依然是“物理位移”——依靠人工携带存储介质完成跨地域交付。一位来自河南信阳的用户讲述了真实经历:他曾需将4TB资料从信阳送往郑州,首次尝试纯网络传输,系统预估总耗时近72小时;最终改用专人驱车运送,单程仅需约2.5小时,当天即完成取件与送达,整体效率显著超越线上方式。该实例迅速引发热议,多位资深IT博主随
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



