

Python爬虫入门:BeautifulSoup解析教程
Python爬虫开发的核心在于高效抓取和精准解析。1.安装requests和beautifulsoup4库,用于发送HTTP请求和解析HTML内容;2.使用requests获取网页内容,并检查状态码确保请求成功;3.利用BeautifulSoup解析HTML,提取所需数据如链接和段落文本;4.对JavaScript渲染页面,使用Selenium或Pyppeteer模拟浏览器行为执行JavaScript代码;5.应对反爬虫机制,设置请求头、使用代理IP、设置延迟及处理验证码;6.高效爬取大量数据可采用多线程
Python爬虫开发的核心在于高效抓取和精准解析。1. 安装requests和beautifulsoup4库,用于发送HTTP请求和解析HTML内容;2. 使用requests获取网页内容,并检查状态码确保请求成功;3. 利用BeautifulSoup解析HTML,提取所需数据如链接和段落文本;4. 对JavaScript渲染页面,使用Selenium或Pyppeteer模拟浏览器行为执行JavaScript代码;5. 应对反爬虫机制,设置请求头、使用代理IP、设置延迟及处理验证码;6. 高效爬取大量数据可采用多线程/多进程、异步IO和分布式爬虫技术,依据需求和资源选择合适方法。
Python爬虫开发,核心在于高效抓取和精准解析。BeautifulSoup是解析HTML/XML的利器,两者结合能让你轻松获取网页数据。
解决方案
安装必要的库:
pip install requests beautifulsoup4
requests负责发送HTTP请求,beautifulsoup4负责解析HTML内容。发送HTTP请求,获取网页内容:
import requests

url = "https://www.example.com" # 替换成你要爬取的网址
response = requests.get(url)

if response.status_code == 200:
    html_content = response.text
else:
    print(f"请求失败,状态码:{response.status_code}")
    html_content = None
这里检查了状态码,确保请求成功。 如果失败,直接返回None,避免后续解析出错。
使用BeautifulSoup解析HTML:
from bs4 import BeautifulSoup if html_content: soup = BeautifulSoup(html_content, 'html.parser') # 例如,提取所有链接 for link in soup.find_all('a'): print(link.get('href')) # 或者,提取所有段落文本 for paragraph in soup.find_all('p'): print(paragraph.text)html.parser是Python内置的解析器,速度较快。 你也可以选择lxml,如果安装了的话,速度会更快,但需要额外安装。数据清洗与存储:
爬取到的数据往往需要清洗,例如去除空格、特殊字符等。 之后,可以将数据存储到CSV文件、数据库等。
如何处理JavaScript渲染的页面?
有些网站的内容是JavaScript动态生成的,直接用requests获取到的HTML可能不包含这些内容。 这时,可以考虑使用Selenium或Pyppeteer等工具,它们可以模拟浏览器行为,执行JavaScript代码,获取完整的页面内容。
from selenium import webdriver
from selenium.webdriver.chrome.options import Options

# 设置Chrome Headless模式
chrome_options = Options()
chrome_options.add_argument("--headless")
chrome_options.add_argument("--disable-gpu")

driver = webdriver.Chrome(options=chrome_options) # 确保安装了ChromeDriver

driver.get("https://www.example.com") # 替换成你要爬取的网址

html_content = driver.page_source
driver.quit()

soup = BeautifulSoup(html_content, 'html.parser')
#  后续解析步骤与前面相同
Selenium启动浏览器比较耗资源,如果只需要获取动态内容,可以考虑Pyppeteer,它更轻量级。
如何应对反爬虫机制?
网站可能会采取一些反爬虫措施,例如限制IP访问频率、验证码等。 应对这些机制,可以采取以下策略:
设置请求头: 模拟浏览器请求,设置User-Agent、Referer等。
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3',
    'Referer': 'https://www.google.com'
}
response = requests.get(url, headers=headers)
使用代理IP: 通过代理IP隐藏真实IP地址。 可以购买代理IP服务,或者使用免费的代理IP(但稳定性较差)。
proxies = {
    'http': 'http://10.10.1.10:3128',
    'https': 'http://10.10.1.10:1080',
}
response = requests.get(url, proxies=proxies)
设置延迟: 避免过于频繁地访问网站,设置一定的延迟时间。
import time
time.sleep(2) # 延迟2秒
处理验证码: 可以使用OCR技术识别验证码,或者使用第三方验证码识别服务。
如何高效地爬取大量数据?
如果需要爬取大量数据,可以考虑使用以下方法:
多线程/多进程: 并发地发送请求,提高爬取速度。
import threading
import queue

def worker(q, url):
    while True:
        try:
            url = q.get(timeout=5) # 从队列中获取URL
            response = requests.get(url)
            #  处理response
            print(f"爬取 {url} 完成")
        except queue.Empty:
            break

url_list = ["https://www.example.com/page1", "https://www.example.com/page2", ...] # 你的URL列表
q = queue.Queue()
for url in url_list:
    q.put(url)

threads = []
for i in range(10): # 创建10个线程
    t = threading.Thread(target=worker, args=(q, url_list))
    threads.append(t)
    t.start()

for t in threads:
    t.join()
异步IO: 使用
asyncio和aiohttp等库,实现异步IO,进一步提高爬取效率。import asyncio import aiohttp async def fetch(session, url): async with session.get(url) as response: return await response.text() async def main(): async with aiohttp.ClientSession() as session: tasks = [fetch(session, url) for url in ["https://www.example.com/page1", "https://www.example.com/page2"]] htmls = await asyncio.gather(*tasks) # 处理htmls if __name__ == "__main__": asyncio.run(main())分布式爬虫: 将爬虫程序部署到多台机器上,协同工作,进一步提高爬取能力。 可以使用Redis等消息队列,协调各个爬虫节点。
选择哪种方法取决于你的具体需求和硬件资源。 多线程/多进程适合CPU密集型任务,异步IO适合IO密集型任务。 分布式爬虫适合大规模数据爬取。
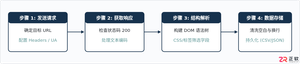
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
requests库是Python爬虫常用工具,安装命令为pipinstallrequests。通过requests.get()发送GET请求,可传入params参数添加URL参数;使用requests.post()发送POST请求,data传递表单数据,json参数发送JSON数据。可设置headers模拟浏览器访问,避免反爬。响应对象提供status_code、headers、text、content、json()等属性解析结果。结合BeautifulSoup或正则表达式提取数据,可构建完整爬虫流程,需
日志记录能提升爬虫的可维护性和调试效率,通过logging模块实现多级别信息分类、异常捕获及文件保存,结合模块化配置实现透明化运行。
答案:使用requests库可安全抓取HTTPS网站,需正确处理SSL证书验证。默认情况下requests会自动验证服务器证书,确保连接安全;若遇自签名或私有CA证书,可指定本地证书路径或谨慎关闭验证(仅限测试);结合headers、cookies和代理提升兼容性与隐蔽性;对高级需求可用urllib3或自定义SSL上下文控制TLS行为;保持库更新以支持最新安全标准。
答案:Python爬虫数据可保存为CSV、JSON、Excel或存入MySQL、MongoDB。小数据用CSV/JSON,分析选Excel,长期结构化存储用MySQL,非结构化数据选MongoDB,注意编码与异常处理。
使用异步请求、统一解析接口、反爬策略和容错机制可高效抓取多网站数据。1.采用aiohttp+asyncio并发请求,显著提升抓取效率;2.为各站点编写独立解析函数并注册到统一映射表,实现结构化输出;3.设置请求头、频率控制、代理IP和重试机制应对反爬;4.成功数据存入数据库,失败记录日志以便重试,确保程序稳定运行。
先掌握Python基础语法,再学习requests库发送请求,用BeautifulSoup解析网页,逐步应对反爬机制并实践小项目。

在Python中处理爬取数据主要使用BeautifulSoup解析HTML、json模块处理JSON和xml.etree.ElementTree解析XML。1)使用BeautifulSoup从HTML中提取标题和段落。2)用json.loads()解析JSON数据。3)用xml.etree.ElementTree从XML中提取信息。数据处理还包括清洗、转换和存储,通常使用pandas库进行操作。
合规使用Python爬虫需遵循robots协议并依法获取数据。首先通过urllib.robotparser读取robots.txt判断可抓取范围,示例代码显示利用RobotFileParser类检查目标URL权限,并在请求前集成该逻辑。其次控制请求频率,使用time.sleep()加入1-3秒随机延迟或Scrapy的AUTOTHROTTLE扩展减轻服务器压力。同时遵守《网络安全法》《数据安全法》等法规,不采集隐私信息,非授权不得用于商业或传播受版权保护内容。设置规范User-Agent头表明身份,如包含爬
掌握Python爬虫需四步:先用requests发送HTTP请求获取HTML源码,注意添加User-Agent;再用BeautifulSoup或lxml解析HTML提取数据;若页面为JavaScript动态加载,则使用Selenium模拟浏览器;最后将数据保存为CSV或JSON,并通过设置请求间隔、代理IP等应对反爬策略。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



