

Python将LineString转为带缓冲区的Polygon
本文详细介绍了如何使用Python的GeoPandas和Shapely库,将GeoJSON中的LineString几何对象转换为带有指定半径缓冲区的Polygon。教程涵盖了数据加载、坐标系转换(CRS)、缓冲区计算中的单位换算,以及如何通过shapely.union_all处理多个缓冲区合并以避免几何体无效,最终生成并保存新的GeoJSON文件。通过本教程,读者将掌握处理地理空间数据类型转换和几何操作的关键技巧。

1. 引言与目标
在地理空间数据处理中,我们经常需要对几何对象进行转换和操作。本教程的目标是将GeoJSON格式的LineString几何体转换为Polygon几何体,具体实现方式是沿着LineString的每个坐标点生成一个指定半径的缓冲区,然后将这些缓冲区合并成一个或多个Polygon。这在例如划定线路影响区域、分析周边覆盖范围等场景中非常有用。
我们将使用Python的geopandas和shapely库来完成此任务,并重点解决在坐标系处理、单位转换以及几何体合并过程中可能遇到的问题。
2. 环境准备与数据加载
在开始之前,请确保已安装必要的Python库:geopandas, shapely, json 和 matplotlib (用于可选的可视化)。
pip install geopandas shapely matplotlib
首先,我们需要加载GeoJSON格式的输入数据。假设我们的输入数据Sample_lines.geojson包含LineString特征,如下所示:
{
  "type": "FeatureCollection",
  "name": "Sample_lines",
  "crs": { "type": "name", "properties": { "name": "urn:ogc:def:crs:OGC:1.3:CRS84" } },
  "features": [
    { "type": "Feature", "properties": { "OBJECTID": 123 }, "geometry": { "type": "LineString", "coordinates": [ [ -112.4000, 41.0833, 0.0 ], [ -112.5666, 41.3000, 0.0 ] ] } },
    { "type": "Feature", "properties": { "OBJECTID": 124 }, "geometry": { "type": "LineString", "coordinates": [ [ -112.5666, 41.3000, 0.0 ], [ -112.6500, 41.4333, 0.0 ] ] } }
  ]
}
使用json库加载此文件:
import json
import geopandas as gpd
import shapely
from shapely import plotting # 用于可选的可视化
from pathlib import Path # 推荐用于路径处理

# 假设 GeoJSON 文件与脚本在同一目录下
geojson_path = Path(__file__).with_suffix(".geojson") # 或者直接指定文件名 "Sample_lines.geojson"
with open(geojson_path) as f:
    geojson_data = json.load(f)

features = [] # 用于存储处理后的新特征
3. 核心概念与挑战
在将LineString转换为带缓冲区的Polygon时,有几个关键概念和潜在挑战需要理解和解决:
3.1 坐标参考系统 (CRS) 的重要性
输入的GeoJSON数据通常使用地理坐标系(如WGS84,EPSG:4326),其单位是度。直接在地理坐标系中计算缓冲区会导致不准确的结果,因为度不是一个等距单位。为了进行准确的距离计算和缓冲区操作,必须将数据投影到一个投影坐标系(Projected CRS),其单位通常是米或英尺。
例如,对于美国境内的数据,EPSG:2163 (US National Atlas Equal Area) 是一个常用的投影坐标系,其单位是米。
3.2 缓冲区单位转换
问题要求添加“2英里”的缓冲区。在投影坐标系中进行缓冲区操作时,需要将英里转换为该坐标系对应的单位。如果投影坐标系使用米作为单位,那么2英里需要转换为米:2 * 1609.34 米。
3.3 处理多个缓冲区的合并
LineString由多个坐标点组成。为每个点生成缓冲区后,这些独立的圆形缓冲区可能会重叠。为了得到一个代表整个LineString缓冲区的单一(或复合)Polygon,我们需要将这些重叠的缓冲区进行合并。直接将它们放入MultiPolygon可能会导致无效的几何体。shapely.union_all()函数是解决此问题的理想选择,它可以将一组几何体合并成一个单一的、有效的几何体(可能是Polygon或MultiPolygon)。
4. 逐步实现
我们将遍历GeoJSON中的每个LineString特征,对其进行处理。
4.1 遍历特征与坐标
for feature in geojson_data["features"]:
    coords = feature["geometry"]["coordinates"]

    # 打印部分坐标信息,用于调试
    # print(coords[0][0])
    # print(coords[0][1])
    # print(tuple(coords[0])) # 原始问题中尝试将coords转换为tuple导致了错误
    # print(coords)

    buffers = [] # 存储每个点的缓冲区
注意事项: 原始问题中尝试将coords整体或其子元素转换为tuple(coords),这在迭代时不是必需的,且可能导致gpd.points_from_xy接收到不期望的输入。coords本身就是一个可迭代的列表,可以直接用于循环。
4.2 创建并缓冲点
对于LineString中的每个(x, y, z)坐标(即使z为0或不存在,我们只关心x和y):
- 创建GeoSeries点对象: 使用gpd.points_from_xy()创建点。务必指定原始CRS (EPSG:4326)。
- 重投影: 将点从地理坐标系 (EPSG:4326) 重投影到适合距离计算的投影坐标系 (例如,EPSG:2163)。
- 应用缓冲区: 使用buffer()方法应用2英里(转换为米)的缓冲区。
    for x, y, z in coords: # coords可以直接迭代,无需转换为tuple
        # 创建一个GeoSeries,包含单个点,并指定其原始CRS
        point_gs = gpd.points_from_xy([x], [y], crs=4326)

        # 将点重投影到适合距离计算的投影CRS (例如,EPSG:2163)
        point_projected = point_gs.to_crs(epsg=2163)

        # 计算缓冲区:2英里转换为米 (1英里约等于1609.34米)
        buffered_point = point_projected.buffer(2 * 1609.34)
        buffers.append(buffered_point.geometry.iloc[0]) # 提取 shapely 几何对象
注意事项:
- gpd.points_from_xy([x], [y], crs=4326) 是正确的使用方式,它期望x和y坐标的列表。
- buffer()方法返回的是一个GeoSeries,我们通常需要提取其中的shapely几何对象(通过.geometry.iloc[0])以便后续合并。
4.3 合并缓冲区
将所有单个点的缓冲区合并成一个单一的几何体。shapely.union_all()能够高效地处理重叠几何体的合并。
    # 使用shapely.union_all合并所有缓冲区,处理重叠部分
    merged_polygon = shapely.union_all(buffers)

    # 可选:绘制合并后的多边形进行检查
    # plotting.plot_polygon(merged_polygon)
4.4 构建输出GeoJSON特征
将合并后的Polygon几何体和原始特征的属性组合成一个新的GeoJSON特征。
    # 创建新的GeoJSON特征
    features.append(
        {
            "geometry": gpd.GeoSeries(merged_polygon).__geo_interface__, # 将shapely几何体转换为GeoJSON字典
            "properties": feature["properties"], # 保留原始属性
        }
    )
5. 输出新的GeoJSON文件
所有特征处理完毕后,将它们封装到一个新的GeoJSON FeatureCollection中,并保存到文件。
# 构建新的GeoJSON FeatureCollection
new_geojson_data = {"type": "FeatureCollection", "features": features}

# 将结果输出到新的GeoJSON文件
output_filename = "lines2Polygon.geojson"
with open(output_filename, "w") as f:
    json.dump(new_geojson_data, f, indent=2) # 使用indent=2使输出更易读

print(f"转换完成,结果已保存到 {output_filename}")
# print(new_geojson_data) # 打印新GeoJSON数据,用于调试

# 如果之前开启了绘图,显示所有图表
# plt.show()
6. 完整代码示例
from pathlib import Path
import json
import geopandas as gpd
import shapely
from shapely import plotting # 用于可选的可视化
from matplotlib import pyplot as plt # 用于显示绘图

# --- 配置 ---
INPUT_GEOJSON_FILENAME = "Sample_lines.geojson"
OUTPUT_GEOJSON_FILENAME = "lines2Polygon.geojson"
BUFFER_RADIUS_MILES = 2
TARGET_PROJECTED_CRS = 2163 # EPSG:2163 (US National Atlas Equal Area), 单位为米
MILE_TO_METER = 1609.34 # 1英里约等于1609.34米

# --- 数据加载 ---
# 假设 GeoJSON 文件与脚本在同一目录下
geojson_path = Path(__file__).parent / INPUT_GEOJSON_FILENAME
if not geojson_path.exists():
    print(f"错误: 输入文件 '{geojson_path}' 不存在。请确保文件存在。")
    # 可以选择在此处创建一个虚拟文件用于测试,或者直接退出
    # 例如:创建一个简单的测试 GeoJSON
    sample_data = {
        "type": "FeatureCollection",
        "name": "Sample_lines",
        "crs": { "type": "name", "properties": { "name": "urn:ogc:def:crs:OGC:1.3:CRS84" } },
        "features": [
            { "type": "Feature", "properties": { "OBJECTID": 123, "GLOBAL_ID": "8CAB8A", "IDENT": "41",  "TYPE": "N",  "Shape__Length": 0.2733 }, "geometry": { "type": "LineString", "coordinates": [ [ -112.400011882673994, 41.0833390325461, 0.0 ], [ -112.56667894652, 41.300005042600802, 0.0 ] ] } },
            { "type": "Feature", "properties": { "OBJECTID": 124, "GLOBAL_ID": "9ACAVB", "IDENT": "45",  "TYPE": "N",  "Shape__Length": 0.1573 }, "geometry": { "type": "LineString", "coordinates": [ [ -112.56667894652, 41.300005042600802, 0.0 ], [ -112.650011982188005, 41.4333400501312, 0.0 ] ] } },
            { "type": "Feature", "properties": { "OBJECTID": 125, "GLOBAL_ID": "5ACBFA", "IDENT": "48",  "TYPE": "N",  "Shape__Length": 0.4599 }, "geometry": { "type": "LineString", "coordinates": [ [ -112.650011982188005, 41.4333400501312, 0.0 ], [ -113.100012081374004, 41.5000060205737, 0.0 ] ] } }
        ]
    }
    with open(geojson_path, "w") as f:
        json.dump(sample_data, f, indent=2)
    print(f"已创建示例文件 '{geojson_path}'。")

with open(geojson_path) as f:
    geojson_data = json.load(f)

processed_features = [] # 用于存储处理后的新特征

# --- 处理每个LineString特征 ---
for feature in geojson_data["features"]:
    coords = feature["geometry"]["coordinates"]

    # 存储当前LineString所有点的缓冲区
    individual_buffers = []

    for x, y, *z in coords: # 使用 *z 来处理可能存在的第三个维度(Z值),但我们只关心X和Y
        # 1. 创建GeoSeries点对象,并指定其原始CRS (WGS84)
        # geopandas.points_from_xy 期望 x 和 y 坐标的列表
        point_gs = gpd.points_from_xy([x], [y], crs=4326)

        # 2. 将点重投影到适合距离计算的投影CRS
        # 对于美国数据,EPSG:2163 是一个常见的等面积投影,单位为米
        point_projected = point_gs.to_crs(epsg=TARGET_PROJECTED_CRS)

        # 3. 计算缓冲区:将英里转换为目标CRS的单位 (米)
        buffer_in_meters = BUFFER_RADIUS_MILES * MILE_TO_METER
        buffered_point = point_projected.buffer(buffer_in_meters)

        # 提取 shapely 几何对象并添加到列表中
        individual_buffers.append(buffered_point.geometry.iloc[0])

    # 4. 合并所有单个点的缓冲区
    # shapely.union_all 能够处理重叠的几何体,生成一个有效的MultiPolygon或Polygon
    if individual_buffers: # 确保有缓冲区可以合并
        merged_polygon = shapely.union_all(individual_buffers)

        # 可选:绘制合并后的多边形进行检查
        # fig, ax = plt.subplots(1, 1, figsize=(10, 10))
        # plotting.plot_polygon(merged_polygon, ax=ax, add_points=False, color='blue', alpha=0.5)
        # plotting.plot_points(gpd.points_from_xy([c[0] for c in coords], [c[1] for c in coords], crs=4326).to_crs(epsg=TARGET_PROJECTED_CRS), ax=ax, color='red', markersize=5)
        # ax.set_title(f"Feature ID: {feature['properties'].get('OBJECTID', 'N/A')}")
        # plt.show()

        # 5. 构建新的GeoJSON特征
        processed_features.append(
            {
                "geometry": gpd.GeoSeries(merged_polygon).__geo_interface__, # 将shapely几何体转换为GeoJSON字典
                "properties": feature["properties"], # 保留原始属性
            }
        )
    else:
        print(f"警告: 特征 {feature['properties'].get('OBJECTID', 'N/A')} 没有坐标,跳过。")

# --- 输出新的GeoJSON文件 ---
new_geojson_data = {"type": "FeatureCollection", "features": processed_features}

with open(OUTPUT_GEOJSON_FILENAME, "w") as f:
    json.dump(new_geojson_data, f, indent=2) # 使用indent=2使输出更易读

print(f"\n转换完成!结果已保存到 '{OUTPUT_GEOJSON_FILENAME}'。")

# 如果在循环中使用了plotting.plot_polygon,并且想要一次性显示所有图表,
# 可以将 plt.show() 放在这里。但更好的做法是在循环中控制每个图的显示或保存。
# plt.show()
7. 注意事项与最佳实践
- CRS选择: 选择一个适合您数据地理范围的投影坐标系至关重要。不同的区域有不同的推荐CRS。例如,对于全球范围,可以考虑使用Web Mercator (EPSG:3857),但它在极地地区存在变形。对于特定国家或地区,通常有更精确的本地投影CRS。
- 单位一致性: 确保缓冲区半径的单位与所选投影坐标系的单位一致。如果CRS使用米,则半径也应以米为单位。
- 几何体有效性: shapely.union_all()在合并几何体时会自动处理重叠和自相交,从而生成有效的几何体。如果直接将多个可能重叠的Polygon放入MultiPolygon中,可能会导致无效几何体,这在后续的GIS分析中可能引发问题。
- 性能考虑: 对于包含大量点或LineString的非常大的数据集,缓冲区计算和合并操作可能会非常耗时。考虑使用更高效的算法或并行处理技术(如果适用)。
- Z坐标: 原始数据中的坐标可能包含Z(高程)维度。shapely和geopandas通常只关注X和Y维度进行平面几何操作。在迭代坐标时,可以使用 x, y, *z 来优雅地处理可能存在的Z值,而只使用 x 和 y。
8. 总结
本教程详细展示了如何利用Python的geopandas和shapely库,将GeoJSON中的LineString几何体转换为带有指定半径缓冲区的Polygon。通过理解并正确应用坐标系转换、单位换算以及几何体合并策略,我们能够生成准确且有效的地理空间数据。这些技术在各种地理空间分析和可视化任务中都具有广泛的应用价值。
Cursor新增实时语音对话,支持在Agent运行任务时交流并听取进度,覆盖Agents Window、IDE、网页端与iOS,语音通话需登录账号并开启麦克风权限。
VS Code 1.145新增本地Cron调度,扩展远程Agent预览能力;后续1.145.1与1.145.2修正遥测归属和事件路由。文中区分正式、预览及实验性功能。
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
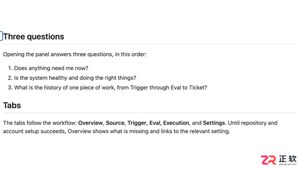
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
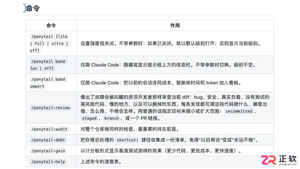
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
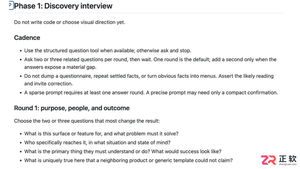
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
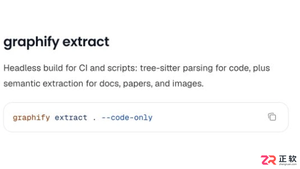
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
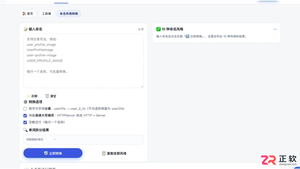
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
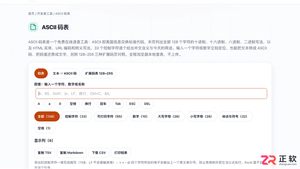
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



