

qsort与bsearch区别详解
qsort用于排序,bsearch用于在已排序数据中查找特定元素。1.qsort是基于快速排序的通用排序函数,接受数组、元素数量、元素大小及比较函数作为参数,通过自定义比较函数实现对任意类型数组的排序,并直接修改原数组;2.bsearch是二分查找函数,要求数组已排序,接受目标元素、数组、元素数量、大小及比较函数,返回指向查找到元素的指针或NULL;3.使用时应先用qsort排序再用bsearch查找,二者均需正确编写比较函数并传递准确参数以确保功能正确与性能高效。
qsort 用于排序,bsearch 用于在已排序数据中查找特定元素。1. qsort 是基于快速排序的通用排序函数,接受数组、元素数量、元素大小及比较函数作为参数,通过自定义比较函数实现对任意类型数组的排序,并直接修改原数组;2. bsearch 是二分查找函数,要求数组已排序,接受目标元素、数组、元素数量、大小及比较函数,返回指向查找到元素的指针或 NULL;3. 使用时应先用 qsort 排序再用 bsearch 查找,二者均需正确编写比较函数并传递准确参数以确保功能正确与性能高效。
qsort 用于排序,而 bsearch 用于在已排序的数据中查找特定元素。简单来说,一个负责整理,一个负责查找。
解决方案
qsort 和 bsearch 都是 C 标准库
qsort:通用排序函数
qsort 是一个通用的排序函数,它可以对任意类型的数组进行排序。它的原型如下:
void qsort(void *base, size_t nmemb, size_t size, int (*compar)(const void *, const void *));
base: 指向要排序的数组的起始地址。nmemb: 数组中元素的数量。size: 每个元素的大小(以字节为单位)。compar: 一个比较函数,用于确定两个元素的顺序。
关键点:
qsort使用的是快速排序算法(Quicksort)的一种变体,通常具有较好的平均性能。- 比较函数
compar是qsort的核心。 你需要自己编写这个函数,告诉qsort如何比较数组中的两个元素。 qsort是原地排序,也就是说它会直接修改原始数组。
比较函数的编写:
比较函数 compar 接受两个 const void * 类型的参数,它们指向要比较的两个元素。 比较函数必须返回一个整数:
- 如果第一个元素小于第二个元素,返回一个负数。
- 如果第一个元素等于第二个元素,返回 0。
- 如果第一个元素大于第二个元素,返回一个正数。
示例:
#include#include int compare_integers(const void *a, const void *b) { return (*(int*)a - *(int*)b); } int main() { int numbers[] = {5, 2, 8, 1, 9, 4}; int num_elements = sizeof(numbers) / sizeof(numbers[0]); qsort(numbers, num_elements, sizeof(int), compare_integers); printf("Sorted array: "); for (int i = 0; i < num_elements; i++) { printf("%d ", numbers[i]); } printf("\n"); return 0; }
在这个例子中,compare_integers 函数比较两个整数的大小。 qsort 会使用这个函数来对 numbers 数组进行排序。
bsearch:二分查找函数
bsearch 是一个二分查找函数,它用于在已排序的数组中查找指定的元素。 它的原型如下:
void *bsearch(const void *key, const void *base, size_t nmemb, size_t size, int (*compar)(const void *, const void *));
key: 指向要查找的元素的指针。base: 指向要搜索的已排序数组的起始地址。nmemb: 数组中元素的数量。size: 每个元素的大小(以字节为单位)。compar: 一个比较函数,用于确定目标元素与数组中元素的相对顺序。
关键点:
bsearch使用二分查找算法,它要求数组必须是已排序的。 如果数组没有排序,bsearch的结果是不可预测的。- 比较函数
compar的作用与qsort中的比较函数类似,但它比较的是目标元素key和数组中的元素。 - 如果
bsearch找到了目标元素,它会返回指向该元素的指针。 如果没有找到,它会返回NULL。
比较函数的编写:
bsearch 的比较函数 compar 与 qsort 的比较函数类似,接受两个 const void * 类型的参数。 第一个参数指向要查找的元素 key,第二个参数指向数组中的一个元素。 比较函数必须返回一个整数,含义与 qsort 的比较函数相同。
示例:
#include#include int compare_integers(const void *a, const void *b) { return (*(int*)a - *(int*)b); } int main() { int numbers[] = {1, 2, 4, 5, 8, 9}; // 必须是已排序的 int num_elements = sizeof(numbers) / sizeof(numbers[0]); int key = 5; int *result = (int*)bsearch(&key, numbers, num_elements, sizeof(int), compare_integers); if (result != NULL) { printf("Found %d in the array.\n", *result); } else { printf("%d not found in the array.\n", key); } return 0; }
在这个例子中,bsearch 在 numbers 数组中查找值为 5 的元素。
何时使用 qsort 和 bsearch?
- 如果你需要对数组进行排序,使用
qsort。 - 如果你需要在已排序的数组中查找元素,使用
bsearch。 - 如果数组未排序,先使用
qsort排序,再使用bsearch查找。
性能考量
qsort的平均时间复杂度为 O(n log n),其中 n 是数组中元素的数量。bsearch的时间复杂度为 O(log n),这使得它在大型已排序数组中查找元素非常高效。
错误处理
- 在使用
qsort之前,确保比较函数compar正确实现了比较逻辑。 错误的比较函数会导致排序结果不正确。 - 在使用
bsearch之前,确保数组已经排序。 如果数组未排序,bsearch的结果是不可预测的。 - 检查
bsearch的返回值,以确定是否找到了目标元素。 如果返回值为NULL,表示没有找到。
qsort 和 bsearch 可以用于哪些数据类型?
qsort 和 bsearch 都可以用于任何数据类型,只要你提供了正确的比较函数。 这包括基本数据类型(如 int、float、char),以及结构体、指针等复杂数据类型。
如何对结构体数组进行排序和查找?
要对结构体数组进行排序和查找,你需要编写一个比较函数,该函数能够比较两个结构体的成员。
示例:
#include#include #include typedef struct { char name[50]; int age; } Person; int compare_persons(const void *a, const void *b) { // 先按年龄排序,如果年龄相同,则按姓名排序 int age_diff = ((Person*)a)->age - ((Person*)b)->age; if (age_diff != 0) { return age_diff; } else { return strcmp(((Person*)a)->name, ((Person*)b)->name); } } int main() { Person people[] = { {"Alice", 30}, {"Bob", 25}, {"Charlie", 30}, {"David", 20} }; int num_people = sizeof(people) / sizeof(people[0]); qsort(people, num_people, sizeof(Person), compare_persons); printf("Sorted array of people:\n"); for (int i = 0; i < num_people; i++) { printf("Name: %s, Age: %d\n", people[i].name, people[i].age); } // 查找年龄为 30 岁的人 Person key = {"", 30}; // 姓名可以为空,因为我们只按年龄查找 Person *result = (Person*)bsearch(&key, people, num_people, sizeof(Person), compare_persons); if (result != NULL) { printf("Found person with age 30: Name: %s, Age: %d\n", result->name, result->age); } else { printf("Person with age 30 not found.\n"); } return 0; }
在这个例子中,compare_persons 函数比较两个 Person 结构体的年龄和姓名。 qsort 会使用这个函数来对 people 数组进行排序。 bsearch 会使用相同的函数来查找年龄为 30 岁的人。 注意,在 bsearch 的示例中,我们创建了一个 key 结构体,并将要查找的年龄设置为 30。 姓名可以为空,因为我们只按年龄查找。
如何避免 qsort 和 bsearch 的常见错误?
- 确保比较函数正确: 比较函数是
qsort和bsearch的核心。 确保它正确实现了比较逻辑,并且返回正确的负数、0 或正数。 - 确保数组已排序(对于
bsearch):bsearch只能在已排序的数组中工作。 如果数组未排序,bsearch的结果是不可预测的。 - 传递正确的参数: 确保你传递给
qsort和bsearch的参数是正确的,包括数组的起始地址、元素数量、元素大小和比较函数。 - 检查返回值: 检查
bsearch的返回值,以确定是否找到了目标元素。 - *小心使用 `void
指针:**qsort和bsearch使用void指针来处理任意类型的数据。 在比较函数中,你需要将void ` 指针转换为实际的数据类型,并小心处理指针运算。 - 避免内存错误: 确保你的代码没有内存泄漏或其他内存错误。 例如,不要在比较函数中修改数组中的元素。
其他排序和搜索算法
除了 qsort 和 bsearch 之外,C 语言中还有其他排序和搜索算法可供选择。
排序算法:
- 冒泡排序(Bubble Sort): 简单但效率较低,时间复杂度为 O(n^2)。
- 插入排序(Insertion Sort): 在小规模数据上效率较高,时间复杂度为 O(n^2)。
- 选择排序(Selection Sort): 简单但效率较低,时间复杂度为 O(n^2)。
- 归并排序(Merge Sort): 效率较高,时间复杂度为 O(n log n),但需要额外的内存空间。
- 堆排序(Heap Sort): 效率较高,时间复杂度为 O(n log n),不需要额外的内存空间。
搜索算法:
- 线性搜索(Linear Search): 简单但效率较低,时间复杂度为 O(n)。
- 哈希表(Hash Table): 在理想情况下,可以实现 O(1) 的平均查找时间,但需要额外的内存空间,并且需要解决冲突问题。
选择哪种算法取决于具体的应用场景和性能要求。 在大多数情况下,qsort 和 bsearch 都是不错的选择。 但在某些特殊情况下,其他算法可能更适合。
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
理解GitHub Copilot CLI v1.0.111的高级请求百分比、用户提示活动图与实际路由模型窗口,区分显示口径和任务状态。
按维护分支、利用权限与节点类型对应四项修复,区分正式补丁、Beta和临时缓解的适用边界。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
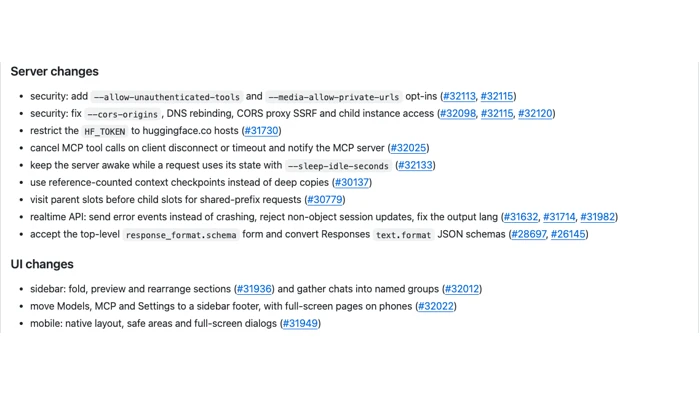
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
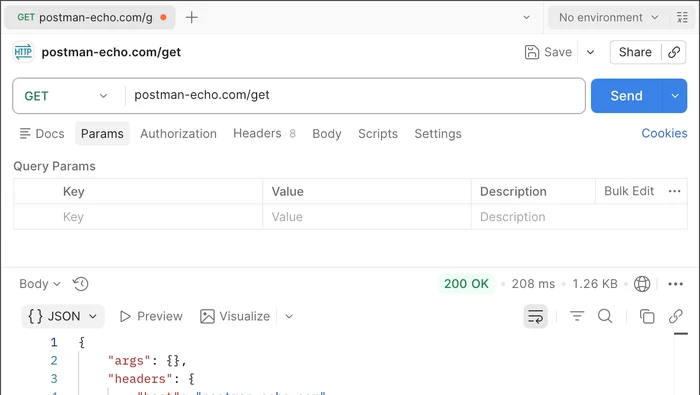
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
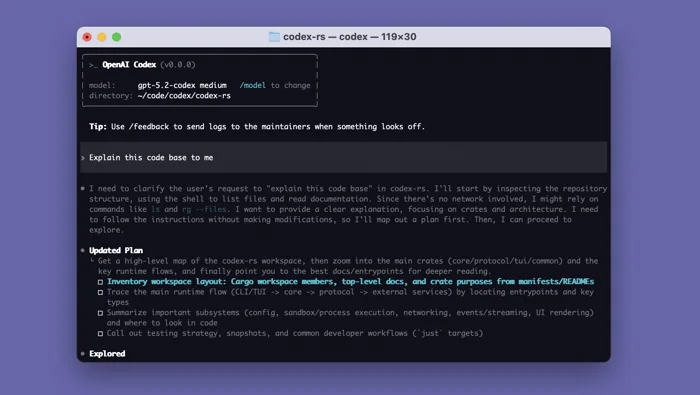
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



