

GitHub Actions重跑失败作业会使用最新代码吗
解释已有运行重跑的提交和权限边界,给出确认、失败作业重跑及结果核对命令,区分漏触发事件。
GitHub Actions重新运行只适用于已经存在的运行记录。它沿用原始事件的提交SHA和引用,不会自动切换到分支最新代码;完全没有创建运行的漏触发事件,也不能靠一个不存在的RUN_ID执行重跑。事故后处理时,先确认对象,再选择重跑范围并读取新尝试结果。
重跑之前确认已有运行和原始提交
适用环境为已安装并认证的GitHub CLI终端。OWNER/REPO替换为真实仓库,RUN_ID替换为已经存在的运行ID;读取需要相应访问权限,真正重跑需要仓库写入权限。以下代码是官方命令用法示例,不代表已经替任何仓库执行。
gh run view RUN_ID --repo OWNER/REPO --json databaseId,headSha,headBranch,event,status,conclusion,attempt预期读取单次运行对象,核对headSha、分支、事件和当前结论。运行对象不存在或权限不足时,应处理具体错误,不能虚构一个运行ID继续。重跑沿用首次触发者的权限和原始GITHUB_SHA、GITHUB_REF,因此它验证的是原始事件,不等于重新测试后来推送的代码。
只重跑失败作业也会带动依赖作业
对于已确认需要重跑的失败运行,可选择失败作业范围。执行前应理解自己的工作流是否含部署、通知、制品发布等实际效果;重复执行可能再次发生这些效果,不能仅因服务已恢复就给所有运行无条件补跑。
gh run rerun RUN_ID --repo OWNER/REPO --failed预期是请求重跑失败作业及依赖它们的作业,不是立刻保证工作流成功。没有纳入重跑范围的作业保留上次尝试的输出,新作业可以使用这些输出。该入口也不是用于凭空创建此前从未启动的PR事件运行。
提交重跑请求之后核对新尝试
使用相同RUN_ID读取结果,观察attempt、status和conclusion。调用成功只是提出了重跑请求,需要以实际运行结果确认完成,不能把请求已受理写成测试已通过。
gh run view RUN_ID --repo OWNER/REPO --json databaseId,attempt,status,conclusion,headSha,url预期得到更新后的尝试和状态;仍在排队或执行时没有最终成功结论。官方允许在初次运行后30天内重跑,每次运行最多重跑50次,包含整次及部分作业重跑;工作流处于禁用状态时不能重跑。这些边界与仓库自己是否需要重新执行是不同问题。
漏触发与已有失败运行为什么不能混用结论
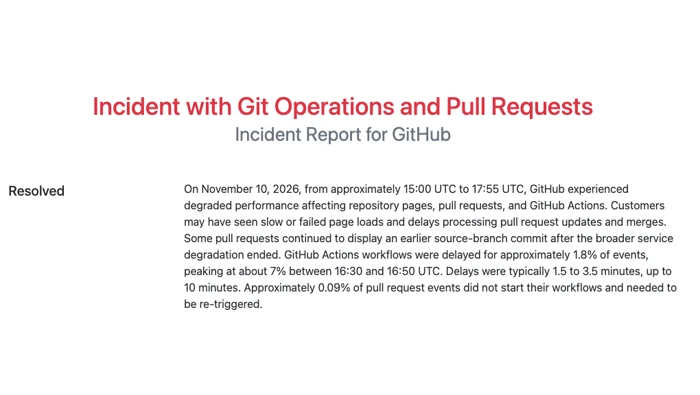
11月10日约15:00至17:55 UTC的GitHub事故中,约1.8%的事件出现工作流延迟,峰值约7%;另约0.09%的PR事件未启动工作流,需要重新触发。前者和后者的分母不同,也不能把“需要重新触发”机械等同于对任意失败运行使用--failed。
本次共享Git基础设施承受了增加的后台分析及合并计算压力。GitHub关闭近期合并处理优化、暂停后台分析并限制低优先级流量来缓解;后台处理在总体恢复后继续追赶。复盘指出的残留现象提醒使用者区分运行是否存在、是否结束及结果是否正确,按具体证据处理。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
GitHub对11月5日Actions与Checks事件的新增复盘指出:数据库服务在高并发大读请求下耗尽资源,导致部分运行无法排队或执行失败。检查类似问题时,先比对平台事件时间与失败状态,再决定是否重试自己的工作流。
GitHub对11月9日Actions事件的新增复盘说明:数据库迁移后,新区域容量与速率限制不足导致请求被拒,部分运行在服务恢复后仍占用并发。排查自己的工作流时,应把平台状态、运行状态与应用代码错误分开核对。
GitHub Public monitoring支持为单条告警生成独立链接。在企业视图点击告警编号即可打开、收藏或分享对应URL,接收者仍需具备访问权限。
GitHub Secret Scanning新增cloudflare_access_service_token检测类型,可帮助发现仓库中的Cloudflare服务令牌。检测、向签发方报告、生成用户告警和实际吊销是不同动作;本篇说明新检测器与开发团队处置边界,不将功能发布写成已发生泄露。
GitHub公告Windows与Linux托管运行器将于2026年12月8日结束ARM32作业执行支持,包含原生AArch32用户空间执行。原因与Node 20支持结束及Node 24不支持ARM32有关;本篇说明受影响范围、迁移检查与尚未说明的截止时刻。
GitHub已于2026年11月13日05:43:56北京时间关闭邮件投递事件,确认其系统内邮件处理影响消除。紧邻进展仍提示受影响上游邮箱供应商可能延迟;本篇区分平台恢复、收件状态和登录验证流程,避免把事件关闭等同每封邮件送达。
GitHub已于2026年11月13日03:33:54北京时间确认Webhooks API事件解决,先前约1%客户流量出现超时与错误。本文说明恢复时间线、CI与智能体工作流的投递核对方法,以及尚未公开的根因边界。
GitHub邮件投递事件已进入监控,登录和邮箱验证出现恢复,但部分上游邮件供应商托管的邮箱仍可能延迟。截至2026年11月13日05:18北京时间,官方未宣布完全恢复;本文说明受影响流程、最新范围与登录排查边界。
GitHub更新11月9日Webhooks与Actions事故复盘,确认退化的Kafka broker导致队列延迟,部分Actions事件因超过30分钟而未启动。新增进展是根因、影响数据和告警改进;原故障已结束,不能把复盘更新时间写成今天再次宕机。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



